# 成本优化
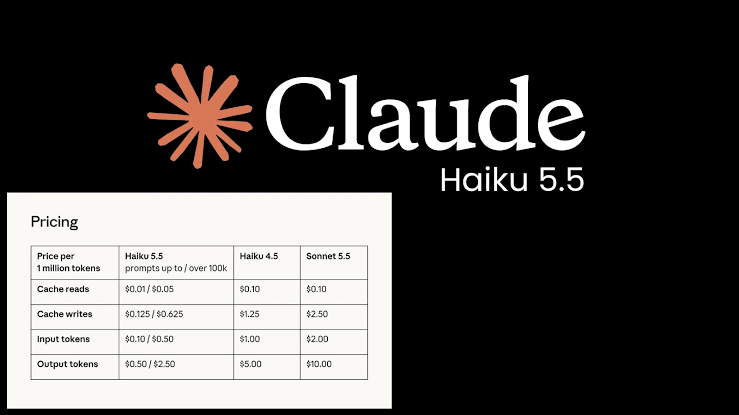
Claude Haiku 5.5 定价详解:两档价格、缓存与批处理折扣
10 万 token 以内输入 $0.10、输出 $0.50 每百万 token,超过后涨到 $0.50/$2.50;缓存读取 $0.01 起,Batch API 全部费率减半。本文拆解价格表、“便宜约 75%”的来源与各 effort 档的单次成本。
Gemini 4 Argon 定价详解:首发 $2/$10、后续 $4/$20,以及一次 100 万 token 回答的成本
拆解 Gemini 4 Argon 的定价:首发 $2/$10 每百万 token、之后 $4/$20、缓存输入减免 95%,并给出实际成本测算、百万 token 回答的费用与竞品价格对比。
GPT-6 提示缓存:缓存读取降 90%,以及如何真正命中缓存
每个 Agent 循环都在重发同一段开场。本文说明缓存降价的实际金额、提示词要如何排布才能命中、显式断点怎么放,以及在有人重构系统提示词后如何用测试保证命中率不回落。
Claude Opus 5.5 提示缓存:$0.20 缓存读取的盈亏平衡点
缓存读取 $0.20/M 对全新输入 $4.00/M 是 95% 折扣,但缓存写入 $5.00/M 比不缓存还贵。本文算出单个前缀在 1.26 次调用后回本、稳态下约 21% 命中率是盈亏分界线。
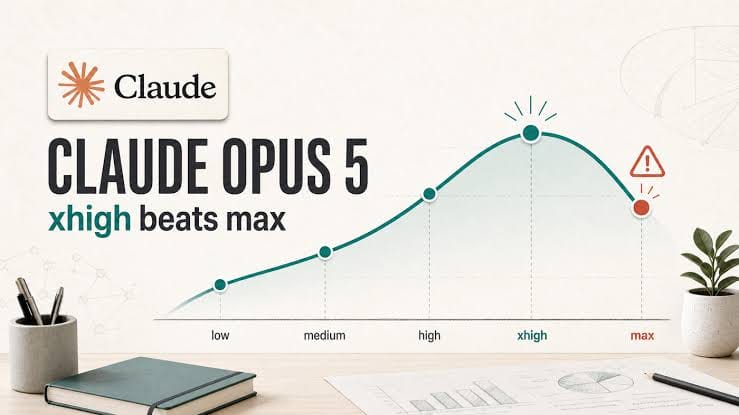
GPT-6 Sol 定价:所谓「降价 50%」到底是跟谁比
「便宜 50%」的基线是 GPT-5.6 的促销价而不是标价。本文换回标价基线后重算降幅,说明这个形容词如何让迁移预算表偏差三分之一,并给出按任务而非按 token 估算成本的方法。
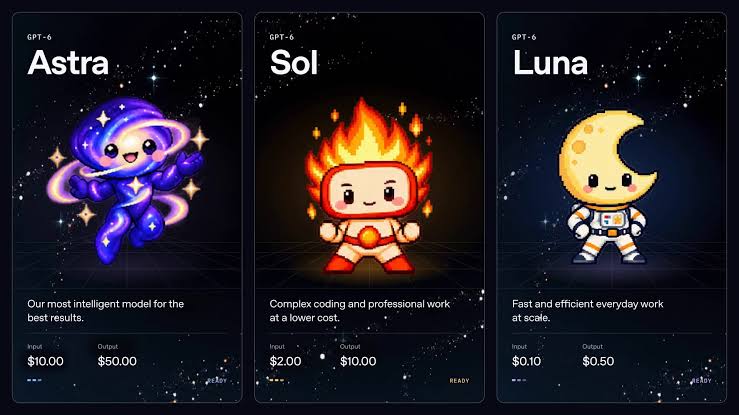
GPT-6 Luna vs Sol vs Astra:按单任务成本选档位
把 $0.10 和 $10 直接对比会得出「顶配贵一百倍」的错误结论,因为生产环境交付的是完成的任务而不是 token。本文用单任务成本这一个单位,说明三档模型各自适合什么工作负载。
GPT-6 Luna 支撑高并发 API 负载:真实请求量下的成本测算
每天分类五百万条工单、补全千万行商品目录这类任务,过去卡在成本上。本文按三种真实负载形态测算每百万次请求成本,并指出决定最终账单的三个关键变量。
GPT-6 Luna vs Gemini 3.8 Flash vs DeepSeek:亚美元 API 档位的真实成本
三个低价模型的三组标价并非同一种数字:一个是相对促销价的降幅,一个有到期日,一个按时段浮动。本文把它们对齐到同一口径,算清高频分类与摘要任务下的真实月账单。
DeepSeek API 即将涨价:开发者的成本优化指南
DeepSeek API 宣布即将大幅涨价!本文为你提供五大核心优化指南,包括利用 Prompt 缓存、按任务路由及低谷期批处理等实用策略,助你轻松应对成本危机,锁住开发预算。
Gemini 3.7 Flash 定价详解:在价格翻倍前锁定费率
谷歌推出 Gemini 3.7 Flash 模型,虽然限时费率极具性价比,但 2027 年价格将翻倍。本文详细拆解两个阶段的收费、真实场景成本估算及 5 大降本策略,助你精准规划 API 预算。

Claude Opus 4.8 价格详解:完整成本分析
深入了解 Claude Opus 4.8 的定价机制,包括标准与快速模式对比、effort 参数对成本的影响、Prompt Caching 节省技巧以及 Batch API 折扣。通过实际案例助您优化 AI 预算。