面对 Claude Fable 5.2 与 Opus 5.5,日常编码和知识工作先从 Opus 5.5 开始。当高难度推理、模糊的迁移或长时间的 Agent 项目超出你的 Opus 基线时,再尝试 Fable 5.2。在把全部工作负载切过去之前,比较 effort 设置和每个被接受结果的成本。
这个建议来自 Anthropic 的 Fable 5.2 公告,核对时间为 2026 年 11 月 10 日。本文是基于资料源的比较,我们没有运行独立的头对头基准测试。此前那篇 Opus 5 与 Fable 5 对比覆盖的是上一代模型。下面的价格、默认值和证据适用于这些更新的版本。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
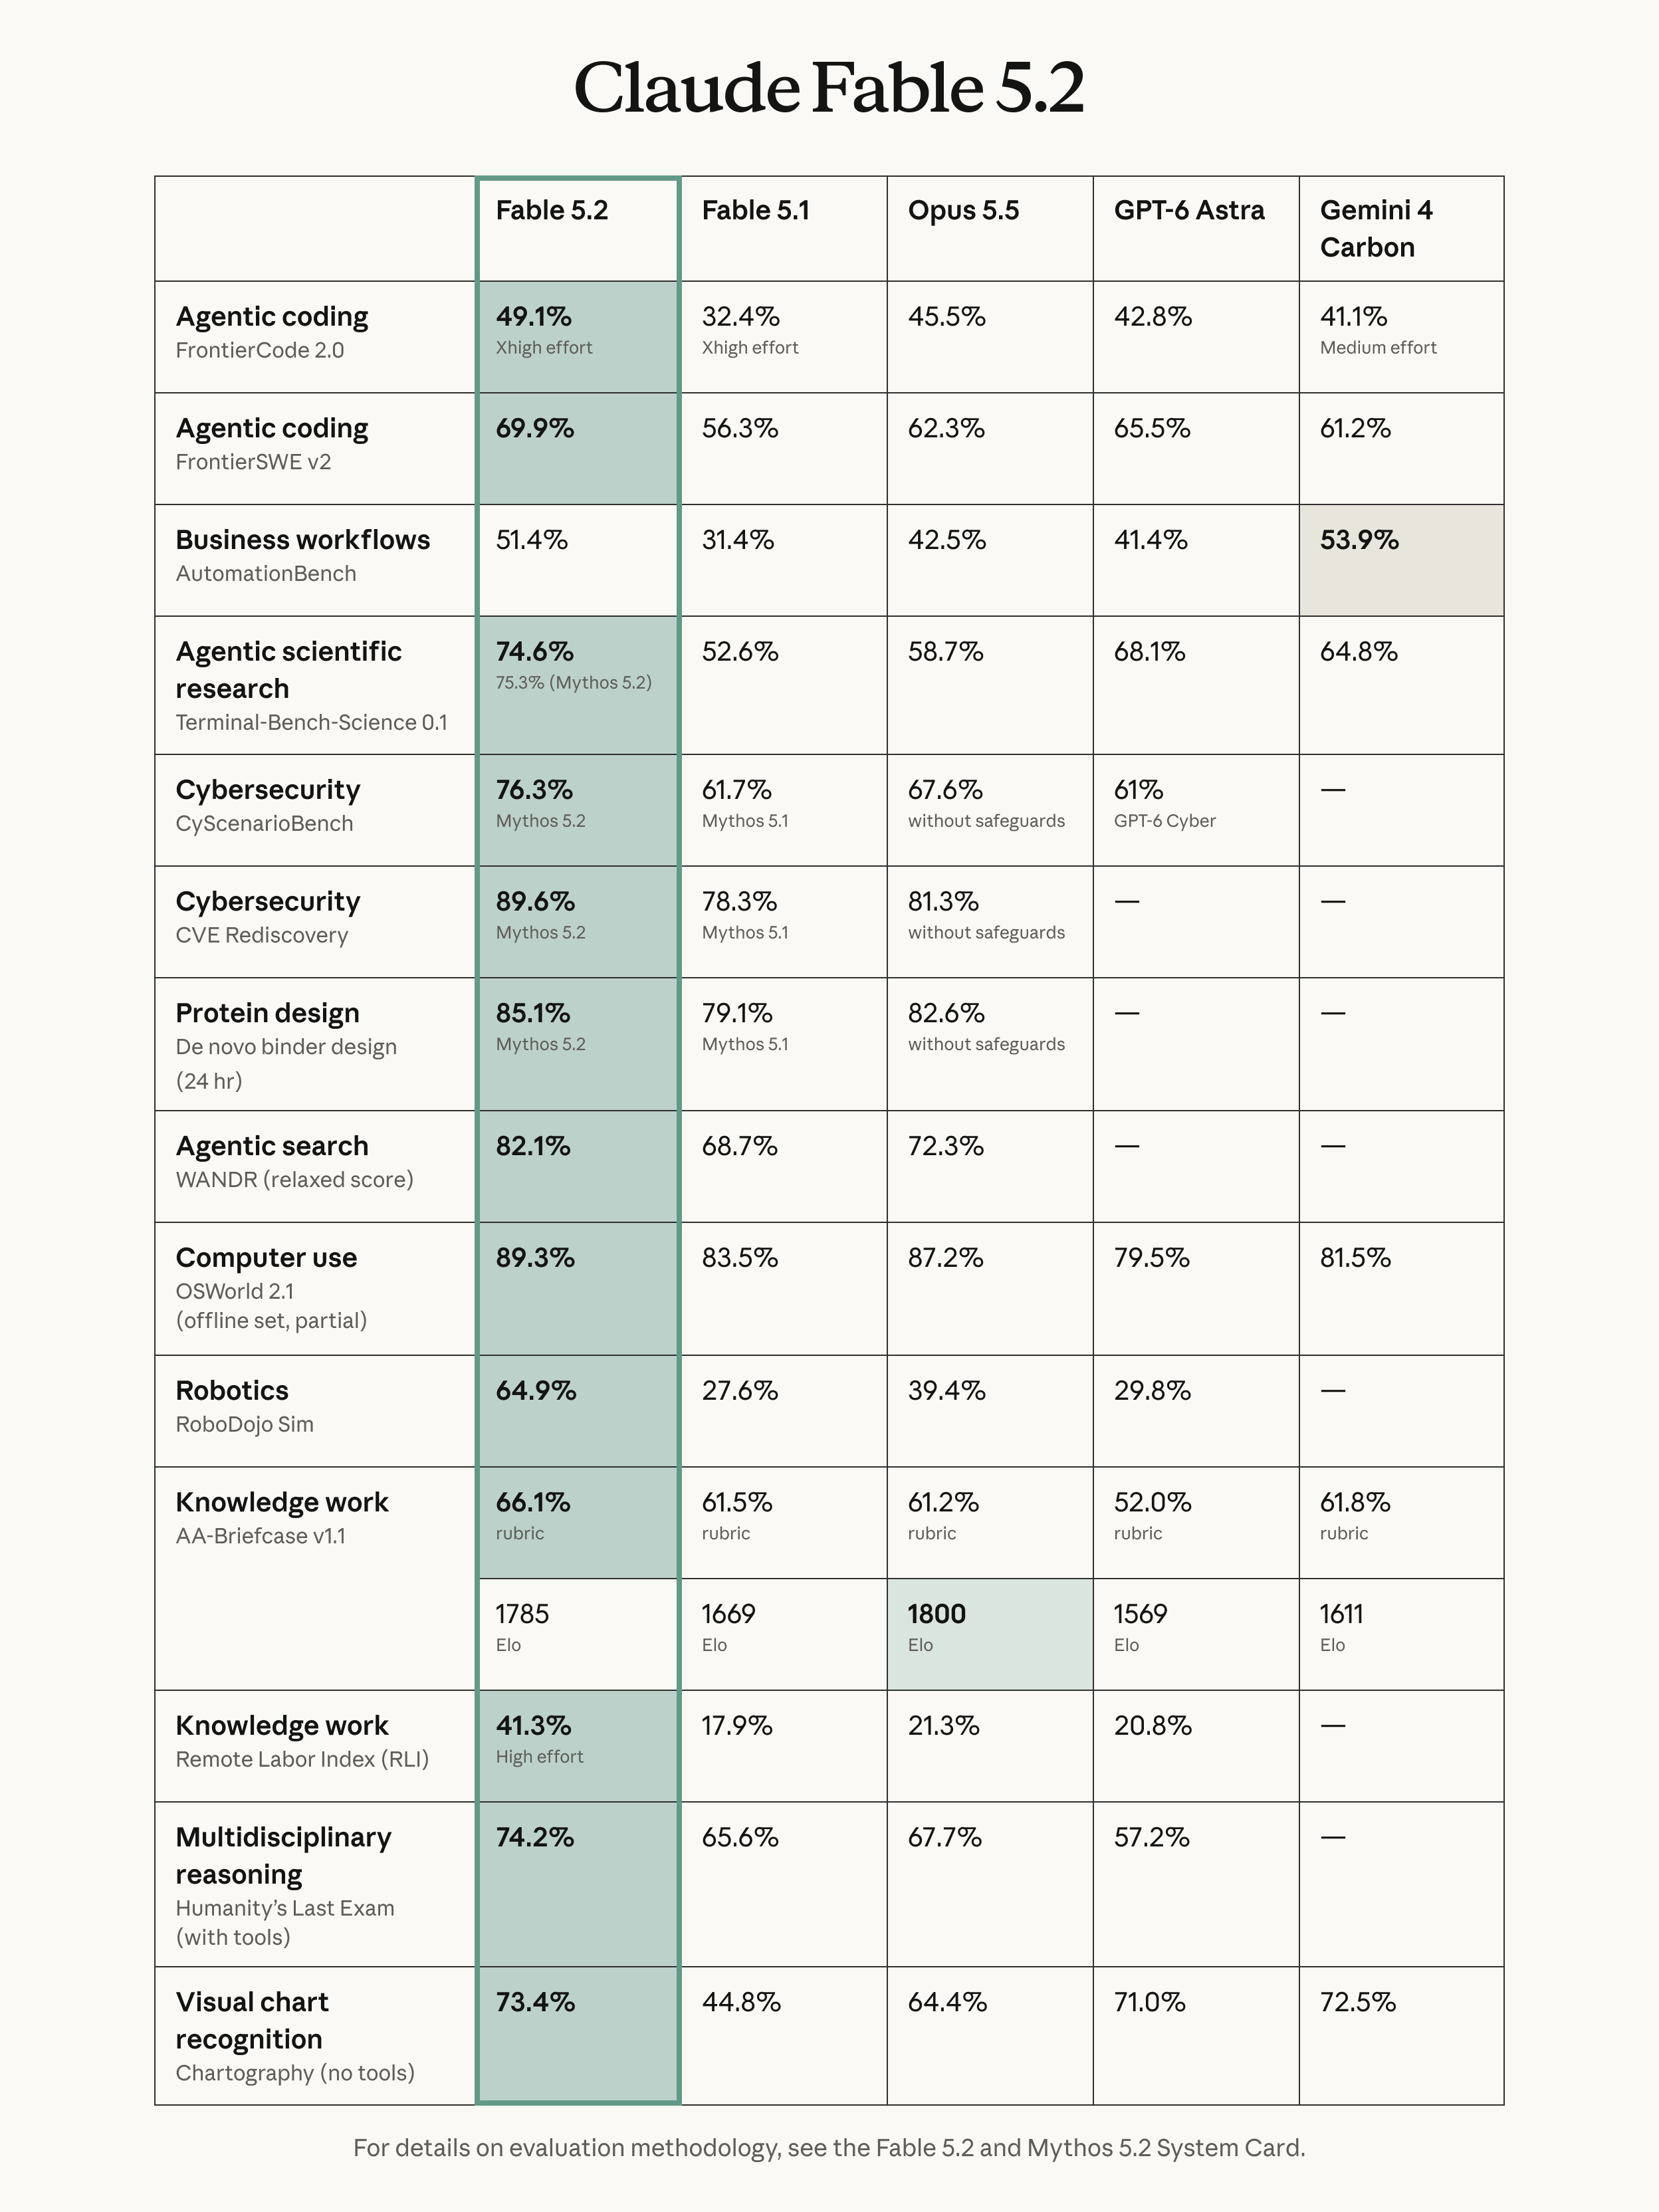
Claude Fable 5.2 与 Opus 5.5 一览
| 决策点 | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| 起始定位 | 高要求推理和长时间 Agent 工作 | 大多数工作负载的默认选择 |
| Claude API 模型 ID | claude-fable-5-2 |
claude-opus-5-5 |
| 标准输入,每百万 token | $8 | $4 |
| 标准输出,每百万 token | $40 | $20 |
| API 默认 effort | High | Medium |
| 上下文窗口 | 1M token | 1M token |
| 最大输出 | 128K token | 128K token |
| 相对延迟标签 | Moderate | Moderate |
来源:当前的 Claude 模型概览。两个模型都接受文本和图像输入、输出文本、支持工具,并使用始终开启的自适应思考。因此,更大的上下文窗口并不能区分它们,真正能区分的是它们能否完成你的具体任务。
Fable 的标准 token 价格是 Opus 的两倍。当两个模型在相似 token 量下都能满足你的验收标准时,Opus 就是更合理的起点。但当推理深度、重试和工具调用不同时,这并不能确定谁的总账单更低。
哪些编码任务值得切换到 Fable 5.2?
有明确检查项、范围有限的变更,用 Opus。当 Agent 必须自己发现问题、协调多个相互依赖的变更,或从失败的方法中恢复时,再测试 Fable。这些是根据 Anthropic 的定位和结果推断出的工作负载建议,不是针对你仓库的实测保证。
| 你的任务 | 起始选择 | 值得升级的证据 |
|---|---|---|
| 新增一个有文档的端点 | Opus 5.5 | 契约或集成反复失败 |
| 小重构后更新测试 | Opus 5.5 | Agent 无法识别发生变化的不变量 |
| 调试间歇性的跨服务故障 | 先用 Opus,再试 Fable | Opus 反复修复却不验证其他可能原因 |
| 迁移依赖关系不清楚的服务 | 两者都试 | Fable 在预算内完成更多被接受的变更 |
| 协调一个长期技术项目 | 试用 Fable | 更好的规划能经得起执行和审查 |
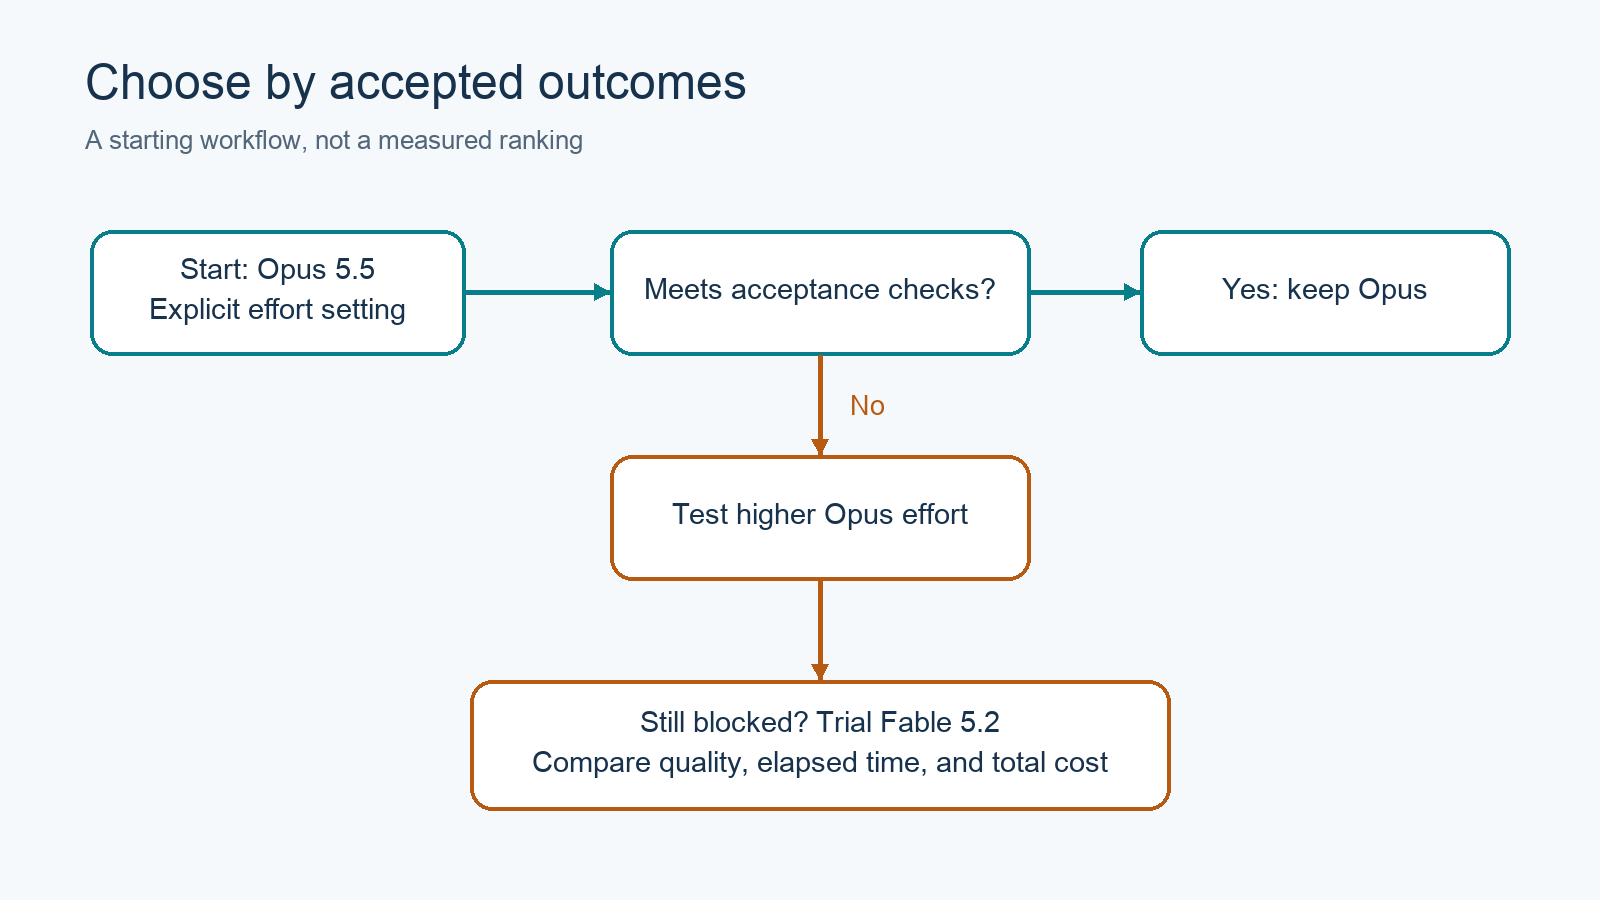
选择性升级:把日常任务留在基线上,把困难工作交给能通过检查的模型。
设想一个支付 Webhook 偶尔会把同一事件处理两次。如果所需修复已经明确,对 Opus 来说就是一个范围有限的编码任务。如果 Agent 必须重建重试、存储和下游服务之间的并发关系,这项调查就更适合试用 Fable。
给两个模型相同的故障证据和约束。更贵的模型无法弥补缺失的日志、无法访问的依赖,或者奖励错误行为的验收测试。
Anthropic 的基准测试说明了什么?
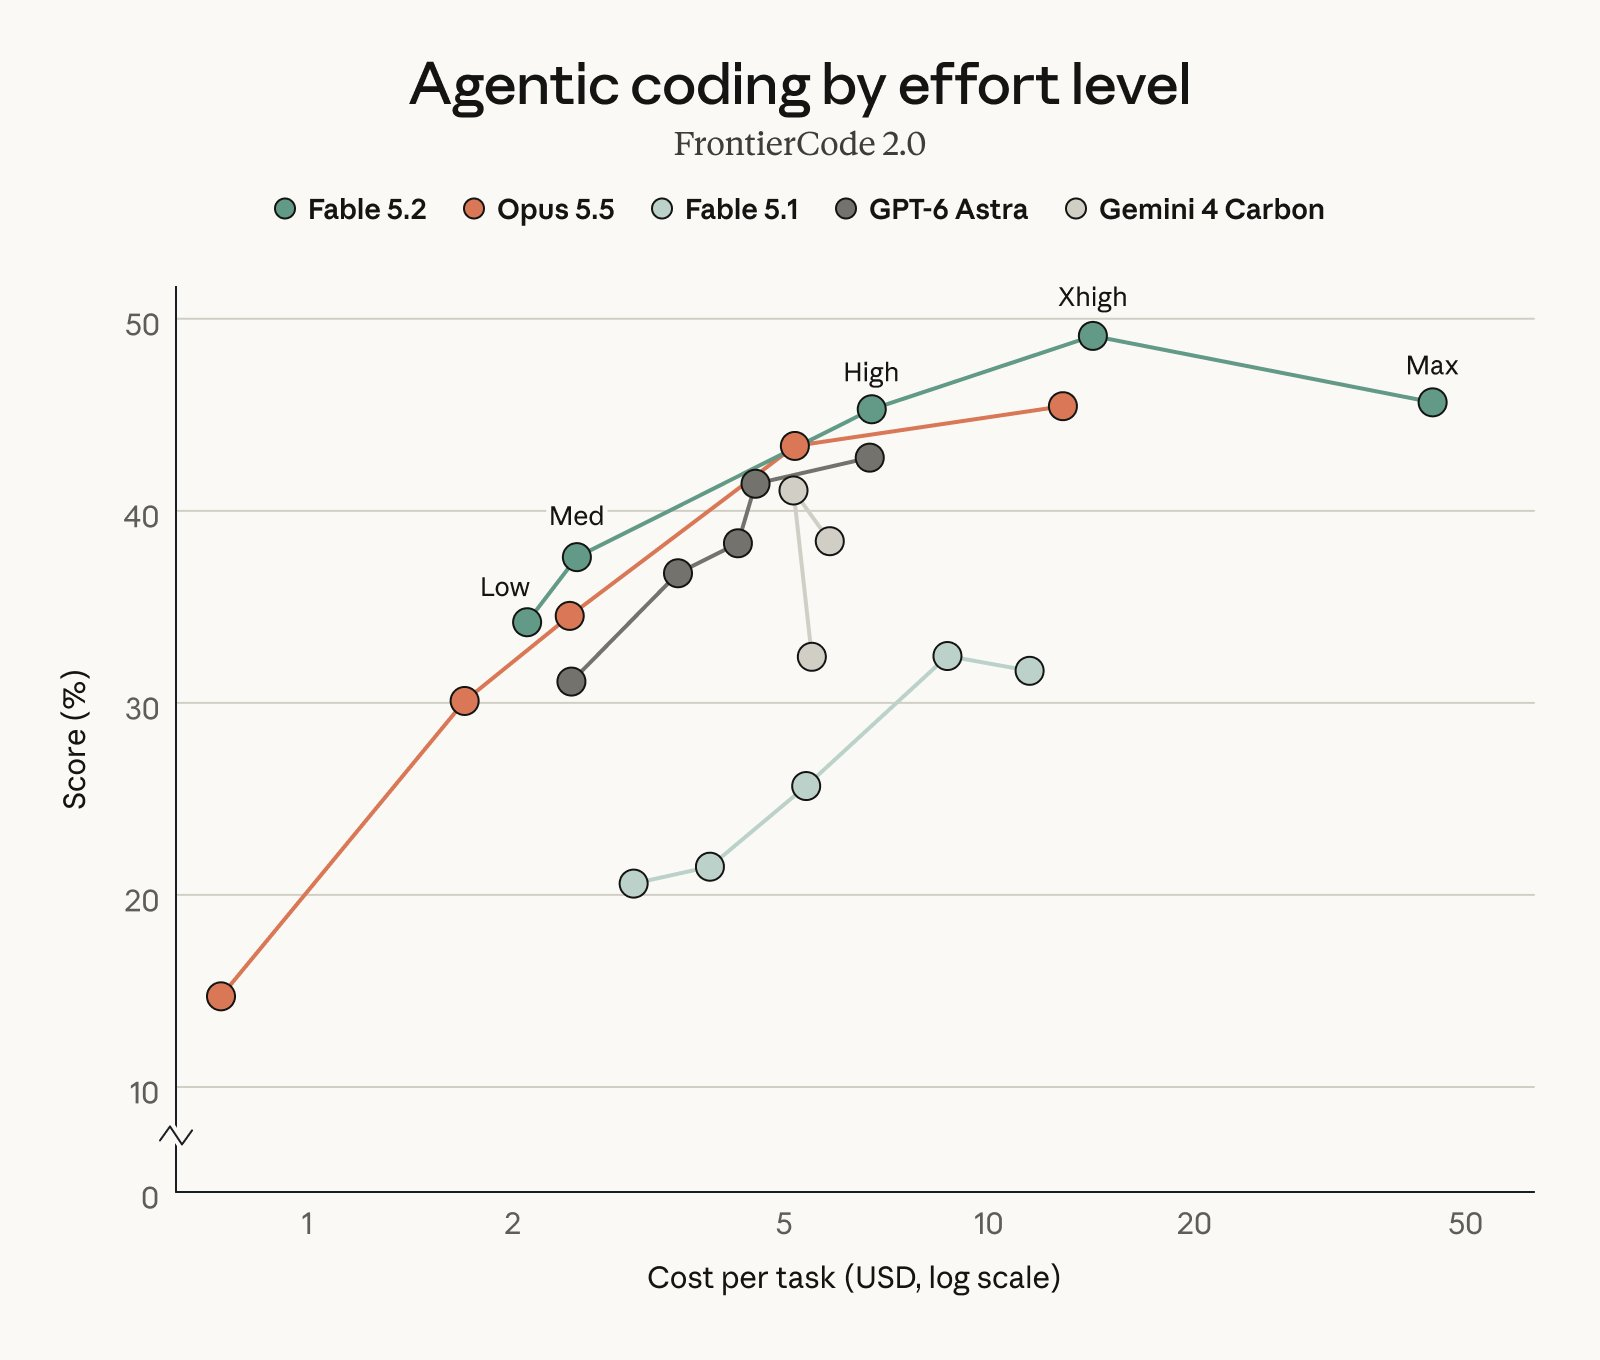
Anthropic 报告 Fable 5.2 在多项编码和推理评估中得分更高。最有实际价值的信号是它的 effort 与成本结果:在 Anthropic 的早期测试中,Fable 在 High 档几乎追平 Opus 在 Max 档的 FrontierCode 2.0 成绩,而每个任务成本约为后者的一半。
| 厂商报告的评估 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0,Agent 编码 | Xhigh 档 49.1% | 45.5% |
| FrontierSWE v2,Agent 编码 | 69.9% | 62.3% |
| WANDR,Agent 搜索,放宽评分 | 82.1% | 72.3% |
| OSWorld 2.1,部分离线集 | 89.3% | 87.2% |
这些数字来自公告。公告称,除非另有说明,分数使用可用的最高 effort。它们描述的是 Anthropic 的评估条件,不是默认设置,也不是你的工单上的预期通过率。
成本比较的范围更窄。Fable 在 High 档得分 45.3%,而 Opus 的最佳成绩是 45.5%。这支持在该项评估中测试更便宜的配置,但并不意味着每个 Fable 工作流的成本都是 Opus 的一半。
不要把基准百分比变成生产力预测。编码分数不衡量你的审查队列、部署风险,也不衡量修复一次错误迁移所花的时间。还要把仅限 Mythos 的网络安全和生物学结果排除在 Fable 的成绩单之外:公告指出它们共用底层模型,但防护和访问权限不同。
effort 设置会改变比较结果
比较模型时,要显式设置 effort。API 默认值对 Fable 5.2 是 High,对 Opus 5.5 是 Medium。Anthropic 的公告还单独说明,Claude 应用和 Claude Code 中的默认值是 Medium。记录你使用的产品和设置,不要假设同一个默认值适用于所有地方。
effort 文档为两个模型定义了 low、medium、high、xhigh 和 max。effort 会影响响应文本、工具参数和思考过程。它是行为信号,不是硬性的支出上限。
先从你当前可用的 Opus 配置开始。如果不够,再比较更高 effort 的 Opus 与 Medium 或 High 的 Fable。把 Xhigh 和 Max 的试验留给那些额外推理有合理收益、且你能承受花费的任务。
同等 effort 的比较回答一个问题:两个模型在相同命名设置下表现如何?成本匹配的比较回答另一个问题:哪种配置能在你的预算内产出最强的可接受结果?两者不能互相替代。
延迟:衡量整个任务
在 Anthropic 的概览中,两个模型的相对延迟标签都是 Moderate。仅凭这个标签无法得出通用赢家。应衡量到获得可审查结果所需的时间,包括工具调用和重试,而不是把输出速度当作整个开发工作流的速度。
Anthropic 表示 Fable 5.2 的生成速度比 Fable 5.1 快最多 30%。这是与上一代比较,不是与 Opus 5.5 比较。其可选的 fast 模式提供最高 2.5 倍的 token 生成速度,同样是厂商声明,而不是你的任务时长实测缩短幅度。
受编译或慢数据库支配的任务,不会随 token 生成变快而同比例加速。反过来,一个避免两次失败尝试的 Agent,即使 token 生成更慢,也可能更早完成。在支付速度溢价之前,分别追踪这些因素。
比较每个被接受结果的成本
用总工作流支出除以被接受的结果,作为你的决策指标。token 价格决定费率,但 token 量、缓存、失败尝试、工具和审查决定你实际买到了什么。下面的算术仅作示例,不是对任一模型行为的测量。
假设一个请求消耗 100,000 个未缓存输入 token 和 10,000 个输出 token,使用标准全球路由,没有额外工具费用:
| 配置 | 输入成本 | 输出成本 | 合计 |
|---|---|---|---|
| Opus 5.5 标准 | $0.40 | $0.20 | $0.60 |
| Fable 5.2 标准 | $0.80 | $0.40 | $1.20 |
| Opus 5.5 fast | $0.80 | $0.40 | $1.20 |
| Fable 5.2 fast | $1.60 | $0.80 | $2.40 |
费率已于 2026 年 11 月 10 日核对 Anthropic 的价格文档。订阅额度与这些 API 费率是分开的。云提供商、缓存、驻留选项和其他功能都可能改变账单。
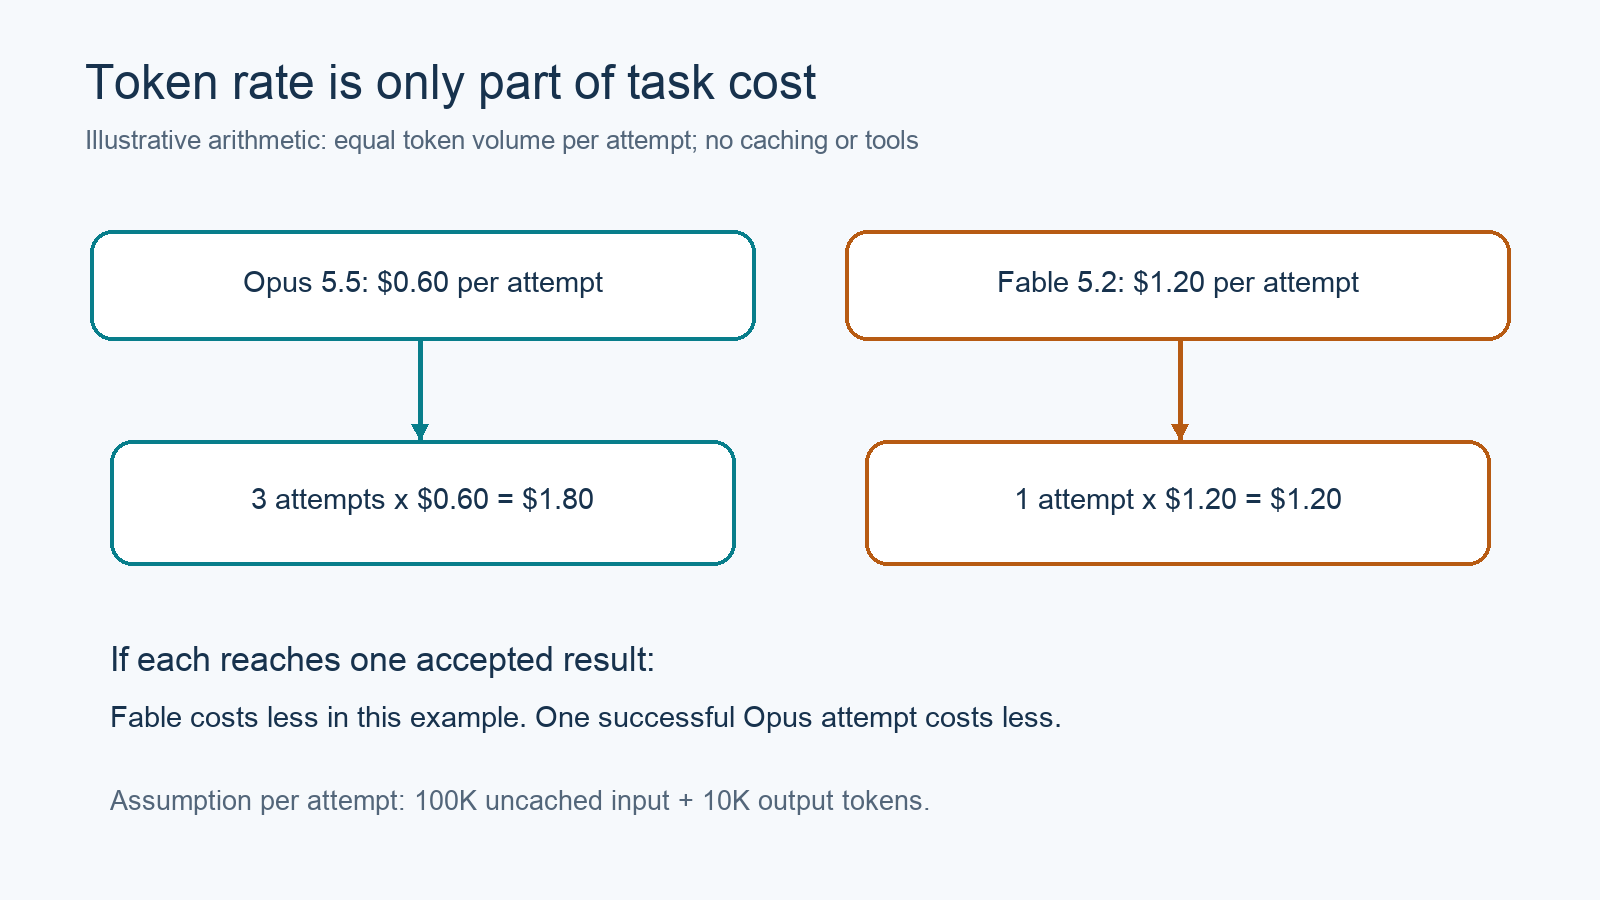
比较获得成功结果所需的全部尝试,包括重试和审查。
在这个简化示例中,三次同等 token 量的 Opus 尝试花费 $1.80,一次 Fable 尝试花费 $1.20。只有 Fable 能在那一次尝试中达到被接受的结果,它才更便宜。一次成功的 Opus 尝试仍然更便宜。真实重试消耗的 token 量往往不同,因此应使用记录的用量,而不是乘以猜测的平均值。
把工程审查时间与 API 支出放在一起看。一个通过测试但需要大量修正的补丁,并没有达到可直接审查的补丁那样的标准。
让编码 Agent 用 Apifox CLI 检查 API
你可以让编码 Agent 用 Apifox CLI 创建并运行可重复的 API 检查。切换模型时,这些检查可以发现请求或响应回归。它们不能证明 Agent 对仓库的修改是正确的;仓库测试和人工审查仍要保留。
可以用 Apifox CLI 把这条流程写成可重复执行的命令:安装 CLI、用令牌登录、查看测试用例分类,取回创建测试用例的 schema 并校验 payload,再创建并运行用例。在 Apifox 项目里用相同提示和显式 medium effort 比较 claude-opus-5-5 与 claude-fable-5-2,把 API 凭据放在私有变量中,断言预期状态和响应结构,记录用量与耗时。
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_APIFOX_TOKEN>
apifox test-case category --project <PROJECT_ID>
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file case.json
apifox test-case create --project <PROJECT_ID> --file case.json
apifox test-case run <CASE_ID> --project <PROJECT_ID> -e <ENVIRONMENT_ID> -r cli,json
可以给 Claude Code 或你常用的 Agent 这样的提示:
Read the current CLI installation guide for your project.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
Agent 应先检查 schema、选择有效的测试用例分类、构建 case.json,再运行命令;所有写入型 payload 都要先校验。把占位符替换成你项目中的资源。这是一个工作流模板,不是已执行的模型对比。Agent 的配置方式可参考 Claude Code 或 Codex 的集成指南。
常见问题
Fable 5.2 在所有编码任务上都比 Opus 5.5 好吗?
不是。Anthropic 建议大多数编码和知识任务使用 Opus 5.5。当困难工作超出该基线时,Fable 值得测试。它更高的厂商基准分数并不保证在每个任务上都更好。
Fable 5.2 的价格是两倍吗?
它的标准输入和输出 token 费率是 Opus 5.5 的两倍。总任务成本可能不同,因为不同配置消耗的 token 量和所需尝试次数不同。
应该总是使用最大 effort 吗?
不应该。把设置与你的验收检查和预算进行比较。更高的 effort 允许更多 token 支出,但不保证对范围有限的任务带来有用提升。
Fable 5.2 比 Opus 5.5 更快吗?
本文查阅的资料没有确立通用的头对头延迟赢家。两者都带有 Moderate 延迟标签。请测量你的实际工作流,并把 fast 模式视为独立配置。
Apifox 能判断哪个模型写代码更好吗?
Apifox 的接口测试能力可以帮助 Agent 运行 API 检查并收集响应证据。代码质量仍需要仓库测试和审查。用这些被接受的结果来决定哪个模型和 effort 设置值回成本。