Gemini 4 Argon 在介绍期内每 1M 输入 token 收费 $2、每 1M 输出 token 收费 $10,之后为 $4 和 $20。缓存输入在输入价格基础上优惠 95%,即介绍期每 1M token $0.10,之后 $0.20。Google 没有说明介绍期持续多久,而且你现在还买不到 Argon:它已经发布但尚未全面可用,目前只面向 Fairwind Program 的网络防御方 rollout。
本文把那张价格表变成预算数字:与七个当前模型的对比、四个场景演算、第三方的每任务成本,以及现在就该设置的成本控制。关于模型本身,先从 what Gemini 4 Argon is 看起;关于访问权限,见 is Gemini 4 Argon free。你可以在 Apifox 中针对一个今天就能调用的模型构建成本断言,之后再替换模型名。
价格表
Google 在 Gemini 4 Argon 发布博客 中公布了价格,介绍期后的价格见于脚注 1:“介绍期结束后,将适用每 1M 输入 token $4 和每 1M 输出 token $20 的价格。”
| Gemini 4 Argon,每 1M token | 介绍期 | 标准价(介绍期后) |
|---|---|---|
| 输入 | $2.00 | $4.00 |
| 缓存输入(输入优惠 95%) | $0.10 | $0.20 |
| 输出 | $10.00 | $20.00 |
| 每次响应最大输出(Google) | 1M token | 1M token |
| 一次完整 1M token 输出的成本 | $10.00 | $20.00 |
缓存价格是根据 Google 的 95% 规则算出的($2 x 0.05 和 $4 x 0.05)。Google 没有公布输入上下文窗口或模型 ID。它表示输出上限为 1M token,“此前为 64K token”;至少有一家第三方评测机构 Vals AI 在其测试的配置下列出的最大输出为 262K。
Argon 与当前前沿模型及 Gemini 模型的对比
所有价格均为每 1M token。
| 模型 | 输入 | 缓存输入 | 输出 | 最大输出 |
|---|---|---|---|---|
| Gemini 4 Argon(介绍期) | $2 | $0.10 | $10 | 1M |
| Gemini 4 Argon(标准价) | $4 | $0.20 | $20 | 1M |
| GPT-6 Astra | $10 | $1 | $50 | 128,000 |
| Claude Opus 5.5 | $4 | $0.20 | $20 | 128K(Batch 上为 300K,beta) |
| Claude Sonnet 5.5 | $2 | $0.20 | $10 | 128K(Batch 上为 300K,beta) |
| GPT-6.1 Sol | $2 | $0.10 | $10 | 128,000 |
| Claude Fable 5.1 | $10 | $0.25 | $50 | 128K |
| gemini-3.1-pro-preview(prompt <=200K / >200K) | $2 / $4 | $0.20 / $0.40 | $12 / $18 | 65,536 |
| gemini-3.8-flash(介绍期 / 2027-01-01 起) | $0.75 / $1.50 | $0.075 / $0.15 | $3.75 / $7.50 | 65,536 |
竞争对手的价格来自各厂商自己的页面:OpenAI 的 GPT-6 Astra 页面、Anthropic 的定价页面 和 Google 的 Gemini API 定价页面。
- 标准价 Argon = Claude Opus 5.5。 同样是 $4/$20,同样是 $0.20 的缓存输入。
- 介绍期 Argon = Claude Sonnet 5.5 和 GPT-6.1 Sol。 同样是 $2/$10;$0.10 的介绍期缓存价格与 GPT-6.1 Sol 一致。
- GPT-6 Astra 和 Claude Fable 5.1 的成本是介绍期 Argon 的 5 倍、标准价 Argon 的 2.5 倍。见 Claude Fable 5.1 pricing。
- Argon 的介绍期输出价格($10)低于 gemini-3.1-pro-preview 的($12),后者是 Google 之前顶级的 Pro 模型。
- 长 prompt 会改变算法。 OpenAI 对超过 272K 输入 token 的 prompt,按整条请求的输入和缓存 2 倍、输出 1.5 倍计费。Gemini 3.1 Pro 在超过 200K 时收费更高;Anthropic 则不会。Google 没有说明 Argon 是否设有长 prompt 档位。
要在价格之外看能力,见 Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5。
思考 token 按输出计费
在当前的 Gemini 模型上,思考 token 按输出计费:Google 的 thinking 文档 称“响应定价是输出 token 与思考 token 之和”。Google 没有专门记录 Argon 的规则,但可以按同样的规则来规划。Google 是在“最高思考设置”下运行 Argon 的评测,所以要把“每 1M 输出 token $10”理解为回答加推理。
四个演算场景
以下每个数字都是 token 数除以 1M,再乘以每 1M 的费率。场景 1 到 3 假设不使用缓存。
1. 一次典型的 API 调用:20K 输入,5K 输出
- 介绍期:20,000 / 1M x $2 = $0.04 输入,加上 5,000 / 1M x $10 = $0.05 输出。合计 $0.09。
- 标准价:$0.08 + $0.10 = $0.18。
如果每天 1,000 次调用,介绍期是 $90,标准价是 $180。同样的调用在 Claude Opus 5.5 上是 $0.18,在 GPT-6 Astra 上是 $0.45($0.20 + $0.25),在 gemini-3.1-pro-preview 上是 $0.10($0.04 + $0.06),而在 gemini-3.8-flash 的介绍期价格下约为 $0.034($0.015 + $0.019)。
2. 一次较长的 agent 回合:200K 输入,50K 输出
- 介绍期:200,000 / 1M x $2 = $0.40,加上 50,000 / 1M x $10 = $0.50。合计 $0.90。
- 标准价:$0.80 + $1.00 = $1.80。
GPT-6 Astra 会收取 $4.50($2.00 + $2.50)。gemini-3.1-pro-preview 收取 $1.00($0.40 + $0.60),但 200K 是它的档位分界线:更长的 prompt 按 $4/$18 计费。如果 Argon 也有类似的档位,更长的回合会更贵。
3. 一次用满的响应:1M token 输出
仅输出就是 1,000,000 / 1M x $10 = 介绍期 $10.00、标准价 $20.00。再加上一个 100K token 的 prompt(介绍期 $0.20,标准价 $0.40),这次调用就是 $10.20 或 $20.40。
表中没有其他模型能在一次同步响应中做到这一点:竞争对手的上限是 128K,此前的 Gemini Pro 是 65,536。按 Vals 列出的 262K 最大输出,一次完整响应在介绍期约 $2.62,标准价 $5.24。工程侧的问题(超时、流式传输、网关)见 Gemini 4 Argon 的 1M output tokens。
4. 一个 500K token 的缓存 prompt 复用 10 次
假设你把同样的 500K token 代码库或合同集发送十次,每次 5K 输出 token。假定第一次调用按完整输入价格付费以构建缓存,接下来九次从中读取。
| 10 次调用,500K prompt,每次 5K 输出 | 介绍期 | 标准价 |
|---|---|---|
| 输入,不使用缓存(10 x 500K) | $10.00 | $20.00 |
| 输入,使用缓存(1 次完整 + 9 次缓存) | $1.00 + 9 x $0.05 = $1.45 | $2.00 + 9 x $0.10 = $2.90 |
| 输出(10 x 5K) | $0.50 | $1.00 |
| 使用缓存合计 | $1.95 | $3.90 |
| 不使用缓存合计 | $10.50 | $21.00 |
缓存把输入账单削减了 85.5%。有两点需要注意:Google 没有说明 Argon 是否对缓存存储收费(gemini-3.1-pro-preview 每小时每 1M token 收费 $4.50,持有 500K token 一小时会增加 $2.25),而且 500K 的 prompt 超出了 3.1 Pro 的 200K 分界线。Argon 的标准缓存价格与 Opus 5.5 的 $0.20 一致,所以 Claude Opus 5.5 prompt caching cost math 中的盈亏平衡逻辑同样适用。
每 token 价格不等于每任务成本
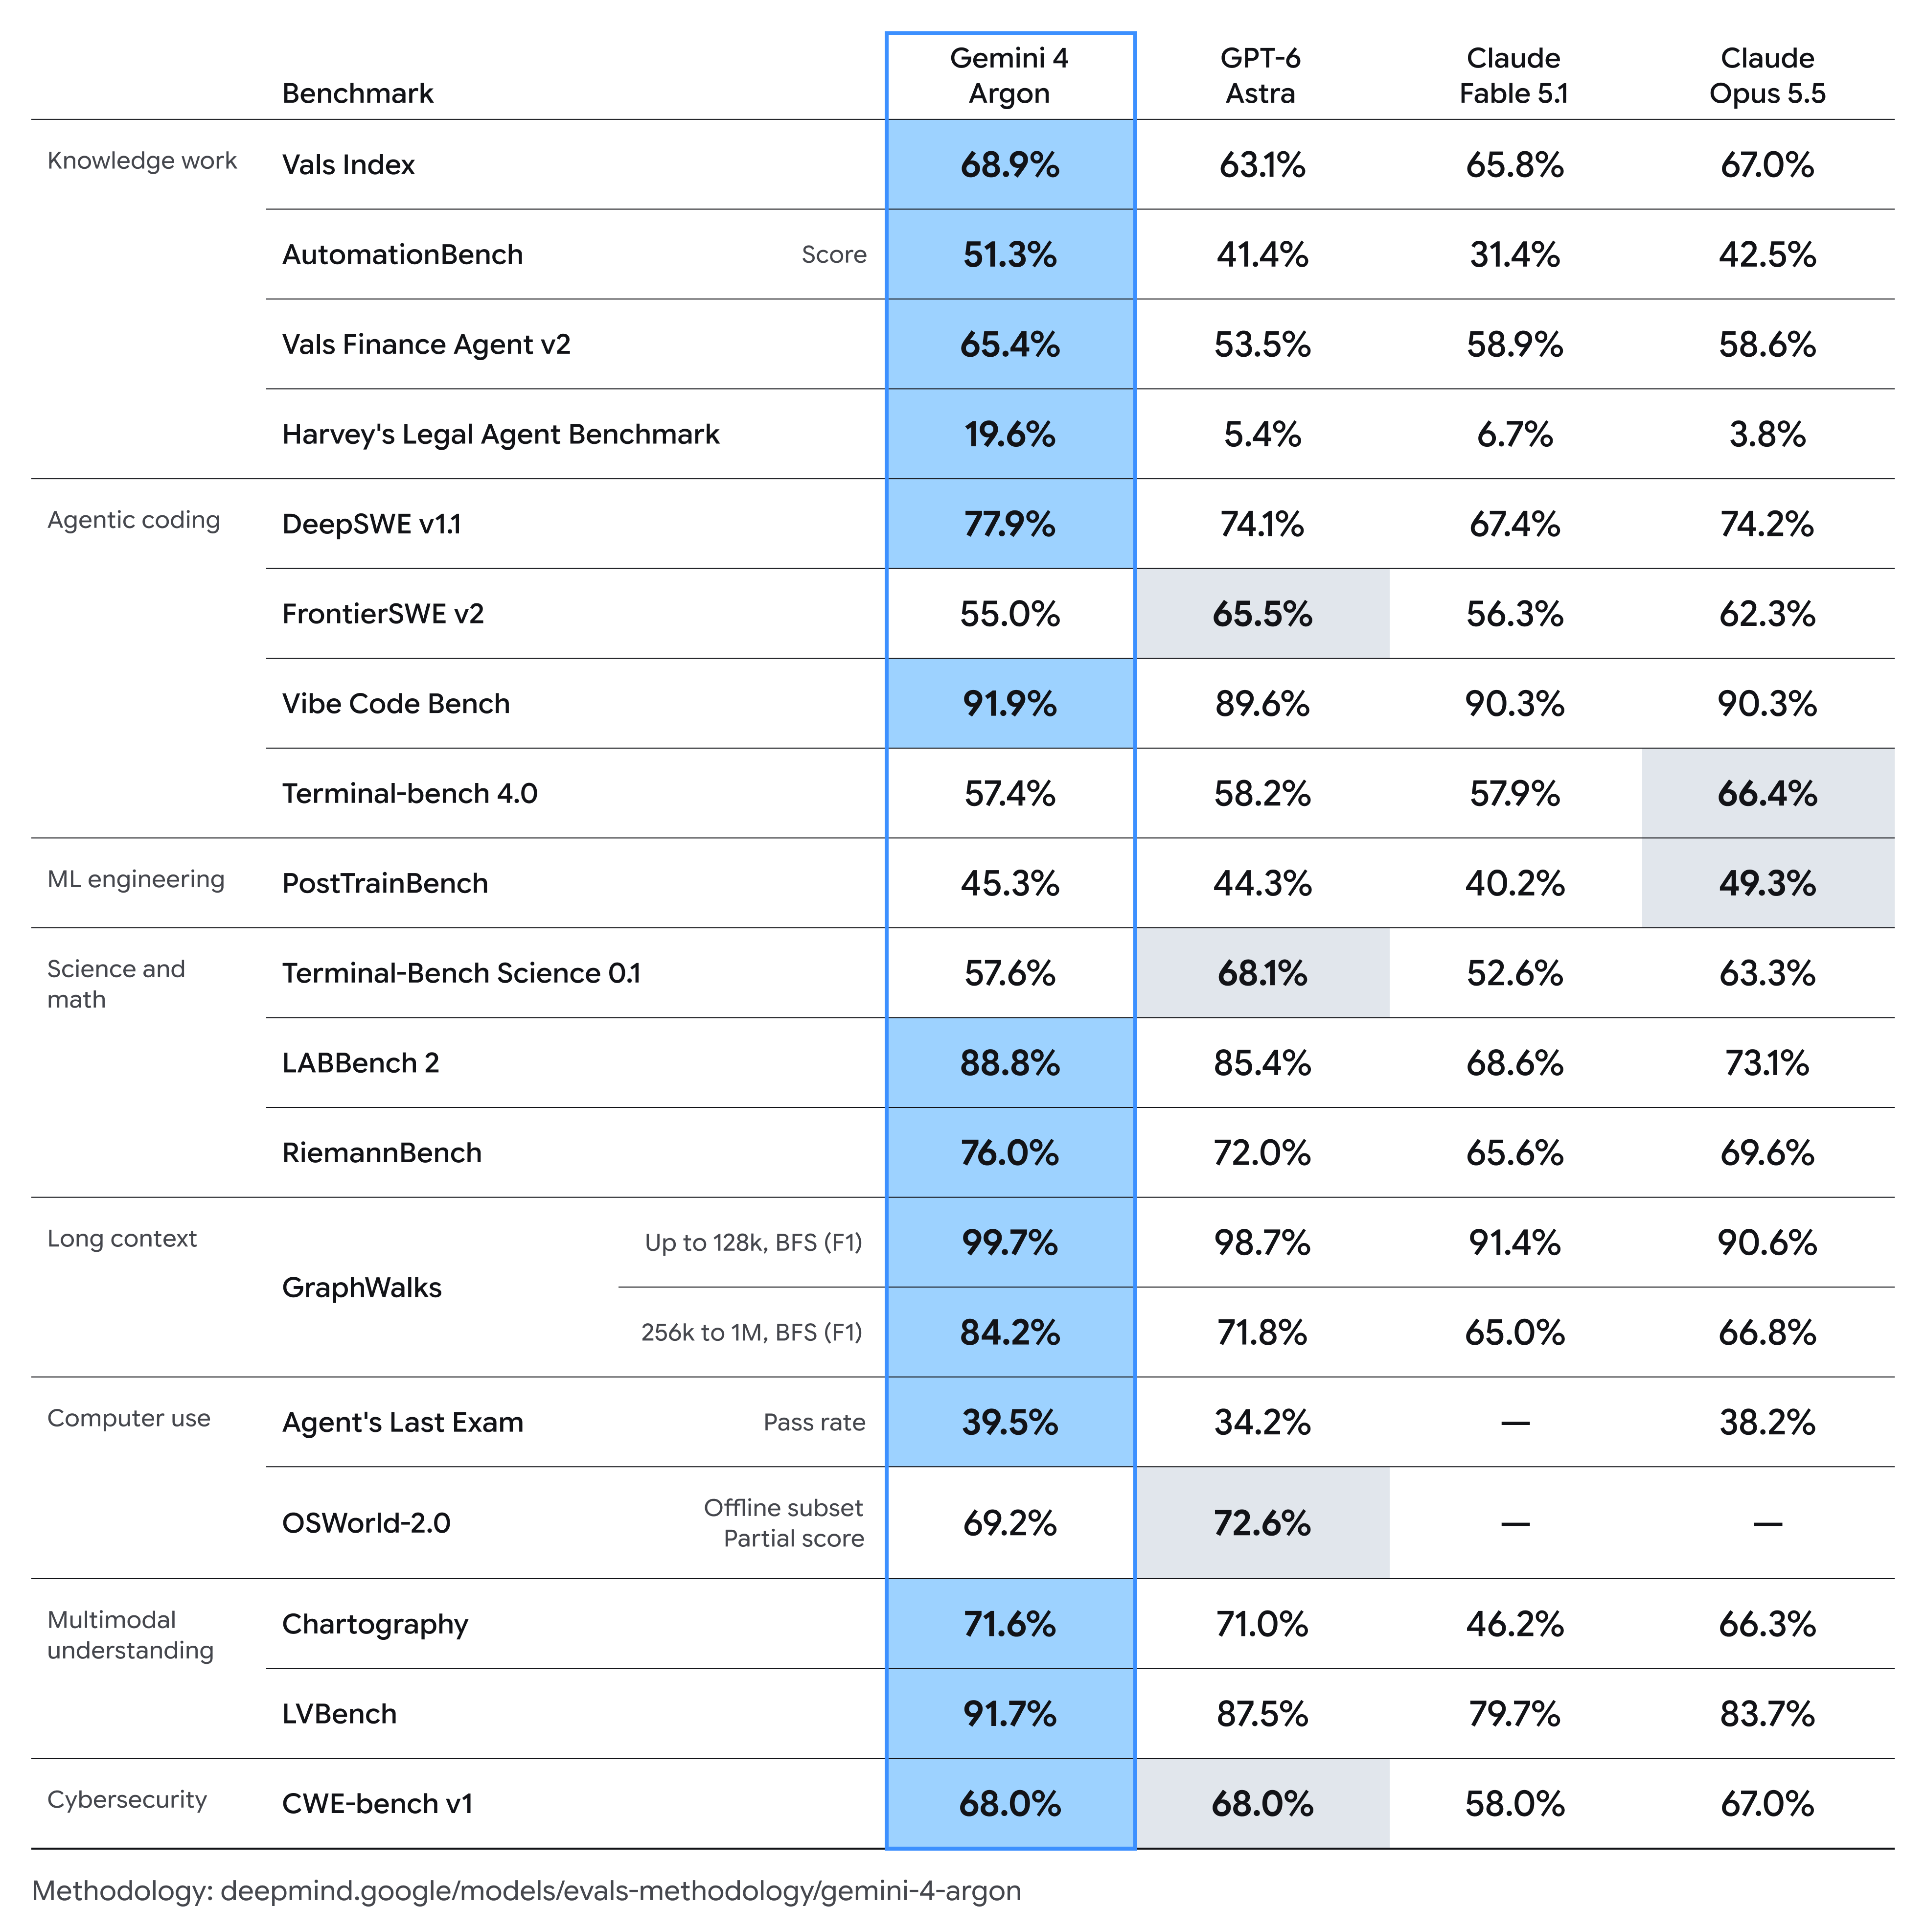
Artificial Analysis 列出了以介绍期价格在 Gemini 4 Argon(High)上运行其 Intelligence Index 的每任务成本为 $1.99;The Decoder 把同样的运行按标准价算为 $3.98。AA 给 Argon 打 53 分,与 GPT-6 Astra(max)相同,后者被列为每任务 $3.26。
关键在于 token 用量。AA 统计 Argon(high)每任务约 62K 输出 token,而 Astra 在最高设置下约 27K,约为 2.3 倍。介绍期每任务输出:62,000 / 1M x $10 = $0.62,而 Astra 是 27,000 / 1M x $50 = $1.35。按标准价,The Decoder 给出的 Argon 完整任务数字($3.98)高于 AA 给 Astra(max)的 $3.26,尽管 Argon 的标准费率比 Astra 低 60%。
Vals AI 显示出同样的模式。它列出 Argon 在 Vals Index 上的每次测试成本为 $15.68,而 Claude Opus 5.5 为 $32.14、Claude Sonnet 5.5 为 $21.34、GPT-6.1 Sol 为 $3.24,并且它把 Argon 按 $4/$20 的标准费率列出。Sonnet 5.5 和 GPT-6.1 Sol 在纸面上与 Argon 的介绍期价格相同,但它们的每次测试成本相差 6 倍以上。
根据你自己的 token 用量来做预算,而不是价格表。
在 Argon 上线前就设置好的成本控制
- 限制输出。 在 generateContent 上,
generationConfig.maxOutputTokens用来设置上限。Google 表示新模型在 Interactions API 上发布,所以等文档为 Argon 列出对应的上限后,在那里设置等价的限制。按标准价,1M 的上限就是每次调用 $20 的输出上限。 - 缓存稳定的内容。 在多次调用间重复的系统指令、数据模型和参考文档,正是 95% 折扣发挥作用的地方。
- 有意识地选择思考档位。 Google 尚未公布 Argon 的档位。目前 gemini-3.1-pro-preview 默认为
high,gemini-3.8-flash 默认为medium。等 Argon 的档位有文档后,测试更低的档位在你的任务上能否保持质量。 - 对用量做断言。 每个 generateContent 响应都以
usageMetadata结尾。在 Apifox 中,把请求保存下来,把模型放在GEMINI_MODEL环境变量里,添加一个后置响应断言,从usageMetadata中的 token 计数计算成本,并在调用超过你的上限时让测试失败。今天先对 gemini-3.8-flash 运行;等 Argon 的 ID 发布后,改一个变量并重新运行整套测试。
该断言的算式:
cost = uncached_input / 1,000,000 x input_rate
     + cached_input   / 1,000,000 x cached_rate
     + (output + thinking) / 1,000,000 x output_rate
Google 还没有定价的部分
介绍期的时长以及 $4/$20 开始的日期;超过 200K 的 prompt 是否更贵;Batch 或 Flex 定价(3.1 Pro 两者都有,输入 $1/$2、输出 $6/$9);缓存存储费用;速率限制;以及是否根本存在免费额度。
FAQ
Gemini 4 Argon 每百万 token 要多少钱? 介绍期内输入 $2、输出 $10,之后为 $4 和 $20。缓存输入优惠 95%:$0.10,之后 $0.20。
介绍期价格持续多久? Google 没有说明。发布博客没有给出结束日期或时长。
思考 token 按输出计费吗? 在当前的 Gemini 模型上是的。Google 没有专门记录 Argon 的规则。
一次 1M token 的输出响应要多少钱? 介绍期定价 $10,标准价 $20,不含输入。
Argon 比 Claude Opus 5.5 或 GPT-6 Astra 便宜吗? 按 token 算,标准价 Argon 与 Opus 5.5 相同,比 Astra 低 60%。按任务算,取决于 token 用量:Artificial Analysis 测得 Argon 使用的输出 token 约为 Astra 的 2.3 倍。想用今天更便宜的 Gemini,见 Gemini 3.8 Flash pricing。
我今天能为 Argon 付费吗? 不能。它仅面向 Fairwind Program 合作伙伴 rollout。付费 API 客户和 Google AI Ultra 订阅用户是下一批,没有日期。
现在做预算,之后再测量
把你当前流量的 token 数分别乘以 $2/$10 和 $4/$20,就得到 Argon 的介绍期和标准价区间。然后搭建度量:把请求保存到 gemini-3.8-flash,用 GEMINI_MODEL 作为变量,并对 usageMetadata 添加成本断言。当 Google 公布模型 ID 时,你换一个值,第一天就能看到真实的每次调用成本。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
