一个模型家族里最便宜的档位,过去正是那个你不信任的档位。分类、摘要和重试流量往那儿送,任何带 agent 性质的活都留在旗舰上,并且默认只要任务需要超过一步,这个廉价模型就会崩。
GPT-6 Luna 于 2026 年 9 月 22 日发布,定价属于那个档位,行为却不像。它每百万输入 token 收 $0.10、每百万输出 token 收 $0.50,带 1 百万 token 的上下文窗口,而 OpenAI 公布的数字把它放进了前沿模型在 agent 编程基准测试上的区间,单任务成本却只是它们的一小部分。
先澄清一件事:这不是你可能已经接进降级链里的那个 GPT-5.6 Luna。档位名一样,模型是新的,价格是新的,上下文窗口也是新的。不这么假设,很容易悄悄上线一个行为变更,然后只能从支持工单里发现它。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

GPT-6 Luna 一览
| 项目 | 值 |
|---|---|
| API 模型 ID | gpt-6-luna |
| 输入价格 | 每百万 token $0.10 |
| 输出价格 | 每百万 token $0.50 |
| 缓存输入读取 | 90% 折扣 |
| 上下文窗口 | 1,000,000 token |
| Artificial Analysis 智能指数 | 37 |
| 发布时间 | 2026 年 9 月 22 日,与 GPT-6 Sol 同期 |
| 可用入口 | ChatGPT Work 和 Codex、面向 Free 和 Go 用户的桌面版,以及 API |
| 不可用入口 | Chat(截至发布时) |
在同一个家族里,GPT-6 Sol 是 $2/$10,窗口 872,000 token,指数 48;GPT-6 Astra 是 $10/$50。OpenAI 表示 Astra “依然是我们在各方面表现最好的模型”,所以 Luna 并不是被当作最聪明的模型来卖,它是被当作单任务成本塌掉的那个模型来卖。
它是新模型,不是改了名的档位
GPT-5.6 家族是 Sol、Terra 和 Luna。GPT-6 家族是 Astra、Sol 和 Luna。两个名字延续下来,Terra 没有,Astra 是新的。OpenAI 说 Sol 和 Luna 的训练方法与 GPT-6 Astra 相似,也就是说它们是新模型,只是沿用了旧名字的命名习惯。
没有 GPT-6 Terra。如果你围绕 GPT-5.6 的命名方案搭了一套路由阶梯,中间那一级已经不存在了,我们早先那篇 Sol 与 Terra、Luna 的对比,现在只算历史记录,不再是当下的参考。
价格沿革能看出这个档位走了多远:
| 档位 | GPT-5.6 标价 | GPT-5.6 促销价 | GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | 没有 GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
所有数字都是每百万输入 token 与每百万输出 token 的价格。GPT-5.6 那两行来自我们当时的报道:《GPT-5.6 定价》和《GPT-5.6 降价》。
OpenAI 说 Sol 和 Luna 比 GPT-5.6 的 promotional 定价便宜 50%。“促销”这个词是 OpenAI 自己用的,它改变了这个说法的含义:比较是拿一个折扣价来做的,而不是 GPT-5.6 发布时的价格。以 GPT-5.6 Luna 的标价 $1/$6 衡量,GPT-6 Luna 的 $0.10/$0.50 相当于输入降 90%、输出降 92%。真实降幅比标题上的数字更大,而标题是从一个折扣价算起的。请把第二个数字放进你的预算模型,不是第一个。
便宜的模型反而有更大的上下文窗口
这是大多数发布报道跳过的一个细节。Luna 带 1,000,000 token 的上下文窗口。价格是它二十倍的 Sol,带的是 872,000。
这推翻了大量路由代码里写死的一个假设:payload 变大时就把请求升级到更贵的模型。在 GPT-6 里,家族中最大的窗口位于价格表的最底部。一份 900,000 token 的文档装不进 Sol,却装得进 Luna。
算术直接由两个价格推出。把 Luna 的整个窗口填满一次,输入 token 花 $0.10。把 Sol 的 872,000 token 窗口填满一次,大约花 $1.74。以每百万 $4 的价格填满 Claude Opus 5.5 的 1M 窗口,要花 $4.00。同一量级的 payload,读取它的花费差了四十倍。
再把 OpenAI 的缓存工作叠加上去,差距进一步拉大。GPT-6 对缓存输入读取给 90% 折扣,所以一个在多次调用间保持缓存的 1M token 前缀,重新读取大约只花 $0.01 而不是 $0.10。OpenAI 还说 GPT-6 默认缓存命中率更高,改变推理 effort 或工具可用性不再让缓存失效,显式断点让你能控制缓存前缀在哪里结束。GitHub 报告称,在数十亿次请求中,需要重新处理的提示 token 减少了 50% 以上。
OpenAI 公布了什么
下面每个数字都来自 OpenAI 的发布材料。推理 effort 设置写在括号里,因为这些模型在不同 effort 档位下得分差别很大,一行不带 effort 设置的基准测试数字没法用。
| 基准测试 | GPT-6 Luna | 对照点 |
|---|---|---|
| DeepSWE 1.1 | 66.6%(max) | 与中等 effort 的 Claude Opus 5 和 Claude Fable 5 相当,单任务成本比 Opus 5 低 93%、比 Fable 5 低 96% |
| AutomationBench 1.0.6 | 比前代高出 5.4 个百分点(high) | 单任务成本低 58% |
| OSWorld 2.0 offline | 在 max effort 下击败 GPT-5.6 Sol(medium) | 成本约为其十分之一 |
| 事实性 | 在更高 effort 下与 GPT-5.6 Sol 持平 | 成本约为其百分之一 |
DeepSWE 这一行值得坐下来细看。一个每百万输入 token $0.10 的模型,在一个 agent 软件工程基准测试上拿到 66.6%,进入两个前沿模型中等 effort 的同一区间,单任务成本还比其中一个低 93%,这和廉价档位完全是两回事。这不意味着 Luna 能在你最难的活上取代前沿模型。它意味着“把这个路由给便宜模型”与“这个需要贵模型”之间的分界线移动了,而你在 2026 年 9 月之前画的这条线,现在画错了地方。
事实性这项结果最可能影响普通的产品工作。在事实准确度上与上一代中档持平,成本却只有它的大约百分之一,这正是 Luna 能用于面向用户的摘要和抽取、而不只是内部批处理任务的原因。
这里每一处对比都是针对 Claude Opus 5 的
注意那些行对标的是哪个 Claude 模型:Claude Opus 5。
Anthropic 在同一天发布了 Claude Opus 5.5,价格 $4/$20,而 Opus 5 是 $5/$25,并以 58 分拿下 Artificial Analysis 智能指数榜首,在 212 个模型中排名第一。OpenAI 的发布文章写在 Opus 5.5 存在之前,所以每一处针对 Opus 5 的单任务成本对比,对标的都是一个在文章发布后几小时内就被取代的模型。
这并不说明 OpenAI 的数字错了,对当时所做的那次对比而言它们是准确的。它意味着:你不该把“比 Opus 5 便宜 93%”当作当前市场状况写进采购文件,却不说明指的是哪个 Opus。没有任何厂商公布过 Luna 与 Opus 5.5 的正面对比,社交媒体上流传的对比来自个人测试者,而非两家的实验室。我们的价格战主文用一张表把三次发布相互对照。
延迟:便宜的模型不是快的模型
Artificial Analysis 的第三方测量显示,GPT-6 Luna 的输出速度为每秒 153.9 个 token,首 token 时间 124.23 秒。有两点需要说明,而且两点都关键。这些是第三方数字,不是厂商公布的。而且它们测的是 max 推理档位,也就是可用配置里最慢、最贵的那个。
即便带上这两点,方向也值得记住:Luna 的首 token 时间测得比 Sol 更慢,后者是 102.15 秒。在这个家族里,价格和延迟并不相关。首 token 到达前等两分钟,会突破默认 HTTP 客户端的超时、让负载均衡器判定为空闲、并超过大多数 serverless 运行时的执行上限。如果你要把某个同步接口路由到高 effort 的 Luna,集成工作花在你的超时和流式层上,而不是提示词上。
路由过去之前,先用自己的负载测一遍
基准测试表是聚合结果,你的提示词不是。真正有用的问题是:在你负担得起的 effort 档位下,Luna 在你的流量上扛不扛得住。认真回答这个问题大约要十分钟。
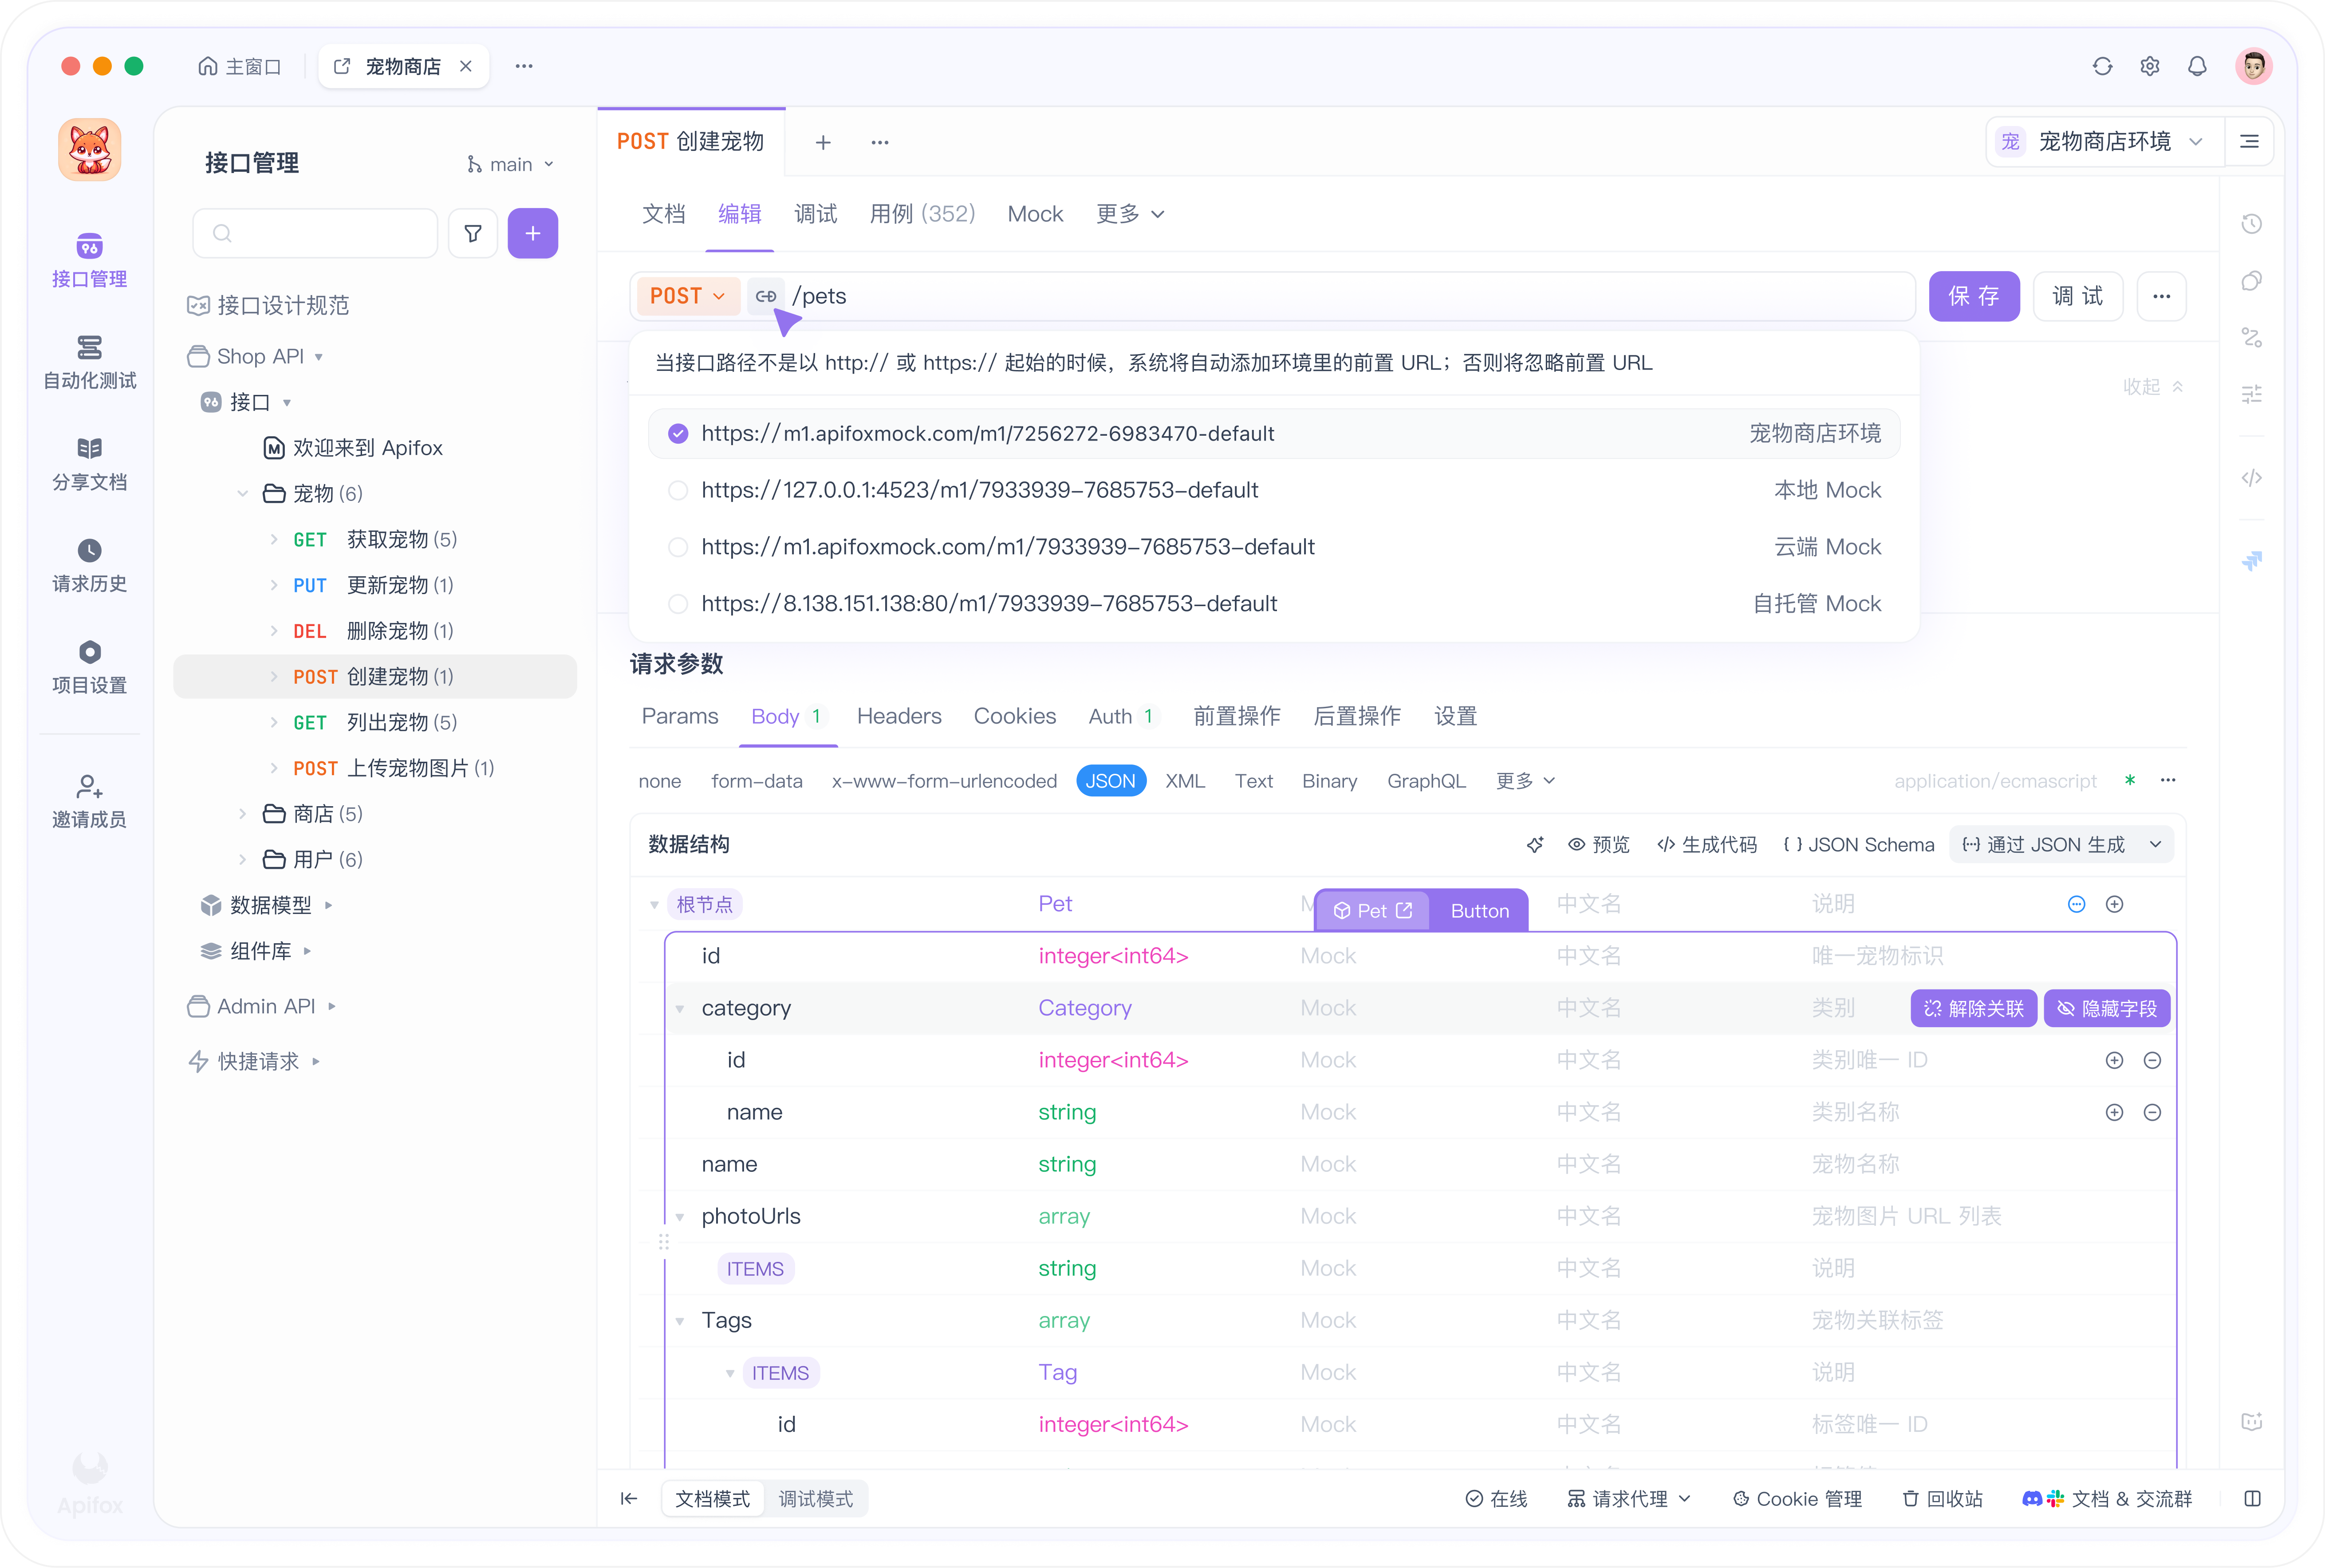
每个模型建一个请求,把模型 ID 参数化,把同一份 payload 在整条档位上跑一遍:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
在按这个形状动手之前,先对照 OpenAI 当前的模型参考确认接口和参数名。模型 ID gpt-6-luna 是从发布材料里确认下来的那一部分。
在 Apifox 里,同一个请求会变成一个保存下来的接口,模型 ID 作为环境变量,因此一个集合就能覆盖 Luna、Sol 和 Astra,不用重复任何东西。把它作为测试场景运行,你每次都能拿到响应时间和 token 用量,还能对响应结构加断言——这恰好能抓住更便宜模型的真实故障模式:不是答错,而是响应不再符合你解析器期望的 JSON Schema。把同一场景在三个 effort 档位上各跑一遍,你得到的就是针对自己提示词的成本、延迟和可靠性表,而不是别人的基准测试套件。
什么时候该选 Luna
当 payload 很大、任务定义清晰、并且你能以编程方式验证输出时,就路由到 Luna。文档抽取、规范解析、日志分诊、测试生成、大批量分类,以及任何一份 1M 窗口能省掉切分流水线的批处理任务,都符合条件;而当长前缀在多次调用间保持稳定时,缓存折扣会持续叠加。
把贵的那一档留给无法低成本校验答案的工作,以及任何对延迟敏感的工作——直到你在自己的流量上测过首 token 时间为止。Luna 移动了这条线,但没有抹掉它。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。

值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会

