Claude Opus 5.5 是 Anthropic 最新的 Opus 档位模型,于 2026 年 9 月 22 日发布。它与 OpenAI 发布 GPT-6 Sol 和 GPT-6 Luna 是同一天,所以那一周你的信息流都在争论每 token 价格,而不是去读两家的发布页。
如果你的配置文件里放着 claude-opus-5,这里简短说说换个 id 能换来什么。Opus 5.5 每百万输入 token $4、每百万输出 token $20,低于 Opus 5 的 $5 和 $25。它带 1,000,000 token 的上下文窗口和 128,000 token 的最大输出。Anthropic 说它的运行成本比 Opus 5 低 40%,输出速度快 30%,并且能在单个任务上持续 18 小时以上。在 Artificial Analysis 智能指数上,它以 58 分在 212 个模型中排名第一,不过该指数是第三方测量,不是厂商的说法。
本文涵盖规格表、Anthropic 公布的八项基准测试成绩、决定你真实账单的缓存算术,以及那些你应当拒绝做出的对比。下面的每个请求都是纯 HTTP 加 JSON,你可以在 Apifox 里构建并检查它。想了解两天内三次前沿发布的更大背景,见《2026 年 9 月模型价格战》。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

Claude Opus 5.5 一览
| 规格 | 值 |
|---|---|
| API 模型 ID | claude-opus-5-5 |
| 发布时间 | 2026 年 9 月 22 日 |
| 输入价格 | 每百万 token $4 |
| 输出价格 | 每百万 token $20 |
| 缓存输入读取 | 每百万 token $0.20 |
| 缓存写入 | 每百万 token $5 |
| 快速模式 | 每百万 token 输入 $8 / 输出 $40 |
| 上下文窗口 | 1,000,000 token |
| 最大输出 | 128,000 token |
| 相比 Opus 5 的运行成本 | 低 40%(据 Anthropic) |
| 相比 Opus 5 的输出速度 | 快 30%(据 Anthropic) |
| 持续任务时长 | 单任务 18+ 小时 |
| 安全性 | 成功绕过边界的尝试减少 85% |
| 可用平台 | Claude Platform、AWS、Google Cloud、Azure |
| Artificial Analysis 智能指数 | 58,212 个模型中排名第 1(第三方) |
有两行值得再看一眼。$0.20 的缓存读取价是标准输入价的 5%,这会改变哪些架构是负担得起的。而 18 小时这个数字说的是任务持续性,不是请求超时。这是两个非常不同的工程问题。
相比 Opus 5 改了什么
模型 id 是最明显的断裂点。Anthropic 的产品名带点,API id 不带点,所以 Claude Opus 5.5 是 claude-opus-5-5。在配置里做一次字符串替换,就是迁移的第一步。
| Claude Opus 5 | Claude Opus 5.5 | |
|---|---|---|
| API 模型 ID | claude-opus-5 |
claude-opus-5-5 |
| 每百万输入 | $5 | $4 |
| 每百万输出 | $25 | $20 |
这是计费表两边各降 20%。Anthropic 另外还说 Opus 5.5 的运行成本比 Opus 5 低 40%,那是另一种测量口径,值得分清楚。每 token 降价,加上完成同样工作所消耗的 token 更少,两者叠加会让单任务成本降得更多。每 token 成本是你能在发票上核对的东西。单任务成本是厂商在自己的评测上测出来的,所以在拿它做预算之前,先在你的工作负载上复现一遍。
其余的变化是行为层面的:输出快 30%,单个任务可持续工作 18 小时以上,成功绕过边界的尝试减少 85%。最后这个数字是一项范围很窄的安全声明,不是一个通用的“更安全”标签。我们的提示注入与 API 安全一文拆解了它到底测的是什么。想看上一代的规格表,见《Claude Opus 5 是什么》。
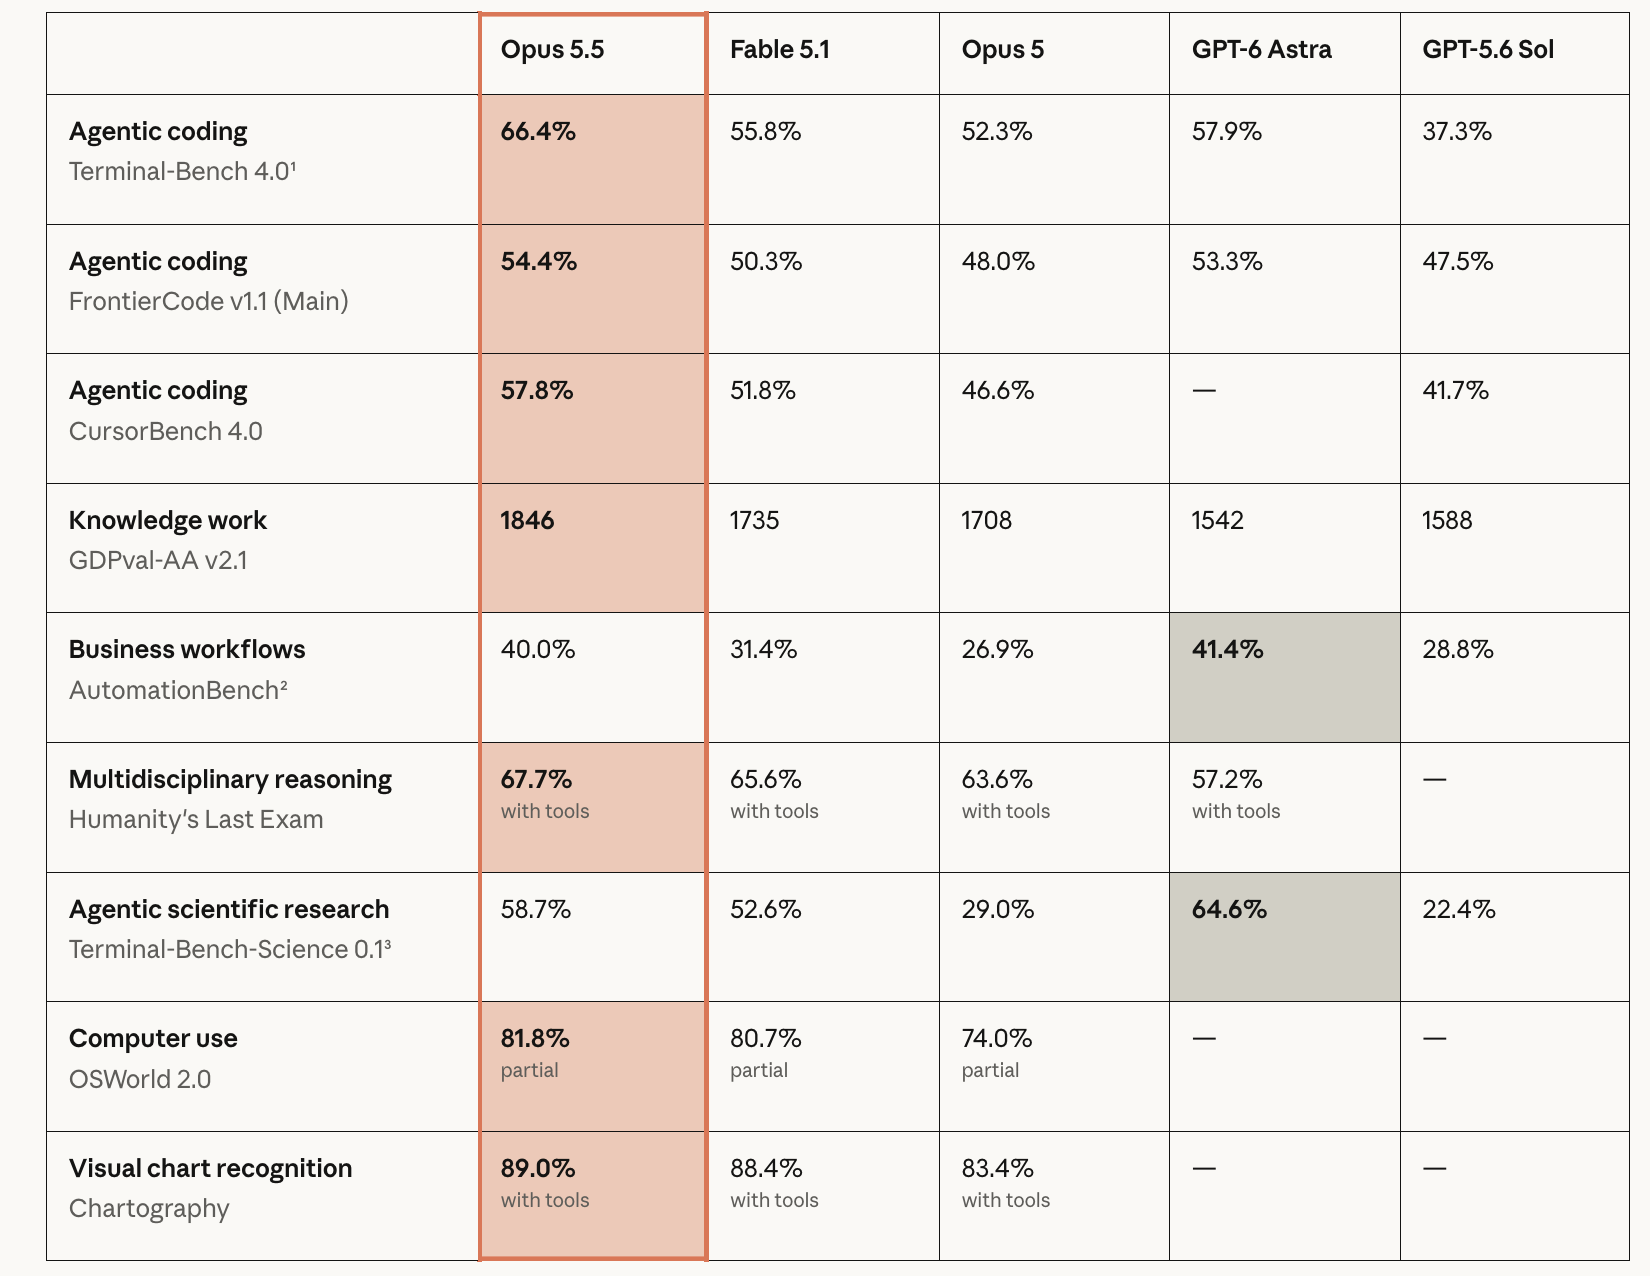
Anthropic 公布的八项基准测试成绩
这些是 Anthropic 在自己的发布材料里给出的、由它自己运行得出的数字。
| 基准测试 | Claude Opus 5.5 |
|---|---|
| Terminal-Bench 4.0 | 66.4% |
| FrontierCode v1.1 | 54.4% |
| CursorBench 4.0 | 57.8% |
| GDPval-AA v2.1 | 1846 Elo |
| AutomationBench | 40.0% |
| Humanity’s Last Exam(带工具) | 67.7% |
| OSWorld 2.0 | 81.8% |
| Chartography | 89.0% |
注意缺了什么:没有对手列。Anthropic 公布的是分数,不是对 GPT-6 的正面对照表,所以任何人拿这些行拼出一张整齐的 Opus 5.5 对 Astra 表格,都是自己拼的。
AutomationBench 是个陷阱,因为它同时出现在两家厂商的发布材料里。OpenAI 的数字来自 AutomationBench 1.0.6,其中 GPT-6 Sol 在 extra-high 推理下为 33.2%,GPT-6 Astra 在 low 下为 30.3%,Claude Opus 5 在 max 下为 26.9%。Anthropic 给 Opus 5.5 的 40.0% 来自它自己的一次运行,而我们核实过的材料里没有说明版本和 effort 档位。两家厂商、两套测试框架、两个 effort 设置,可能还是两个基准测试版本。不要把两者相减,然后把差值叫做领先。
Opus 5.5 在 9 月 22 日这一批里处于什么位置
| 模型 | API id | 输入 $/M | 输出 $/M | 上下文 | AA 指数 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 |
$4 | $20 | 1M | 58 |
| GPT-6 Sol | gpt-6-sol |
$2 | $10 | 872k | 48 |
| GPT-6 Luna | gpt-6-luna |
$0.10 | $0.50 | 1M | 37 |
| GPT-6 Astra | n/a | $10 | $50 | n/a | n/a |
| Claude Opus 5 | claude-opus-5 |
$5 | $25 | n/a | n/a |
| Grok 4.7 | n/a | $2 | $6 | n/a | n/a |
Artificial Analysis 那一列是第三方指数,不是厂商的说法,而且一个综合数字代表的是很多差异很大的任务。把它当作排序,不要当作判决。
关于时间点,有一件确实值得注意的事。OpenAI 的发布文章拿 Sol 和 Luna 对标 Claude Opus 5,因为那篇文章写出来的时候 Opus 5.5 还不存在。Anthropic 在几小时后就以比 Opus 5 低 20% 的价格发布了 Opus 5.5。所以那句被广泛引用的话——extra-high 的 Sol 以 9% 的单任务成本击败 max 的 Opus 5——按字面是真的,但对标的是一个当天就被取代的模型。没有人公布过重跑的结果。
反向的说法同样没有依据。OpenAI 表示 Astra “依然是我们在各方面表现最好的模型”,而两家厂商都没有公布 Astra 与 Opus 5.5 的对比。X 上流传的具体正面对比数字是推文,不是厂商数据。如果你需要这个答案,唯一诚实的来源是你自己的评测框架在你自己的任务上跑出来的结果。
决定你账单的缓存算术
在 $4 的输入价和 $0.20 的缓存读取价下,一次缓存命中只花一次全新读取的 5%。缓存写入按每百万 $5 计费,比标准输入价贵 25%。这个比例让盈亏平衡点变得很浅。
假设有一个 200,000 token 的系统前缀,包含工具 schema 加上你的一部分代码库或规范。不缓存的话,每次调用按每百万 $4 计费 200,000 token,也就是每次 $0.80。十次调用光输入就是 $8.00。
用缓存的话,你先付一次写入,按每百万 $5 计,也就是 $1.00;之后每次读取按每百万 $0.20 计,也就是 $0.04。十次调用花费 $1.00 加上九次读取各 $0.04,共 $1.36。写入的溢价在第一次重读时就还清了,到第十次调用时你只付了不缓存账单的约 17%。
到了上限,把整个 1,000,000 token 窗口发出去,作为全新输入要 $4.00,作为缓存读取只要 $0.20。这就是一个你能放进循环里反复跑的上下文策略和一个不能之间的差别。完整的缓存成本模型会走一遍 agent 循环和多租户前缀。
快速模式按输入 $8、输出 $40 计费,正好是标准费率的两倍。把它当作交互路径上买延迟的开销,不要当作默认选项。
18 小时的单任务会对你的 API 层做什么
一个能工作 18 小时的模型,不是一个更长的请求。它是一种不同的集成形态,而为 chat completions 写的大部分 API 代码都会在它上面崩掉。
有四件事需要注意。负载均衡器、网关和客户端的超时必须能容忍长连接流,否则你就需要一套任务加轮询的设计。重试必须是幂等的,因为重放一个已经烧掉三小时工具调用的请求,其代价远不是重试一个 GET 所能比的。流式需要 keepalive 处理,免得一条看起来空闲的连接在任务中途被回收。而可恢复性比吞吐更重要:如果进程在第 11 小时挂掉,你需要知道哪些状态是已经持久化的。《18 小时任务 API 设计》一文给出了每种情况的具体模式。
调用 Claude Opus 5.5
Messages API 的形式没有变化。换掉 id,并给 max_tokens 留出真实的余量。
curl https://api.anthropic.com/v1/messages \
  --header "x-api-key: $ANTHROPIC_API_KEY" \
  --header "anthropic-version: 2023-06-01" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-opus-5-5",
    "max_tokens": 16384,
    "messages": [
      {"role": "user", "content": "Review this handler and list the failure modes."}
    ]
  }'
两个习惯马上就有回报。把 key 放在环境变量里,这样它永远不会落进一个共享的集合。以及在每个响应里读 usage 块,因为那才是你确认缓存读取确实生效、而不是悄悄按每百万 $4 重新计费的地方。一个静默未命中的缓存,看起来和一个正常工作的集成一模一样,直到发票到来。
这正是 API 客户端体现价值的地方。在 Apifox 中,你可以保存一个基准 Messages 请求,为流式和非流式各复制一份,用同一个提示词跑两者,并对 usage 字段加断言,让缓存回退变成一次测试失败,而不是月底的意外。SSE 查看器还会显示一条长流实际在哪里停下。
可用平台
Anthropic 把 Opus 5.5 列在 Claude Platform、AWS、Google Cloud 和 Azure 上。消费级应用档位和知识截止日期不在我们核实过的材料里,所以我们两个都不写。在把截止日期写进系统提示词之前,先查一下 Anthropic 的模型页面。
你应该迁移吗?
如果你今天用的是 claude-opus-5,那就迁。同一个档位,两边每 token 都便宜 20%,公布的数字更好,唯一的成本是换 id 加上跑一轮回归。迁移说明里覆盖了调用方可见的细节。
如果你的工作负载便宜且量大,就多想一层。Opus 档位的定价不属于批量分类或抽取该待的地方,而 9 月的几场发布把 1M 上下文窗口带进了不到一美元的档位。在默认选 Opus 之前,先和那一档比一比。
在看到那一周任何跨厂商的说法时都要先测量,包括上面那张表。两个实验室在同一天发布了三个前沿模型,每一份公布的对比都是针对一个已经被替换掉的模型写的,而唯一能决定你结论的基准测试,就是跑在你自己请求上的那一套。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。

值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会

