Claude Opus 5.5 是 Anthropic 最新的 Opus 级模型,于 2026 年 9 月 22 日发布。它与 OpenAI 发布 GPT-6 Sol 和 GPT-6 Luna 是同一天,所以你那一周的信息流都在争论每 token 的价格,而不是去读任何一家的发布页。
如果你的配置文件里放着 claude-opus-5,下面简要说明换掉这个 ID 能带来什么。Opus 5.5 每百万输入 token $4、每百万输出 token $20,低于 Opus 5 的 $5 和 $25。它拥有 1,000,000 token 的上下文窗口和 128,000 token 的最大输出。Anthropic 称其运行成本比 Opus 5 低 40%、输出速度快 30%,并能在单个任务上持续工作 18 小时以上。在 Artificial Analysis 智能指数上,它以 58 分在 212 个模型中排名第一——不过该指数是第三方测量结果,不是厂商声明。
本文涵盖规格表、Anthropic 公布的八项基准成绩、决定你真实账单的缓存算法,以及那些你应当拒绝做的对比。下文每个请求都是普通的 HTTP + JSON,你可以在 Apifox 中构建并查看。关于两天内三次前沿模型发布的更大背景,请见 2026 年 9 月的模型价格战。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

Claude Opus 5.5 一览
| 项目 | 值 |
|---|---|
| API 模型 ID | claude-opus-5-5 |
| 发布时间 | 2026 年 9 月 22 日 |
| 输入价格 | 每百万 token $4 |
| 输出价格 | 每百万 token $20 |
| 缓存输入读取 | 每百万 token $0.20 |
| 缓存写入 | 每百万 token $5 |
| Fast 模式 | 每百万 token 输入 $8 / 输出 $40 |
| 上下文窗口 | 1,000,000 token |
| 最大输出 | 128,000 token |
| 相比 Opus 5 的运行成本 | 降低 40%(据 Anthropic) |
| 相比 Opus 5 的输出速度 | 快 30%(据 Anthropic) |
| 持续任务时长 | 单任务 18 小时以上 |
| 安全 | 成功绕过边界的尝试减少 85% |
| 可用平台 | Claude Platform、AWS、Google Cloud、Azure |
| Artificial Analysis 智能指数 | 58,212 个模型中排名第 1(第三方) |
有两行值得再看一眼。$0.20 的缓存读取价格是标准输入价格的 5%,这会改变哪些架构是负担得起的。而 18 小时指的是任务持续性,不是请求超时——这是两个完全不同的工程问题。
相比 Opus 5 改变了什么
最明显的断裂是模型 ID。Anthropic 用带点的产品名和不带点的 API ID,所以 Claude Opus 5.5 的 API ID 是 claude-opus-5-5。对配置做一次字符串替换是迁移的第一步。
| 项目 | Claude Opus 5 | Claude Opus 5.5 |
|---|---|---|
| API 模型 ID | claude-opus-5 | claude-opus-5-5 |
| 输入每百万 | $5 | $4 |
| 输出每百万 | $25 | $20 |
这是计价表两侧各降 20%。Anthropic 另外表示 Opus 5.5 的运行成本比 Opus 5 低 40%,这是另一个口径的测量,值得区分清楚。每 token 降价,加上完成同样工作所消耗的 token 更少,两者叠加才会带来每任务成本更大的降幅。每 token 成本是你在账单上能核对的东西;每任务成本则是厂商在自己的评测中测得的,所以在据此做预算之前,先在你的负载上复现一遍。
其余的差异是行为层面的:输出快 30%、单任务可持续工作 18 小时以上、成功绕过边界的尝试减少 85%。最后一个数字是一个范围很窄的安全声明,而不是一个通用的“更安全”标签。我们的提示注入与 API 安全一文拆解了它到底测的是什么。上一代的规格表见《什么是 Claude Opus 5》。
Anthropic 公布的八项基准成绩
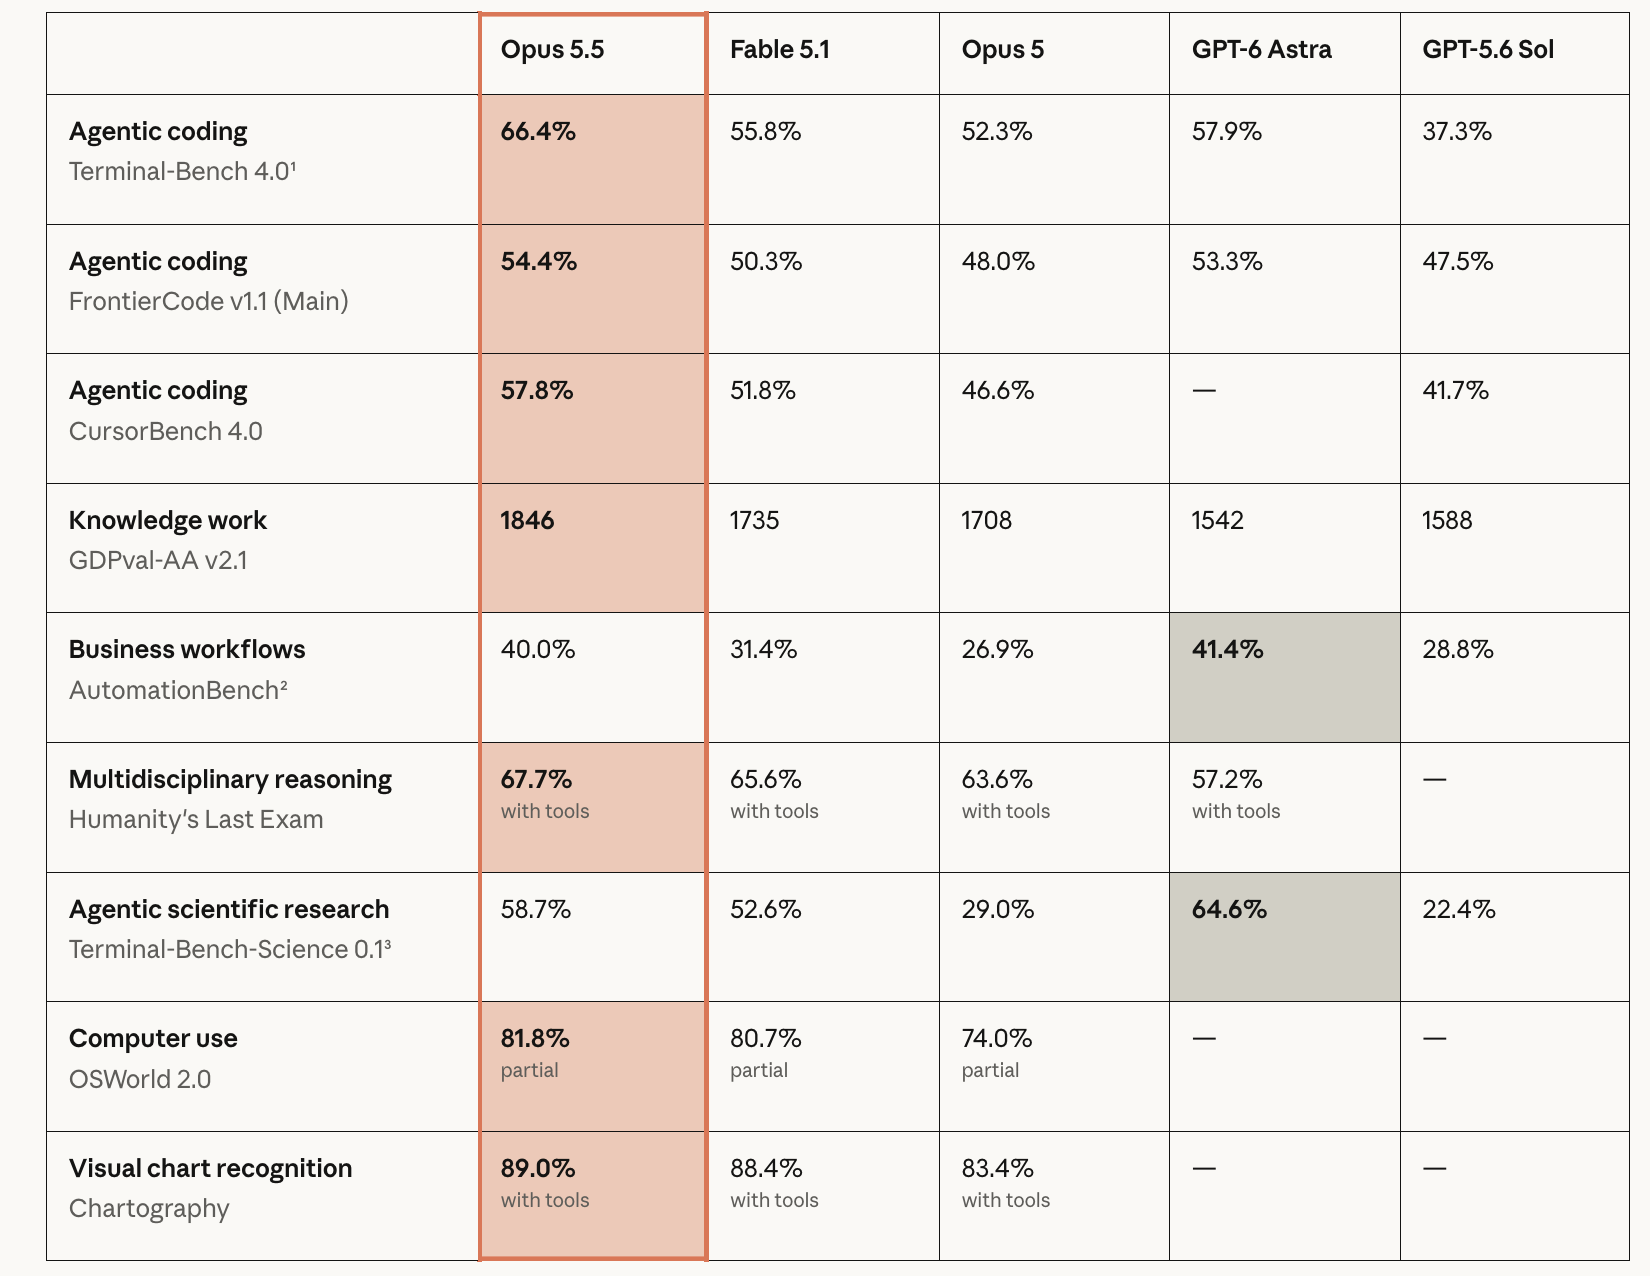
以下是 Anthropic 在其发布材料中给出、由其自行运行得到的数据。
| 基准 | Claude Opus 5.5 |
|---|---|
| Terminal-Bench 4.0 | 66.4% |
| FrontierCode v1.1 | 54.4% |
| CursorBench 4.0 | 57.8% |
| GDPval-AA v2.1 | 1846 Elo |
| AutomationBench | 40.0% |
| Humanity’s Last Exam(带工具) | 67.7% |
| OSWorld 2.0 | 81.8% |
| Chartography | 89.0% |
注意缺少了什么:对手的对照列。Anthropic 只公布了分数,而没有给出与 GPT-6 的正面对比表——所以如果有人给你看一张用这些数据拼出来的、整洁的“Opus 5.5 对比 Astra”表格,那是他自己组装的。
AutomationBench 是其中的陷阱,因为它同时出现在两家厂商的发布材料里。OpenAI 的数字来自 AutomationBench 1.0.6:GPT-6 Sol 在 extra-high 推理下为 33.2%,GPT-6 Astra 在 low 下为 30.3%,Claude Opus 5 在 max 下为 26.9%。Anthropic 给 Opus 5.5 的 40.0% 来自它自己的运行,而版本号和推理档位在我们核实的材料中并未说明。两家厂商、两套测试框架、两种推理档位,可能还有两个基准版本。不要把两者相减,然后把差值称为领先。
Opus 5.5 在 9 月 22 日这批模型中的位置
| 模型 | API ID | 输入 $/M | 输出 $/M | 上下文 | AA 指数 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | 1M | 58 |
| GPT-6 Sol | gpt-6-sol | $2 | $10 | 872k | 48 |
| GPT-6 Luna | gpt-6-luna | $0.10 | $0.50 | 1M | 37 |
| GPT-6 Astra | n/a | $10 | $50 | n/a | n/a |
| Claude Opus 5 | claude-opus-5 | $5 | $25 | n/a | n/a |
| Grok 4.7 | n/a | $2 | $6 | n/a | n/a |
Artificial Analysis 这一列是第三方指数,不是厂商声明,而且一个综合分数代表了许多非常不同的任务。把它当作排序依据,而不是结论。
关于时间点,有一件确实值得注意的事。OpenAI 的发布文章是把 Sol 和 Luna 与 Claude Opus 5 做对比的,因为那篇文章写作时 Opus 5.5 还不存在。Anthropic 在数小时后发布了 Opus 5.5,价格比 Opus 5 低 20%。所以那句被广泛引用的话——Sol 在 extra-high 下以每任务 9% 的成本胜过 max 档的 Opus 5——按原文是成立的,但它对比的是一个同一天就被取代的模型。至今没有人公布重跑的结果。
反向的说法同样没有依据。OpenAI 称 Astra“仍然是我们在所有方面最好的模型”,而两家厂商都没有公布 Astra 与 Opus 5.5 的对比。在 X 上流传的那些具体对比数字是推文,不是厂商数据。如果你需要答案,唯一诚实的来源就是你自己在自己的任务上跑的评测框架。
决定你账单的缓存算法
在 $4 输入和 $0.20 缓存读取下,一次缓存命中的成本是一次全新读取的 5%。缓存写入按每百万 $5 计费,比标准输入价格高 25%。这个比例让回本点很浅。
以一个 200,000 token 的系统前缀为例——比如一份工具 schema 加上你代码库或规范的一部分。不缓存时,每次调用计费 200,000 token × $4/百万,即每次 $0.80;十次调用仅输入就要 $8.00。
缓存后,写入一次按每百万 $5 计费,即 $1.00;之后每次读取按每百万 $0.20 计费,即 $0.04。十次调用是 $1.00 加上九次 $0.04 的读取,共 $1.36。写入溢价在第一次重读时就已收回,到第十次调用时你只付出了不缓存账单的约 17%。
在区间顶端,把完整的 1,000,000 token 窗口作为全新输入发送需要 $4.00,而作为缓存读取只需 $0.20。这正是“能放进循环里跑的上下文策略”和“跑不起来”之间的差别。完整缓存成本模型推演了 Agent 循环和多租户前缀的情况。
Fast 模式按输入 $8、输出 $40 计费,正好是标准价格的两倍。把它当作交互路径上的一次延迟采购,而不是默认选项。
18 小时的任务时长会对你的 API 层做什么
一个能工作 18 小时的模型并不是一个更长的请求,而是一种不同的集成形态,大多数为 chat completions 写的 API 代码都会在它上面出问题。
有四件事需要关注。负载均衡器、网关和客户端上的超时必须能容忍长时间存活的流,否则你就需要改成“提交任务 + 轮询”的设计。重试必须是幂等的,因为重放一个已经烧掉三小时工具调用的请求,其代价是重试一次 GET 永远无法相比的。流式需要处理 keepalive,以免一个看起来空闲的连接在任务中途被回收。而可恢复性比吞吐量更重要:如果进程在第 11 小时挂掉,你需要知道哪些状态是已经持久化的。18 小时任务的 API 设计一文用具体模式分别覆盖了这四点。
调用 Claude Opus 5.5
Messages API 的形态没有变化。换掉模型 ID,并给 max_tokens 留出真正的空间。
curl https://api.anthropic.com/v1/messages \
  --header "x-api-key: $ANTHROPIC_API_KEY" \
  --header "anthropic-version: 2023-06-01" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-opus-5-5",
    "max_tokens": 16384,
    "messages": [
      {"role": "user", "content": "Review this handler and list the failure modes."}
    ]
  }'
有两个习惯会立刻带来回报。把密钥放在环境变量里,这样它永远不会出现在共享的集合中。以及每次响应都读 usage 字段,因为你要在那里确认缓存读取确实生效,而不是在悄悄按每百万 $4 重新计费。一个静默未命中的缓存在账单到来之前,看起来和一个正常工作的集成完全一样。
这正是 API 客户端体现价值的地方。在 Apifox 里,你可以保存一个基准 Messages 请求,分别复制出流式和非流式两份,用相同的 prompt 运行,并对 usage 字段做断言,这样缓存退化会让测试失败,而不是在月底给你一个意外。SSE 查看器还能显示一个长流实际停在了哪里。导入上面的请求即可跟着操作。
可用平台
Anthropic 将 Opus 5.5 列在 Claude Platform、AWS、Google Cloud 和 Azure 上。消费级应用档位和知识截止日期不在我们核实的材料中,因此我们两者都不写。在把截止日期写进系统提示词之前,请查阅 Anthropic 的模型页。
你应该迁移吗?
如果你现在用的是 claude-opus-5,那就迁移。同一档位、两侧每 token 都便宜 20%、公布的指标更好,唯一成本是替换 ID 加跑一次回归。迁移说明覆盖了调用方可见的细节。
如果你的负载廉价且量很大,就要多想一层。Opus 档的定价并不适合批量分类或抽取,而 9 月的几次发布已经把 1M 上下文窗口带进了每百万不到一美元的档位。在默认选择 Opus 之前,先和那个档位比一比。
在相信那一周任何跨厂商的说法之前——包括上面那张表——先去测量。两家实验室在同一天发布了三个前沿模型,所有已公布的对比都是针对一个已经被取代的模型写的,而唯一能决定你选择的基准,是跑在你自己请求上的那一个。
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。