2026 年 7 月成为了开源权重前沿模型双雄争霸的月份,而且这两匹“黑马”都来自中国。月之暗面(Moonshot AI)于 7 月 16 日发布了 Kimi K3。三天后,阿里巴巴预告了 Qwen 3.8-Max,随后于 8 月初正式上线。两者都是万亿参数的混合专家(MoE)模型,也都承诺(或已提供)开源权重,并且都能接入类似 Claude Code 风格的智能体框架。此外,它们在价格上也都远低于美国的前沿实验室。
表面上的相似性掩盖了真正的差异:包括你目前实际能下载到什么、模型能够处理什么,以及一个月重度使用所需的费用。本次对比将逐一剖析截至 2026 年 8 月 3 日可以验证的每一个维度。欲了解阿里巴巴这款新旗舰的完整规格详解,可以先阅读我们的 Qwen 3.8-Max 解读文章,然后再阅读本文。
在开始之前,需要坦诚地说明一点:目前还没有针对这两个模型的独立第三方正面交锋评测。本文中的所有数据均来自厂商各自发布的数据表,且我们已标注了每组数据的出处。因此,请将基准测试部分的数据视为参考,而非最终结论。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
时间线:谁在何时发布了什么
在这里,发布的先后顺序比以往更为重要,因为目前“开源权重”对这两款模型而言有着不同的实际含义。
Kimi K3 于 2026 年 7 月 16 日发布。月之暗面在发布时承诺会开源权重,并在 11 天后兑现了诺言:7 月 27 日,该权重以 594 GB 的 MXFP4 格式正式上线 Hugging Face。截至今天,你已经可以下载 K3,并对其进行进一步量化,然后在自己的硬件上运行。这不再是一个口头承诺,而是已经成为现实。
Qwen 3.8-Max 于 7 月 19 日进行了预告,并于 8 月初在 Alibaba Cloud Model Studio 正式上线,具体内容可参阅 Qwen 官方发布博客。官方承诺将于“下周”(大约在 8 月 10 日左右)将权重上传至 Hugging Face 和 ModelScope。截至 2026 年 8 月 3 日,这些权重仍处于无法下载的状态。尽管 K3 在发布与开源权重之间也有 11 天的时间差,说明这种节奏很正常,但就目前而言,这两款模型中实际上只有一款真正实现了开源。
如果本地部署是你的决定性因素,那么单凭这一事实就可能让你提前做出选择。
Qwen 3.8-Max 是在这两个指标上都较小的模型:与 K3 相比,其总参数量少 4000 亿(400B),激活参数量少 90 亿(9B)。这两个差距都不算悬殊,而且激活参数量也并不能线性地转化为能力。但它们能直接转化为服务成本。在其他条件相同的情况下,每个 token 激活 950 亿(95B)参数的模型在规模化运行时的成本,要低于激活 1040 亿(104B)参数的模型,这种差异也体现在下文的 API 定价中。
对于自建托管的用户来说,更相关的数字是 K3 在 MXFP4 精度下 594 GB 的下载大小。甚至在考虑长上下文的 KV 缓存之前,这已经属于多节点(multi-node)的范畴了。可以预料,总参数量为 2.4T 的 Qwen 3.8-Max 在其文件发布时也会处于类似的量级。大多数团队都会为这两个模型使用托管接口,而将自建托管留给合规或研究场景。
如今的开放性:现成的权重 vs 远期的承诺
这个维度值得单开一节讨论,因为双方的营销口径都宣称“开放”,但事实却有所不同。
Kimi K3 的权重是公开的。你现在就可以验证仓库、检查许可证并拉取文件。这带来了真正开放所能实现的一切:第三方托管、社区量化、微调,以及确保你测试过的模型不会在背地里被悄悄替换。
Qwen 3.8-Max 将是首个发布开源权重的 Qwen-Max 级别的模型,这代表了阿里巴巴策略的真正转变,因为此前所有的 Max 级别模型都仅通过 API 提供。但“第一”只有在真正发生时才算数。在 Hugging Face 仓库上线之前,Qwen 3.8-Max 仍然只是一个伴随着发布公告的 API 模型。
目前在这一维度上,K3 略胜一筹,但我们可以在日程表上记下,在 8 月 10 日左右重新确认。如果阿里巴巴兑现承诺,这一维度的对比将打成平手,而比较的焦点将转移到许可证条款和量化质量上。
模态:Qwen 懂图像,K3 读文本
在这个维度上,差距则反了过来,而且差距非常悬殊。
根据官方模型配置("input_modalities": ["text", "image"]),Qwen 3.8-Max 支持文本和图像输入。阿里巴巴的发布文章甚至展示了通过记忆图谱实现对 200 多页 PDF 的长文档理解以及 100 小时的视频理解;不过,我们应该把这些看作是博客演示,而不是已记录在档的 API 输入类型。但是,图像输入是真实存在的,并且目前已经在 API 中可用。阿里巴巴的官方基准测试也偏向这一点:多模态测试表(MathVision 95.2、LogicVista 91.9、OSWorld-Verified 86.1,以及强大的 OCR 表现)是 Qwen 3.8-Max 取得压倒性优势的地方。
Kimi K3 是一个纯文本模型。如果你的工作负载涉及屏幕截图、扫描文档、UI 理解或任何与视觉相关的 Agent 任务,K3 就需要额外挂载一个独立的视觉模型到流水线中,这也意味着随之而来的胶水代码和额外的延迟。
对于纯文本编程和 Agent 工作,这一维度无关紧要。但对于文档智能和计算机操作(computer-use)Agent 而言,它则是决定性的。
上下文、输出与 API 表面
Qwen 3.8-Max 提供了 1,000,000 token 的上下文窗口(采用单一扁平层级),最大输出为 65,536 token。推理过程由 reasoning_effort 参数控制(默认为 xhigh,并提供 medium 和 low 选项),且默认保留思维输出。值得注意的是,思维模式和非思维模式的计费费率相同。
用户可以通过阿里云百炼(Alibaba Cloud Model Studio)进行访问,该平台提供三个区域的前置 URL(北京、新加坡、美东-弗吉尼亚),并且不同寻常地在同一个平台上支持两种协议形态:兼容 OpenAI 的接口和兼容 Anthropic 的接口。正是因为这种双协议接口,Qwen 3.8-Max 仅需配置 ANTHROPIC_BASE_URL 和 ANTHROPIC_MODEL=qwen3.8-max 即可直接接入 Claude Code。完整的模型阵容和区域可用性已记录在 Model Studio 模型页面中;如果您需要跨区域工作,可以使用类似 Apifox 的工具将每个前置 URL 存储为环境,并在它们之间进行切换,而无需编辑请求。
Kimi K3 同样支持 Anthropic 协议,并能嵌入 Claude Code 风格的框架中,这正是这两个模型竞争同一个生态位的原因:即“将您现有的 Agent 框架指向更便宜的前沿模型”。有关 K3 的接口详情和当前限制,请参阅我们的 Kimi K3 解析说明,而不是轻信自发布以来可能已经发生变化的数据。
价格:单一且简单 vs 低输入高输出
以下是公布的费率(每百万 token):
| 费率 | Qwen 3.8-Max | Kimi K3 |
|---|---|---|
| 输入 | $2.00 | $3.00 |
| 输出 | $6.00 | $15.00 |
| 缓存命中输入 | $0.20(输入费率的 10%) | $0.30 |
| 分层计费方式 | 整个 1M 上下文统一费率 | 按照 Moonshot 公布的方案 |
根据官方 Model Studio 价格页面,Qwen 3.8-Max 的输入价格为 $2,输出价格为 $6,无论是思维 token 还是非思维 token,从第 0 个 token 到第 1,000,000 个 token 都采用统一费率。显式缓存创建(Explicit cache creation)按输入费率的 125% 计费,缓存命中则按 10% 计费。此外还有免费额度:100 万 token,仅限新加坡区域,有效期 90 天。
K3 的费率为:缓存命中每百万 token 为 $0.30,输入每百万 token 为 $3,输出每百万 token 为 $15。
这项对比不能只看单一数字。在具有良好缓存规范的输入密集型工作负载(如长系统提示词、重复的文档上下文)中,这两个模型的实际成本差距比标价显示的要小:缓存的每百万 token 分别是 $0.20 和 $0.30,差距微乎其微。在输出密集型工作负载中,差距就拉开了:K3 的 $15 输出费率是 Qwen $6 的 2.5 倍。会产生大量推理和代码的 Agent 循环往往偏向于输出密集型,这在理论上更利于 Qwen 3.8-Max。
特别需要注意 Qwen 的一点是:reasoning_effort 默认为 xhigh,并且思维 token 是按输出计费的。实际账单可能会超出通过简单的输入/输出 token 估算得出的结果。如果您想在正式使用前进行成本建模,可以参考我们的 Qwen 3.8 价格分析,其中详细介绍了单项任务成本的示例。
基准测试:两家厂商的数据,缺少第三方裁判
这也是大多数对这两个模型进行比较的尝试容易出错的地方,因此让我们先明确究竟存在哪些数据。
存在的数据: 阿里巴巴发布了一份 Qwen 3.8-Max 与 Claude Opus 4.8、Fable 5、GPT-5.6 Sol 以及 Qwen 3.7-Max 的基准测试对比表。月之暗面(Moonshot)也针对类似的顶尖模型阵容,发布了其 Kimi K3 的上线对比表。两者都是由厂商自行运行测试的。
不存在的数据: 没有任何独立的第三方评估在相同的测试框架下将 Qwen 3.8-Max 和 Kimi K3 放在同一张表中进行对比。在撰写本文时,尚无针对 Qwen 3.8-Max 的 Artificial Analysis 数据。这两家厂商也没有将对方的模型纳入自己的基准测试中。
在此背景下,以下是双方在各自运行的测试中所声称的数据。
阿里巴巴的表格数据(由阿里巴巴运行,主要通过 Claude Code 测试框架执行,这是阿里巴巴自己透露的细节):
| Benchmark | Qwen 3.8-Max | Claude Opus 4.8 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 84.6 | 84.6 | 88.8 |
| SWE-bench Pro | 67.7 | 69.2 | 80.0 | 64.6 |
| PaperBench | 93.0 | 80.3 | 88.8 | 90.5 |
| GPQA Diamond | 92.6 | 92.0 | 92.6 | 94.1 |
| HLE | 43.6 | 45.7 | 53.3 | 47.2 |
阿里巴巴自身公布的数据中也包含明显的劣势:Qwen 3.8-Max 在 SWE-bench Pro 上落后 Fable 5 较多,且在 HLE 上落后于所有列出的模型。其表现突出的领域是 PaperBench、指令遵循(IFBench 82.8)以及多模态综合评测。其他几项引人注目的核心结果使用的是阿里巴巴自研的基准测试(如 QwenSWEBench、CoWorkBench 等),这些测试无法与其他模型进行交叉对比。
从月之暗面的角度来看,K3 的上线对比表显示,它在月之暗面主打的基准测试中击败了 Claude Opus 4.8,但在整体上落后于 Fable 5 和 GPT-5.6 Sol。我们在《Kimi K3 对比 Claude Opus 4.8》一文中探讨过这些声明及其局限性。
能否将这两个表格中重合的基准测试进行横向对比?当然可以,许多人也会这么做,但由于测试框架、外围脚手架(scaffolding)和采样设置各不相同,跨表解读最多只能起到参考作用。客观的总结是:两家厂商都表明其模型在智能体(agentic)任务上具有与美国顶尖模型竞争的实力,并在某些特定任务上领先。这两份表格都无法盖棺定论谁更强大。有关阿里巴巴数据的详细分析,请参阅我们的《Qwen 3.8 基准测试分析》。
在 Apifox 中进行你自己的真机实测
既然没有权威的裁判,那么最实用的基准测试就是针对你自己的业务场景进行的测试。这两个模型都提供了兼容 OpenAI 的 chat-completions 接口,这使得在 Apifox 中进行直观的对比测试变得非常简单。
设置两个环境,一个包含 DashScope 前置 URL 和 qwen3.8-max,另一个包含 Moonshot 的接口和 K3 模型 ID,每个环境都有其专属的 API key 变量。保存一个包含您的真实 prompt(来自您产品的实际任务,而非脑筋急转弯)的请求,并在不同环境之间切换,向两个模型发送相同的 payload。Apifox 的响应视图可以并排为您呈现状态、延迟和完整的 body,并且其 SSE 调试功能可以显示每个模型如何流式传输推理内容——如果您的 UI 需要渲染 thinking token,这一点至关重要。添加几个断言(响应数据模型、延迟上限、输出中的必要关键词),您就可以将感性的“直觉评估”(vibe check)转化为可重复的测试,以便在任一供应商发布更新时重新运行。免费下载 Apifox来进行对比;通过这两个接口运行十个 prompt 得到的结果,比任何供应商给出的数据表都更有说服力。
评分表
| 维度 | 当前胜者 | 注意事项 |
|---|---|---|
| 总参数量/活跃参数量 | Qwen 3.8-Max(更轻量:2.4T/95B 对比 2.8T/104B) | 参数量更小本身无所谓好坏;它主要代表了服务成本 |
| 开放权重(截至今天) | Kimi K3(已在 Hugging Face 上线,594 GB MXFP4) | Qwen 的权重预计将于 8 月 10 日左右发布;届时请重新核对,此维度可能很快会打平 |
| 模态 | Qwen 3.8-Max(文本 + 图像输入) | 宣称的视频/长文档支持多为博客演示,而非接口文档中记录的输入类型 |
| 上下文窗口 | Qwen 3.8-Max(1M 统一档位,最大输出 65,536) | 请针对您的具体使用场景,对照 Moonshot 的文档验证 K3 当前的限制 |
| 价格 | Qwen 3.8-Max($2/$6 统一费率 对比 $3/$15) | 默认的 xhigh 推理模式会增加 Qwen 的实际输出账单金额 |
| 基准测试 | 无法做出评判 | 双方的数据表均由供应商自行测试得出;目前不存在独立的正面交锋测试 |
| 测试框架生态 | 平手 | 两者都可以通过兼容 Anthropic 协议的接口直接接入 Claude Code 风格的测试框架中 |
| 兑现承诺的历史记录 | Kimi K3 | 发布 11 天后即交付了权重;而 Qwen 的承诺仍未兑现 |
如何选择
在以下情况下选择 Kimi K3:你本周就需要在自己的硬件上运行权重;你的合规要求需要一个可以锁定并进行审计的模型;或者你的工作负载是纯文本且输入量极大,以至于缓存定价起主导作用。
在以下情况下选择 Qwen 3.8-Max:你的工作负载涉及图像或文档;你需要生成大量的输出 token(如 Agent 循环、代码生成);或者你需要 1M token 的上下文,且不希望受到分档定价的意外干扰。
在以下情况下建议观望一周:开放权重是你评估这两个模型唯一的出发点。如果 Qwen 的权重确实如承诺般在 8 月 10 日左右发布,那么开放性维度的对比将重新洗牌,最终抉择将取决于模态、价格以及你自己的评估结果。
核心事实是,开发者在短短三周内就拥有了两个来自中国的、靠谱、低成本且兼容测试框架的前沿模型选择。无论你更倾向于哪一个,在将产品路线图绑定到任何一家供应商的数据表之前,都请先通过这两个接口运行你自己的 prompt。
为了在这场对决中全面评估 Qwen 3.8,了解阿里巴巴在底层实际做出了哪些改变会很有帮助——Qwen 3.8 与 Qwen 3.7 Max 之间的架构和基准测试差异,清晰地表明了哪些提升是结构性的,哪些是额外微调的结果。
FAQ
Kimi K3 比 Qwen 3.8-Max 更开放吗?
就目前而言,事实确实如此:K3 的权重自 2026 年 7 月 27 日起就已托管在 Hugging Face 上(594 GB,MXFP4),而 Qwen 3.8-Max 的权重承诺在 8 月 10 日左右发布,目前还无法下载。如果阿里巴巴兑现承诺,两者都将成为开源权重的领先模型,届时真正的差异将转向许可条款和社区支持。在此之前,只有 K3 可以进行本地部署;我们的本地 K3 指南解释了具体所需的配置。
Qwen 3.8-Max 和 Kimi K3,哪一个更擅长编程?
目前还没有人能给出客观坦诚的答案。两家厂商都发布了强劲的 agentic-coding 数据,但各自的评估都是在不同的条件下进行的,目前缺乏独立的直接对比测试。阿里巴巴自己的表格甚至显示 Qwen 3.8-Max 在 SWE-bench Pro 上输给了 Fable 5,这说明厂商的评测表确实承认了劣势,只是这些数据在不同厂商之间无法进行横向对比。在做出决定之前,建议先在你自己仓库的任务上运行这两个模型。
我可以在 Claude Code 中使用这两个模型吗?
可以。两者都提供了兼容 Anthropic 的接口。对于 Qwen 3.8-Max,请根据阿里巴巴发布贴中的配置,将 ANTHROPIC_BASE_URL 设置为 DashScope 的 Anthropic 接口,并将 ANTHROPIC_MODEL=qwen3.8-max。K3 也支持同样的模式,只需通过 Moonshot 的接口配置即可。这种共享测试框架的兼容性,使得对这两者进行 A/B 测试的搭建成本变得非常低。
对于典型的智能体(agent)工作负载,哪一个更便宜?
从目录价来看,Qwen 3.8-Max 更便宜:每百万 token 的价格为 $2/$6,而 K3 为 $3/$15。智能体循环(agent loops)往往更偏向于输出 token,在这方面两者的差距达到了 2.5 倍。但有两个限制条件:第一,K3 仅为 $0.30 的缓存命中率使得高输入、高缓存命中的工作负载依然具有竞争力;第二,Qwen 默认的 xhigh 推理力度(reasoning effort)会将思考过程计入输出计费,因此其实际使用成本会高于简单的预估。在认定标价决定一切之前,建议先根据您自己的 token 组合进行成本建模。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
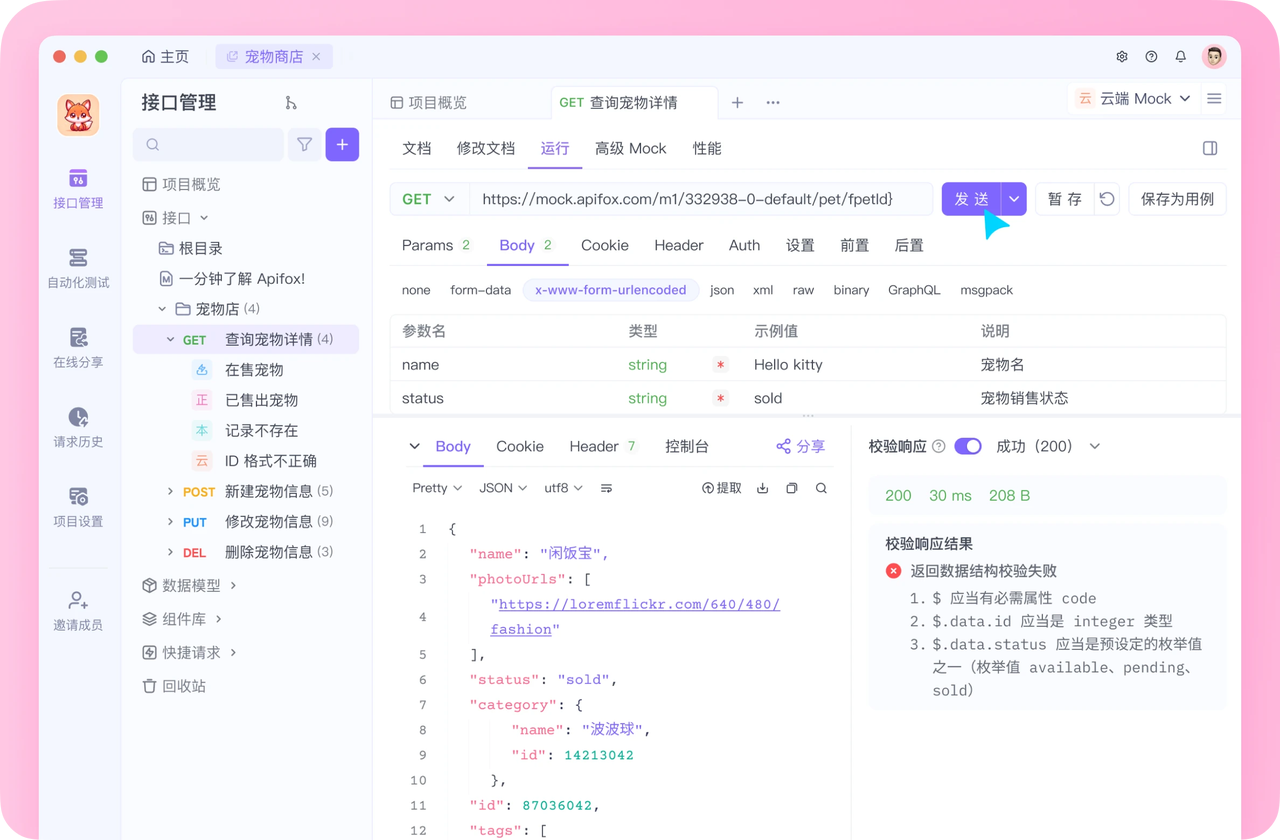
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会