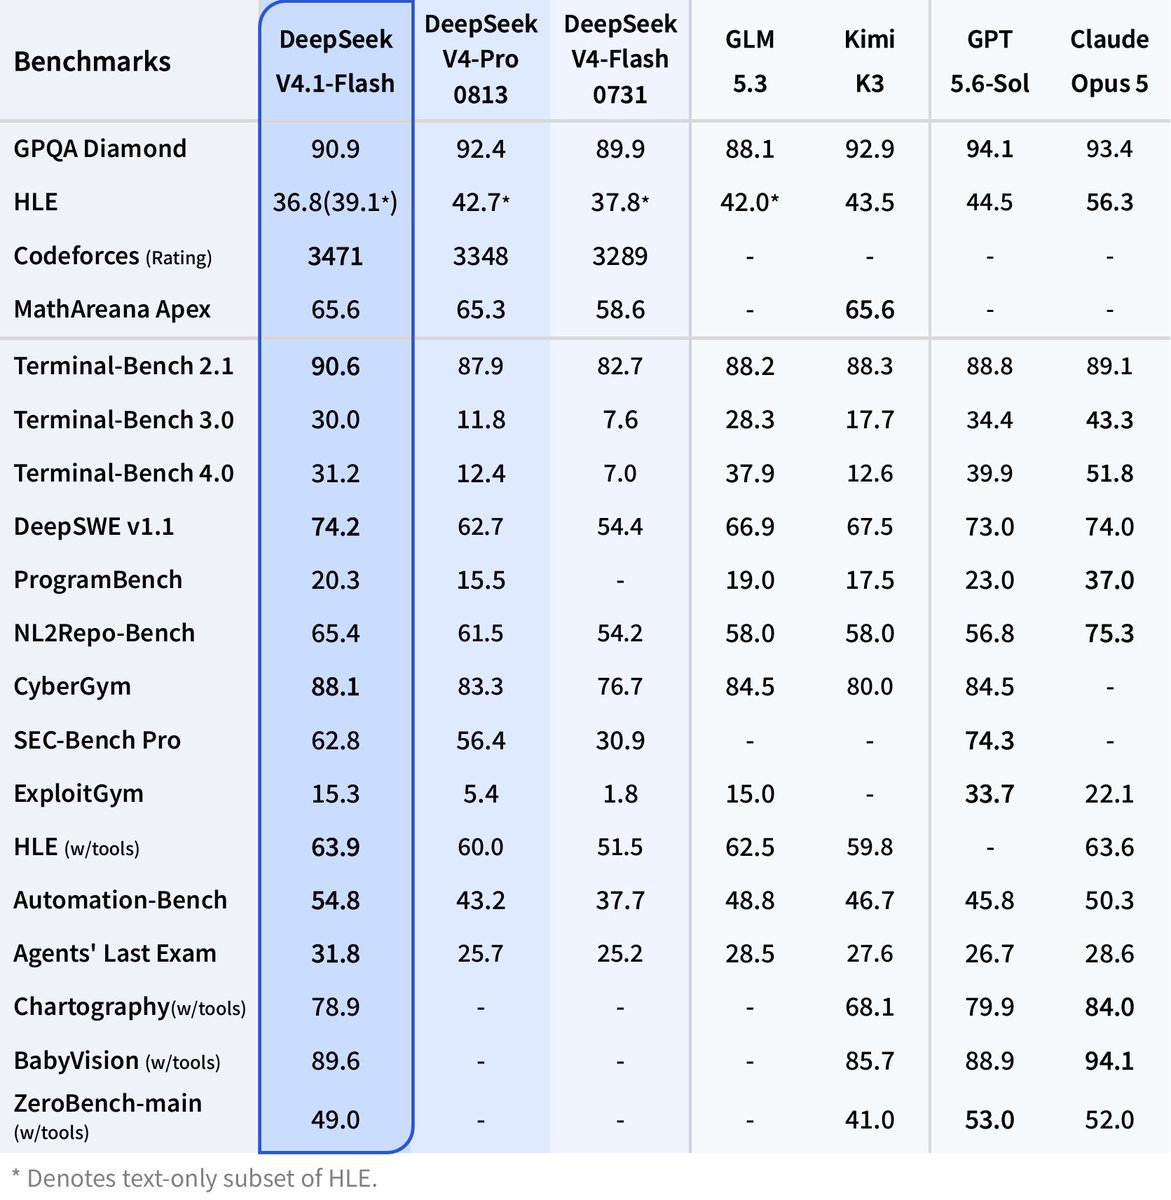
DeepSeek 在 2026 年 9 月 10 日发布了 DeepSeek-V4.1-Flash 的模型卡,而里面的数字对 V4-Pro 用户来说有点尴尬。这个更小、更便宜的模型,在 DeepSeek 列出的每一项编码和 Agent 基准测试上都高于旗舰型号,高峰时段每 token 成本低 70% 到 77%,并且从 9 月 14 日起它会完全吸收 V4-Pro:所有 deepseek-v4-pro 请求都会被路由到 V4.1-Flash,并按 Flash 的价格计费。
这不是常见的“小模型对大模型”的取舍,而是一场带有截止时间的对比。如果你在生产环境里跑 V4-Pro,你只有四天时间去搞清楚重路由生效后会发生什么变化。如果你跑的是 V4-Flash,变化已经发生:今天 deepseek-v4-flash 这个名字已经由 V4.1-Flash 提供服务。
下面依次是:三款模型在架构、DeepSeek 公布的基准测试、美元定价和吞吐上的对比,然后是一套工作流,让你在切换前用同一组 prompt 分别在 Apifox 里跑 deepseek-v4-pro 和 deepseek-flash,对比输出、延迟和用量计数。想深入了解架构,先读 DeepSeek-V4.1-Flash 是什么;迁移清单请见 V4-Pro 退役指南。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

TL;DR
- V4.1-Flash 在 DeepSeek 自家基准测试上胜出。 最亮眼的是 DeepSWE v1.1:74.2,而 V4-Pro 是 62.7,V4-Flash 是 54.4。
- 它是三者中最便宜的。 高峰时段缓存未命中的输入价格为每 100 万 token $0.30,而 V4-Pro 是 $1.32,旧的 V4-Flash 是 $0.44。
- 它是为吞吐而生的。 prefill 阶段 8B 激活参数,KV cache 每 token 890 字节,并发上限 2,500。
- 9 月 14 日之后只剩一个选择。 V4-Pro 的流量会重路由到 V4.1-Flash。问题变成你会得到什么、失去什么,而不是选哪一个。
规格对比
V4.1 这一代是全新架构,不是重新做后训练。DeepSeek 称其为 Causal Encoder-Decoder(CED):40 层拆成 20 层 encoder 和 20 层 decoder,每层有 384 个路由专家外加 1 个共享专家。模型卡显示主干网络为 552B 参数(含视觉编码器为 763B)。
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| 架构代际 | V4 MoE | V4 MoE | V4.1 Causal Encoder-Decoder,40 层 |
| 总参数 | 284B(OpenRouter 上视觉版本的列表值) | 此处未披露 | 552B 主干,含视觉编码器 763B |
| 激活参数 | 13B | 此处未披露 | prefill 8B,decode 16B |
| 上下文窗口 | 1M tokens | 1M tokens | 1M tokens |
| 最大输出 | 384K tokens | 384K tokens | 384K tokens |
| 视觉 | 独立的 Vision-Exp 版本 | 此处未披露 | 原生支持,DeepSeek-ViT 编码器 |
| 许可证 | 此处未涉及 | 此处未涉及 | MIT,权重发布在 Hugging Face |
| 并发上限 | 2,500 | 500 | 2,500 |
| API 状态 | 已退役,别名由 V4.1-Flash 提供服务 | 9 月 14 日重路由至 V4.1-Flash | 自 9 月 10 日起 GA,模型 id 为 deepseek-flash |
值得注意的细节是激活参数的拆分:V4-Flash 每个 token 都花 13B,而 V4.1-Flash 在输入上花 8B、在输出上花 16B,而质量恰恰在输出上。
基准测试:这 11.5 分从哪来
下面的每一个数字都来自模型卡,由 DeepSeek 自己报告。目前没有公开发表的独立测试结果,退役通知里那句“由多方测试”也没有点出是谁。请把它们当作厂商声明,用自己的 prompt 去验证。
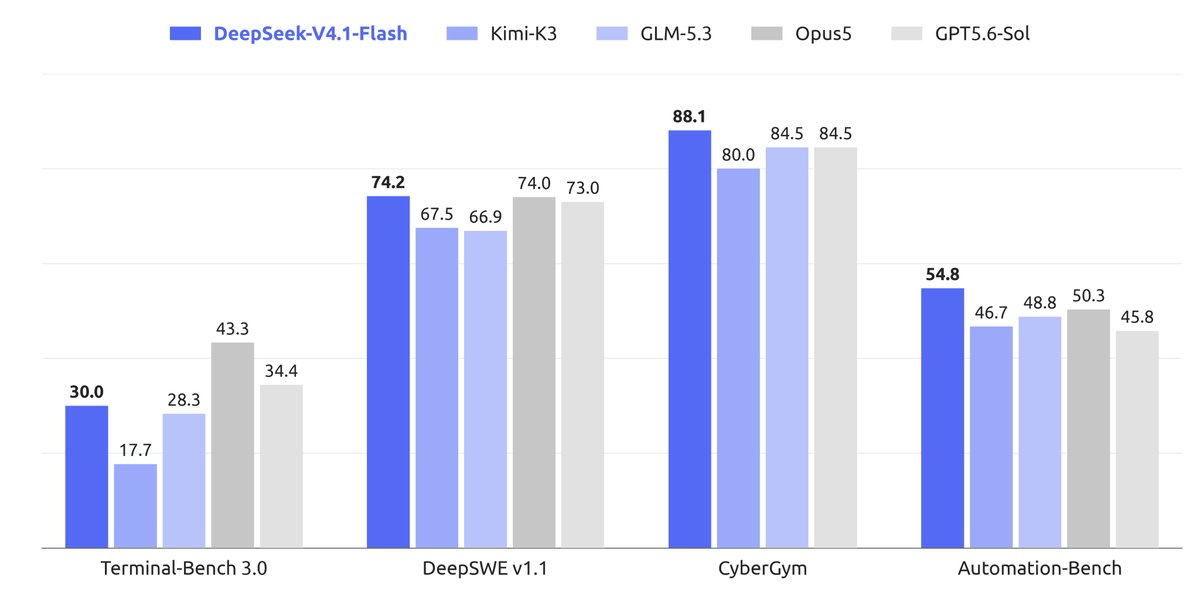
DeepSWE v1.1(比 Pro 高 11.5,比 V4-Flash 高 19.8)。 这是最亮眼的数字,也是唯一大到足以改变决策的差距。DeepSWE 衡量的是多文件软件工程任务,也就是编码 Agent 整天都在跑的工作负载。如果它在你自己的仓库上成立,那 V4.1-Flash 的编码能力就超过了贵四倍的模型。
Terminal-Bench 2.1(+2.7)。 Shell 驱动的 Agent 任务。V4-Flash-0731 在 7 月就已经在这项上赢了 V4-Pro-Preview;V4.1 把领先优势扩大到接近 3 分。是真实提升,但不算决定性。
HumanEval(+2.6)和 GSM8K(+0.4)。 两项都接近饱和:所有模型在 GSM8K 上都超过 90,而 HumanEval 对生产代码的参考价值有限。不要给这两行太大权重。
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 里有 V4 一代与其他开源模型的数字对比;但都还没有包含 V4.1。
成本:三款模型,六档价格
高峰时段是周一至周五的 01:00 到 04:00 以及 06:00 到 10:00 UTC,其余时间都是非高峰,价格减半。费率均为每 100 万 token,出自定价页,自 9 月 10 日起生效。V4-Flash 的两行使用它 2026 年 8 月 21 日的美元费率,作为“变更前”的对照列。
| 模型与档位 | 输入,缓存命中 | 输入,缓存未命中 | 输出 |
|---|---|---|---|
| V4-Flash,非高峰(8 月 21 日费率) | $0.007 | $0.22 | $0.66 |
| V4-Flash,高峰(8 月 21 日费率) | $0.014 | $0.44 | $1.32 |
| V4-Pro,非高峰 | $0.022 | $0.66 | $1.98 |
| V4-Pro,高峰 | $0.044 | $1.32 | $3.96 |
| V4.1-Flash,非高峰 | $0.003 | $0.15 | $0.60 |
| V4.1-Flash,高峰 | $0.006 | $0.30 | $1.20 |
相比 V4-Flash,V4.1 把缓存命中输入降低约 57%,缓存未命中输入降低约 32%,输出降低约 9%。相比 V4-Pro,高峰时段的缓存未命中输入降低 77%,输出降低 70%。
一个月的实例测算。 假设某个编码 Agent 每月处理 2B 输入 token,缓存命中率 70%(system prompt 和仓库上下文在多轮之间复用),并产生 300M 输出 token,全部按高峰时段计。
| V4-Pro,高峰 | V4-Flash,高峰 | V4.1-Flash,高峰 | V4.1-Flash,非高峰 | |
|---|---|---|---|---|
| 1.4B 缓存命中输入 | $61.60 | $19.60 | $8.40 | $4.20 |
| 600M 缓存未命中输入 | $792.00 | $264.00 | $180.00 | $90.00 |
| 300M 输出 | $1,188.00 | $396.00 | $360.00 | $180.00 |
| 月度合计 | $2,041.60 | $679.60 | $548.40 | $274.20 |
这比 V4-Pro 少 73%,把批处理任务挪到非高峰时段还能再减半。输出 token 在每一列里都占大头,所以输出降价 70% 比缓存命中那个标题数字更重要。V4.1-Flash 定价拆解里有缓存命中的算法说明。
速度与吞吐
DeepSeek 没有公布每秒 token 数,所以吞吐这件事只能靠三个架构事实和一个轶事来支撑。
- KV cache 每 token 890 字节。 FP4 主 KV 缓存把全局缓存压到大约 V4-Flash 的四分之一。发布说明里写的是上一代 HBM 的 1/4、SSD 存储的 1/8。完整的 1M token 上下文大约需要 0.9 GB 缓存。
- prefill 阶段 8B 激活参数。 每个输入 token 的计算量低于 V4-Flash 的 13B,所以大上下文下的首 token 延迟应该会下降。
- 并发 2,500 对 500。 被重路由的 V4-Pro 流量会继承 Flash 的上限,对 Agent 集群来说是 5 倍的提升。
- 一位用户的报告:“接近 400 t/s”。 一位 X 用户在 beta 期间通过视频测试发了这个数字;这是轶事,不是基准测试。HN beta 帖里也基本是同样的热情。
在相信这一切之前,先测你自己的 p50 和 p95。
9 月 14 日之后你会失去什么、得到什么
切换之后就不存在“该选哪个模型”这个问题了。deepseek-v4-pro 会变成一个别名,所以更诚实的说法是列一张收支表。
你会得到: 所有列出的基准测试分数都更高、高峰价格低 70% 到 77%、5 倍并发、不需要单独的视觉模型 id 就能原生输入图片,以及一个 DeepSeek 称为可在 1 到 100 之间连续调节的 reasoning-effort 旋钮。
你会失去: 锁定 V4 一代 checkpoint 的能力。为 V4-Pro 的风格、啰嗦程度或 tool call 格式调过的 prompt 可能会漂移。输出长度和 reasoning token 数量可能变化,而这会以费率表看不出来的方式改变你的账单。而且重路由是按 DeepSeek 的时间表发生,不是按你的。
正因为有这第二条清单,你才应该在 14 日之前做对比,而不是之后。
切换前在 Apifox 里对比 V4-Pro 和 V4.1-Flash
Apifox 测的是 API 层,所以它正是用同一组 prompt 跑两个 model id、并对比返回结果的地方。
- 添加接口。 新建一个项目并添加
POST https://api.deepseek.com/chat/completions,或者导入 OpenAPI 规范。 - 把 key 和 model id 放进环境。 存好
DEEPSEEK_API_KEY和一个MODEL变量。创建两个环境:v4-pro用MODEL=deepseek-v4-pro,v41-flash用MODEL=deepseek-flash,然后分别以Bearer {{DEEPSEEK_API_KEY}}放在 header 里、"model": "{{MODEL}}"放在 body 里引用。 - 把真实 prompt 存成请求。 挑 20 到 30 条能代表生产环境的 prompt:你的 system prompt、一轮 tool call、一次长上下文摘要、一次多文件代码修改。每条都用
stream: false保存,这样usage对象会出现在响应体里。 - 对影响账单的字段做断言。 用保存的请求构建一个测试场景,并对
usage.prompt_tokens、usage.completion_tokens和usage.prompt_cache_hit_tokens添加断言。记录每一步的响应时间,再加一个前置脚本,把环境名写进 header,方便给每次运行打标签。 - 每个环境各跑一次,然后对比。 先在
v4-pro下跑场景,再在v41-flash下跑。对比 completion token 数(重路由会改变你的输出账单)、每一步的延迟,以及内容本身是否有格式漂移。 - 14 日在 CI 里重跑。 切换时在你的流水线里用
apidog-cli跑同一个场景。重路由弄坏的东西会变成一条失败的断言,而不是一张支持工单。
同样的对比,用脚本实现:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
FAQ
V4.1-Flash 在编码上比 V4-Pro 更好吗? 按 DeepSeek 公布的数字,是的:DeepSWE v1.1 上是 74.2 对 62.7,Terminal-Bench 2.1 上是 90.6 对 87.9。关于 V4 一代与 Claude 在编码上的对比,见 DeepSeek V4 与 Claude Opus 编码对比。
9 月 14 日我的 V4-Pro 集成会怎么样? 从 04:00 UTC 起,每个 deepseek-v4-pro 请求都由 V4.1-Flash 提供服务,并按 Flash 的费率计费。你的代码照常能跑,只是背后的模型换了。完整清单见迁移指南。
我需要把 deepseek-v4-flash 改名成 deepseek-flash 吗? 目前不用。deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 仍然被接受,并由 V4.1-Flash 提供服务。DeepSeek 还没有给出下线日期,所以下次动配置的时候顺手换成 deepseek-flash 就行。
V4.1-Flash 比 V4-Pro 更快吗? DeepSeek 说是,但没有公布任何数字。架构支持这个说法:prefill 阶段 8B 激活参数,KV cache 只有 V4-Flash 的四分之一。还是自己测吧。
我还能在别的地方跑 V4-Pro 吗? 14 日之后不能在 DeepSeek 的 API 上跑。V4 一代的背景见《DeepSeek V4 是什么》;V4.1-Flash 的权重以 MIT 许可发布在 Hugging Face 上。
简而言之
V4.1-Flash 同时做到了更小、更便宜、分数更高——至少在厂商的表格上是这样,而那张表格没法告诉你它对不对你的 prompt 更管用。这周就在 Apifox 里用同一组 prompt 跑这两个 model id,把差异留档,你就能在用户之前知道 9 月 14 日会发生什么。
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。