阿里巴巴 Qwen 团队于 2026 年 9 月 20 日开源了 Qwen-Image-2.1。它是一个同时支持文生图与图像编辑的模型,视觉生成部分有 7B 参数,并且能根据提示词直接输出透明 PNG,而不是靠背景移除后处理来伪造透明效果。发布博文列出了四项变化:更轻更快的架构、原生透明通道、最多 10 张参考图的编辑,以及更好的排版与人像细节。权重托管在Hugging Face和 ModelScope 上,代码在GitHub。
模型卡里有一句话比任何功能都重要:许可证是 Qwen Research License,而不是 Apache 2.0。商用需要另行签订协议。如果你在为产品评估 2.1,先读许可证那一节再看跑分。如果你想真正跑起来,Qwen-Image-2.1 实战指南提供了 diffusers 代码和一个可以在Apifox里测试的 HTTP 封装。如果你在拿它和托管的 Qwen Image 3.0 API 做权衡,2.1 与 3.0 对比就是帮你做决定的那篇文章。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

Qwen-Image-2.1 一览
| 项目 | 详情(来源:发布博文、模型卡、GitHub README) |
|---|---|
| 发布日期 | 2026 年 9 月 20 日 |
| 功能定位 | 文生图与图像编辑二合一,支持透明(RGBA)输出 |
| 视觉生成器 | 32 层 Single-Stream DiT,7B 参数 |
| 文本编码器 | Qwen3-VL 8B |
| VAE | 64 通道 RGBA 自编码器,16 倍空间压缩 |
| 默认输出 | 2048 x 2048;7 种长宽比,最大 2752 x 1536 |
| 参考图像 | 单次编辑最多 10 张 |
| 局部编辑 | 画圈标记、涂抹标注,或单独提供 mask 图像 |
| 配套模型 | Qwen-Image-2.1-PE-T2I 与 PE-I2I 提示词重写模型(Qwen3.5-VL 9B 微调) |
| 许可证 | Qwen Research License Agreement;商用需另行获取许可 |
| 试用渠道 | Hugging Face Space、Qwen Chat、ComfyUI(发布当天起原生支持) |
在 Qwen-Image 产品线中的位置
初代 Qwen-Image于 2025 年 8 月发布,是一个以文字渲染见长的 20B MMDiT 模型,编辑能力则由独立的Qwen-Image-Edit承担。到 2025 年底,这条产品线进一步分化:主打真实感的 2512 refresh、面向多人一致性的 Edit-2511,以及 12 月推出、用于透明分层的 Qwen-Image-Layered。Qwen-Image-2.0则于 2026 年 2 月把生成与编辑合并进一个 7B 模型,并原生支持 2K 输出。
2.1 保留了 2.0 的体量与统一设计,并吸收了 Layered 模型的透明通道能力,过去需要三个模型覆盖的场景,现在一个 checkpoint 就够。它还引入了一条新的推理路径(下文详述)和一套围绕 mask 与多参考图构建的编辑接口。与此同时,阿里还在运营一条托管产品线:Qwen Image 3.0 和 3.0 Pro 于 2026 年 7 月发布,是只提供 API、不开放权重的模型。所以这套命名是一个分叉,而不是先后序列:2.1 是你下载到本地的开源模型,3.0 是你按量租用的模型。
2.1 有哪些新东西
更轻的架构与更快的编辑路径
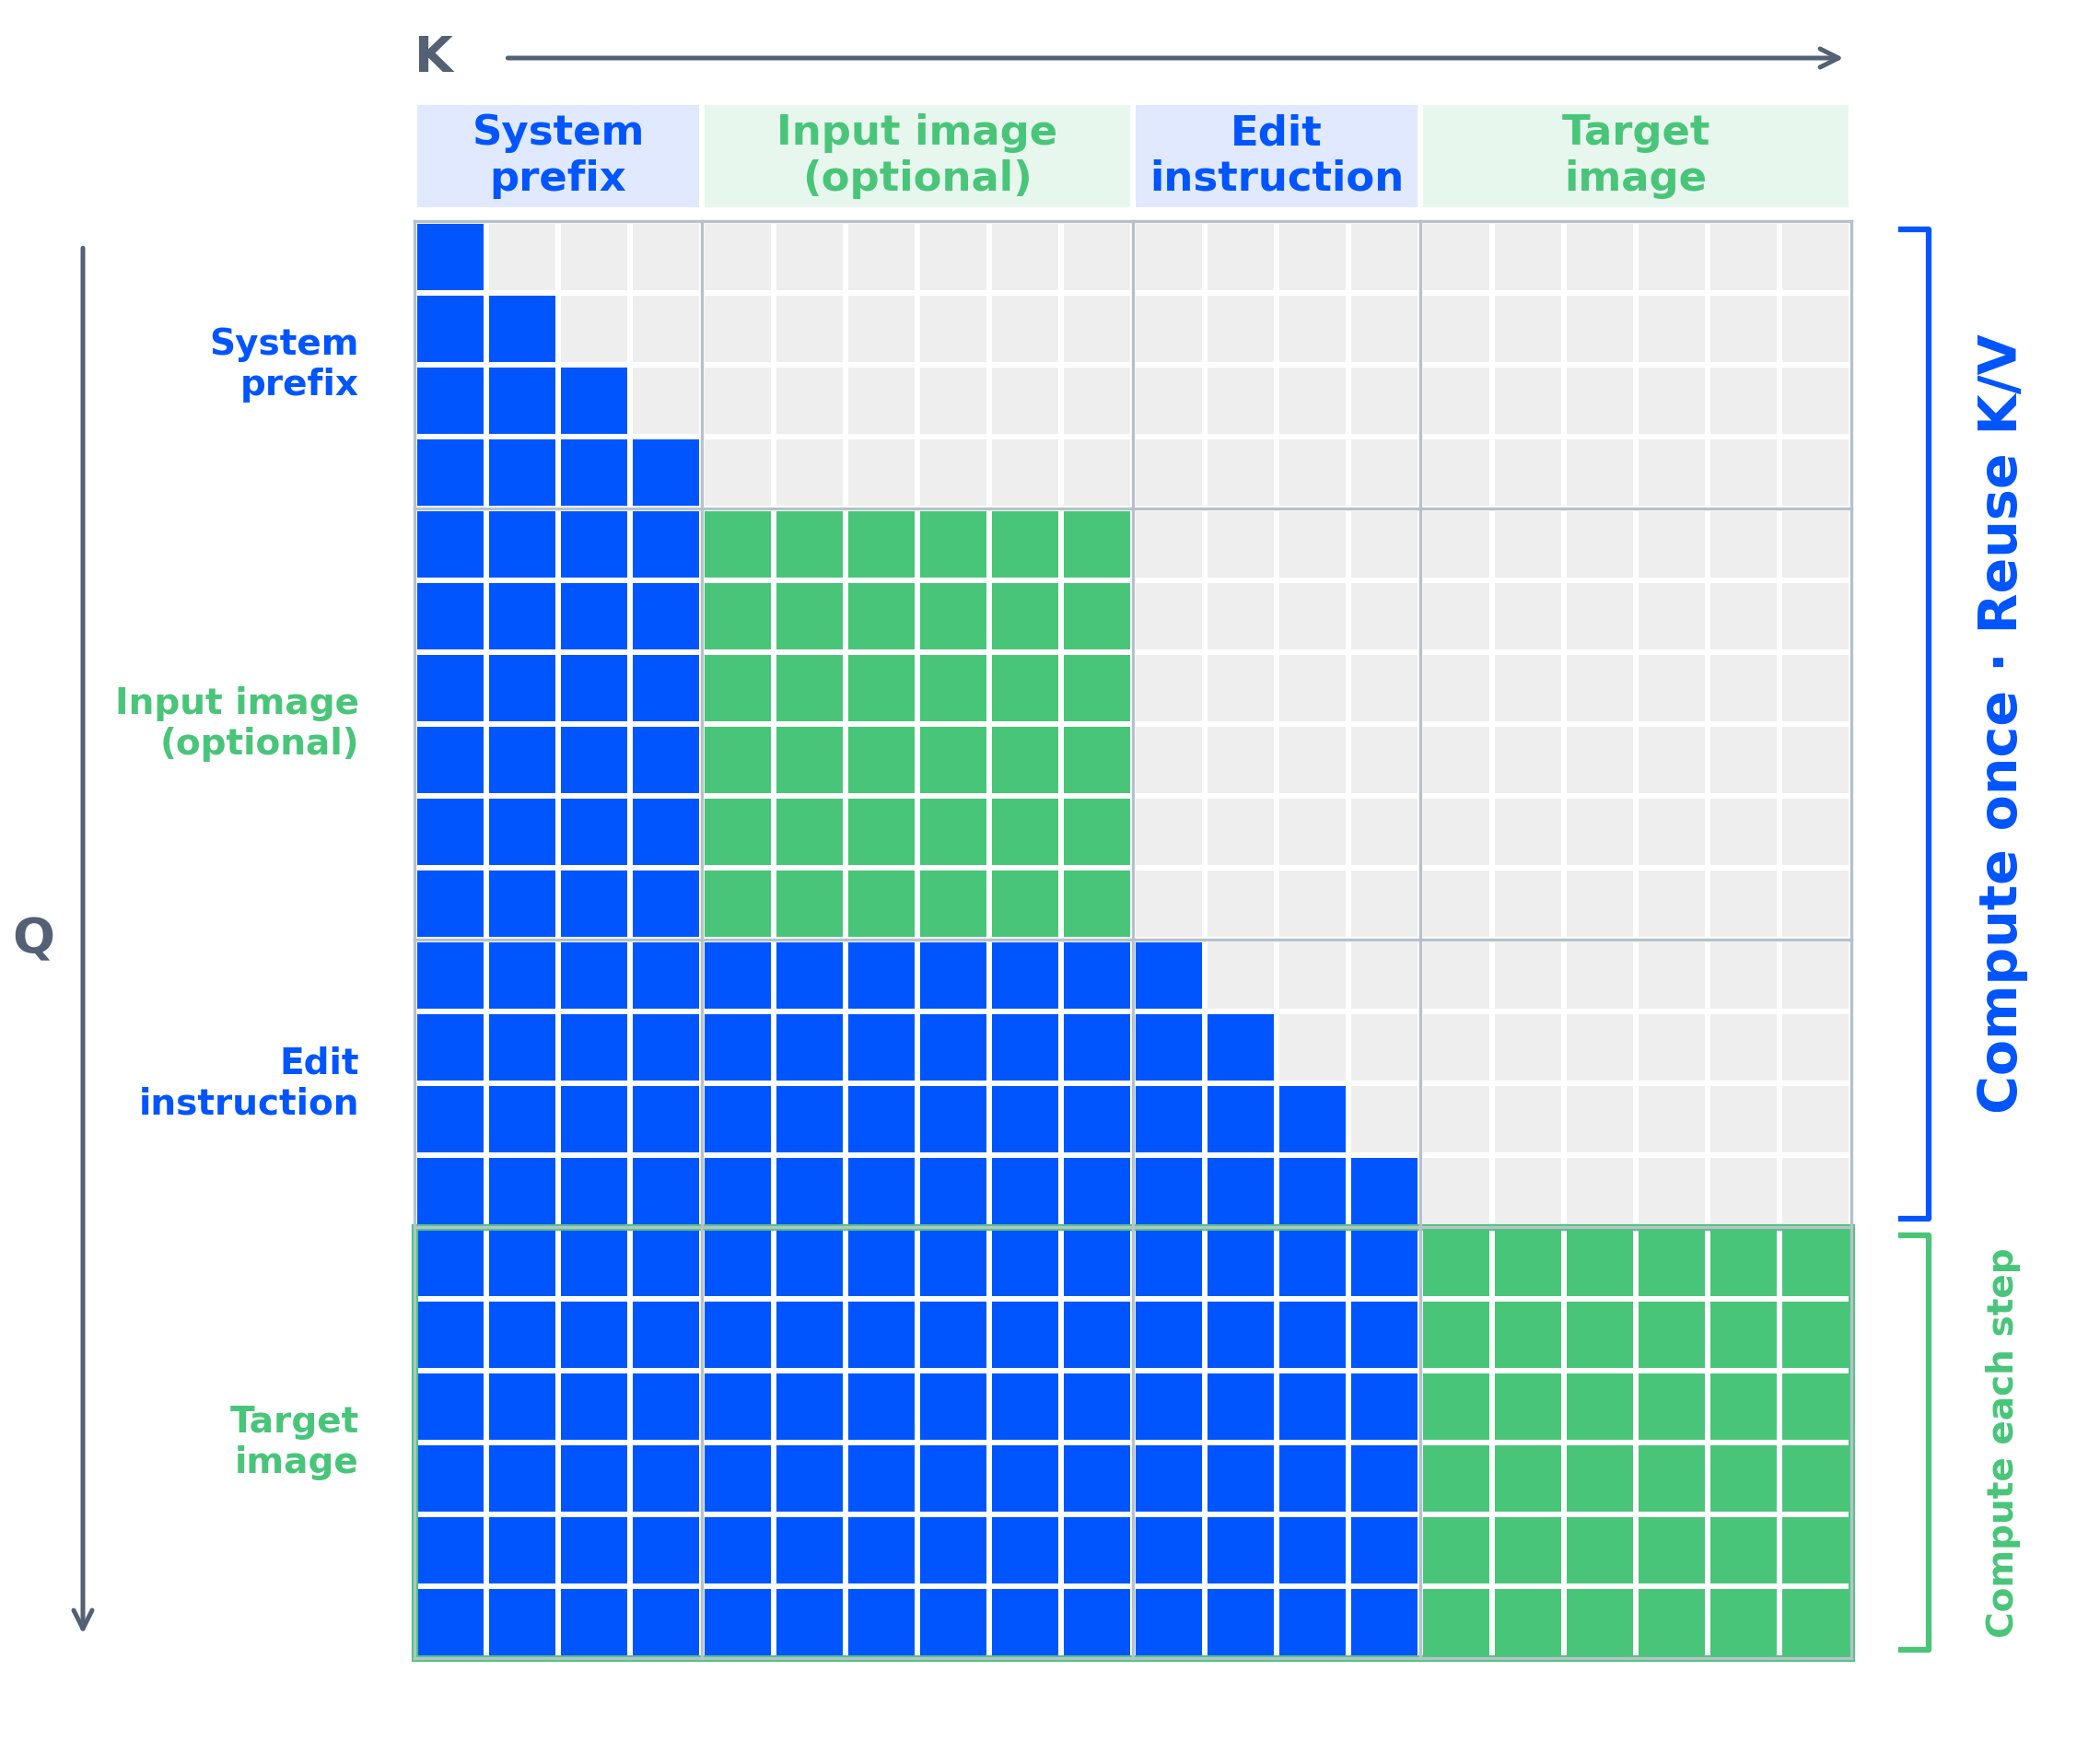
视觉生成器是 32 层 Single-Stream DiT、共 7B 参数,搭配 8B 的 Qwen3-VL 编码器和一个原生携带 alpha 通道的 VAE。真正有意思的工程在注意力机制上。Qwen 把它称为 mixed-granularity(混合粒度):文本 token(系统前缀和你的编辑指令)使用 token 级因果 mask,而图像生成使用 chunk 级 mask。由于输入图像和编辑指令在整个去噪过程中保持不变,模型在第一步计算一次它们的 key-value 缓存,之后直接复用。Qwen 给出的收益说法是:带多张参考图做编辑时延迟和显存占用更低——这恰好是 10 张图上限让工作负载变重的那类场景。
调度器采用 flow matching 加 Euler 离散步,参考代码默认跑 40 步。
同一个模型原生支持透明
这是本次发布最大的亮点。你在提示词里要求透明图像,模型直接返回 RGBA。README 给出的推荐写法非常直白:以“This is an RGBA image with transparency”开头,并说明背景是透明的。发布博文展示了单个主体、多元素合成,以及三个在透明输入上做编辑的案例:在保留 alpha 的前提下改变主体表情、替换透明图层内的文字,以及从普通 RGB 照片把主体抠成 RGBA 前景。
对产品团队来说,这把“先生成、再抠图”的双模型流水线变成了一次调用。它还消除了背景移除工具在头发、玻璃边缘留下的光晕伪影,因为 alpha 是生成出来的,不是事后推断的。至于 2K 分辨率下边缘在你自己的素材上是否站得住,应该实测而不是假设;免费额度指南介绍了不用 GPU 跑这些测试的途径。
最多 10 张参考图的编辑与真正的区域控制
发布示例中有三个编辑功能最突出:
- 多参考图。六张人像合成一张合影;模特、服装、鞋子、包和帽子合成一套穿搭;十张家具照片生成一个布置好的房间。上限是 10 张输入图。
- 三种局部编辑方式。画彩色圆圈并在提示词里按颜色指代(例如 “remove the watch in the blue circle”)、直接涂抹一个区域,或者把未改动的原图和单独的 mask 作为两个输入传入,保证源图任何部分都不被遮挡。
- 保真度。Qwen 称人脸身份以及产品的文字、纹理和形状在编辑后的保持度优于 2.0。博文展示了前后对比图,但没有给出量化指标,把它当作需要在你自己的 SKU 上验证的说法即可。
同一条编辑路径还能从一张自拍生成全景图、从产品照片生成信息图、从三视图角色设定图生成分镜脚本。连续的局部编辑可以串成短动画,博文用一段水豚视频做了演示。
排版与人像质量
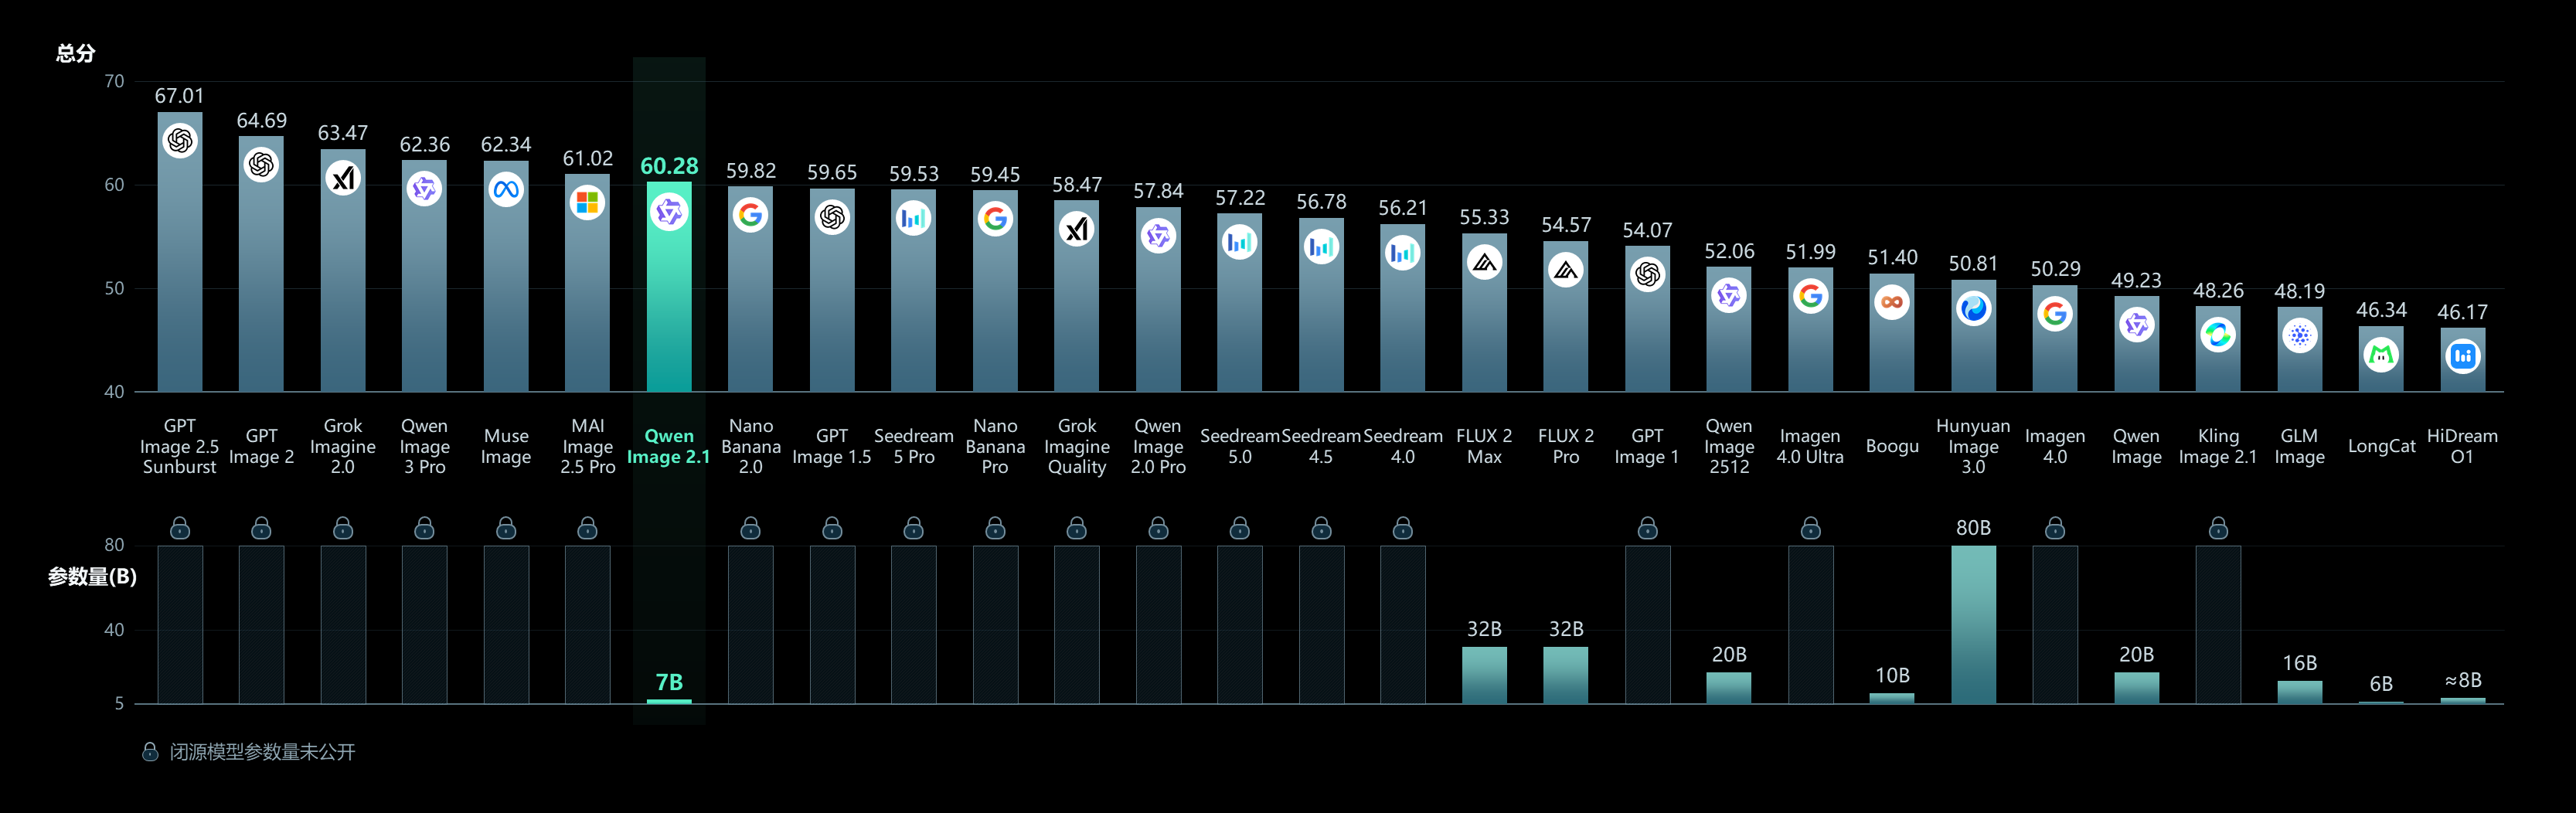
从初代 Qwen-Image 起,Qwen 就在开源文字渲染上保持领先,2.1 把它延伸到字体风格、版式以及文字在构图中的位置,而不只是拼写正确。人像光照和细节表现也有提升。发布博文用一张对比开源与闭源模型的 Qwen-Image-Bench 图表来支撑这一说法;图表是图片,博文没有印出具体数字,所以本文也不引用任何数字。
许可证:开放权重,研究条款
初代 Qwen-Image 采用 Apache 2.0。Qwen-Image-2.1 则以 Qwen Research License Agreement 发布,许可证文本篇幅不长,在最关键的一点上写得清楚:
- 未经 Qwen 另行授予商业许可,不得将模型“用于任何商业目的”,商业授权需通过邮件向 Qwen 申请。
- 再分发与衍生作品必须附带许可证、“Built with Qwen”或“Improved using Qwen”声明,以及注明杭州通义实验室的版权行。
- 不能用“Qwen”作为衍生作品的主要名称。
- 协议适用中国法律,司法管辖地为杭州。
两个提示词重写配套模型也采用同样条款。对业余项目、研究论文或内部评估来说没有问题;但要做 SaaS 功能,就意味着先得和阿里谈,或者改用托管的 3.0 API——后者附带常规商业条款和按张计价。
两个提示词重写模型
除了生成器本身,Qwen 还发布了Qwen-Image-2.1-PE-T2I和 Qwen-Image-2.1-PE-I2I。PE-T2I 是一个微调过的 Qwen3.5-VL 9B,接收任意语言的简短请求,返回包含详细英文提示词和建议长宽比的 JSON。PE-I2I 是对应的编辑版本 [VERIFY]。两者都是可选的,demo Space 正是靠它们把一句话输入变成长而结构化的提示词。如果你要围绕 2.1 搭建 API 服务,这一步就是“提示词增强”,ChatGPT Images 这类产品在后台默默做了同样的事。
发布会上没说的部分
- 没有按分辨率给出的显存数字。README 指向
enable_model_cpu_offload()、vLLM-Omni(FP8)、SGLang 和 LightX2V 作为更轻或更快的部署方案,另外还支持 AMD,但没有给出表格。 - 没有公开的基准测试数字,只有一张图。
- 截至发布时,Model Studio 上还没有 2.1 的托管 API [VERIFY];托管产品线是 3.0。
- 没有明确的推理速度数据,只有 KV 缓存复用带来的“效率提升”。
把它放到 API 后面并测试
大多数团队不会在应用代码里直接调用 diffusers 流水线,而是把它包装成 GPU 机器上的 HTTP 服务再调用。一旦它成为一个接口,它就和其他 API 没什么两样,而Apifox正是用来设计和测试它的地方:定义请求 schema(提示词、可选参考图、长宽比、透明开关),发送真实请求,断言响应是带 alpha 通道的 PNG,再把好的用例沉淀成回归测试集,在每次模型更新后重跑。你还可以 mock 这个接口,让前端团队在 GPU 忙碌时依然能基于稳定契约开发。实战指南会一步步讲完这个封装和对应的 Apifox 测试。
FAQ
Qwen-Image-2.1 可以免费商用吗?不可以,除非从 Qwen 获得单独的商业许可。权重可以免费下载,用于研究和非商业目的。许可详情见上文许可证一节,免费试用途径见免费额度指南。
2.1 和 Qwen-Image-2.0 有什么区别?体量同样是 7B,设计同样是生成与编辑二合一。2.1 的新增点:原生 RGBA 输出与编辑、最多 10 张参考图、基于 mask 和标注的局部编辑、带 KV 缓存复用的 mixed-granularity 注意力路径(多图编辑更快),以及更好的排版与人像细节。
它和 Qwen Image 3.0 是同一个东西吗?不是。3.0 和 3.0 Pro 是 2026 年 7 月发布的托管 API 模型,权重不开源;2.1 是开放权重模型。对比文章覆盖了价格和能力差异。
它需要什么硬件?Qwen 没有公布显存要求。参考代码以 bfloat16 在单个 CUDA 设备上加载流水线,并支持 CPU offload;社区部署方案加入了 FP8。想在 40 步设置下输出 2K 图像,请按数据中心或高端消费级 GPU 预期。
它能编辑透明图像,而不只是生成吗?能。发布示例包括在保留 alpha 通道的前提下改变主体表情、替换透明图层内的文字,以及从 RGB 照片中抠出 RGBA 主体。
接下来去哪里
Qwen-Image-2.1 是一个强大的开源编辑模型,有一个别人都没在单一 checkpoint 里提供的特性——原生透明通道,也有一个决定你能不能用它的新增约束——研究许可证。用实战指南在本地把它跑起来,通过免费方案不用 GPU 先试试,并在做决定前对比托管的 3.0 API。无论选哪条路,都建议把接口放进Apifox里做测试,这样换模型时才不会悄悄弄坏你的产品。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。

值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会

