OpenAI LifeVal 是一个由 169 个日常任务组成的基准测试——给孩子办入学、管理家庭预算、跟政府机构打交道——AI agent 通过浏览器操作、computer use 和连接器完成它们,每个尝试按评分规则打分,得分是 0 到 1 的平均 reward。GPT-6 Astra 在 xhigh effort 下得分 80.6%。
这是摘要版。下文会讲 OpenAI 怎么构建 LifeVal、它公布的每一个模型得分(包括只存在于页面交互图表里的分 effort 数据)、这些数字对 reasoning effort 意味着什么,以及这个基准漏掉了什么。
OpenAI LifeVal 是什么?
LifeVal 是 OpenAI Research 的一个基准,衡量的是模型能不能完成普通生活里的杂事,而不是写代码或考试。它的 169 个任务都是 agentic 的:模型要浏览网页、操作电脑、调用连接器,由每个场景专属的评分规则打分。
OpenAI 划分了七个任务领域:
- 照护
- 健康
- 教育
- 家务管理
- 个人财务
- 购物
- 政务服务办理
核心指标是平均 reward:每个数据点先对单个任务内的多次尝试取平均,再对 169 个任务的均值等权平均。80.6% 的得分即 reward 0.806。图表注释里写着 “No WTP weighting”,后文会回到这一点。
OpenAI 怎么构建 LifeVal 任务集
OpenAI 没有凭空编任务清单。它从人们实际怎么花时间出发,用了两个公开数据集加一次自家的调研:
- 美国劳工统计局的 American Time Use Survey,逐小时记录美国人都在做什么。
- Multinational Time Use Study,把各国的时间利用日记做了对齐。
- OpenAI 自己对 3,995 名人口结构有代表性的受访者的调研,问他们希望 AI 帮忙做什么。
时间利用数据告诉 OpenAI 哪些活动填满了人们的一天;调研告诉它其中哪些人们愿意交给 agent。两者的交集就成了那 169 个场景。
页面展示了五张示例任务卡,各带一个分数。它们是 OpenAI 挑的例子,不是随机抽样:
| 示例任务(OpenAI 选取) | 得分 |
|---|---|
| 搬家后给孩子报对幼儿园 | 93.1% |
| 洪水来临前组织志愿者 | 98.0% |
| 为家人找新住处 | 100% |
| 陪远方的奶奶一起看球赛 | 96.3% |
| 为新确诊糖尿病的父母做备餐规划 | 90.4% |
LifeVal 得分:所有 OpenAI 模型
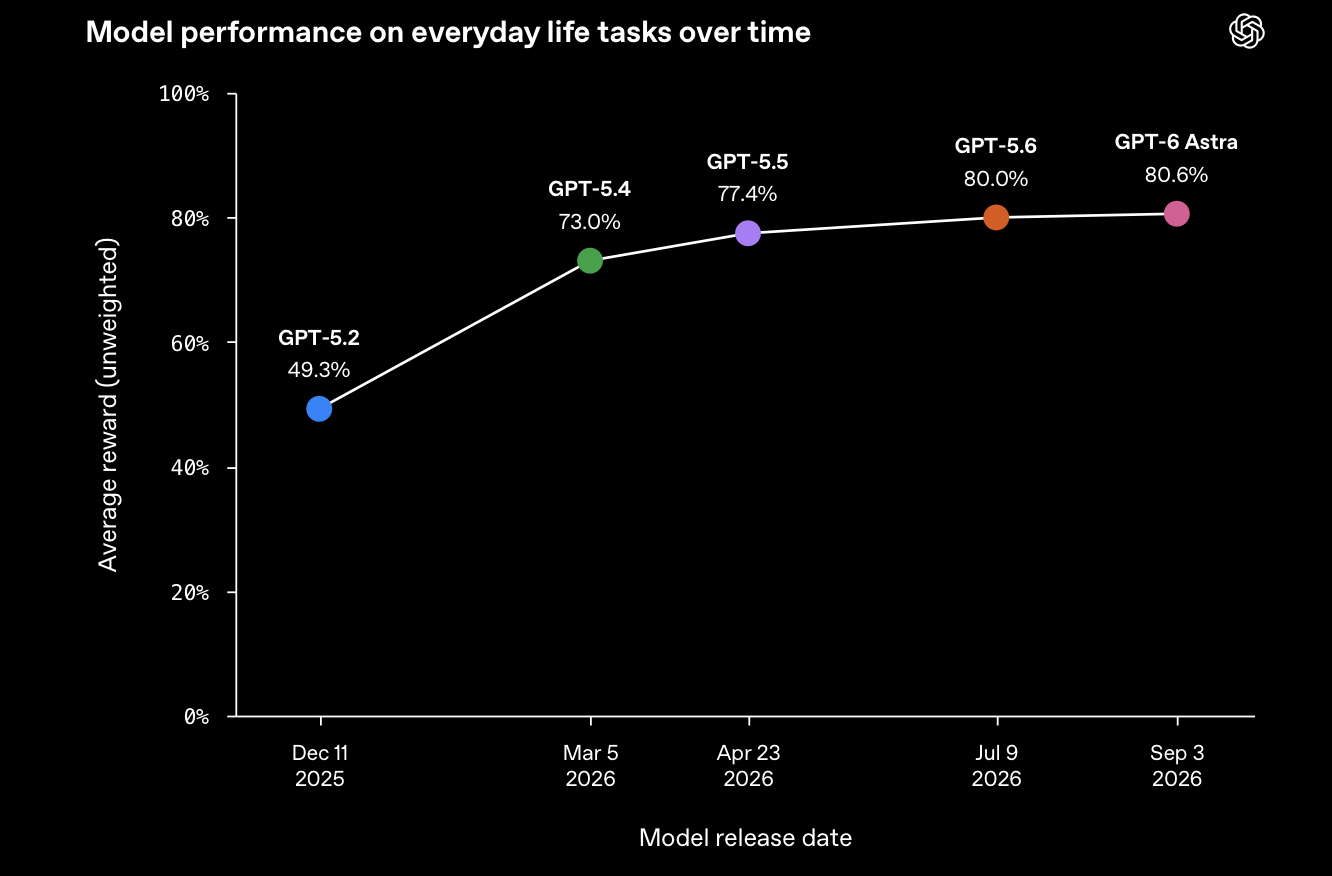
OpenAI 的第一张图按发布日期描绘各模型在 xhigh reasoning effort 下的得分。GPT-6 Astra 用的是“发布博客的 xhigh 设置”。
| 模型 | 发布日期 | LifeVal 平均 reward(xhigh) |
|---|---|---|
| GPT-5.2 | 2025-12-11 | 49.3% |
| GPT-5.4 | 2026-03-05 | 73.0% |
| GPT-5.5 | 2026-04-23 | 77.4% |
| GPT-5.6 | 2026-07-09 | 80.0% |
| GPT-6 Astra | 2026-09-03 | 80.6% |
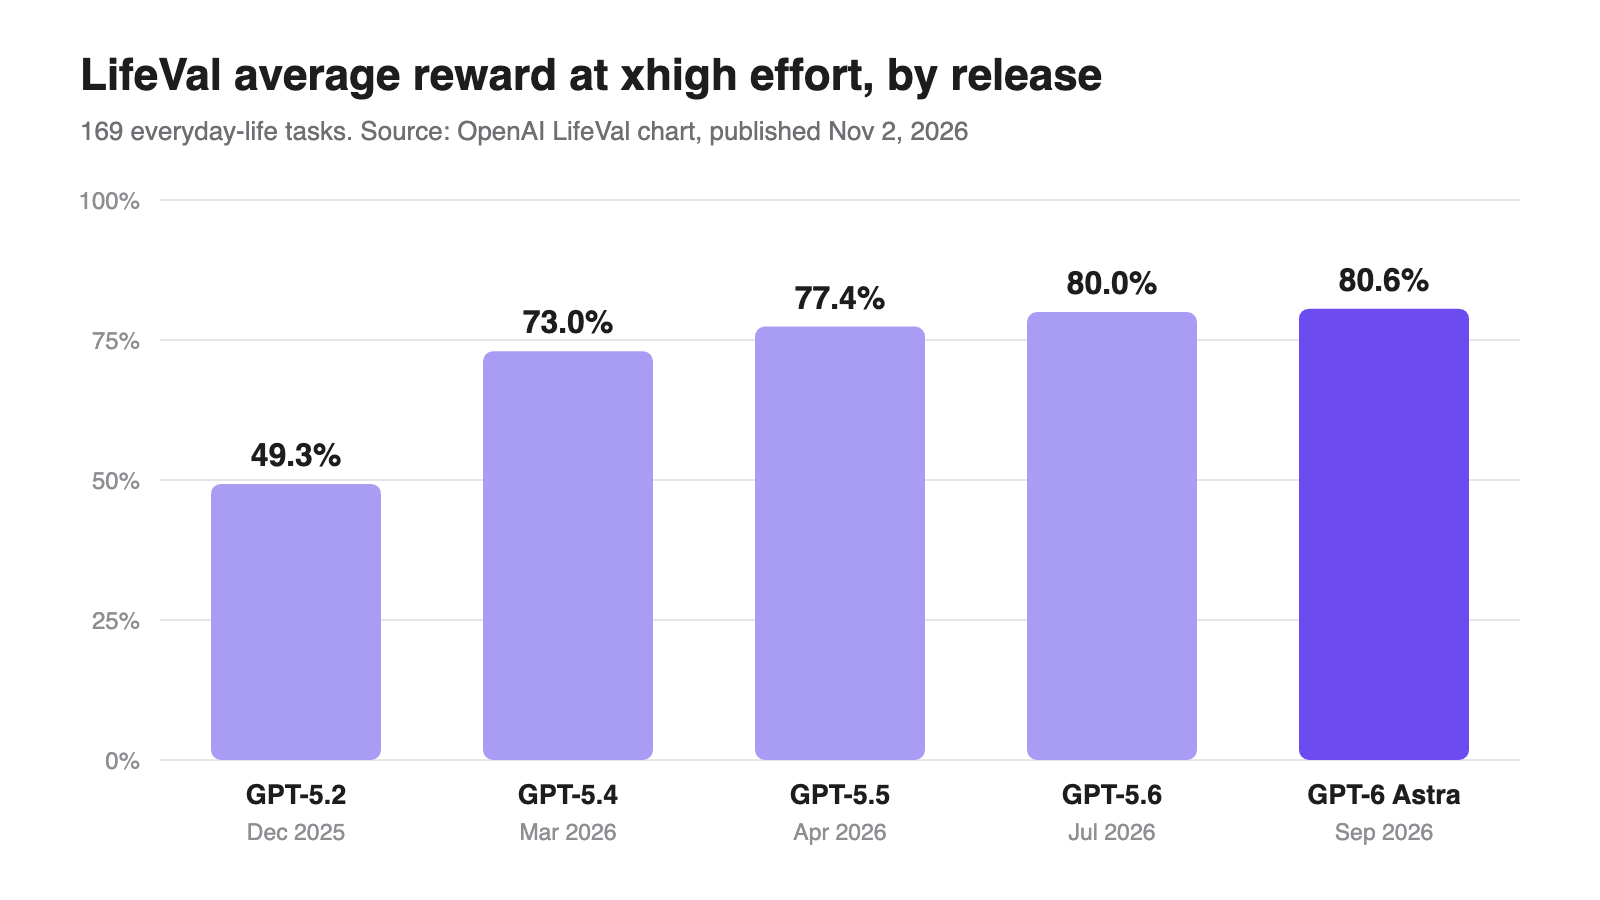
曲线先陡后平:GPT-5.2 到 GPT-5.4 三个月涨了 23.7 个点;接下来三个版本合计只加 7.6 个点,GPT-6 Astra 也只比 GPT-5.6 高 0.6。
GPT-5.4 那一跳不只是质量。同为 xhigh,平均延迟从 121.0 秒降到 16.7 秒,每任务生成 token 从 202.0K 降到 30.6K——新模型用约七分之一的输出拿到好得多的答案。
GPT-6.1 Sol 和 GPT-6.1 Terra 没有出现在任何一张图里,尽管两者都已发布;时间线止于 2026 年 9 月 3 日。如果你在为 agent 产品在 GPT-6.1 Sol 和 Astra 之间做选择,LifeVal 目前帮不上忙。
按 reasoning effort 拆解 LifeVal
第二张图更有用,而且只有悬停才能看到。它按 reasoning effort 拆解每个模型,每个点带四个数:reward、延迟、生成 token 数和 API 成本。各档位的 reward 如下:
| 模型 | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| GPT-5.2 | 27.7% | 37.2% | 45.2% | 49.3% | n/a |
| GPT-5.4 | 62.8% | 70.1% | 72.0% | 73.0% | n/a |
| GPT-5.5 | 57.1% | 71.3% | 75.6% | 77.4% | n/a |
| GPT-5.6 | 63.9% | 75.0% | 78.8% | 80.0% | 82.6% |
| GPT-6 Astra | 66.6% | 77.6% | 80.7% | 80.6% | 82.5% |
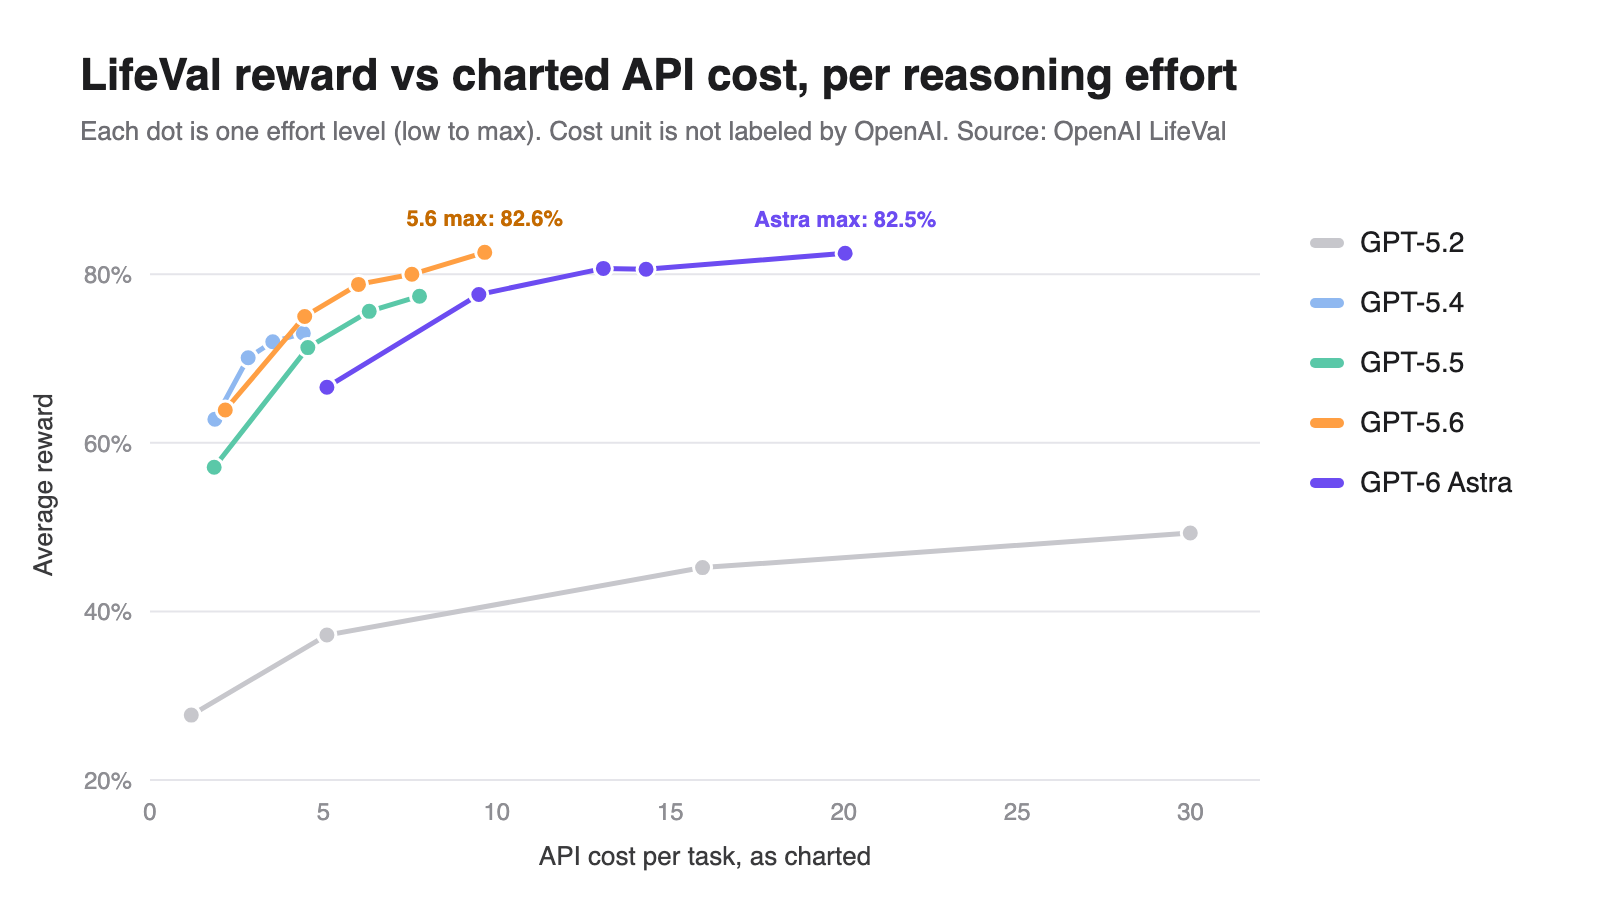
关于成本列的说明:OpenAI 标注为 API cost 但没有给出单位,所以下面的数字请当作“图中每任务 API 成本”,适合看比值,别当美元。
GPT-5.6 的 max 档追平 GPT-6 Astra 的 max 档
| 设置 | Reward | 延迟 | Token | 图中成本 |
|---|---|---|---|---|
| GPT-5.6,max | 82.6% | 22.2 s | 29.7K | 9.65 |
| GPT-6 Astra,max | 82.5% | 20.6 s | 26.3K | 20.04 |
| GPT-5.6,xhigh | 80.0% | 17.5 s | 20.7K | 7.55 |
| GPT-6 Astra,high | 80.7% | 13.6 s | 12.4K | 13.07 |
GPT-5.6 的 max 档以约一半的图中成本比 Astra 的 max 档高 0.1 个点。同档位对比,Astra 对 GPT-5.6 的领先在每个设置下都不到 3 个点(xhigh 只差 0.6),到 max 档被抹平。Astra 略快、token 略少,但在这类任务上你要为它付大约两倍的钱。想按自己的流量核对这个比值,“GPT-5.6 定价拆解”和“GPT-6 Astra API 指南”里有逐 token 费率。
“high” 再往上的推理投入几乎买不到东西
GPT-6 Astra 在 high 档得 80.7%,xhigh 档 80.6%——多花的力气换来 1.4 秒和 2.1K token 的增加,分数还略降。GPT-5.4 形状相同:high 到 xhigh 只差 1 个点。
大收益都在曲线底部。GPT-5.5 从 low 提到 medium 涨 14.2 个点,从 high 提到 xhigh 只涨 1.8。如果你的 agent 跑的就是这类日常任务,medium 或 high 是首先该测的档位。OpenAI 的reasoning 指南解释了 effort 参数在 Responses API 里的工作方式。
LifeVal 漏掉了什么
LifeVal 是有用的信号,但它是自报的信号。引用它之前,先了解它的边界。
- 它不公开。没有可下载的任务集,没有公开榜单,OpenAI 也没公布评分规则和评分器的校准方式。你无法复跑。
- 只测 OpenAI 模型。没有 Claude、Gemini 或开源权重模型,所以它回答不了“GPT-6.1 Sol 对比 Claude Sonnet 5.5”这类跨厂商问题。
- 存在某个加权版本。图表注明 “No WTP weighting”,WTP 即支付意愿。这暗示 OpenAI 计算或考虑过按人们愿意为各任务付多少钱加权的变体,但没有公布。
- 示例卡片是手挑的。页面五张卡的得分从 90.4% 到 100%,而最优模型的 169 任务平均是 80.6%。示例展示的是这个基准最好的一天,不是平常的一天。
这些都不说明 LifeVal 错了,只说明它是厂商基准。按你读任何发布图表的方式读它:当作一个可以在自己任务上检验的说法。
用 Apifox CLI 跑你自己的 reasoning effort 测试
LifeVal 的分 effort 表本质上是一条 reward-成本曲线。你可以为自己的提示词画一条同样的曲线——不用手动发请求,把活交给编码 agent,让它驱动 Apifox CLI。
安装 CLI、登录,并把 Apifox skill 装进你的 agent:
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apifox.com   # pick your agent when prompted
然后给 Claude Code、Codex 或 Cursor 一句提示词:
In Apifox project <projectId>, add a POST https://api.openai.com/v1/responses
endpoint that sends {{model}}, reasoning.effort = {{effort}} and my test prompt.
Create a test case that asserts status 200 and saves latency,
usage.output_tokens and usage.output_tokens_details.reasoning_tokens.
Add a test data set with effort = low, medium, high, xhigh, run the case
once per row against environment <envId>, and give me a table of
latency, tokens and estimated cost per effort.
agent 读取每个 payload 数据模型、校验 JSON,然后写入:
apifox cli-schema get endpoint-create
apifox cli-schema validate endpoint-create --file endpoint.json
apifox endpoint create --project <projectId> --file endpoint.json

apifox test-case category --project <projectId>
apifox cli-schema validate test-case-create --file case.json
apifox test-case create --project <projectId> --file case.json

apifox cli-schema validate test-data-create --file efforts.json
apifox test-data create --project <projectId> --file efforts.json

apifox run --test-case <caseId> --project <projectId> -e <envId> \
  -d <testDataId> -r cli,json --out-dir ./effort-runs
-d 让每行数据跑一次迭代,-r cli,json 给 agent 一份可用来汇总表格的 JSON 报告。想事后在 Apifox 应用里浏览就加 --upload-report。“apifox run 命令参考”列出了全部参数,“Claude Code 配置指南”覆盖 agent 侧。
用五到十个真实提示词去跑,别只用一个。LifeVal 要对 169 个任务取平均是有道理的:单个提示词告诉你的更多是方差,而不是 effort 的效果。
选模型时该信 LifeVal 吗?
拿它定方向,别拿它做决定。LifeVal 告诉你三件可操作的事:2025 年 12 月到 2026 年 3 月之间 OpenAI 模型在多步日常任务上进步巨大;此后的增益很小;在这类工作上 reasoning effort 高过 high 很少划算。
它无法告诉你的是:非 OpenAI 模型能得多少分、你的任务和 OpenAI 的 169 个比起来如何、评分器到底奖励什么。这些要用上面那样的 effort 扫描自己跑,对比看得见的数字。我们的“GPT-6 Astra 上手测试”是这类检验的一个起点。
FAQ
LifeVal 是什么的缩写?
OpenAI 在页面上没有展开这个名字。可以理解为对日常生活(Life)任务的评价(Val):169 个 agentic 场景,覆盖照护、健康、教育、家务管理、个人财务、购物和政务服务。
GPT-6 Astra 的 LifeVal 得分是多少?
xhigh effort 下平均 reward 80.6%——这是 OpenAI 在 Astra 发布博客里用的设置。max 档 82.5%,high 档 80.7%。
我能自己跑 LifeVal 吗?
不能。OpenAI 没有发布任务集、评分规则或评分器。你可以用 Apifox CLI 这类测试工具在自己的提示词上近似它的 effort-成本分析,但无法复现 LifeVal 分数。
LifeVal 包含 Claude 或 Gemini 吗?
不包含。两张图都只有 OpenAI 模型,从 GPT-5.2 到 GPT-6 Astra。GPT-6.1 Sol 和 GPT-6.1 Terra 也不在。
LifeVal 的成本列是美元吗?
OpenAI 标注为 API cost 但未说明单位。用它做设置间的横向比较(比如 GPT-5.6 max 的 9.65 对 Astra max 的 20.04),别当作每任务的美元数。
日常 agent 任务该用哪档 reasoning effort?
在 LifeVal 上,medium 或 high 吃掉大部分收益。GPT-6 Astra 在 high 档 80.7%、xhigh 档 80.6%——先在自己的任务上测 medium 和 high,再考虑为更高档位付费。