Muse Wonder 是 Meta 首个前沿级 AI 模型,由 Meta Superintelligence Labs 于 2026 年 10 月 12 日发布。它有两个规格。Muse Wonder 今天已可通过 Meta Model API 使用,模型 ID 为 muse-wonder-1.0,价格为每百万输入 Token $4、每百万输出 Token $20,同时也可在 Meta 的终端编码 Agent Muse Code 中使用。更大的 Muse Wonder Full 仅面向 Muse Code 订阅用户开放,且只有两个最高档套餐可用,没有 API,也没有按 Token 计费的价格。两者都接受文本、图像、视频和音频输入,返回文本,并具有 1M Token 的上下文窗口。
Meta 打造这对模型是为了 Agent:即能够读取你的邮件、运行你的代码、填写表单,并在出错时继续推进的软件。这个定位决定了此次发布的方方面面,从两大主打功能到 Meta 选择公布的基准测试。本指南涵盖:这两款模型是什么、它们在 Meta 自有测试和独立测试中的得分、如何获取访问权限、价格如何,以及有哪些坑。如果你想今天就调用它,Muse Wonder API 指南会在 Apifox 中带你完成第一个请求。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
两款模型速览
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| 模型 ID | muse-wonder-1.0 |
muse-wonder-full-1.0(仅目录内提供) |
| 获取渠道 | Meta Model API、Muse Code(所有套餐) | Muse Code Power($50/月)和 Maximum($200/月) |
| API 价格 | 每 1M Token:$4 输入 / $20 输出 / $0.20 缓存 | 未公布 |
| 上下文窗口 | 1M Token | 1M Token |
| 输入 | 文本、图像、视频、音频 | 相同 |
| 输出 | 文本 | 文本 |
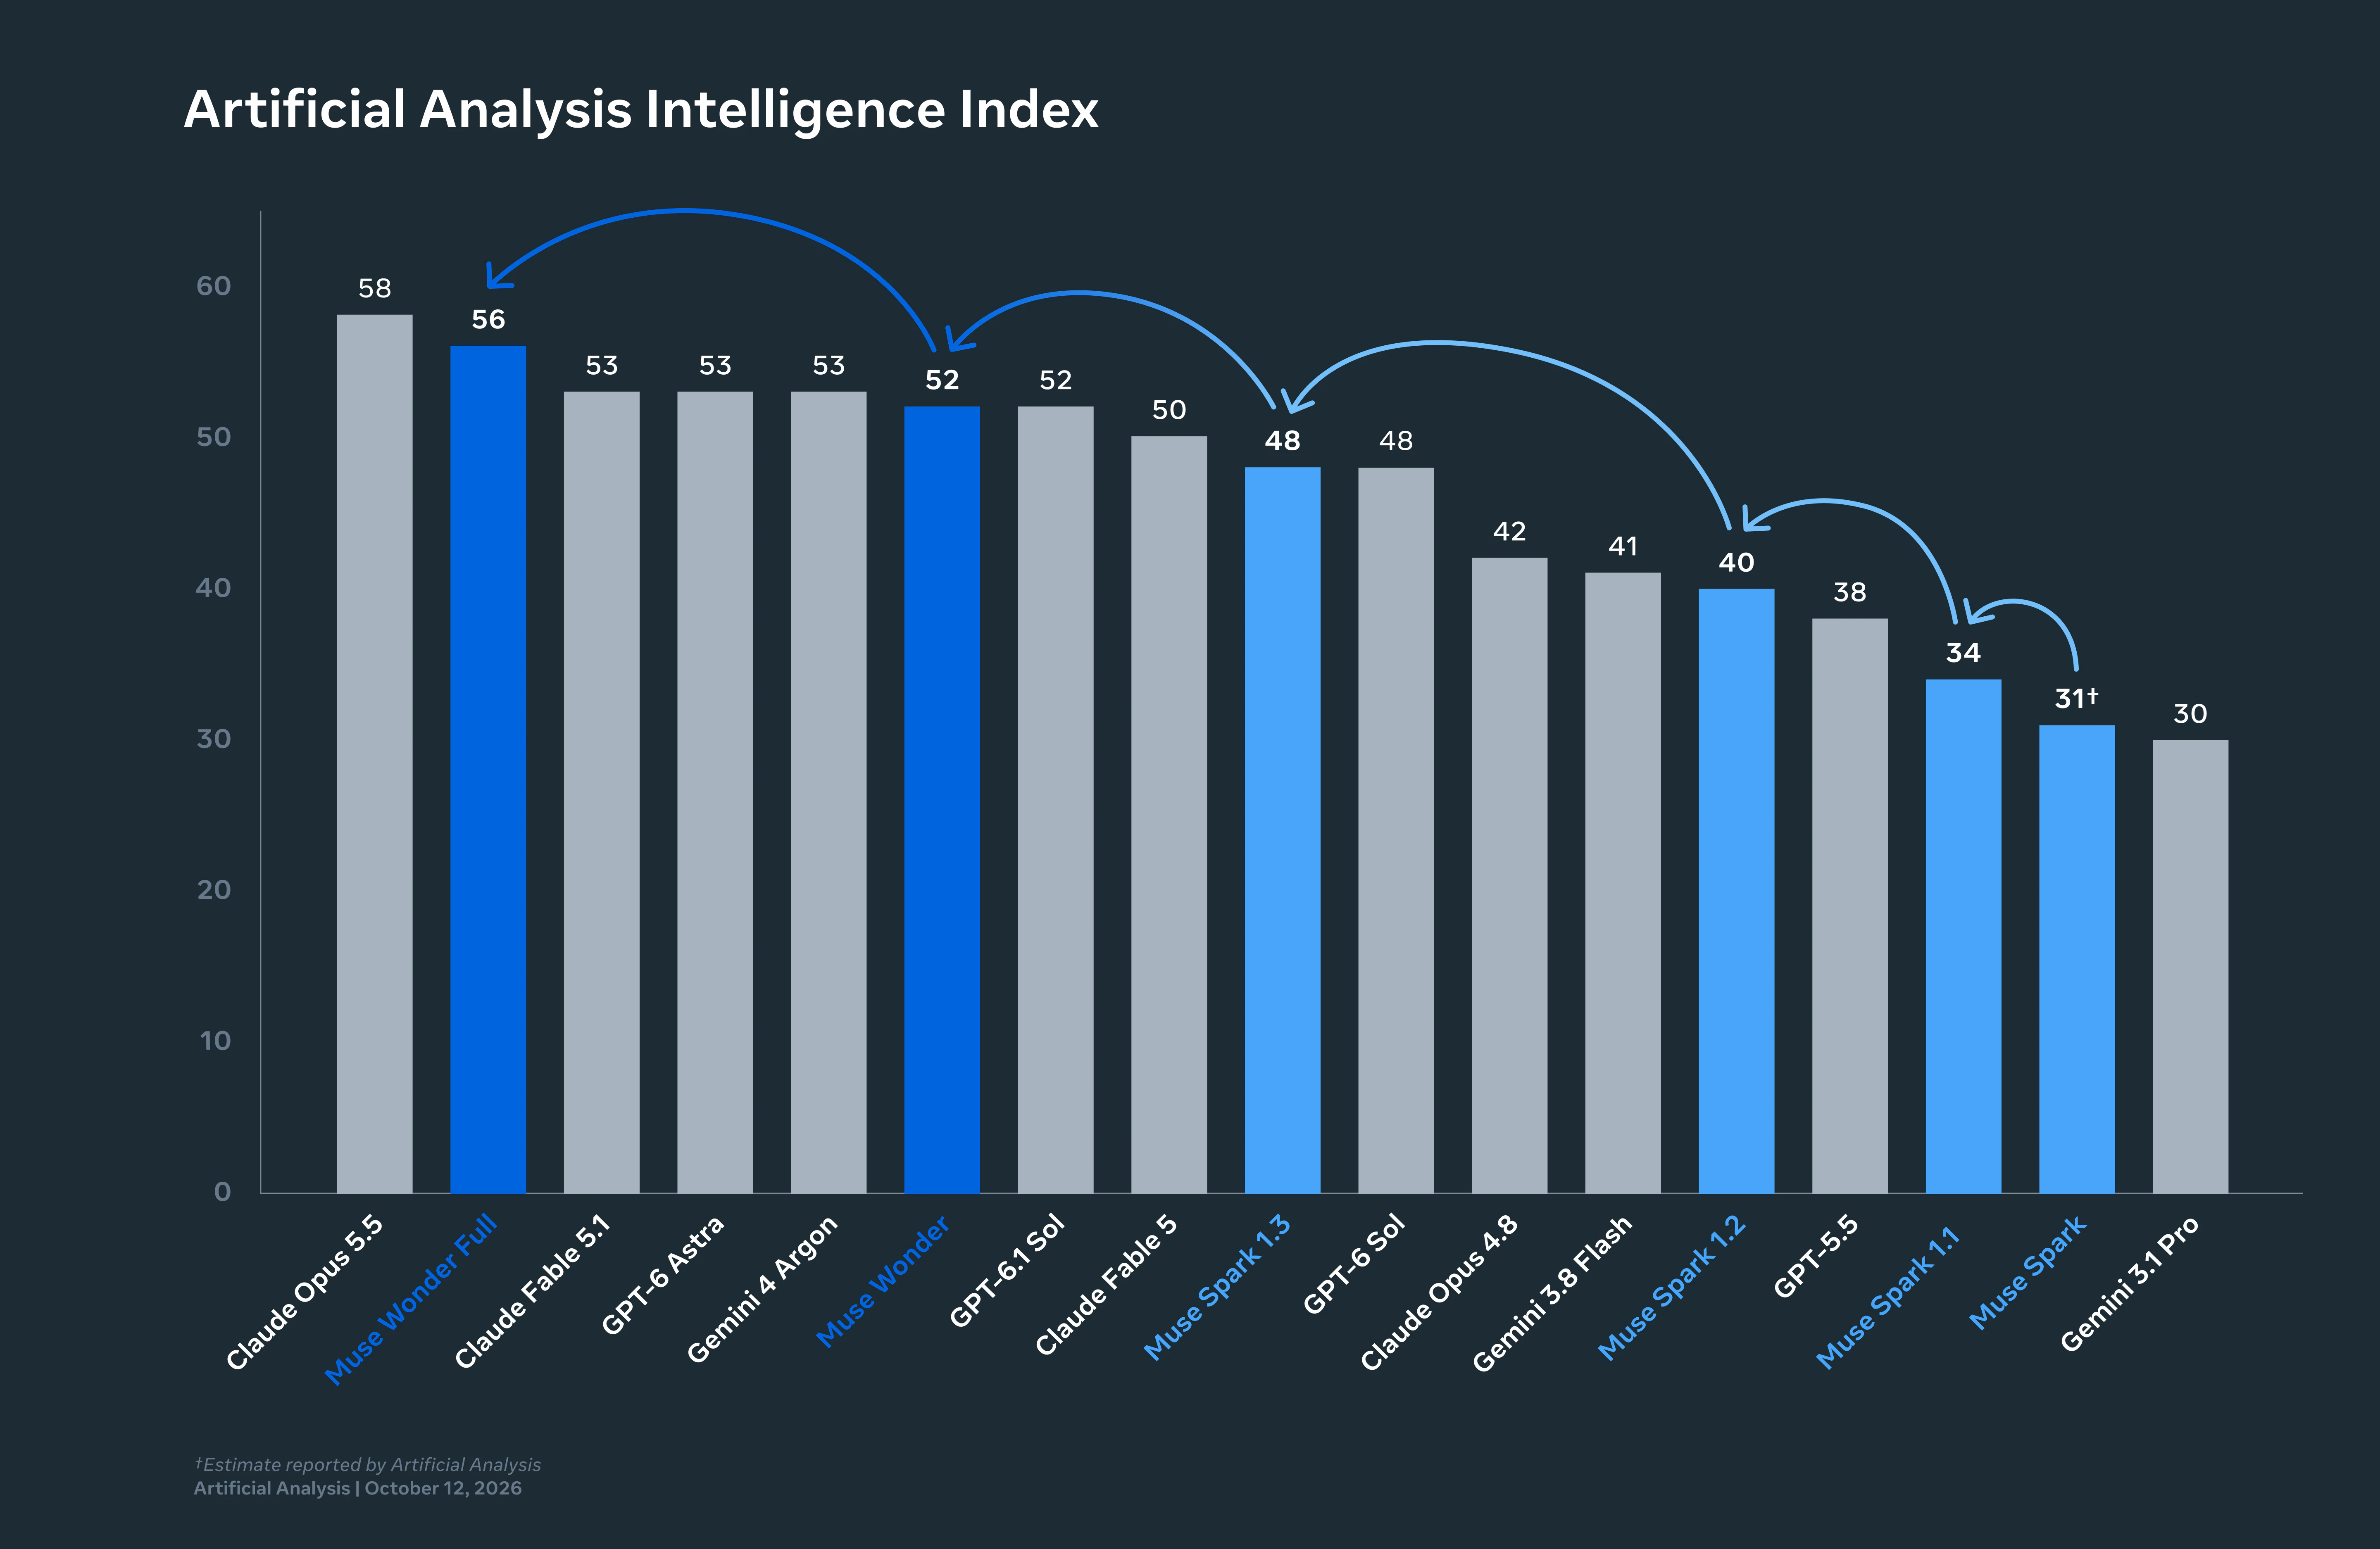
| Artificial Analysis Intelligence Index | 52 | 56 |
| 权重 | 闭源 | 闭源 |
两款模型比 Muse Spark 1.3 晚约六周发布。Muse Spark 1.3 在同一指数上得分为 48,价格为 $1.25 / $4.25。Mark Zuckerberg 在 X 上称 Wonder 是比 Spark“规模更大、更先进的一类模型”。Meta 的 研究公告称,这些模型是在其位于俄亥俄州、算力达吉瓦级的 Prometheus 数据中心训练的,该数据中心于今年上线。
新特性:Active Memory 与 Active Focus
Meta 点名了两项能力,称其让 Wonder 系列区别于更早的模型。
Active Memory 会跨对话携带关于某个人的上下文,并把相关部分带入当前任务。按 Meta 的说法,这是一种模型行为,而不是独立的记忆 API:没有可写入记忆的接口。Meta 内部的 MemoryBench 会在 64K 到 100K Token 的对话中隐藏事实,并在中途改动其中一部分;它给 Muse Wonder 打出 85.6 分,而 Claude Opus 5.5 为 81.5,GPT-6 Astra 为 81.4。
Active Focus 是 Meta 用来描述对困难目标坚持不懈的说法:尝试不同的方法、突破障碍、适应新信息,以及用 Meta 的话说,在需要时主动询问澄清、在执行重要操作前先确认。在内部的 FocusBench 上,Wonder Full 以 54.2% 领先,GPT-6 Astra 为 47.7%,Opus 5.5 为 45.8%,较小的 Wonder 为 44.9%。
这两项基准测试都是 Meta 自有的,无法在 Meta 之外复现。不妨把它们视为一种意图声明,说明这些模型是为哪些目标训练的;至于这种意图实际效果如何,请看下文的独立数据。
除这两项外,Meta 还列出了法律、金融和健康领域的专业知识,跨大型代码仓库的前沿编码能力,计算机操作(操作浏览器、桌面和移动应用),子 Agent 委派,并行工具调用,以及错误恢复。
基准测试表现
Meta 的模型卡将这两款模型与 GPT-6 Astra 和 Claude Opus 5.5 在最高推理强度下进行对比。选取的测试偏向 Agent 类与专业工作:
| 基准测试 | Wonder Full | Wonder | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Harvey LAB-AA(法律) | 13.1 | 10.0 | 8.6 | 4.2 |
| SWE-Marathon(长时间编码任务) | 57.5 | 53.1 | 42.5 | 46.3 |
| DeepSWE 1.1 | 79.0 | 78.8 | 74.1 | 74.2 |
| JobBench | 75.3 | 70.5 | 66.1 | 75.4 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 59.1 | 59.6 |
| HealthBench Pro | 62.3 | 60.5 | 65.3 | 65.6 |
规律是一致的:Wonder 在长时间运行的 Agent 任务和法律任务上领先,而在终端任务和健康任务上落后于 Opus 5.5 和 Astra。Meta 自己的模型卡也指出,竞品的测试结果是尽力而为(best-effort),且部分编码对比使用了不同的工具。
独立的解读来自 Artificial Analysis。在其 Intelligence Index v4.3 上,Wonder Full 得分 56,与 Claude Sonnet 5.5 并列,低于 Opus 5.5 的 58,高于同为 53 的 GPT-6 Astra、Gemini 4 Argon 和 Claude Fable 5.1。Wonder 得分 52。Full 相比 Spark 1.3 提升最大的是 Terminal-Bench 4.0,从 33% 升到 57%。其幻觉率从 33% 降到 23%,在前沿模型中位列第二低。知识召回仍是弱项:在 AA-Omniscience 上得 30,而 Opus 5.5 为 46。基准测试文章逐一梳理了每一行,包括 Meta 的表格与 Artificial Analysis 数据不一致的那一行。
如何获取访问权限
Meta Model API。 在 dev.meta.ai 创建密钥,把任意 OpenAI SDK 指向 https://api.meta.ai/v1,并将模型设为 muse-wonder-1.0。该 API 还提供 Chat Completions 和兼容 Anthropic 的 Messages 接口,因此 Claude Code 和 Codex 只需几个环境变量就能运行其上。速率限制为每分钟 3,000 次请求和 4 百万 Token,按团队共享而非按密钥计算。
Muse Code。 Meta 的终端 Agent 用一条 curl 命令即可安装,从 $5 的 Everyday 套餐起,所有订阅都包含 Muse Wonder。Power($50)和 Maximum($200)套餐解锁 Muse Wonder Full。订阅默认使用 Contributor 模式,该模式允许 Meta 用你的 prompt、代码和输出进行训练,以换取更多用量;你可以关闭它。
Muse app。 面向消费者的 Agent 应用免费,但 Muse Wonder 会先向 $20 和 $100 订阅用户开放。目前没有免费使用该模型的途径;免费访问相关文章列出了现有方式及其价格。
第三方。 Vercel AI Gateway 和 Cloudflare Workers AI 都以相同的 Token 价格提供 meta/muse-wonder-1.0。
实际使用成本
在 $4 / $20 的价位上,Muse Wonder 的标价与 Claude Opus 5.5 持平,比 GPT-6 Astra 和 Claude Fable 5.1($10 / $50)低 60%。$0.20 的缓存输入相当于打 95% 折扣。没有长上下文加价:900K Token 的 prompt 与 9K Token 的 prompt 每 Token 价格相同。
标价不等于任务成本。Artificial Analysis 测出 Wonder 每完成一项 Intelligence Index 任务约花费 $4.52,而 Opus 5.5 为 $5.98,GPT-6 Astra 为 $3.26。原因在于 Token:Wonder 在整个指数测试中消耗了 769 万输入 Token,是 OpenAI 和 Google 模型的 2 到 7 倍,且其大部分成本来自缓存写入和读取,而非全新输入。啰嗦的 Agent 即使单价看似便宜,最终也可能很贵。定价文章用示例做了说明,而 Apifox 会在每个响应中显示 usage.input_tokens_details.cached_tokens,让你看清钱花在哪里。
需要注意的坑
- 最好的模型不在 API 上。 Meta 发布时关于前沿性能的所有宣传都基于 Wonder Full,而它只能通过 Muse Code 订阅使用。API 上的模型在指数上低了四分。
- 内部基准测试。 MemoryBench、FocusBench 和 Personal Superintelligence Index 都是 Meta 自有的测试。Meta 的表格还把 Full 在某一 Artificial Analysis 项目上列为 59.0,而 Artificial Analysis 自己公布的是 56。
- 数据模式很重要。 Standard 模式下的 API 流量不会用于训练。Muse Code 订阅默认使用 Contributor 模式,而这种模式下的流量会用于训练。经批准的组织可以使用零数据留存,但这会禁用服务端对话状态、后台请求、文件上传和内置网页搜索。
- 发布周的 bug。 Wonder 和 Wonder Full 在第一天异常快速地耗尽 Muse Code 配额;Meta 重置了配额,Alexandr Wang 表示“仍有一些问题在努力解决”。
- 安全报告待发布。 Meta 表示,在没有护栏的情况下无法排除化学和生物滥用的高风险阈值,在有护栏的情况下评估剩余风险为中或更低,并承诺很快发布完整报告。
- Agent 仍会犯错。 Meta 自己也建议在产生重大影响的操作前由人工确认,这也是我们对任何能操作你的 API 的 Agent 所给的建议。
常见问题
Muse Wonder 像 Llama 一样开源权重吗? 不是。两款 Wonder 模型都是闭源的,仅通过 Meta 的 API、Muse Code 和合作网关提供。没有可下载的内容。
它使用哪种 API 格式? 三种。Responses API 是 Meta 推荐用于多步骤任务的方式,Chat Completions 兼容任何 OpenAI SDK,Messages 接口则接受 Anthropic 格式的请求。推理强度从 minimal 到 max;none 会返回 400,因为该模型始终进行推理。
它比 Claude Opus 5.5 更好吗? 在 Meta 的 Agent 类基准测试上,Wonder Full 在长时间编码任务和法律工作上领先。在独立指数上,Opus 5.5 仍领先于两款 Wonder 模型,并在终端任务和健康任务上胜过它们。对比文章里有完整说明;简而言之,两者定价相同,各自擅长的任务不同。
付费前能先试用吗? 只能通过在 API 上花费几美分来试。按 $4 / $20 的价格,几次测试调用比一杯咖啡还便宜。下载 Apifox,把密钥存为私密变量,在同一个项目中运行这些调用。
结语
Muse Wonder 是一款可信的前沿级产品,定价与 Opus 5.5 持平,在长时间运行的 Agent 任务上有明显优势,而在知识和终端任务上存在明显差距。赢得 Meta 头条基准测试的那款模型则被挡在 $50 订阅之后。如果你在构建 Agent,值得本周用自己的任务测一测,并以实际消耗的 Token 而非标价来衡量。
开发必备:API 全流程管理神器 Apifox
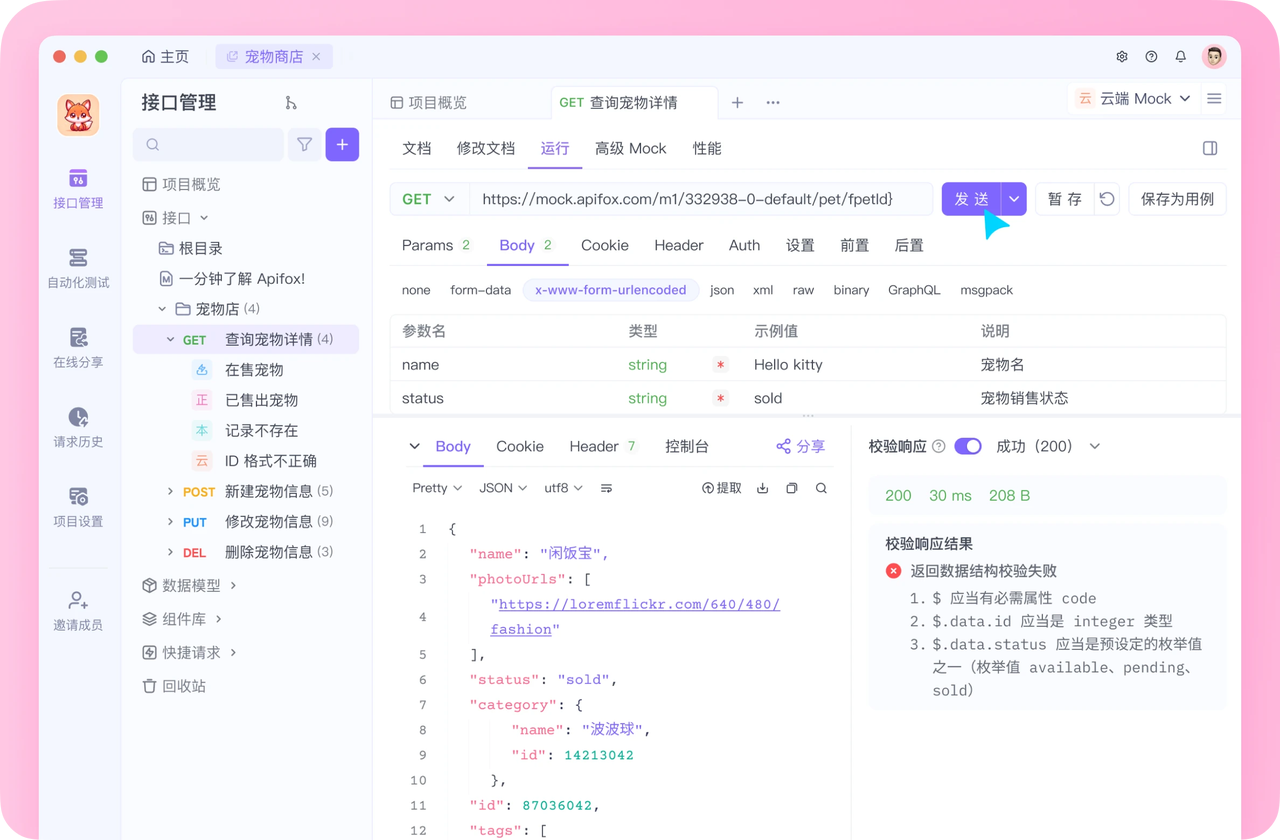
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会