DeepSeek 用自家最小的模型下线了旗舰型号。2026 年 9 月 10 日,DeepSeek-V4.1-Flash 在 API 上正式 GA,而发布说明里有一句多数厂商会悄悄埋掉的话:从 9 月 14 日起,所有发往 deepseek-v4-pro 的请求都会被路由到 V4.1-Flash,并按 Flash 的价格计费。这个 552B 参数的 Flash 模型,输入时只激活 8B 参数,如今代表整个 V4 系列作答。
这就是本周“deepseek v4.1 flash”搜索量背后的故事,它之所以重要有两个原因。第一,架构是全新的。Causal Encoder-Decoder 拆分、每 token 890 字节的 FP4 KV cache、以及从第一步预训练就具备的原生视觉能力,都不是对 DeepSeek V4 的增量改动。第二,价目表也跟着变了。如果你原本按 V4-Pro 的价格付费,那么到 14 号,无论你是否改动任何东西,账单都会下降 70% 甚至更多。
本指南覆盖已发布的内容、架构在开发者视角下如何运作、厂商基准测试给出了什么数字,以及定价算术。最后给出一个在 Apifox 中用你自己的 prompt 测试该模型的工作流,因为一张基准测试表只是起点,不是结论。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

TL;DR
- DeepSeek-V4.1-Flash 已于 2026 年 9 月 10 日 GA。模型 id:
deepseek-flash。Base URL 不变,仍为https://api.deepseek.com。 - 552B MoE(加上视觉编码器为 763B),prefill 激活 8B,decode 激活 16B。1M 上下文窗口,最大输出 384K。
- 按 DeepSeek 自己给出的数字,它在 HumanEval、GSM8K、DeepSWE 和 Terminal-Bench 上超过 V4-Pro。
- 高峰定价:每 1M cache-miss 输入 $0.30,每 1M 输出 $1.20。非高峰为半价。
- V4-Pro 请求将于 9 月 14 日 04:00 UTC 改路由到 V4.1-Flash。
9 月 10 日发布了什么
DeepSeek 从 9 月 8 日起进行了为期两天的内测,模型名为 deepseek-v4.1-flash-expires-on-0910,每个账号并发请求上限为 20,定价与 deepseek-v4-flash 相同。TechNode 报道了这次内测。两天后该模型正式 GA,changelog 中有一条日期为 2026-09-10 的记录,并在 X 上发布了公告。
有三处命名变化会影响你的代码:
- 新的模型 id 是
deepseek-flash。新集成请使用它。 - 旧名称
deepseek-v4-flash和deepseek-v4-flash-vision-exp仍然可以解析,但由 V4.1-Flash 提供服务。V4-Flash 和 V4-Flash-Vision-Exp 作为独立模型已下线。 deepseek-v4-pro会一直可用到 9 月 14 日,之后路由到 V4.1-Flash。
Base URL 没有变化:OpenAI 格式使用 https://api.deepseek.com,Anthropic 格式使用 https://api.deepseek.com/anthropic。Flash 系列此前已支持 Responses API,因此 Codex 风格的集成可以直接沿用。参数细节(包括图片输入和 reasoning effort)请参阅如何使用 DeepSeek-V4.1-Flash API。
开发者视角下的 Causal Encoder-Decoder 架构
模型卡描述了一种 DeepSeek 称为 Causal Encoder-Decoder(简称 CED)的设计。当你自己是那个为 token 付费的人时,下面每个数字意味着什么,值得逐个说清。
552B 参数,带视觉为 763B。语言主干是一个 552B 参数的 mixture-of-experts 模型。加上为本次发布从零训练的 DeepSeek-ViT 编码器,完整模型达到 763B。这些是存储参数量,不是一次请求的成本。
prefill 激活 8B,decode 激活 16B。这是最核心的变化。40 层被拆分为 20 层编码器和 20 层解码器。读取你的 prompt(prefill)时,每个 token 激活约 8B 参数;写出答案(decode)时激活约 16B。早期的 DeepSeek MoE 模型对两个阶段使用同一份激活参数预算。
为什么这个拆分重要?prefill 受算力限制:你要一次性把一份 200K token 的文档推过模型。decode 受内存带宽限制:你一次生成一个 token,成本来自从 HBM 读取权重和 KV cache。prefill 用更少参数可以缩短长输入的首 token 延迟(time-to-first-token);decode 用更多参数,则是在额外算力相对内存流量更便宜的环节换取回答质量。一段 1M 上下文的 agent 轨迹如果只产出 2K token 的回复,其中 99.8% 的 token 都走的是便宜的那条路径。
每层 384 个 routed experts 加 1 个 shared expert。router 为每个 token 从 384 个 expert 中挑选少数几个,shared expert 则每次都参与计算。552B 的存储参数就是这样变成 8B 或 16B 的激活量。
CSA2 与 FP4 KV cache。Compressed Sparse Attention 2 提供三种静态 attention 模式。配合主 KV cache 的 FP4 存储,全局 cache 占用为每 token 890 字节,约为 DeepSeek-V4-Flash 的四分之一。发布说明中的说法是 HBM 占用为上一代的 1/4,SSD 存储为 1/8。按每 token 890 字节计算,完整的 1M token 上下文约需 0.9 GB KV cache。这也是 Flash 的并发上限为 2,500、而 Pro 为 500 的部分原因。
1M 上下文窗口,384K 输出。稀疏 attention 在 64K 长度上训练,并在 45T token 多模态语料推进到 34T token 时扩展到 1M。reasoning effort 被描述为可在 1 到 100 的刻度上连续调节;该刻度对应的具体 API 参数形态需对照文档 [VERIFY]。
基准测试:DeepSeek 公布了什么数字
本节所有数字都来自 DeepSeek 模型卡的自我报告。截至 9 月 10 日,尚无独立评测发布。请把它们当作厂商的主张来读,然后自己跑一遍。
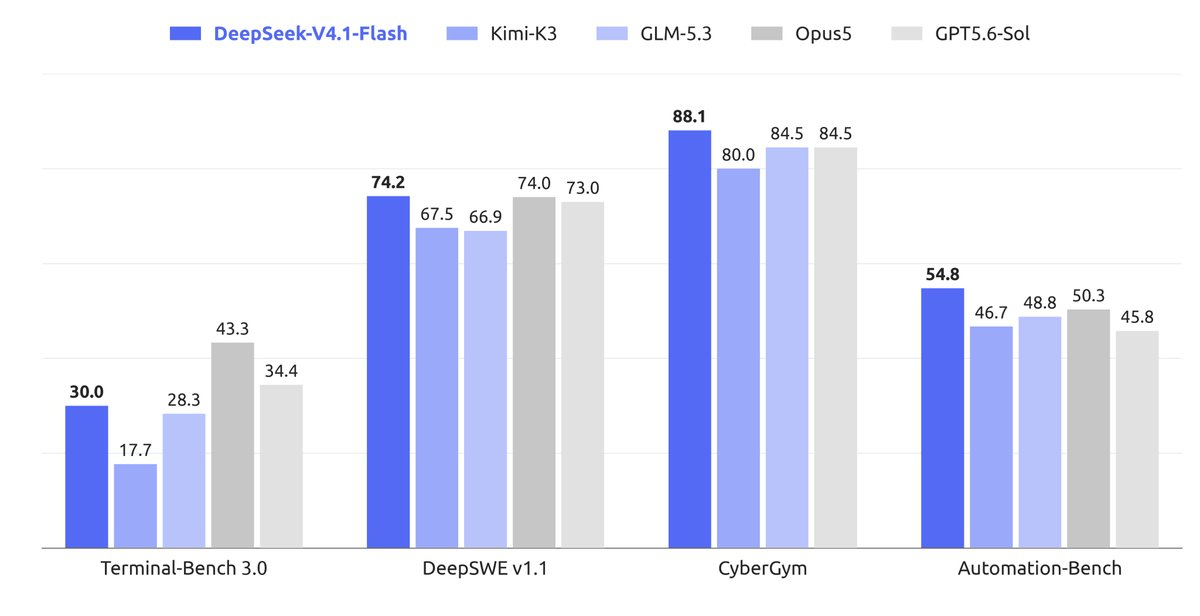
规律很一致:V4.1-Flash 在每一行上都高于 V4-Pro,差距最大的是 agentic coding。DeepSWE 比 Pro 高出 11.5 分,比旧版 Flash 高出近 20 分。GSM8K 已经饱和,所以 0.4 分的优势说明不了什么。
视觉分数同样是厂商自报:MMMU-Pro 56.5,CVBench 77.9,DocVQA 95.6,RefCOCO 86.0。DocVQA 是值得盯住的那个数字,因为文档解析是生产环境视觉流量最主要的去向。
DeepSeek 对 V4-Pro 改路由的说法是,V4.1-Flash“在性能、成本、速度和总耗时上已全面超越 V4 Pro”,并引用多方测试作为依据。这些“多方”并未具名。请把这句话当成一个你可以自行验证的主张。
定价与 V4-Pro 改路由
下表费率来自定价页面,自 9 月 10 日 04:00 UTC 起生效,单位为美元/1M token。
| deepseek-flash 非高峰 | deepseek-flash 高峰 | deepseek-v4-pro 非高峰 | deepseek-v4-pro 高峰 | |
|---|---|---|---|---|
| 输入,缓存命中 | $0.003 | $0.006 | $0.022 | $0.044 |
| 输入,缓存未命中 | $0.15 | $0.30 | $0.66 | $1.32 |
| 输出 | $0.60 | $1.20 | $1.98 | $3.96 |
高峰时段为工作日的 01:00 至 04:00 和 06:00 至 10:00 UTC;非高峰为高峰的 50%。上下文缓存是自动的,在任一档位上,缓存命中的成本都比未命中低 50 倍。
相比 V4-Flash 8 月的费率,V4.1-Flash 把缓存命中输入降低约 57%,缓存未命中输入降低约 32%,输出降低约 9%。
V4-Pro 那一列值得盯住。9 月 14 日之后,发往 deepseek-v4-pro 的请求按 Flash 列计费。高峰时段下,每 1M cache-miss 输入为 $0.30 而非 $1.32(便宜 77%),每 1M 输出为 $1.20 而非 $3.96(便宜 70%)。你不动代码就能拿到这个降价,不过还是应该更新模型 id,而不是依赖一个已下线的别名。迁移指南给出了完整的检查清单,定价深潜则讲清了长 agent 会话下的缓存命中算术。
在 Apifox 中用你自己的 prompt 评测 V4.1-Flash
厂商的表格说这个模型擅长 DeepSWE,但它没说它能否处理你的抽取数据模型、你的 tool-call 格式,或者你那 30 万 token 的客服对话记录。下面是一套 Apifox 工作流,一个下午就能回答这些问题,并且能在每次模型悄悄更新之后继续给出答案。
- 把密钥存为环境变量。创建一个 Apifox 环境,并添加来自 DeepSeek 平台的
DEEPSEEK_API_KEY。在 Authorization header 中以Bearer {{DEEPSEEK_API_KEY}}引用它。 - 添加接口。创建
POST https://api.deepseek.com/chat/completions,或导入一份 OpenAPI 规范。 - 为每个真实 prompt 保存一个请求。从生产日志里取五到十个 prompt,每个都保存为独立请求,并使用
"model": "deepseek-flash"。在 14 号之前保留一份指向deepseek-v4-pro的副本,这样就能并排 diff 输出。 - 开启流式并观察事件。设置
"stream": true。Apifox 会逐事件渲染 SSE 响应,因此 reasoning delta 和答案 delta 会分别显示,而不是一大片data:行。这是观察长 prefill 下首 token 延迟最快的方式。 - 添加断言并构建测试场景。对状态码、预期出现
tool_calls字段的位置,以及输出的 JSON 合法性做断言。把保存的请求串联成一个测试场景。 - 每次模型更新后重跑。当 DeepSeek 在
deepseek-flash背后推送下一次变更时,运行这个场景。用apidog-cli把它接入 CI,让它在每次部署时运行。
下面是其中一个保存的 prompt 的 body,使用 OpenAI SDK:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Extract the order ID, SKU list, and refund amount as JSON."},
        {"role": "user", "content": "Ticket #48213: customer wants a refund of $42.90 for SKUs KB-220 and MS-114 from order ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
FAQ
DeepSeek-V4.1-Flash 是 V4-Pro 的替代品吗?是的,这是 DeepSeek 的决定。从 9 月 14 日 04:00 UTC 起,deepseek-v4-pro 的请求由 V4.1-Flash 按 Flash 价格提供服务。V4 API 阵容中已经没有更大的模型了。
我需要改 model id 吗?不必马上改。deepseek-v4-flash、deepseek-v4-flash-vision-exp,以及(14 号之后的)deepseek-v4-pro,都会解析到 V4.1-Flash。下次改这份集成时再切到 deepseek-flash 即可。API 指南里有完整的参数参考。
8B prefill / 16B decode 对延迟意味着什么?输入侧更少的激活参数意味着长 prompt 下更快的首 token 延迟。输出侧更多的参数意味着算力被用在决定生成质量的地方。每 token 890 字节的 KV cache 让长会话在内存中的持有成本更低。
我能在本地跑它吗?权重在 Hugging Face 上以 MIT 许可发布。仅主干在 8-bit 下就约 552 GB、4-bit 下约 280 GB,所以这是一个多 GPU 或 SSD 流式加载的项目,不是笔记本能干的活。首发当天的推理引擎支持情况 [VERIFY]。
这些基准测试是独立的吗?不是。上面每一个分数都来自 DeepSeek 的模型卡。技术报告里有方法论说明。
V4 系列由此走向何处
DeepSeek 把双模型 API 收拢成了一个。它押的是:一个 552B 模型,配上 16B 的 decode 预算、四分之一大小的 KV cache、以及每账号 2,500 个并发会话,在服务 agent 类负载上,比一个价格高三到四倍的更大模型更划算。厂商的数字支持这个赌注;而它是否成立,由你的负载决定。
把你的 SDK 指向 deepseek-flash,在 14 号之前用你自己的 prompt 跑一遍,并保留那套测试场景。如果你原本就是基于 V4-Flash API 构建的,你的集成现在已经可用。变的是它背后的模型,而这正是值得测量的部分。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。

值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会

