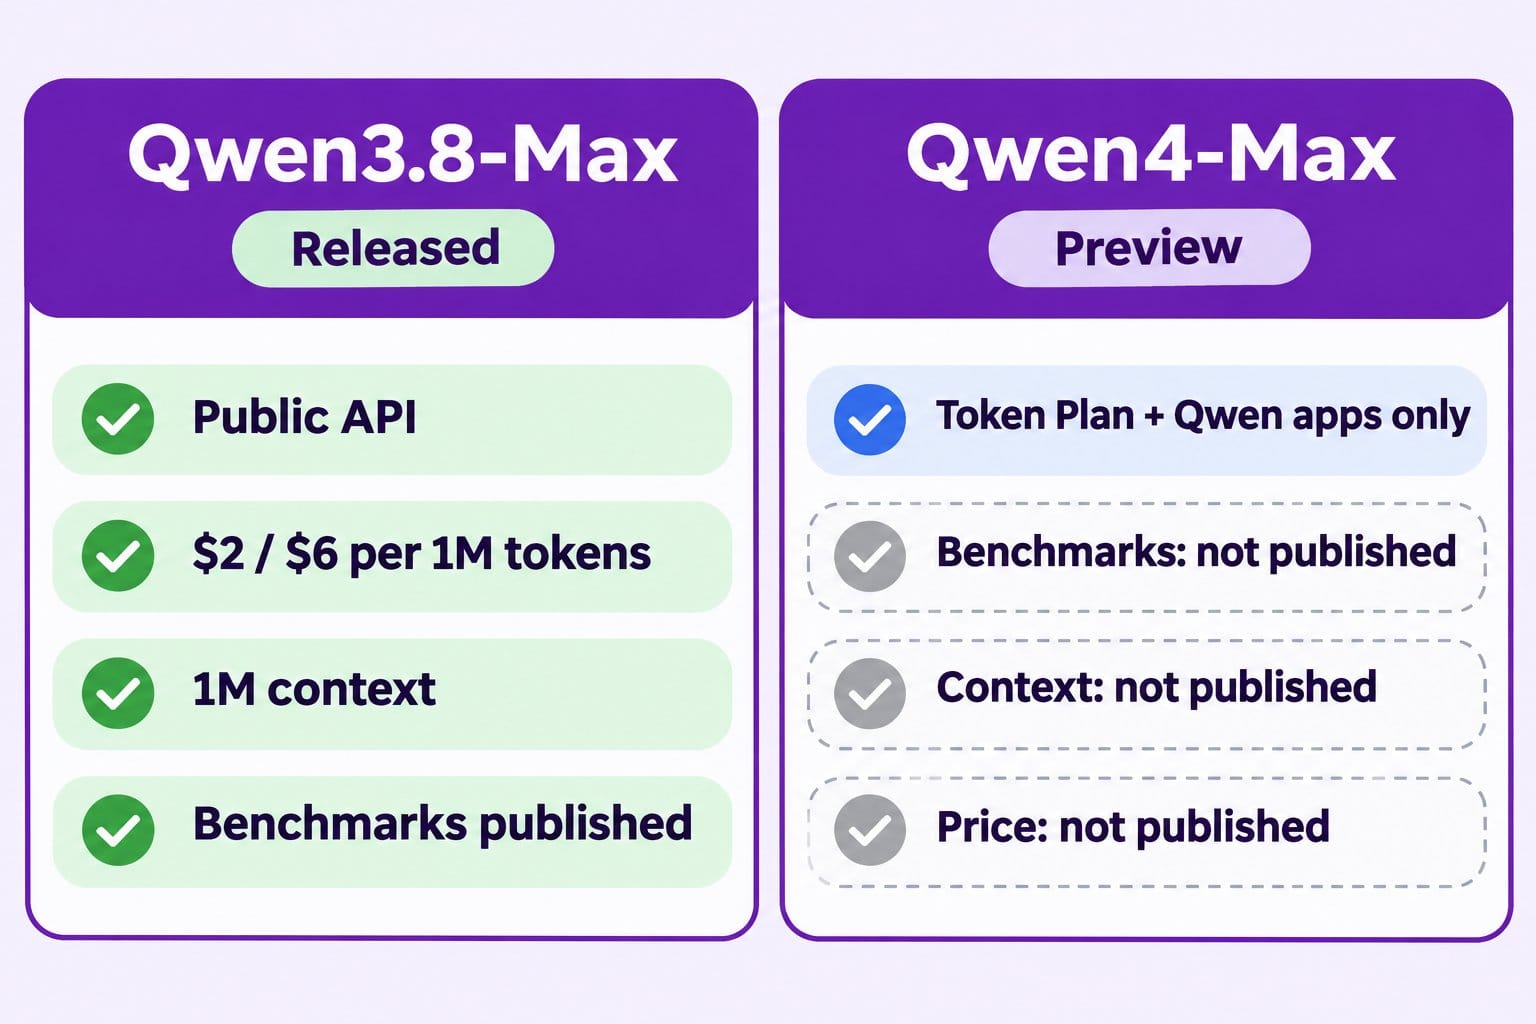
Qwen4-Max 与 Qwen 3.8 的现状可以归结为一句话:Qwen4-Max 目前处于预览阶段,仅能通过阿里巴巴的 Token Plan 及其自有应用使用,尚未公布基准测试分数、上下文长度或按 token 计费单价;而 Qwen3.8-Max 是已正式发布的模型,提供每百万 token $2 / $6 的公开 API、1M token 上下文窗口以及 131K 输出上限。生产环境请选择 Qwen 3.8;而在你自己的开发任务中可以实测体验 Qwen4-Max。
这是截至 2026 年 11 月 11 日(阿里 Qwen 团队上线 Qwen4-Max 预览版当天)的真实进展。下文将依次梳理:本次更新的内容、目前已可核实的差异、尚无法对比的空白项,以及一套实操对比方案。刚接触这两款模型?可以先了解 Qwen4-Max 是什么以及 Qwen 3.8 是什么。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Qwen4-Max 与 Qwen 3.8 一览
以下每一行数据均整理自 2026 年 11 月 11 日核查的阿里巴巴官方页面。
| 对比维度 | Qwen4-Max(预览版) | Qwen3.8-Max |
|---|---|---|
| 发布状态 | 预览版,2026 年 11 月 11 日公布 | 正式版,2026 年 8 月起全面开放(GA) |
| 模型 ID | qwen4-max-preview(Token Plan) |
qwen3.8-max |
| 按量付费 API | 未公布 | 支持,兼容 OpenAI 与 Anthropic 格式 |
| 每百万 token 价格 | 未公布 | 输入 $2 / 输出 $6 |
| 上下文窗口 | 未公布 | 1M tokens |
| 最大输出长度 | 未公布(Qwen Code 默认值为 32,768) | 131K tokens |
| 输入模态 | 文本与图像(Token Plan 标签) | 文本、图像与视频 |
| 参数规模 | 未公布 | 总参数 2.4T,混合专家(MoE)架构 |
| 官方基准测试 | 暂无 | 发布时已公开官方评测表 |
| Token Plan 支持 | 支持,带“限时 2 折(Limited-Time 80% Off)”标签 | 支持,带“夜间 6 折(40% Off Nights)”标签 |
数据来源:Qwen3.8-Max 模型页 与 Token Plan 定价页。Qwen4-Max 尚无独立模型页,我们在核查时其对应 URL 返回 404。
阿里巴巴表示 Qwen4-Max 有哪些变化
发布在 X 上的官宣帖 以“Qwen4 is coming”开篇,并列出了四项改进。请注意,这些是 Qwen 团队的官方说法,而非实测数据:
- 更深厚的知识储备(Deeper knowledge): 在专业领域的问答表现更好。
- 更丰富的世界理解(Richer world understanding): 对真实世界上下文的推理能力更强。
- 更强的编码与 Agent 能力(Stronger coding and agentic capabilities): 在任务规划、工具调用和多步执行上表现更佳。
- 面向真实世界任务打造(Built for real-world tasks): 公告点名提到了“复杂编码与知识工作”、“前端构建”以及“专业软件工程工作流”。
不难发现,这些宣传点与 Qwen 3.8 当初的定位非常接近。Qwen3.8-Max 的模型页同样写着“编码与专业工作的全面跃升”以及“跨度长达 10 天以上的自主项目”。演进方向没有变,Qwen4-Max 宣称在同一条路线上走得更远。公告最后写道“拿真实问题去检验它吧(Put it to the test on a real problem)”——在官方规格表尚未公布前,这确实是最务实的建议。
目前已经可以对比的 5 项差异
今天有五项差异是可以明确核实的。
1. 发布阶段。 Qwen3.8-Max 是已正式发布的模型,拥有明确的速率限制文档(模型页标注为每分钟 2,000,000 tokens)。Qwen4-Max 则是预览版,其行为表现、额度限制或模型 ID 在正式发布前都可能调整。
2. 调用方式。 Qwen 3.8 运行在 Qwen Cloud 标准的按量付费 API 上,因此你可以直接将其接入生产环境后端。Qwen4-Max 目前只能通过 Token Plan 端点和阿里巴巴自有应用调用。Token Plan 常见问题文档 明确指出,个人版(Individual)套餐仅供“通过指定工具进行个人交互式开发”,禁止用于生产自动化、批量脚本和后台定时任务。
3. 实际输出长度。 Qwen3.8-Max 标注了 131K 的最大输出上限。而对于 Qwen4-Max,目前唯一有据可查的数字是一个客户端默认值:Qwen Code 配置指南 指出 qwen4-max-preview 默认的最高输出限制为 32,768 tokens,你可以通过 generationConfig.samplingParams.max_tokens 将其调高。这只是工具端的设置,不代表模型本身的硬性上限。
4. 输入类型。 Token Plan 为 Qwen4-Max 打上了文本生成(Text Generation)、推理模型(Reasoning Model)和视觉理解(Visual Understanding)标签。Qwen3.8-Max 的模型页则明确支持文本、图像和视频输入。
5. API 特性。 Qwen3.8-Max 提供了完整的函数调用(function calling)、结构化输出、上下文缓存、批量文件处理(batch files)以及微调文档。而 Qwen4-Max 目前还没有公开这些特性的文档。
目前还无法对比的 4 项空白
截至 2026 年 11 月 11 日,大家最关心的以下四项对比还无法进行:
- 基准测试分数: 阿里巴巴尚未公布任何 Qwen4-Max 的跑分数据。如果你想查看 Qwen 3.8 的官方基准成绩,可参考我们的 Qwen 3.8 基准测试解析。
- 上下文窗口: 坊间有一些文章称 Qwen4-Max 拥有 1M token 上下文。但阿里巴巴官方页面并未这样写,而且 Kie.ai 的深度分析 也指出 1M 这个数字实际上属于 Qwen3.8-Max。
- 按 token 计费单价: 官方尚未挂出按量付费价格表,因此无法与 Qwen 3.8 的 $2 / $6 直接并排对比。Token Plan 也没有说明单次 Qwen4-Max 请求具体消耗多少 Credits。
- 参数规模与架构: 阿里巴巴尚未公布 Qwen4-Max 的参数量。而 Qwen3.8-Max 是 2.4T 参数的混合专家(MoE)模型。
目前任何填上了这些空白数字的文章都属于猜测。关于具体的访问渠道,可查看如何使用 Qwen4-Max。
访问方式与定价:Qwen4-Max 对比 Qwen 3.8
Token Plan 是目前唯一同时包含这两款模型的订阅计划。2026 年 11 月 11 日,其新加坡区域页面展示的个人版月度价格(美元)如下:
| 套餐档位 | 活动价 | 挂牌价 | 每月 Credits 额度 | 并发 Agent 数 |
|---|---|---|---|---|
| Lite | $3.00 | $8.00 | 20,000 | 1-2 |
| Essential | $5.00 | $16.00 | 45,000 | 2-3 |
| Standard | $18.00 | $25.00 | 80,000 | 3-4 |
| Pro | $43.00 | $51.00 | 200,000 | 6-8 |
活动价面向新用户,且页面注明最终价格以登录后结账页显示为准。两款模型共用同一个 Credit 额度池。其中 qwen4-max-preview 带有“限时 2 折(Limited-Time 80% Off)”标签,qwen3.8-max 则带有“夜间 6 折(40% Off Nights)”标签。
Qwen 3.8 则拥有完整的按量付费价格表:每百万 token 输入 $2、输出 $6、隐式缓存命中 $0.25,批量文件处理为 $1 / $3。完整的成本计算可阅读我们的 Qwen 3.8 API 指南。
如果你要在后端服务中调用模型,两者之中只有 Qwen 3.8 可选。如果你是在本地配合编码 Agent 写代码,Token Plan 可以让你用一份订阅同时体验两款模型。
自己动手跑一场 Qwen4-Max 与 Qwen 3.8 的对比测试
在没有官方基准测试的情况下,你自己的实测就是最好的证据。API 开发任务非常适合用来做评测,因为接口能不能通过测试用例一目了然。
Qwen Code 指南的示例配置已经在同一个 Token Plan 端点下同时列出了这两款模型,因此切换模型只需在菜单里选一下:
{
  "$version": 4,
  "env": { "QWENCLOUD_TOKEN_PLAN_API_KEY": "YOUR_API_KEY" },
  "modelProviders": {
    "openai": [
      { "id": "qwen4-max-preview", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" },
      { "id": "qwen3.8-max", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" }
    ]
  }
}
将上述配置写入 ~/.qwen/settings.json,然后按以下步骤设计一场公平测试:
- 先写好一份统一的接口契约。 为一个小型 API 创建一份
openapi.json(例如包含参数校验和鉴权规则的POST /orders与GET /orders/{id})。不要让任何一个待测模型去写这份规范,避免模型“自己给自己出题打分”。 - 创建两个空目录
build-qwen4和build-qwen38,分别放入一份该规范的副本。 - 在两个目录中发送完全一致的构建提示词,其中一个选择
qwen4-max-preview,另一个选择qwen3.8-max:“使用 Express 实现 openapi.json 中的 API,分别运行在 3001(或 3002)端口,不要修改接口规范。” - 记录基础表现:从开始到服务成功启动的耗时、生成的文件数量,以及中途是否需要人工介入修复。
接着,用同一套测试套件检验两个构建产物。这正是 Apifox CLI 发挥作用的地方。
用 Apifox CLI 为两份构建产物打分
你可以让编码 Agent 驱动 Apifox CLI:导入共享的接口规范,基于规范创建一套测试用例,然后分别针对两个本地构建环境运行这套测试。同一套测试、两个目标服务、两份并排报告。
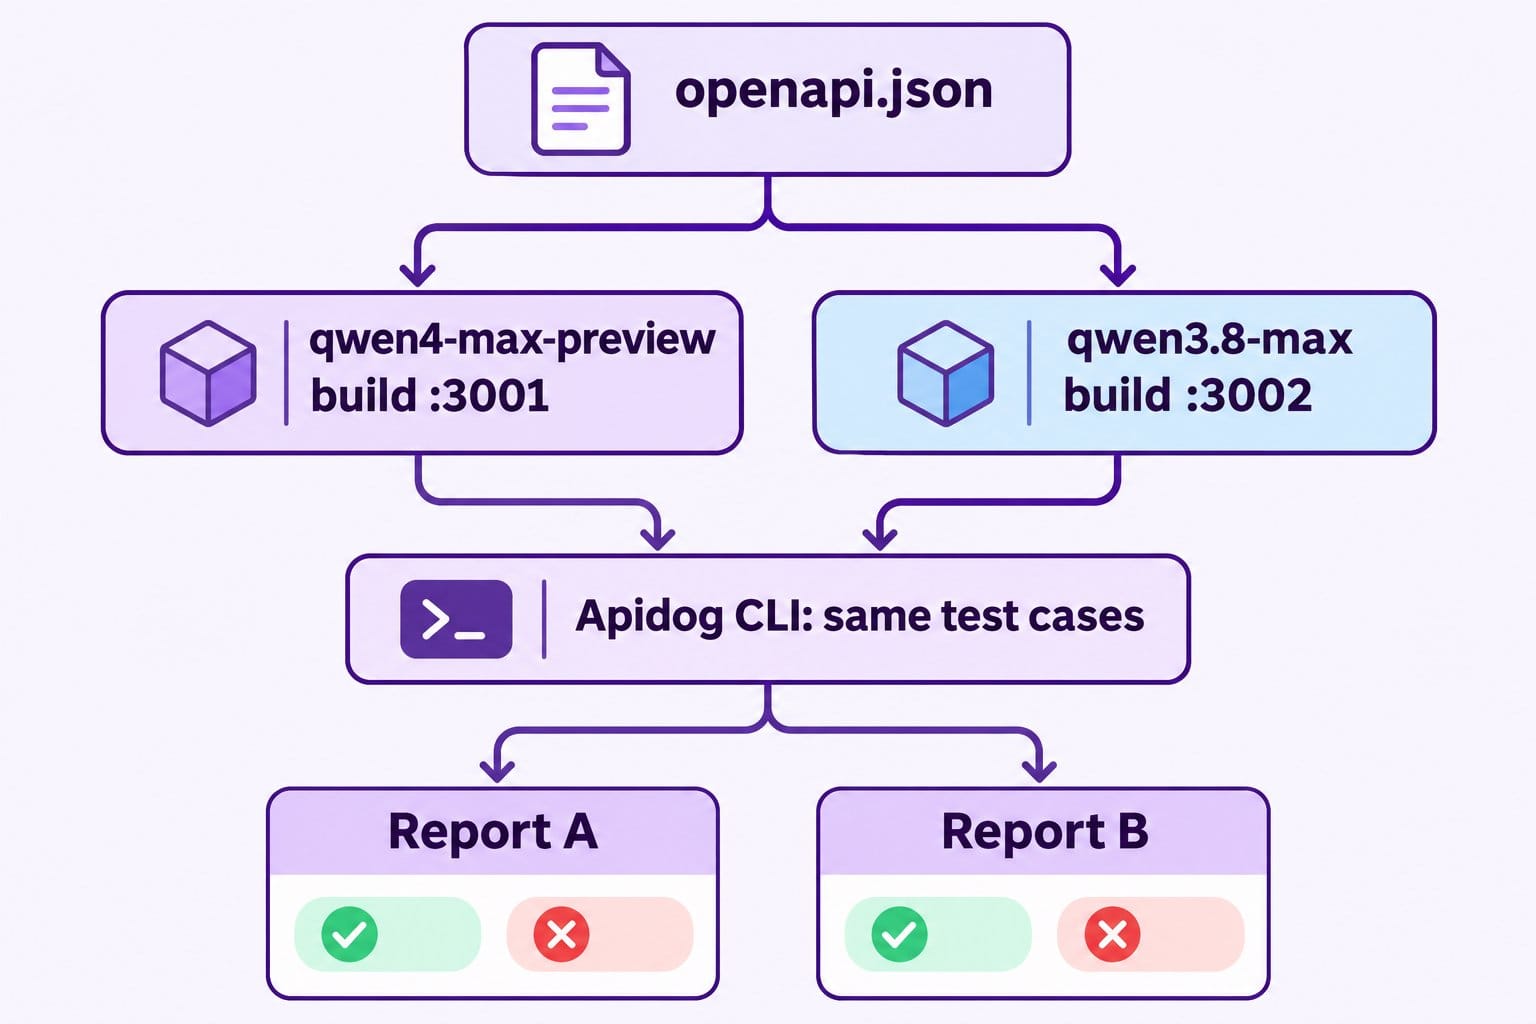
安装并登录 Apifox CLI
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_APIFOX_TOKEN>
apifox test-case category --project <PROJECT_ID>
给你的 Agent 一条提示词
任何编码 Agent 都可以担任裁判,不一定要用 Qwen 模型。
Import ./openapi.json into Apifox project <PROJECT_ID>. Configure two environments:
qwen4 at http://localhost:3001 and qwen38 at http://localhost:3002. From the spec,
create test cases for POST /orders: 201 on a valid order, 400 on a missing
customerId, 401 without a token, plus a GET /orders/{id} 404 case. Run every case
against both environments, save JSON reports, and give me a pass/fail table per model.
Don't modify either build.
Agent 执行的 apifox 命令
以下命令参数均对照 Apifox CLI 2.2.12:
apifox import --project <PROJECT_ID> --format openapi --file ./openapi.json
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file ./case-201.json
apifox test-case create --project <PROJECT_ID> --file ./case-201.json
apifox test-case run <CASE_ID> --project <PROJECT_ID> -e <QWEN4_ENV_ID> -r cli,json --out-file qwen4-{GENERATE_TIME}
apifox test-case run <CASE_ID> --project <PROJECT_ID> -e <QWEN38_ENV_ID> -r cli,json --out-file qwen38-{GENERATE_TIME}
cli-schema get 会为 Agent 提供测试用例的准确 JSON 结构,cli-schema validate 则会在写入前校验每个文件。Agent 会依次为每个用例执行创建和两条运行命令。cli 报告器会在终端打印通过/失败摘要,json 报告器则会将报告保存在 apifox-reports 目录中供 Agent 汇总成对比表。加上 --upload-report 还可以在 Apifox 客户端中查看运行结果。
报告重点看什么
为每个模型统计三件事:首轮构建直接通过的用例数、全部变绿所需的修复轮数,以及模型是否出现了“为了凑通过而擅自修改接口契约”的情况。建议把整套流程重复跑两到三次,因为预览版模型的单次运行结果偶然性较大。
今天该选哪一个?
根据你的实际任务对号入座:
- 生产环境应用或后端服务: 选 Qwen 3.8。它拥有公开 API、透明的定价和完善的限流文档,而且 Token Plan 的使用条款本身就禁止将 Qwen4-Max 用于生产环境。
- 配合 Agent 日常写代码: 在 Token Plan 上同时试试两款模型。从你真实的待办需求里挑一个任务跑上面的测试,不要只拿玩具示例测试。
- 需要明确数据支撑的选型决策: 先等等。Qwen4-Max 的基准测试、上下文长度和按量单价都还没公布。
建议把模型 ID 抽成一个单独的配置项,等 Qwen4-Max 正式版 ID 发布时只需改一行代码即可切换。
常见问题
Qwen4-Max 比 Qwen 3.8 更强吗? 阿里巴巴表示它具备更深厚的知识储备以及更强的编码与 Agent 能力,但尚未公布基准测试分数。目前还没有官方数据能够证明这一点,建议在你自己的任务上实测对比。
我可以像调用 Qwen 3.8 一样通过按量 API 调用 Qwen4-Max 吗? 目前不能按量付费调用。Qwen4-Max 仅在 Token Plan 端点下以 qwen4-max-preview 标识提供,用于编程工具中的交互式开发。Qwen3.8-Max(qwen3.8-max)则提供标准 API。
Qwen4-Max 和 Qwen 3.8 一样拥有 1M token 上下文吗? 阿里巴巴官方尚未说明。Qwen3.8-Max 有明确文档标注支持 1M 上下文;而关于 Qwen4-Max 1M 上下文的说法目前仅来自第三方报道。
Qwen4-Max 与 Qwen 3.8 相比价格如何? Qwen 3.8 按每百万 token 输入 $2、输出 $6 计费。Qwen4-Max 尚未公布按 token 计费单价。在 Token Plan 订阅下,两款模型共享同一个 Credit 额度池,月费从 $3 起(Lite 档活动价,挂牌价 $8)。
我应该把应用从 Qwen 3.8 切换到 Qwen4-Max 吗? 暂时不要。预览版随时可能发生变更,而且 Token Plan 禁止生产自动化调用。建议在生产环境保持使用 Qwen 3.8,同时在开发环境中并排试用 Qwen4-Max。