10 月 2 日,ServiceNow CoreAI 发布了 AutoSynthData:一条把「Agent 在哪里失败」自动转成「它接下来该练什么」的数据生成流水线。它不重新造模型,只针对目标模型的具体短板批量造题、验题、再微调。官方给出的两个例子里,一个把平均 Pass@1 提升 7.2 个百分点,另一个从 18.77% 提到 27.18%。
企业里给 Agent 做微调的团队,通常卡在同一件事上:模型在这些系统、规则和数据结构上就是会失败,但你手里没有那么多覆盖同一能力的训练样本。单次失败很有信息量,可训练需要成百上千个「考同一能力」的新任务,而且这些任务还得满足三个条件——在环境里能跑通、像真实用户提的需求、结果可以被确定性验证。人工写这样的题,成本高到不现实。
发生了什么:把任务拆成三件套,再按短板批量造题
AutoSynthData 把每个训练任务拆成三件套:系统规格(system specification)、用户提示(user prompt)、验证器(verifier)。它对三者分别提要求——任务要可行、要像真人提的、还要有足够难度(已经被解出来的任务几乎没有训练信号);验证器则要跟提示、规格和状态一致,既要够严格能拒绝错误答案,又要够宽容能接受合理的不同解法,而不是只认一条参考轨迹。
流程起点是「诊断」:把目标模型和一个更强的教师模型放在同一批评测任务上跑,从结果里抽出能力标签、工具与工作流结构、失败模式、成功特征,以及哪些地方允许变化。这些发现会被压成「经过脱敏的能力规格卡」——生成器看不到原始提示、实体、轨迹和验证器细节,这是为了防止合成数据把原题照抄一遍。
生成分两个阶段。Target 阶段产出经过审核的核心样本;Multiply 阶段基于它们造出新的变体,每个变体都有自己的请求、状态、实体、参考轨迹和验证器。官方特别说明:Multiply 出来的样本不能再作为下一轮 Multiply 的种子,这样扩张始终锚定在已审核的集合上,不会几轮之后漂移得面目全非。质量控制上,除了正反两向的验证和一个有界的「批评—修复」循环,还有批级别的元审查,用来发现某类任务占比过高、某些能力缺失、样本重复,或批评环节本身存在系统性问题,然后重新平衡生成比例。
架构分成两层:共享的控制器负责生成、质控、覆盖度和数据集构建;环境相关的适配器负责执行、状态与任务管理、参考轨迹回放、确定性验证、求解器运行和任务画像。作者提到这套机制理论上也能接到强化学习上,但此次实验只做了监督微调。
完整工作场景:用谁做教师,练的是谁
两个公开的例子里,目标模型都是 Gemma-4-26B-A4B-it。Hybrid 场景用 Qwen3.8-27B 当教师,约 18 小时生成 2000 条合成样本,最佳检查点出现在第 5 个 epoch:平均 Pass@1 提升 7.2 个百分点(相对提升 35%),验证器成功率从 63.01% 升到 68.55%,补上了 Gemma 与参考模型之间原始 Pass@1 差距的 59%。
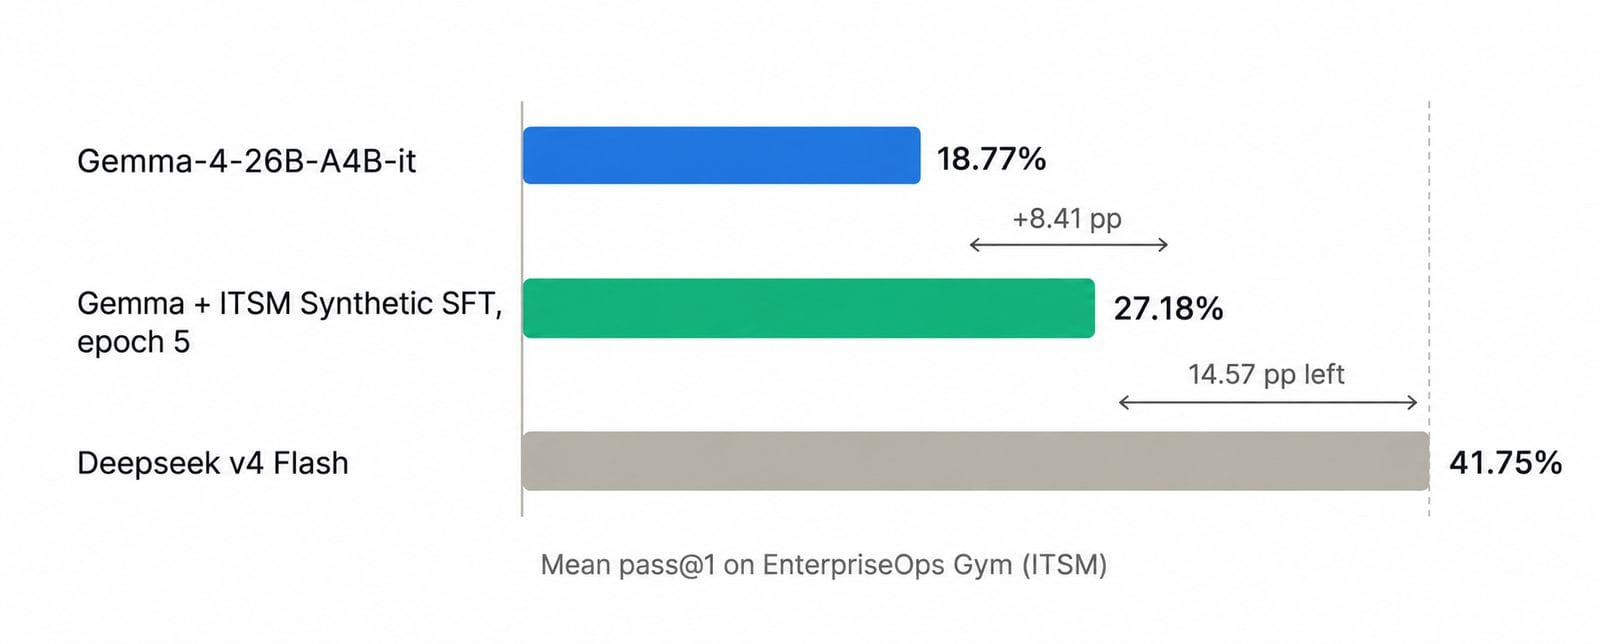
ITSM 场景换成 DeepSeek-V4.1-Flash 当教师,耗时 66 小时生成 1994 条样本——慢得多,官方归因于教师更大、以及流水线本身还没做过优化。结果是平均 Pass@1 从 18.77% 提升到 27.18%。这个数字要连着看:教师模型在同一评测上的成绩是 41.75%,也就是说合成微调之后,两个模型之间还差 14.57 个百分点。合成数据能补一段距离,但没有一步到位。
为什么这对自建 Agent 的团队有意义
它给出的是一套可复制的流程,而不是一个模型。对企业内部做 Agent 微调的团队,最直接的启发有三点。第一,把评测和训练接成闭环:先把目标模型和教师模型放在同一批评测上跑出差异,再让差异决定下一批训练数据造什么,而不是预先写死一个数据集然后反复调参。第二,验证器比生成器更值得投入:任务能不能被确定性判分,决定了这批数据最终有没有用;官方把「完备性」写得很清楚——只认一条参考轨迹的验证器会系统性排斥合法变体。第三,脱敏隔离要有:生成器只看到能力规格卡而不是原题,这是合成数据不变成「换个说法的同题」的关键。
值得注意的是成本结构。18 小时、66 小时这样的数字,意味着这套流程的瓶颈不在推理调用费,而在于求解器反复运行与验证的机器时间。想复用的团队要先把「可确定性验证」这件事在自己的业务环境里解决掉,否则流水线跑不起来。
限制与需要注意的地方
最需要说清的是交付物边界:这次发布是方法与数据集,不是可直接安装的工具。官方链接放出的是评测环境数据集 EnterpriseOps-Gym,博客没有给安装说明、代码仓库,也没有发布 AutoSynthData 本身的产物。也就是说,控制器与适配器这套流水线,需要团队按方法自己实现,或者等后续发布。
另外三点也要记住。其一,官方实验只做了监督微调,虽然提到同一机制可扩展到 RL,但没有给出 RL 的实验结果,别把它当成已验证的 RL 方案。其二,两个场景都跑在企业运营类环境(Hybrid 与 ITSM),换到客服、代码、数据分析等别的领域,验证器怎么写、任务怎么抽象都需要重新设计。其三,博客没有写明 AutoSynthData、生成数据或相关产物的许可证,商用前需要到对应模型与数据集页面确认。最后,两个示例里的目标模型都是 Gemma-4-26B-A4B-it 这一类同量级模型,把它当作「小模型一定能追平大模型」的证据并不成立——官方自己的图表就标着还差 14.57 个百分点。
如何试用
可以走的路是:先读这篇博客,理解「三件套 + 诊断 + 两阶段生成 + 双层质控」的结构;再拉下 ServiceNow-AI/EnterpriseOps-Gym 数据集,看看它怎么把企业运营任务组织成可执行、可验证的形式;然后拿自己业务里的一组评测任务,做一次最小闭环——跑目标模型和教师模型,找出差距最大的能力,手工造 20 到 50 条同能力的新任务验证流程是否成立。跑通这一步再考虑自动化,比一上来就搭生成器划算得多。
信息来源
- Hugging Face 博客:AutoSynthData: Generating Training Data for Enterprise Agents(ServiceNow CoreAI,2026-10-02)https://huggingface.co/blog/ServiceNow-AI/autosynthdata
- 数据集:ServiceNow-AI/EnterpriseOps-Gym(Harness: EnterpriseOps Gym,Malay et al., 2026)
- 涉及模型:google/gemma-4-26B-A4B-it(目标)、Qwen/Qwen3.8-27B(Hybrid 教师)、deepseek-ai/DeepSeek-V4.1-Flash(ITSM 教师)
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
