Mistral Large 4 开放权重于 2026 年 10 月 29 日上线 Hugging Face。你能得到与 Mistral API 相同的 1.05T 参数模型,采用修改版 MIT 许可,提供 FP8、NVFP4 检查点和社区 GGUF 量化。无需审批即可下载,可用 vLLM 或 SGLang 在 8 块数据中心 GPU 上服务,或跳过硬件直接调用 Mistral API 的 mistral-large-4,每百万输入 token $0.70。
下文介绍预览版以来的变化、下载大小、各路径硬件和许可。模型概览见 Mistral Large 4 发布解读;请求格式和 SDK 代码见 API 指南。
什么是 Mistral Large 4 开放权重?
它是 Mistral 旗舰模型的可下载检查点,绰号“Le Chonk”。多模态混合专家模型,总参数约 1.05T,每 token 激活约 49B(计入嵌入和输出层为 52B),1.6B 视觉编码器,1M token 上下文,采用 Mistral Ecosystem Open-Weight License。
官方模型卡列出 72 个文本层和 128 个路由专家,每 token 选 4 个,外加 1 个共享专家。
发布不是预览版冻结副本。Mistral 的开放权重公告称模型在权重发布前又进行了三周强化学习,重点是编码和网络安全。
自 10 月 6 日预览版以来的变化
| 方面 | 10 月 6 日预览 | 10 月 29 日开放发布 |
|---|---|---|
| 权重 | 仅 API,承诺稍后发布 | Hugging Face 上的 FP8 和 NVFP4,无需审批 |
| 推理模式 | high 或 none |
low、medium、high(默认 high);low 取代 none |
| Terminal-Bench 4.0(Mistral 报告) | 28% | 41%,输出 token 减少约 30% |
| B3 Agent Security 抗攻击(Mistral 报告) | 93.3% | 97.1% |
| 每 100 万 token API 价格 | 预览折扣 | 输入 $0.70,缓存输入 $0.07,输出 $2.10 |
推理模式变更会破坏代码。发送 reasoning_effort: "none" 的预览集成请改成 "low":Hugging Face 的发布文章指出 Transformers 会把 none 当作 high 运行,陈旧设置会浪费 token 而不报错。
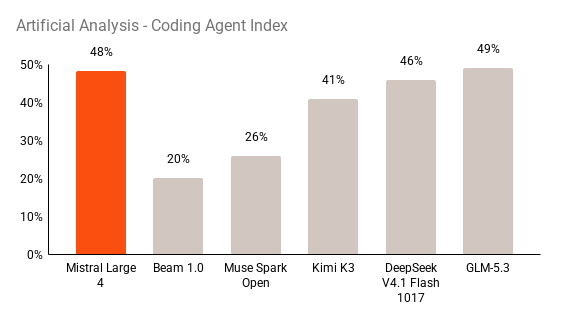
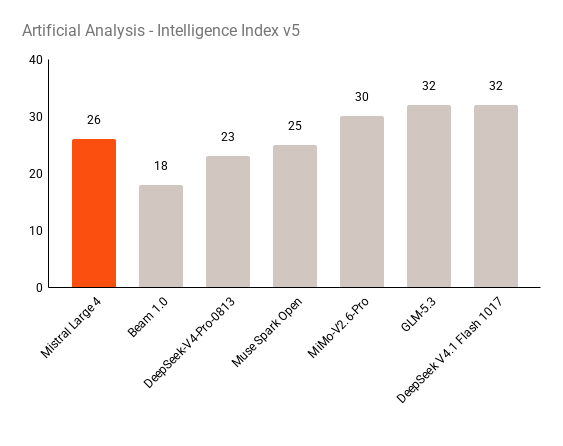
本文基准数字均由厂商报告。Mistral 还声称在 Cognition 私有 FrontierCode 2.0 上达到 19.7%,是其图表中开放权重最高分,并在 Artificial Analysis Coding Agent Index 上达到 48%,与 GLM-5.3 大致持平。我们 11 月 2 日核查时,独立复现仍待完成。
三种运行方式
- 调用 Mistral API。 模型 ID
mistral-large-4,每百万 token 输入 $0.70、缓存输入 $0.07、输出 $2.10。无需 GPU。 - 使用托管提供商。 OpenRouter、NVIDIA 托管端点和 NIM 容器,以及 Microsoft Foundry(Azure 私有部署)。
- 自托管权重。 从 Hugging Face 下载,用 vLLM、SGLang、Transformers 或 llama.cpp 服务。
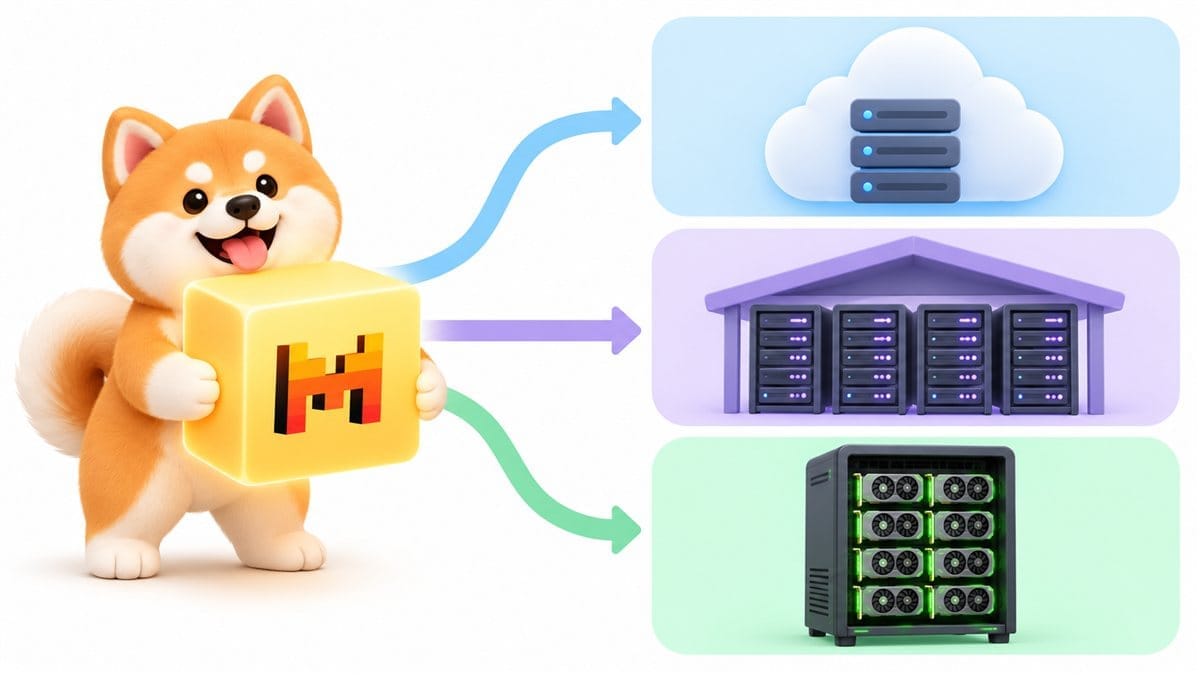
从路径 1 或 2 开始。只有具体理由才转路径 3:数据不能离开网络、需要拥有微调模型,或流量足以让 8 GPU 节点保持忙碌。
下载
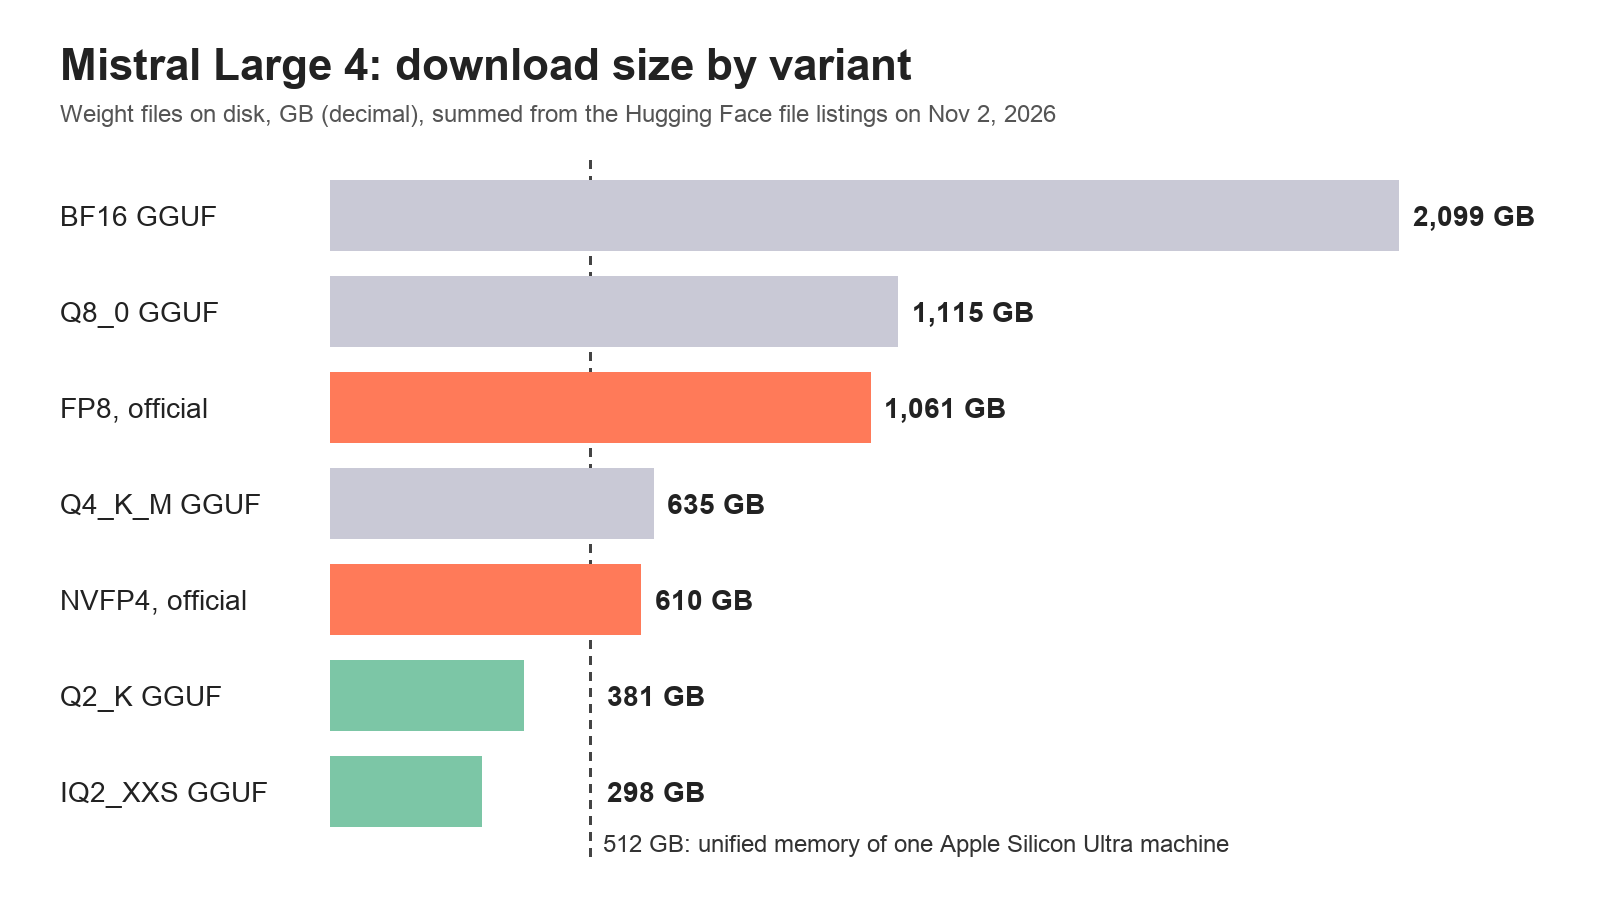
官方仓库没有门禁(Hugging Face API 报告 gated: false),任何账户或匿名客户端都能拉取。门槛是大小。
| 仓库 | 格式 | 磁盘大小 |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8,官方 | 约 1,061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4,官方 | 约 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | 约 1,115 GB |
| 同上 | Q4_K_M | 约 635 GB |
| 同上 | Q2_K | 约 381 GB |
| 同上 | IQ2_XXS | 约 298 GB |
数字于 2026 年 11 月 2 日根据文件列表汇总。Unsloth 也在 unsloth/Mistral-Large-4-1T-A52B-GGUF 发布 GGUF。
只下载需要的文件:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
以持续 1 Gbps 下载 FP8 约需两个多小时。
自托管
每个官方示例都假设一个节点 8 块 GPU、张量并行 8。
| 引擎 | 检查点 | 官方示例硬件 |
|---|---|---|
| vLLM | FP8 | 8 GPU,--tensor-parallel-size 8;Hugging Face Inference Endpoints 用 8x H200 |
| vLLM | NVFP4 | 8 块 NVIDIA Blackwell |
| SGLang | FP8 | 8 GPU,--tp-size 8 |
| Transformers | FP8 | 8 GPU,通过 torchrun |
| llama.cpp | Q2_K GGUF | 一台 512 GB 统一内存的 Apple Silicon Ultra |
vLLM
模型卡推荐 vLLM,并提供专用 Docker 镜像:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
保留两个解析器标志,否则思考文本会落进 content,工具调用以原始文本到达。更快解码可加 DSpark 推测解码:--speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'。
在 8x H200 上使用该 drafter,Hugging Face 测得单请求约每秒 65 token,负载下 1,000 段 ShareGPT 对话合计约每秒 480 token。
SGLang 也可用:sglang serve 示例使用 --tp-size 8、--speculative-algorithm DSPARK 和 auto 解析器。
Mac 上的 llama.cpp
llama.cpp 提供首日支持。Q2_K(381 GB)能装进一台 512 GB 统一内存的 Apple Silicon Ultra:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face 报告在一台 M3 Ultra 上预填充约每秒 90 token、生成约每秒 15 token:适合私人实验,对 Agent 循环很慢。2-bit 量化也损失质量,请先在自己的任务上测试。
Mistral 推荐每个推理级别使用 temperature=1.0 和 top_p=0.95。
调用自托管模型
vLLM 和 SGLang 都暴露 OpenAI 兼容服务器:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
托管 API 上,把同一请求体发到 https://api.mistral.ai/v1/chat/completions,使用 "model": "mistral-large-4" 和 Bearer 密钥。vLLM 的 OpenAI 兼容服务器文档列出接受的字段。
让 Claude Code 用 Apifox CLI 测试两个端点
自托管模型会安静失败:缺少解析器标志会把推理泄漏到 content,或工具调用以纯文本返回。让编码 Agent 用 Apifox CLI 检查两条路径。
先配置:
npm install -g apifox-cli@latest
apifox login --with-token <YOUR_TOKEN>
npx -y skills add https://apifox.com   # 按提示选择 Claude Code
给 Claude Code 一段提示:
In Apifox project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
Agent 读取 schema、验证 payload 并运行:
apifox environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apifox environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apifox cli-schema get endpoint-create
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file case.json
apifox test-case create --project <id> --file case.json
apifox run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apifox run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
添加 --upload-report 可在 Apifox 应用查看,或把 apifox run ... -r junit 放进 CI,防止 vLLM 升级带坏工具调用。Claude Code 中的 Apifox CLI 指南有详细配置。
许可:能做什么,不能做什么
Mistral Ecosystem Open-Weight License 是 MIT 加一个条件。
可以: 运行、部署、微调和修改模型及衍生物,用于商业和非商业用途,只要在副本中保留版权和许可声明。
需要 Mistral 单独商业许可: 把它作为“Model as a Service”运行,即让第三方访问模型或衍生物进行推理或后训练。
不适用: 内部使用、模型位于特定功能或 harness 内的最终用户产品、仅把请求中继给他人托管的模型,以及通过 Mistral 自有产品使用。
内部编码助手或产品功能没问题;转售原始推理需要协议。这是摘要,不构成法律建议。
另一个开放权重模型的演练见 GLM-5.3 自托管指南。
自托管还是调用 API?
流量适中、想不调整服务器限制就获得 1M 上下文,或还没有 8 GPU 节点时,调用 API。按输入 $0.70、输出 $2.10 每百万 token 计算,每月 1 亿输入加 2,000 万输出为 $112,不含缓存折扣。
数据不能离开网络、想拥有微调模型(Hugging Face 展示在 8x B300 上用 TRL 做 LoRA),或稳定流量能让节点保持忙碌时,自托管。Mistral 的 Forge 服务是托管调优选项。
常见问题
开放权重可以免费下载吗? 可以。两个官方仓库都无需审批。运行才是成本:FP8 约 1,061 GB,服务示例用 8 块数据中心 GPU。
能在单 GPU 上运行吗? 没有官方方案。vLLM、SGLang 和 Transformers 示例都用 8 GPU 和张量并行。最小配置是 llama.cpp 加 381 GB Q2_K,运行在一台 512 GB 统一内存的 Apple Silicon Ultra 上。
是开源的吗? 是开放权重,不是 OSI 开源。修改版 MIT 允许商业使用,但向第三方提供推理或后训练服务需要单独商业许可。
开放权重和 API 模型一样吗? Mistral 称发布检查点在预览后又有三周强化学习,API 以 mistral-large-4 提供更新模型。推理模式改为 low、medium、high。
API 多少钱? 截至 2026 年 11 月 2 日,每百万输入 token $0.70、缓存输入 $0.07、输出 $2.10。