2026 年 10 月 6 日,GitHub 宣布堆叠式拉取请求(stacked pull requests,下称“栈”)正式 GA(Generally Available)。这个功能在 7 月 30 日进入 public preview,如今对所有 github.com 套餐开放,GitHub Enterprise Server 的纳入被安排在“即将到来的版本”里,但没有给出具体日期。
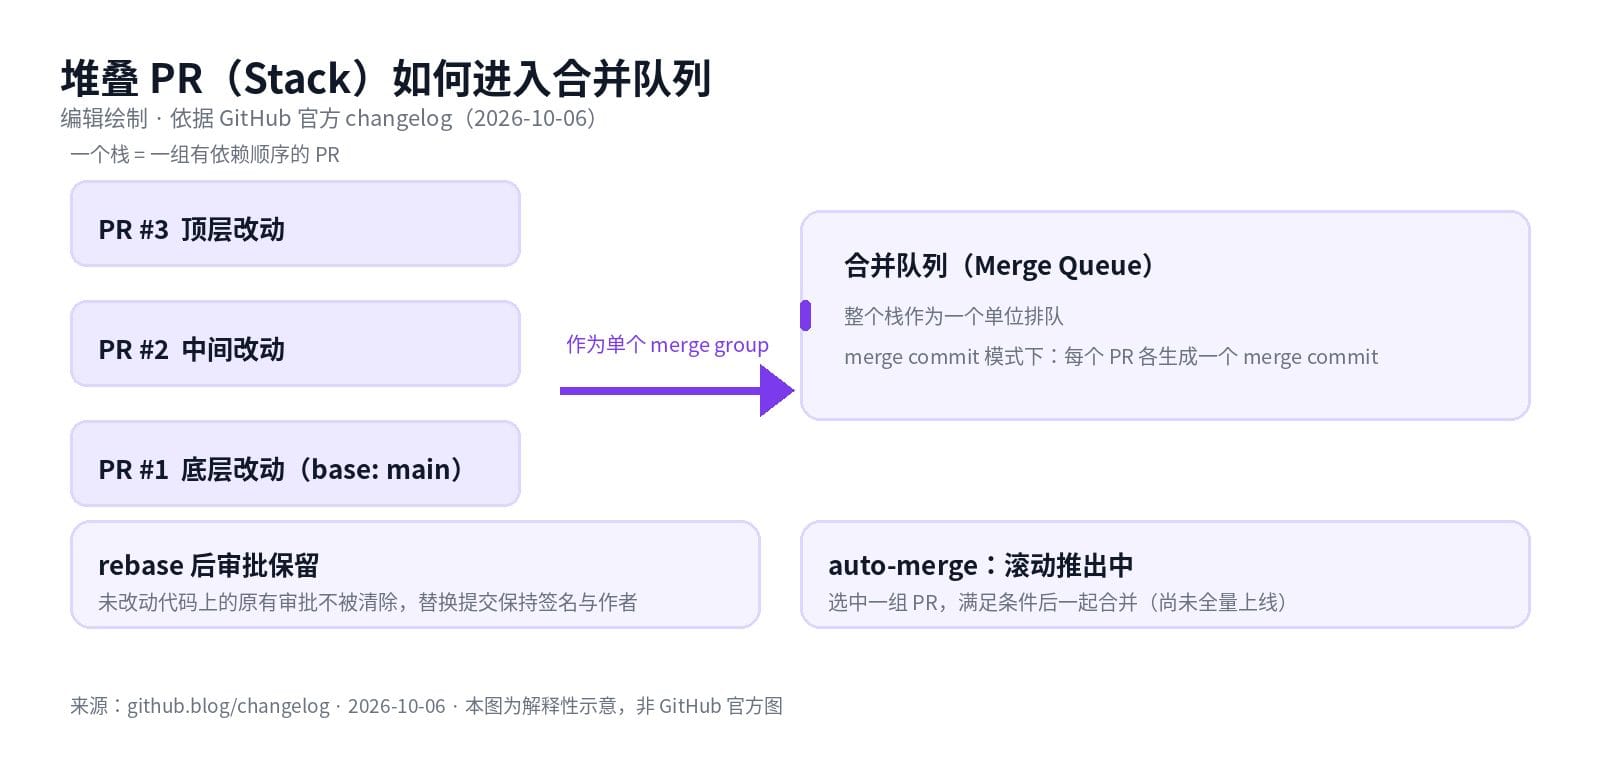
堆叠 PR 合并流程示意(编辑绘制,依据 GitHub 官方 changelog 描述)。
把一个大改动拆成几个不互相阻塞、又能一起落地的小 PR,一直是大型仓库的常规做法,但过去这套做法基本靠人和脚本自己维护:谁在谁上面、rebase 之后审批会不会被清掉、合并队列该怎么排、base 分支被删了怎么办。GitHub 这次做的,是把“栈”从一个团队约定,变成平台自己理解的一等对象。
发生了什么:栈开始被合并队列和权限系统“看见”
GA 版本里最实质的变化,集中在栈和 GitHub 既有机制的交界处,而不是一个新界面。
首先是合并队列。一个栈现在会作为单个 merge group 进入并退出合并队列。在 merge commit 方式下,GitHub 会为栈里的每个 PR 各生成一个 merge commit,而不是“每组一个”。过去如果你用合并队列,栈往往需要绕开它,或者在队列里被拆散,这一步被打通了。
其次是 rebase 与审批的关系。当 base 分支前进之后,重新 rebase 一个栈时,只要对应的代码没有变化,原有的审批会被保留,即便这个仓库配置了“分支更新后自动清除旧审批”(dismiss stale approvals)。这对栈是刚需:底层 PR 一有新提交,上层所有 PR 都会被迫更新,如果每次更新都清空审批,审阅者在栈上做的确认会被反复作废。
与之配套的是提交本身的可信度。rebase 过程中产生的替换提交保持签名并保留原作者;如果仓库规则要求签名,或者任一原始提交本身带签名,自动 rebase 生成的提交也会被签名。此外,在栈被部分合并后触发的自动 rebase,同样遵循这条规则。
权限侧新增了一条通路:拥有绕过仓库规则(bypass)权限的人,可以用这个权限去合并“栈里最底部尚未合并的那个 PR”。这在栈中间某层卡住时,给了管理员一个明确的操作入口,而不是被迫拆栈。
还有一些细节是在“栈被挪动”时兜底的。如果栈的 base 分支被删除,栈会自动重新指向(retarget),而不是把最底部的 PR 直接关掉。官方给出的场景是:一个栈建立在另一个栈之上时,这种情况会真实发生。
完整工作场景:一次迁移从拆分到落地
假设你要做一次数据库 schema 迁移,改动分三层:先加字段、再回填数据、最后切换读路径。按老办法,三件事要么塞进一个巨大的 PR,要么拆成三个 PR 然后靠人记住合并顺序。
按栈的做法:你依次建三个 PR,形成一条有明确依赖的链;审阅者可以只挑某一层单独看、单独批,不需要等整条链都完成。中间你把底层 PR 重推了一次,base 分支也前进了几个提交——因为栈内的 rebase 会保留未改动代码上的审批,审阅者此前的确认不会白做。三层都通过后,整条栈作为一个 merge group 进合并队列,按顺序落地。
导航上的成本也被压低了:栈信息常驻在 PR 页面的顶部栏,在 PR 列表里也能看到,栈内可以用 Shift+J / Shift+K 切换,时间线会记录某个 PR 何时加入或离开栈。pull_request webhook 新增了 stacked 动作,意味着 CI、看板、自动打标签这类自动化可以感知“这是一次栈事件”,而不是只能看到一堆互相孤立的 PR。命令行侧,gh stack 扩展开始支持 Git worktrees,init、checkout、导航都变快了。
为什么这会改变工作流
栈的痛点从来不是“能不能拆”,而是拆开之后谁来保证顺序。以前这件事由人、由 PR 描述里的一句“依赖 #1234”、由团队 wiki 里的规矩来保证;平台只看到一堆普通 PR。GA 之后,顺序、签名、审批、合并队列这几件事第一次由平台统一管起来。
对 Agent 参与开发的团队,这点尤其重要:当机器批量产出 PR 时,“这些 PR 是一组”这样的信息如果只存在于人的脑子里,自动化流水线就无从判断。webhook 里的 stacked 动作和栈内导航,让流水线第一次能拿到这个结构。具体落到 CI 上,你可以对“某个 PR 加入或离开了栈”这件事单独触发检查,而不是等到整组 PR 合并时才发现顺序错了。
另一个容易被忽略的变化是幂等性:过去为了维持栈的顺序,团队往往要自己写 rebase 脚本,而这些脚本在 base 分支变动、部分合并、base 分支被删这类情况下很容易出错。GA 版本把这些边界收进了平台,等于把一条原本需要长期维护的自制流水线,换成了产品行为。
GitHub 同时给出了一组自述数据(产品方统计,非第三方核验):从 preview 开始,使用栈的仓库合并的代码量比同类仓库多 9%,排名前 1% 的仓库里有超过三分之二在使用栈,time-to-merge 有 5% 的改善。这类数字应当按厂商口径理解,但方向是清楚的。
限制与需要人来接管的环节
第一,栈的自动合并(auto-merge)还没完全上线,官方说法是“未来几周滚动推出”:选中一组 PR,满足条件后一起合并。在此之前,合并顺序仍要有人盯。
第二,栈是“可理解”而不是“自动正确”。平台知道哪一层依赖哪一层,但不替你判断拆分是否合理。把一次重构拆成七个互相藕断丝连的 PR,仍然会让审阅者痛苦。
第三,可用范围有边界:github.com 全套餐可用,GitHub Enterprise Server 要等后续版本,自建实例的团队现在还用不上。
第四,栈不能替代评审。合并队列把一组 PR 当作一个单位,不等于这组 PR 可以被跳过审查;bypass 合并最底层 PR 的能力,属于管理员权限,应当在分支保护与审计里被明确约束。
如何试用
github.com 上的仓库已经可以直接使用,不需要额外开关。入口在 PR 页面:创建 PR 时可以把它指定为某个栈的一部分,栈信息会显示在页面顶部栏。命令行用户升级 gh stack 扩展即可获得 worktree 支持。GitHub 指向了堆叠 PR 的官方文档作为上手起点。
信息来源
- GitHub Changelog:Stacked pull requests generally available(2026-10-06)— https://github.blog/changelog/2026-10-06-stacked-pull-requests-generally-available/
- GitHub Docs:关于堆叠式拉取请求(About stacked pull requests)
- GitHub Changelog:Stacked pull requests 进入 public preview(2026-07-30)
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
