2026 年 10 月 6 日,GitHub 工程博客发布了一篇题为 “Building Git infrastructure for agent-scale development” 的文章,作者 Brian Celenza,归类在 Architecture & optimization。它讲的不是新功能,而是 GitHub 正在重建自己的 Git 基础设施,理由写得很直接:要给 agent 规模的软件开发打地基。
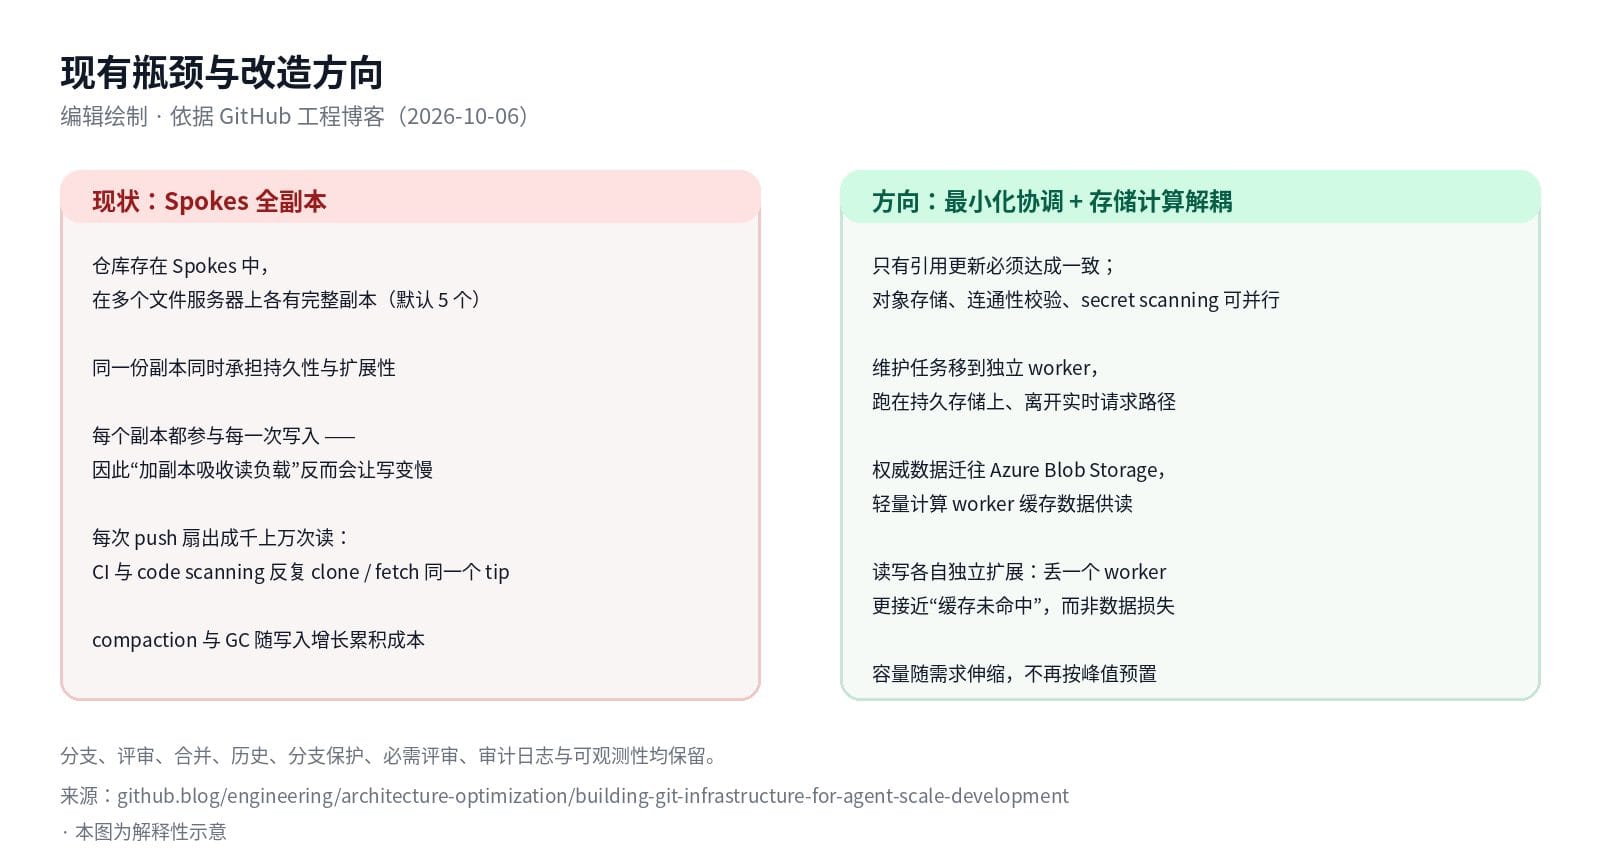
现有瓶颈与改造方向(编辑绘制,依据 GitHub 工程博客描述)。
这篇文章值得开发者读,是因为它把一个问题摆到了台面上:当写代码的主体从人变成 agent,最先撑不住的可能不是模型,而是版本控制系统的写入路径。
发生了什么:agent 的提交节奏改变了流量的形状
GitHub 给出的机制解释是具体的:agent 在紧密的循环里工作,几乎每做完一个动作就提交或打一次检查点。人类开发者不会感知到的 push 延迟,在这个节奏下直接变成瓶颈。
由此带来四个同时发生的压力。第一,写吞吐需要提升数个数量级,因为同一个仓库里可能有数千个 agent 在推分支。第二,合并开始争用同一个 ref:trunk-based 开发、release train、merge queue 最终都汇聚到同一个引用上。第三,每次 push 会扇出成千上万次读,CI 与 code scanning 会反复 clone 或 fetch 同一个分支 tip。第四,仓库维护成本随写入一起增长,compaction 和垃圾回收开始形成复利式的开销。
更关键的是现有架构为什么吃不下这个形状。仓库保存在 GitHub 称为 Spokes 的系统中,在多个文件服务器上各有一份完整副本(默认 5 个),这些副本同时承担持久性和扩展性两个职责。由于每个副本都参与每一次写入,官方给出一句很干脆的结论:“增加副本以吸收读负载,反而会让写入变慢。”读写被绑在了同一条路径上。
改造方向:把协调压到最小,把存储和计算拆开
文章的应对思路是两条。
第一条是最小化协调。在新设计里,只有引用更新这一件事必须达成一致;对象存储、连通性校验、secret scanning 这些工作可以并行推进,从而缩短 push 的关键路径。仓库维护则被移出实时请求路径,交给独立 worker 跑在持久存储上。
第二条是把存储与计算解耦。权威数据迁移到 Azure Blob Storage,而轻量的计算 worker 负责缓存数据以服务读取。这个拆分的直接效果是读写可以各自独立扩展;同时它改变了故障的含义——丢掉一个 worker 更接近一次缓存未命中,而不是数据丢失。容量也可以跟着需求伸缩,而不是按峰值预置。
官方同时明确,既有工作流不受影响:分支、评审、合并、历史,以及分支保护、必需评审、审计日志与可观测性都保留下来。措辞上强调可靠性优先、人仍然掌握控制权。
完整工作场景:一个 agent 密集仓库的一天
设想一个由 agent 批量产出 PR 的仓库:每个 agent 完成一步就提交一次检查点,一天里同一个仓库推上来的分支数以千计。每一次 push 都会触发 CI 与 code scanning 去反复 clone 或 fetch 同一个分支 tip,读请求因此被放大成千上万倍;与此同时,merge queue 上的所有改动都争用同一个引用。
这个场景里值得注意的地方是:人类开发者的数量没有变,评审和合并的习惯也没有变,真正变化的是写入的发生频率和读的扇出倍数。基础设施的每一项改造——缩短 push 的关键路径、把仓库维护挪出请求路径、让读写各自独立扩展——都对应着这条链上的一个具体环节,而不是笼统的“性能优化”。
为什么这会改变工作流
对每天写代码的人来说,这篇文章的价值不在“GitHub 换了存储”,而在于它确认了一件事:agent 的接入方式正在反过来要求基础设施改变形态。
过去十年,版本控制系统的优化方向主要是“让人更快地评审和合并”,写入量在这个假设下是次要变量。当提交的产生者变成一批不会疲倦的进程,写入就从次要变量变成了主要瓶颈。这个视角转换会一层层传导下来:如果 push 更快,agent 的循环可以更短;如果 CI 的重复拉取成本被摊薄,monorepo 与大规模并行 CI 的边界会往外挪;如果仓库维护不再是请求路径上的成本,长期运行的大型仓库会更从容。
反过来说,这也解释了为什么近期“栈”“合并队列”“Agent 批量产出 PR”这些话题会同时出现在产品侧——它们不是营销巧合,而是同一股压力的不同出口。
限制与需要人接管的环节
第一,这是一篇工程文章,不是产品发布。没有可以打开的开关,也没有面向用户的改动清单;对使用者来说,它解释的是“为什么你没有看到某个功能,但基础设施在动”。
第二,没有时间表。文章描述的是设计与方向,改造是在“GitHub 持续运行”的前提下逐步推进的,官方没有给出完成节点。
第三,全部数据都是产品方自述口径。包括 2026 年 8 月最繁忙仓库约 10 亿次请求、9 月 73.8 亿次提交、Actions 运行 32.6 亿次(同比超过 4 倍),以及“内部基准显示写吞吐最高提升 35 倍”这一条——注意它的限定词是内部基准,不是线上实测,两者不应混为一谈。
第四,迁移本身就是这段工程最难的部分。把权威数据从现有副本体系搬到对象存储,同时保证分支保护、审计日志、可观测性这些承诺不降级,属于典型的“边换引擎边开车”。这也是为什么文章把可靠性放在容量和速度之前。
第五,自建 Git 服务的团队不应照搬。Spokes 的副本模型与这里的解耦方案,回答的是超大规模多租户场景的问题;中小规模自建实例照搬会引入远超收益的复杂度。
如何了解进展
文章本身可以在 GitHub Blog 的 Architecture & optimization 分类下读到,作者 Brian Celenza,2026 年 10 月 6 日发布,阅读时长标注约 9 分钟。关注后续进展,跟踪该分类下的更新比跟踪 changelog 更合适——这类底层改造通常不会以 changelog 条目的形式出现。
信息来源
- GitHub Blog:Building Git infrastructure for agent-scale development(2026-10-06,作者 Brian Celenza)— https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
- GitHub Changelog:Stacked pull requests generally available(2026-10-06,同期合并队列相关工作)
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
