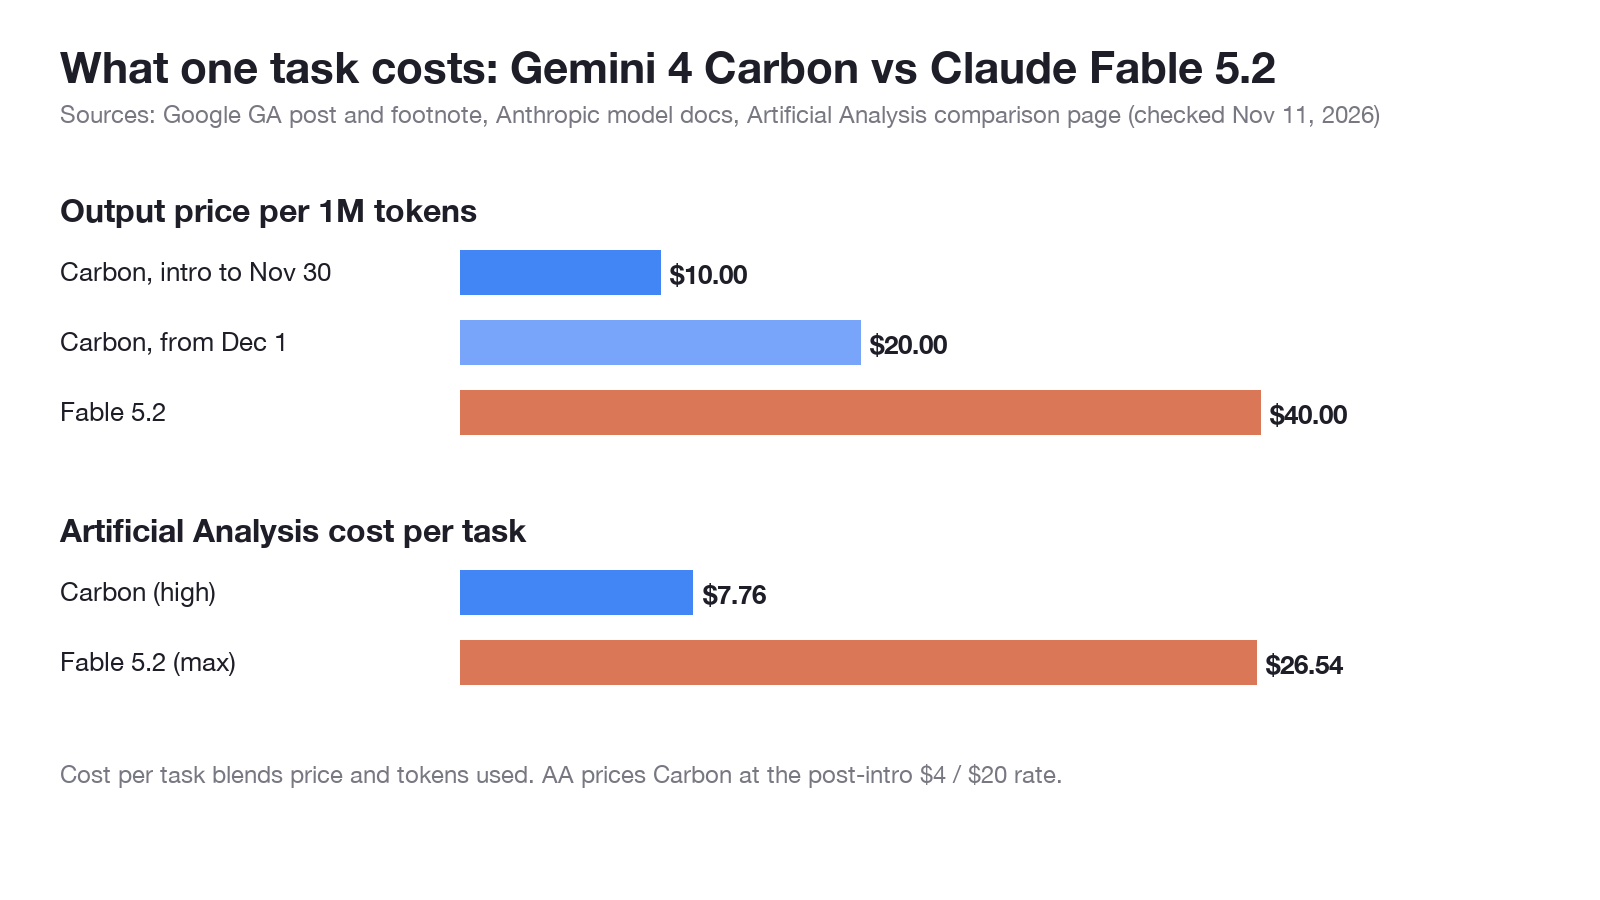
截至 2026 年 11 月 11 日,Google 的 Gemini 4 Carbon 价格更低,而 Claude Fable 5.2 在大多数已公开的编码与 Agent 基准测试中表现更强。Carbon 在 11 月 30 日前的挂牌价为每百万输入/输出 token $2 / $10(之后恢复为 $4 / $20),Fable 5.2 为 $8 / $40,而 Artificial Analysis 测得的单任务成本分别为 $7.76 与 $26.54。
这两款模型前后相隔一天发布(Fable 5.2 于 11 月 9 日发布,Carbon 于 11 月 10 日正式上线 GA),各家厂商给出的对比表格都偏向自家模型。本文将所有数据按测试来源拆开对比,并展示如何在你自己的请求上对两者进行 A/B 测试。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Gemini 4 Carbon 对比 Claude Fable 5.2:快速结论
如果你最看重单任务成本,或者用于业务自动化流程与安全分析工作,选择 Gemini 4 Carbon。如果你需要在高难度编码、终端操作与计算机使用(computer-use)任务上拿到最高分,并且能够接受单任务约 3.4 倍的成本,选择 Claude Fable 5.2。至于日常工程任务,两家厂商都建议优先使用更便宜的默认模型。
Google 在 GA 发布公告中表示,“Argon 依然是绝大多数软件工程与知识工作的理想选择”,并将 Carbon 定位于需要花费更多 token 去探索和验证的高难度任务。Anthropic 的模型文档也表达了同样的意思:大多数工作负载先从 Claude Opus 5.5 起步,面对高要求的推理与长周期 Agent 任务时再切换到 Fable 5.2。
因此,只有当默认模型不够用时,才需要调用这两款模型。还没选好默认模型?可以先阅读 Gemini 4 Carbon 与 Argon 的对比。
Gemini 4 Carbon 与 Claude Fable 5.2 的价格和规格对比
以下是两家厂商公布的核心规格,每行均注明了来源。
| 规格 | Gemini 4 Carbon | Claude Fable 5.2 | 来源 |
|---|---|---|---|
| 模型 ID | gemini-4-carbon |
claude-fable-5-2 |
Google、Anthropic |
| 发布时间 | 2026 年 11 月 10 日 GA | 2026 年 11 月 9 日 | Google、Anthropic |
| 每百万输入 token 价格 | 11 月 30 日前 $2,之后 $4 | $8(fast 模式下为 $16) | Google 脚注、Anthropic |
| 每百万输出 token 价格 | 11 月 30 日前 $10,之后 $20 | $40(fast 模式下为 $80) | Google 脚注、Anthropic |
| 上下文窗口 | 1M tokens | 1M tokens | AI Studio 模型卡、Anthropic 文档 |
| 最大输出长度 | 标注为 65K / 1M [待核实] | 128K tokens | AI Studio 模型卡、Anthropic 文档 |
| 思考机制(Thinking) | 可配置思考等级 | 自适应、始终开启,默认 effort 为 high |
Google 快速入门、Anthropic 文档 |
| 获取渠道 | Gemini API 付费层级、AI Studio、Android Studio、Gemini 企业版、Antigravity、CodeMender、Google AI Ultra | Claude Platform、Amazon Web Services、Google Cloud、Microsoft Azure | Google、Anthropic |
| 免费 API 层级 | 未说明 | 未说明 | Google、Anthropic |
Google 的 GA 公告没有提及 Vertex AI、Gemini CLI 或 GitHub Copilot,因此暂时不要围绕这些渠道做接入规划。Carbon 的首发价格与 Argon 一致,这让 11 月成为运行评估测试成本最低的月份。
完整费率可参考 Claude Fable 5.2 定价说明,以及 Google 的 Gemini 4 Carbon 发布公告。
哪个模型在基准测试中胜出?
这取决于你看哪一方的表格,因此下面将三份表格分开列出。
Anthropic 公布的表格(随 Fable 5.2 发布)
Anthropic 的 Fable 5.2 发布公告 包含了一列 Gemini 4 Carbon 的对比数据。页面并未说明 Carbon 的分数由谁跑出,因此请将其视为厂商报告数据。
| 基准测试(Anthropic 表格) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69.9% | 61.2% |
| FrontierCode 2.0 | 49.1%(xhigh effort) | 41.1%(medium effort) |
| Terminal-Bench-Science 0.1 | 74.6% | 64.8% |
| OSWorld 2.1(离线集,部分) | 89.3% | 81.5% |
| AA-Briefcase v1.1(评分量表) | 66.1% | 61.8% |
| Chartography(无工具) | 73.4% | 72.5% |
| AutomationBench | 51.4% | 53.9% |
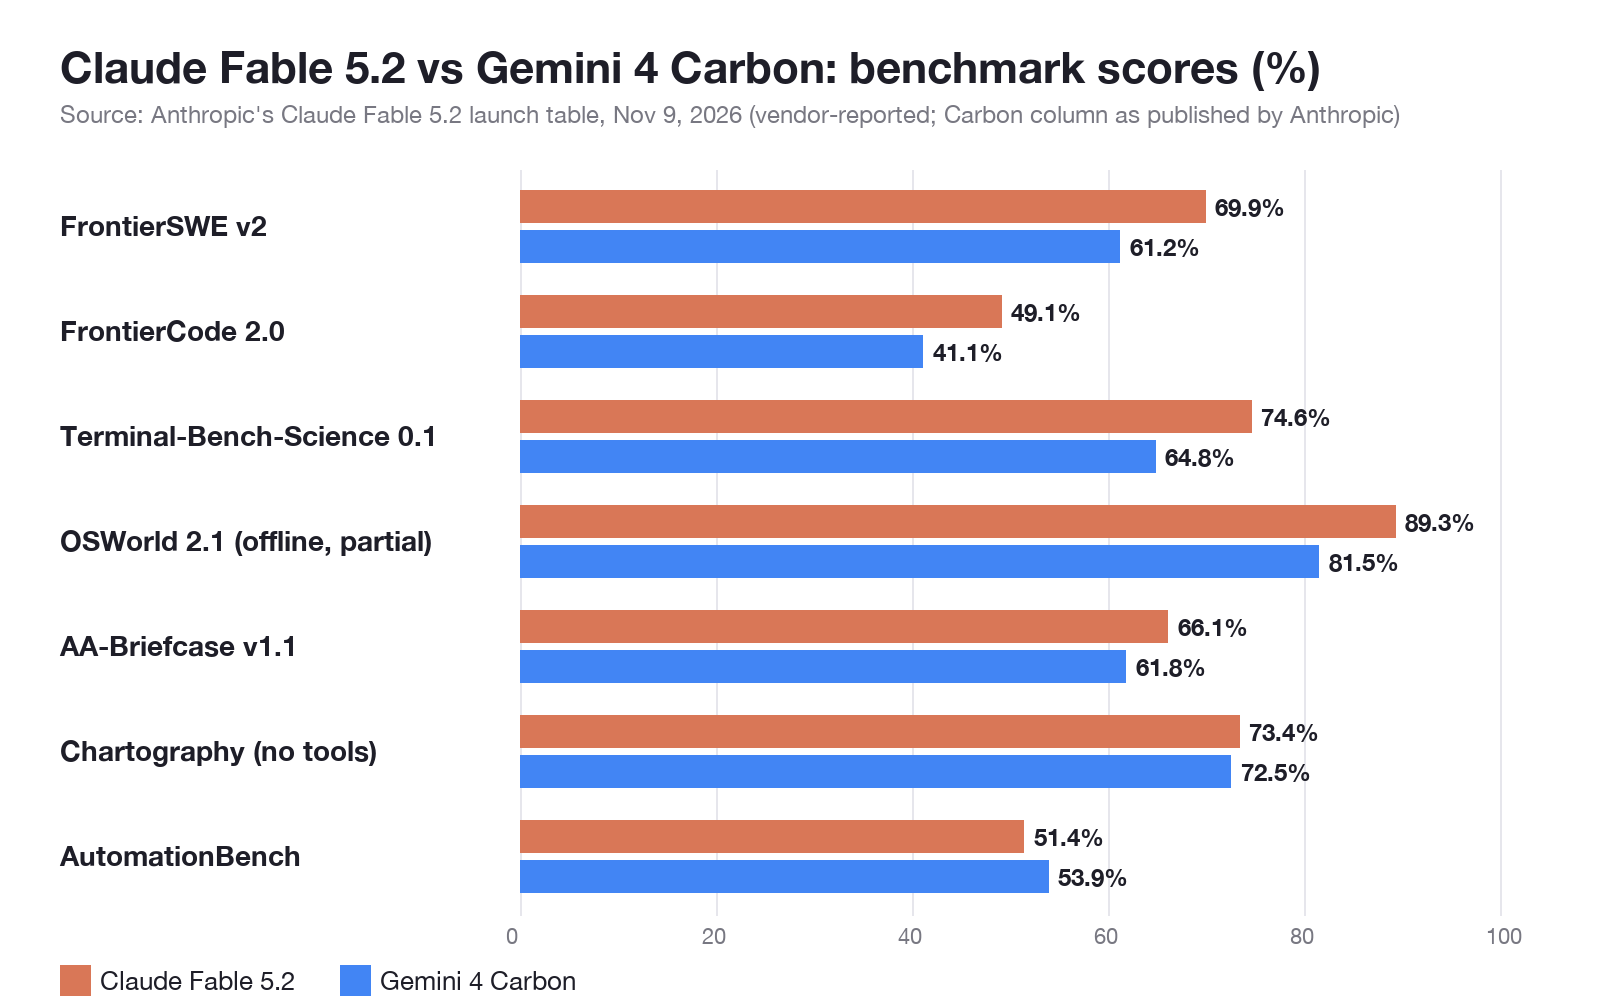
留意 FrontierCode 这一行:Fable 运行在 xhigh effort 下,而 Carbon 运行在 medium effort 下。配置档位上的差距与分数本身的差距同样重要。
Google 公布的表格(随 Carbon GA 发布)
Google 没有公布与 Fable 5.2 的直接头对头对比,而是引用了合作伙伴排行榜:Carbon 在 CursorBench 4.0、Perplexity 的 WANDR 和 Zapier 的 AutomationBench 上排名第一,且“单任务成本比排名第二的外部模型低 2 倍以上”。在 Multimodal Knowledge Agent 基准测试中,它排名第二,平均单任务成本比第一名低 6 倍以上。Google 在这些表述中没有点名竞争对手的具体模型。
Artificial Analysis(独立评测)
Artificial Analysis 对比页面 使用同一套 Intelligence Index v5.0.1 测试了这两款模型:
| 指标(Artificial Analysis) | Fable 5.2(max) | Gemini 4 Carbon(high) |
|---|---|---|
| Intelligence Index(智能指数) | 65 | 60 |
| 单任务成本 | $26.54 | $7.76 |
| 运行完整指数的成本 | $22,191 | $8,240 |
| 输出速度 | 103 tokens/s | 82 tokens/s |
Fable 5.2(max)目前在该指数上排名第一。Carbon 低了 5 分,但单任务成本只有前者的约 29%。Artificial Analysis 按 Carbon 11 月之后的恢复价 $4 / $20 计算,因此这里的成本数据已经反映了 12 月的价格水平。
Claude Fable 5.2 强在哪里?
根据 Anthropic 公布的数据,Fable 5.2 在最高难度的编码与计算机使用任务上胜出:
- 仓库级编码:在 FrontierSWE v2 上为 69.9% 对比 61.2%。
- 终端与科研工作:在 Terminal-Bench-Science 0.1 上为 74.6% 对比 64.8%。
- 计算机使用:在 OSWorld 2.1 上为 89.3% 对比 81.5%。
- 独立指数:在不由任何一方厂商主导的 Artificial Analysis 上为 65 对比 60。
- 最大输出长度:文档明确支持单次请求最高 128K 输出。
如果一次任务失败会耽误工程师一下午的时间,FrontierSWE 上高出的 8 个百分点往往比省下的 token 账单更有价值。接入方式可参考 Claude Fable 5.2 API 指南。
Gemini 4 Carbon 强在哪里?
Carbon 在单任务成本以及 Google 重点打造的场景中胜出:
- 单任务成本:在 Artificial Analysis 上为 $7.76 对比 $26.54,便宜约 3.4 倍。
- 业务自动化:即使在 Anthropic 自己的表格里,Carbon 在 AutomationBench 上也以 53.9% 对比 51.4% 领先。
- 安全能力:据 Google 介绍,它在 SEC-bench Pro、ExploitGym 和 CWE-bench v1 上领先,并通过 Fairwind 计划向防守方提供受控访问的专用网络安全版 Carbon 模型。
- 11 月促销价:11 月 30 日前为 $2 / $10,输入和输出单价都只有 Fable 的四分之一。
- Agent 团队协作:Google Antigravity 中的
/swarm预览功能可以将一条提示词转化为协同工作的团队,由 Carbon 负责规划与审查,同时让轻量模型并行执行。
刚接触这款模型?可以先了解 Gemini 4 Carbon 是什么。
单次任务实际要花多少钱?
挂牌价只代表费率,不等于最终账单。一次任务的实际成本等于单价乘以模型决定消耗的 token 数量,而 Google 表示 Carbon 会花费更多 token 用于探索和验证。
假设一次请求包含 50,000 输入 token 和 10,000 输出 token:
- Carbon(首发优惠价):(0.05 x $2) + (0.01 x $10) = $0.20
- Carbon(12 月 1 日起):(0.05 x $4) + (0.01 x $20) = $0.40
- Fable 5.2:(0.05 x $8) + (0.01 x $40) = $0.80
上述计算假设两款模型都只输出 10,000 token。但实际情况往往不同。如果 Carbon 在推理过程中生成了 30,000 token,而 Fable 只生成了 10,000 token,那么 Carbon 在 12 月的成本就会涨到 $0.80,价格优势随之抹平。不过,Artificial Analysis 在整套评测集上测量了真实消耗后,依然发现 Carbon 的单任务成本便宜约 3.4 倍——在你用自己的任务实测之前,这是最有参考价值的信号。
如何在你自己的请求上对 Gemini 4 Carbon 和 Claude Fable 5.2 做 A/B 测试?
公开基准测试跑的是别人的任务。最公平的测试方式是把同一条提示词同时发给两个 API,并排记录 token 消耗和响应延迟。
两个接口都是标准 HTTP 调用。以下是根据 Google Interactions API 快速入门构建的 Carbon 请求示例,模型名称保存在变量中:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 则通过 Anthropic 的 Messages API 调用,模型设为 claude-fable-5-2。
让编码 Agent 用 Apifox CLI 运行 A/B 测试
手动成对发送请求很快就会变得繁琐。你可以让 Claude Code、Codex 或 Cursor 驱动 Apifox CLI 来执行对比。先安装 CLI 并完成登录与分类查询:
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_APIFOX_TOKEN>
apifox test-case category --project <PROJECT_ID>
然后给你的 Agent 一条提示词:
In Apifox project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
Agent 会先检查 schema、写入用例并运行。以下命令参数来自 Apifox CLI 2.2.12:
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file carbon-case.json
apifox test-case create --project <PROJECT_ID> --file carbon-case.json
apifox test-case create --project <PROJECT_ID> --file fable-case.json
apifox test-case run <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apifox test-case run <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 会将每个用例重复运行 5 次,避免单次偶发的慢响应影响结论。加上 --upload-report 还可以在 Apifox 客户端中查看运行报告。这是一个工作流模板,我们尚未在本机针对 Carbon 实际运行。
常见问题
Gemini 4 Carbon 比 Claude Fable 5.2 更好吗?
并非全面占优。Fable 5.2 在 Anthropic 的大多数基准测试以及 Artificial Analysis 指数(65 对比 60)上得分更高;而 Carbon 在单任务成本($7.76 对比 $26.54)和 AutomationBench 上表现更好。
Gemini 4 Carbon 比 Claude Fable 5.2 便宜多少?
按挂牌单价计算,2026 年 11 月 30 日前 Carbon 便宜 4 倍(每百万 token $2 / $10 对比 $8 / $40),12 月 1 日起便宜 2 倍($4 / $20)。按 Artificial Analysis 实测的单任务成本计算,Carbon 大约便宜 3.4 倍。
两款模型都有 1M token 的上下文窗口吗?
是的。Google 的 AI Studio 模型卡为 Carbon 标注了 1M token,Anthropic 文档也为 Fable 5.2 标注了 1M token。Fable 的最大输出长度为 128K token;Carbon 的确切输出上限请以 Google 开发者指南为准。
Gemini 4 Carbon 或 Claude Fable 5.2 在 API 上有免费层级吗?
两家厂商均未说明提供免费 API 层级。Carbon 位于 Gemini API 付费层级和 Google AI Ultra 应用中;Fable 5.2 则按 token 计费。
我应该把默认模型切换成其中之一吗?
通常不需要。Google 表示 Argon 仍是大多数软件工程和知识工作的合适选择,Anthropic 也建议大多数工作负载使用 Opus 5.5。建议只把默认模型处理失败的任务路由给 Carbon 或 Fable,然后在你自己的请求上对比结果。