Google 在 2026 年 9 月 15 日发布了两款新的 speech-to-speech 模型,Hacker News 帖子一天内就冲到 337 分。对一次语音 API 发布来说,这个反应已经很大,而且讨论的重点并不是演示视频。开发者反复在问同一件事:用它来做产品要花多少钱,以及到底该怎么连上它?
这篇就是那份指南。gemini-3.8-live 和 gemini-3.8-live-extended-thinking 正在 Gemini API 和 Google AI Studio 上线,Gemini Enterprise 与 Search Live 目前还是 private preview。两款模型在付费档之上都提供免费的 input / output token,并且同时按 token 和按分钟计价。对 live audio 模型来说,这已经足够反常,所以值得把 WebSocket session 本身走一遍,而不只是看定价页。我们此前在 GPT-Live vs Gemini Live 里对比过消费级语音助手;本文走的是其中一侧背后的开发者接入路径。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
9 月 15 日实际发布了什么
Google 的公告覆盖两款模型。gemini-3.8-live 是标准的 speech-to-speech 模型。gemini-3.8-live-extended-thinking 则在模型说话时叠加一层推理,下文会展开。两款都支持 97 种语言,并能在对话中途自动切换,也就是调用方可以一句英语开头、一句西班牙语收尾,而不需要手动设语言 flag。
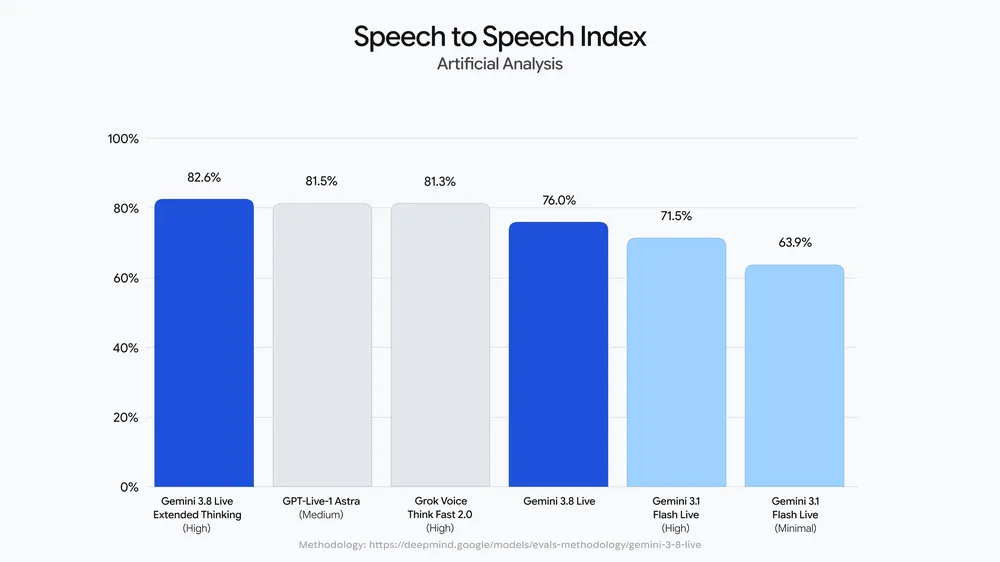
上线时的可用性:Gemini API 和 Google AI Studio(公开访问),以及 Gemini Enterprise 与 Search Live(private preview,所以大多数读到这里的开发者会从 API 或 AI Studio 起步)。两款模型的 input 和 output 都提供免费 token,这意味着在动信用卡之前,就能先做出一个像样的原型。
Google 还没公布的细节是:这两款 Live 模型的免费档 rate limit。rate limits 页面一旦列出具体数字,才是唯一可信来源;在那之前,别处看到的任何数字都先当未确认,自己去那一页核一遍。
Search Live 和 Gemini Enterprise 仍是 private preview,而不像 API 那样开放,这个信号值得读:Google 愿意让开发者先按接近生产的方式对接,再决定把同一模型放到消费级搜索或付费企业席位里。语音模型发布常见这种节奏,也意味着现在稳定的起点是 API 表面,而不是“稍后会有更好消费体验”的缩水预览。
拿免费 API key,打开一次 session
Gemini API key 从 Google AI Studio 申请,绑定 Google 账号。免费档没有单独审批,key 在模型上线当天就能打 Live 模型。有了 key 之后,接入点是 WebSocket,而不是 REST 接口。如果你习惯的是 generateContent 调用,这是第一个要改的地方:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent
这个 URL 来自 Simon Willison 上线当天的 hands-on writeup,和他一贯对新 API 的细读放在一起。他还标出一件在做 UI 之前就该知道的事:你可以像打断真人说话一样,在模型回复到一半时打断它;回来的 transcript 里可能包含模型已经开始生成、但因为被打断而从未完整播放的语音。客户端要把这当成独立状态处理,而不是假设每一行 transcript 都被完整听到。
这条 socket 上的双向 session,形状和所有基于 WebSocket 的流式 API 一样:先发一条 setup message,声明模型和 generation config;随后是双向的 content message 流,携带 audio chunk 或文本;服务端再按就绪节奏推回部分和最终 response 片段。精确的 message schema 以 Google 文档为准,preview 到 GA 之间字段名也可能变,所以在把生产客户端定下来之前,请对照当时的 Gemini API docs 和你所用 SDK 的 reference 核对字段名。稳定下来的是模式本身:连接、发 setup、流式发 content、读流式 response,并把打断当成正常事件,而不是错误。
落到实践上,第一次能跑通的 session 应该追求最小闭环:打开 socket,发一条 setup message 写明你要的模型(gemini-3.8-live 或 gemini-3.8-live-extended-thinking),再发一轮很短的 audio 或 text turn,确认能收到流式 response,然后再加 retry、重连或 UI。打断路径放第二步,等 happy path 通了再做。要测得好,就得故意在模型说到一半时插话,并检查客户端是否把被截断的 transcript 标出来,而不是当成一轮完整回复。
Extended thinking:推理发生在说话的同时
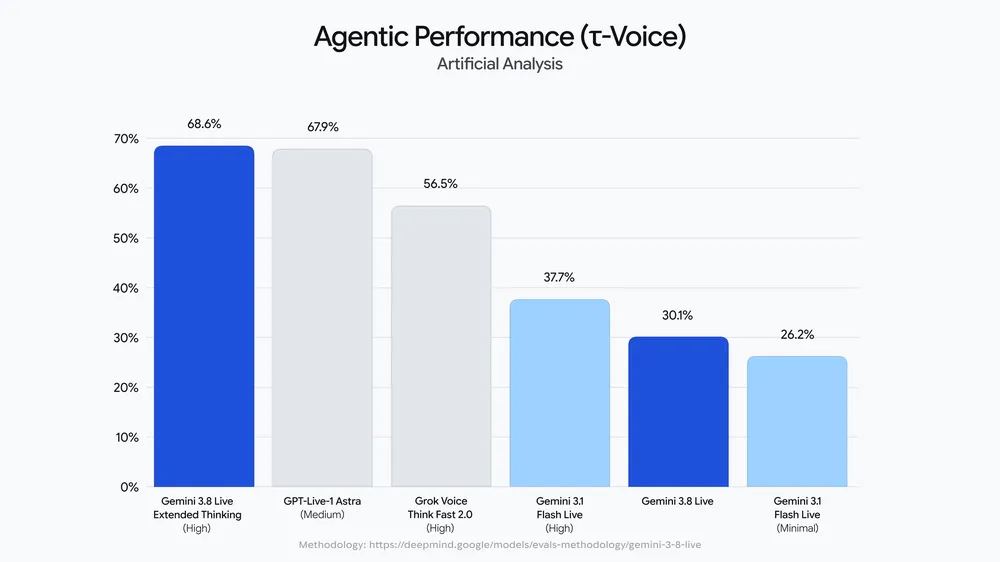
普通的 gemini-3.8-live 会直接作答。gemini-3.8-live-extended-thinking 则不同:Google 说它 “reasons and speaks simultaneously”,用口头提示填满推理时间,例如 “Let me check that”,而不是在模型工作时留下死寂,从而保持它所谓的 “uninterrupted conversational flow”。
这对一类应用特别重要:会在对话中途调用工具或打外部 API 的语音 Agent。extended-thinking 模型会 “executes tools and API calls in the background while continuing the conversation”,而且两款模型都支持 function calling。想象一个订票 Agent 需要查日历 API 的空位:模型不用为了两秒查询而突然静音,它可以先口头确认请求,同时在后台把调用做完,对话继续往前走。
session 里有 tool call、多步查找,或推理很重、沉默空隙会显得对话断掉时,选 extended thinking。更短、更在意低延迟、不需要这层推理开销的交换,选普通模型。两边按 token 计价相同,所以这是行为选择,不是预算选择。如果你的 Agent 主要靠 function calling,我们写过 Gemini 3.8 Flash 的 function calling 指南,覆盖当前 Gemini 3.8 系列的请求形态;但上线前仍要对照 Live API 文档确认 Live 专用的 function-calling payload,文本 API 和语音 API 并不保证共用同一套 schema。
成本怎么算
两款 Live 模型的 standard 定价相同:
| 类型 | 费率 |
|---|---|
| Text input | $0.75 per 1M tokens |
| Audio input | $3.00 per 1M tokens,或 $0.005 per minute |
| Image/video input | $1.00 per 1M tokens,或 $0.002 per minute |
| Text output | $4.50 per 1M tokens |
| Audio output | $12.00 per 1M tokens,或 $0.018 per minute |
Thinking token 按 output 计费,和其他 Gemini 3.x 模型一样,所以 extended thinking 的后台推理会出现在 output 这一行,而不是单独收费。
测算例子:一次 10 分钟语音通话,全程 audio in / audio out,走付费 standard 档。Audio input:10 minutes × $0.005 = $0.05。Audio output:10 minutes × $0.018 = $0.18。合计:$0.23 覆盖完整 10 分钟来回,尚未叠加上面的 text 或 tool-call token。原型阶段把同一通电话放在免费档跑,token 成本是 0,前提是 Google 最终公布的该档 rate limit 还没把你挡住。
同一张定价页上的 gemini-3.1-flash-live-preview 与两款新 Live 模型费率相同。如果你已经在旧模型上接了 Live,值得核一眼:定价本身不是推迟迁移的理由。
开发者目前怎么说
Hacker News 上的 讨论 并不一边倒。反复出现的抱怨是:付费的 Google Workspace 和 Google AI Plus 订阅者,作为付费用户,目前还没有消费级的新 Live 体验,而 API 和 AI Studio 已经开放。帖子里还有人描述过一种 agentic loop:模型会编造原任务里没有的额外需求。如果你要把 Live 接到自主 Agent 而不是人在环内的语音助手,这一点值得单独测。越接近自主闭环而不是受监督助手,就越该加一条显式检查:把模型声称自己需要的东西,拿去对照你给出的任务定义,而不是当面相信模型陈述的需求。这两点都先当作单帖的 day-one 信号,而不是已核实缺陷;在自己的用例上复测之前,不要据此推广。
先看原始协议,再写客户端代码
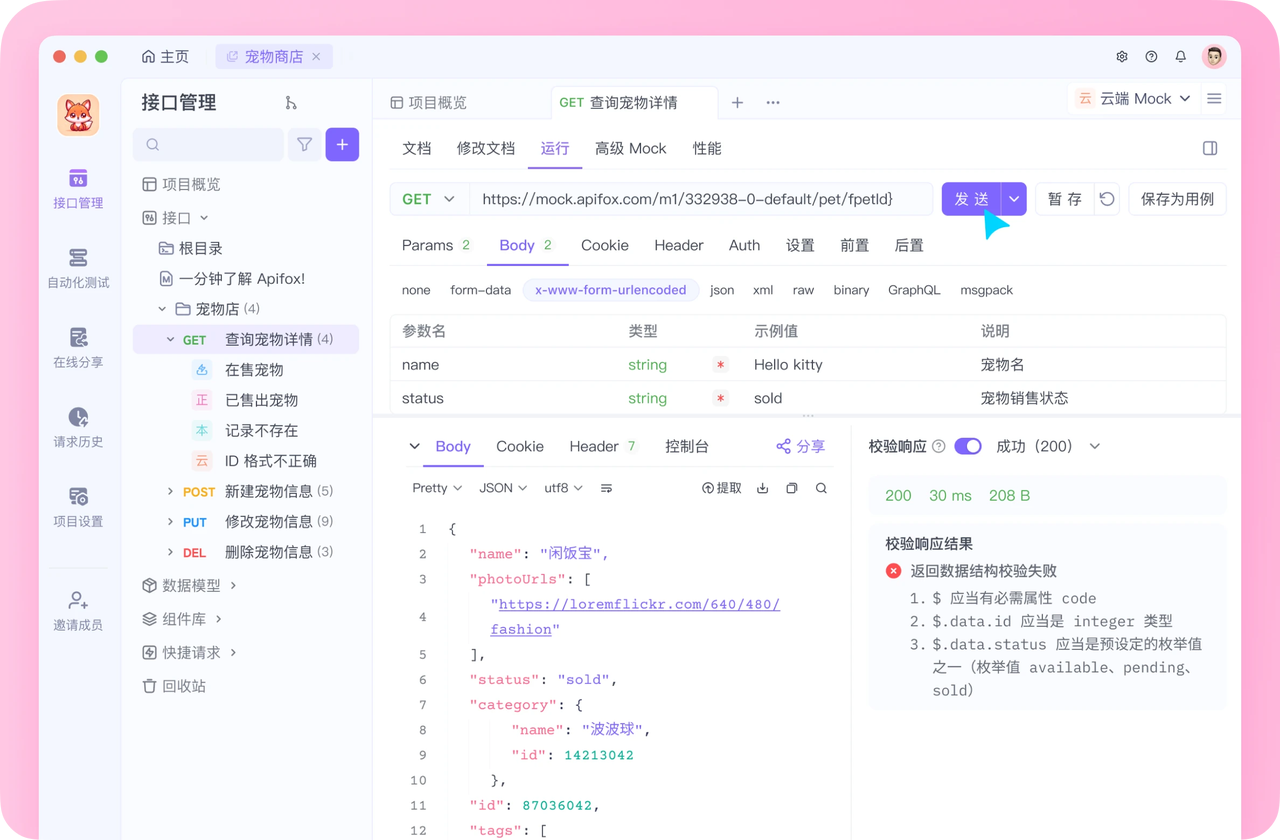
在绑定某个 client library 之前,最好先看见线上实际走过的帧。Apifox 可以对 BidiGenerateContent 接口打开 WebSocket 连接,手工发送 JSON setup message 和后续 content message,并实时展示流回来的帧。这是在写任何一行 SDK 代码之前,理解 setup-then-stream 模式最快的办法。Apifox 不会替你采集麦克风音频;audio 或 text payload 需要你自己提供,连接的用途是检查服务端回了什么、确认 setup message 被接受,以及观察打断时的行为,再把这些写进生产错误处理。用这种方式构建和测试 WebSocket API 的完整协议参考在 docs.apifox.com。在第一次写客户端之前,可以先用 Apifox 自己试一次连接。
作为对照,我们的 WebSocket vs WebRTC 拆解解释了 Google 为什么给这条双向流选 WebSocket,而不是部分竞品语音 API 用的 WebRTC 路径,以及这对浏览器客户端意味着什么。
FAQ
Gemini 3.8 Live API 免费吗? 是的,两款模型在免费档的 input 和 output token 都免费。越过 Google 设定的 rate limit 之后走付费 standard 费率;免费档限额目前尚未公布,请直接看 rate limits 页面。
两款新模型有什么区别? gemini-3.8-live 直接作答。gemini-3.8-live-extended-thinking 边说边推理,用口头填充盖住后台 tool call 和多步查找,token 价格相同。
必须用 WebRTC 吗? 不需要。这是基于 WebSocket 的 API,连的是 BidiGenerateContent 接口,而不是 WebRTC peer connection。
不写客户端能先测吗? 可以。在 Apifox 里打开 WebSocket,手工发送 setup 和 content message,读流式 response,再围绕它写真正的客户端。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会