ERNIE 5.5 Flash、DeepSeek V4.1 Flash 与 GPT-6 Luna 的对比,本质上是三种不同高性价比方案的取舍。ERNIE 5.5 Flash Preview 目前在 OpenRouter 上可以免费调用;DeepSeek V4.1 Flash 提供 MIT 协议开放权重,且高峰期每百万 token 价格为 $0.30/$1.20,闲时更是直接半价;GPT-6 Luna 则拥有最低的付费标价:每百万输入 token $0.10、输出 $0.50。
这三款模型均支持约 1M token 的上下文窗口并具备工具调用能力,主要差异体现在定价结构、权重开放程度以及成熟度上。下文所有价格均于 2026 年 11 月 12 日核对自各平台官方页面,最后一节还将展示如何让你的编码 Agent 用一条提示词同时测试这三款模型。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
ERNIE 5.5 Flash、DeepSeek V4.1 Flash 与 GPT-6 Luna 核心参数一览
| 对比维度 | ERNIE 5.5 Flash Preview | DeepSeek V4.1 Flash | GPT-6 Luna |
|---|---|---|---|
| API 模型 ID | baidu/ernie-5.5-flash-preview:free(OpenRouter) |
deepseek-flash |
gpt-6-luna |
| 每百万输入价格 | OpenRouter 免费;付费价格 [待核实] | 高峰 $0.30,闲时 $0.15 | $0.10 |
| 每百万缓存输入价格 | 免费端点不适用 | 高峰 $0.006,闲时 $0.003 | $0.01 |
| 每百万输出价格 | OpenRouter 免费;付费价格 [待核实] | 高峰 $1.20,闲时 $0.60 | $0.50 |
| 上下文窗口 | 1,024,000 tokens | 1M tokens | 1,050,000 tokens |
| 最大输出长度 | 1,024,000(OpenRouter 标注) | 384K | 128,000 |
| 参数规模 | 总计 280B,激活 14B(MoE) | 552B 主干,预填充激活 8B / 解码激活 16B | 未公开 |
| 输入模态 | 文本 | 文本、图像 | 文本、图像 |
| 开放权重 | Base 模型已开放;Preview 预计“很快”按 Apache 2.0 开源 | 是,MIT 协议 | 否 |
| 当前状态 | 预览检查点(Preview) | 生产就绪(版本 1017) | 生产就绪 |
数据来源:百度发布公告、OpenRouter、DeepSeek 定价页面以及 OpenAI Luna 模型页。
三款高性价比模型各自是什么?
ERNIE 5.5 Flash Preview 是百度基于 11 月初在 Hugging Face 发布的 ERNIE 5.5 Flash Base 打造的首个后训练模型。它是一个 280B 稀疏混合专家(MoE)模型,激活参数为 14B,支持 1M token 上下文。百度称其为中间检查点,意味着后训练尚未最终完成。它是百度 ERNIE 5.5 Flash 系列在更早的 ERNIE 5.1 之后推出的新版本。
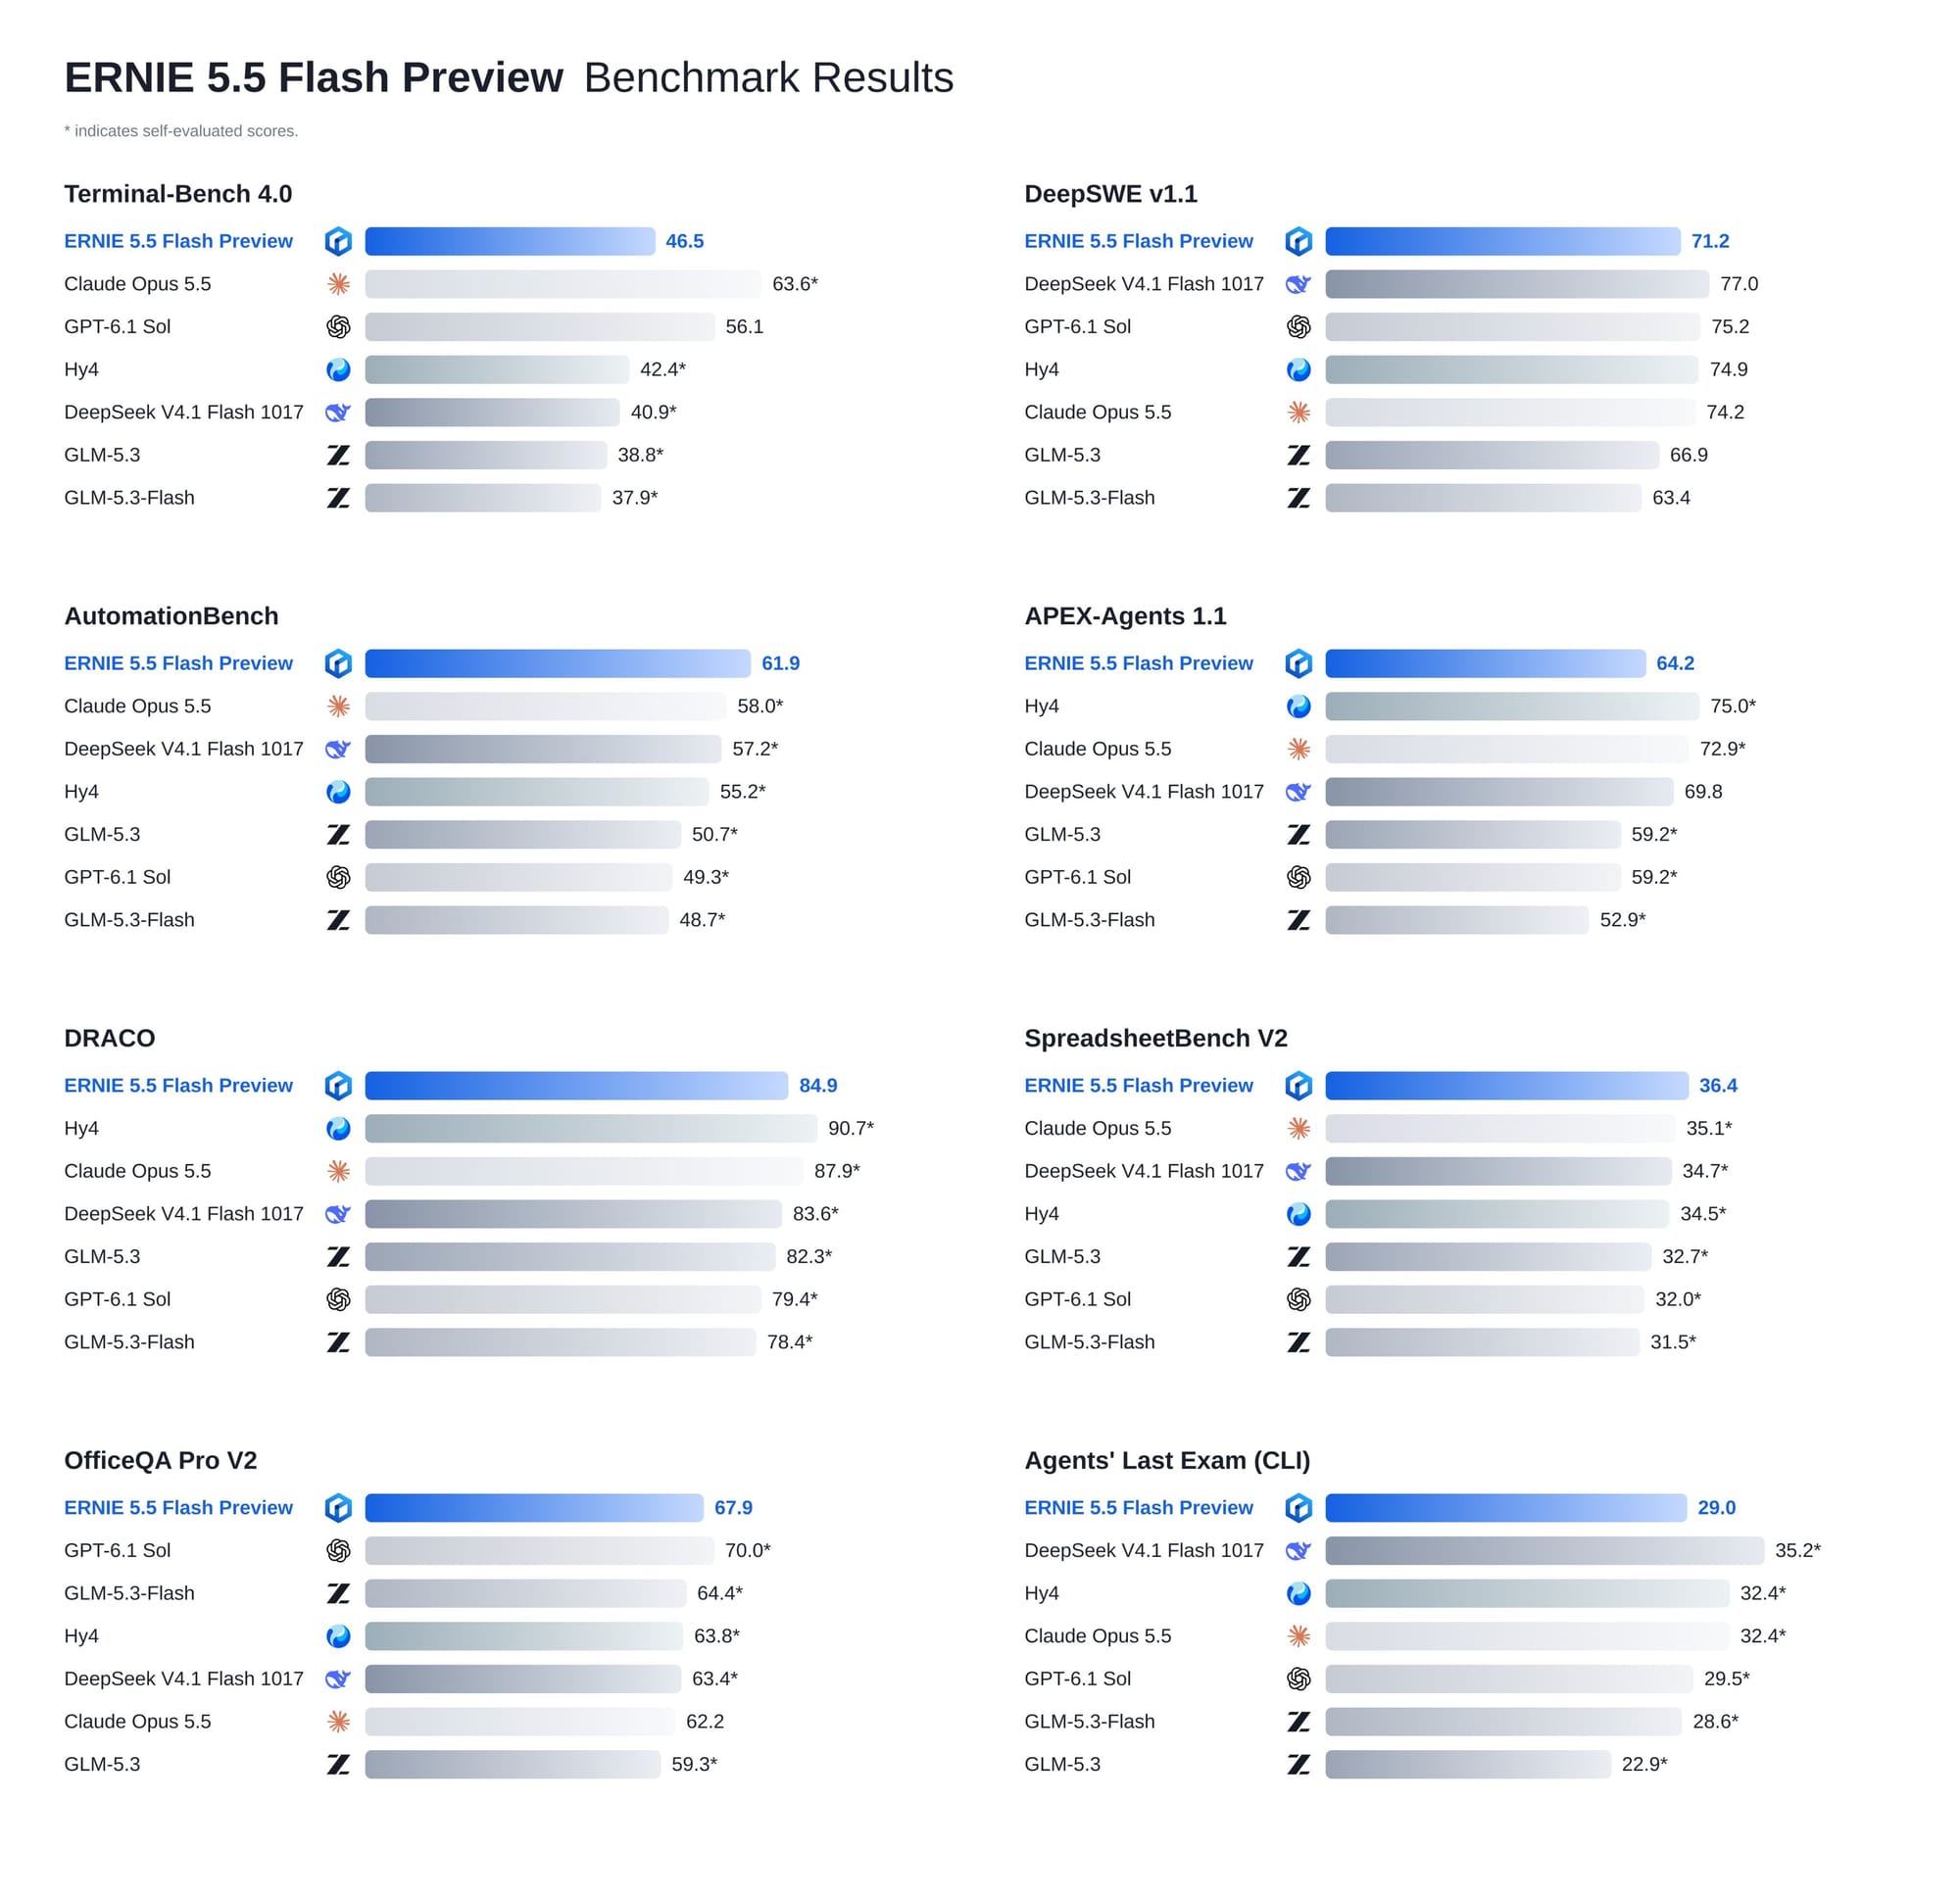
DeepSeek V4.1 Flash 是一款拥有 552B 主干参数的多模态 MoE 模型。它在预填充(prefill)阶段每个 token 激活 8B 参数,在解码(decode)阶段激活 16B 参数,这使得输入密集型的 Agent 任务成本极低。其权重已以 MIT 协议在 Hugging Face 上开源,详见 DeepSeek V4.1 Flash 深度解析。
GPT-6 Luna 是 OpenAI 面向“专注、高吞吐量任务最高效的模型”。它支持文本与图像输入,支持从 none 到 max 的推理强度调节,并可搭配 Responses API 的各类工具使用,详见 什么是 GPT-6 Luna。
每百万 token 定价与真实 Agent 调用成本
Agent 循环会在每一步重复发送相同的长上下文,因此缓存计费和分时折扣规则与表面单价同样重要。
- GPT-6 Luna: 输入 $0.10,缓存输入 $0.01,缓存写入 $0.125,输出 $0.50。当提示词超过 272K 输入 token 时,整次请求的输入单价翻倍(2x)、输出单价变为 1.5 倍。Batch 和 Flex 模式的费用为标准价格的 50%。
- DeepSeek V4.1 Flash: 高峰时段输入(缓存未命中)$0.30,缓存命中 $0.006,输出 $1.20;闲时费率全部减半。高峰时段为周一至周五的 01:00–04:00 及 06:00–10:00 UTC;其余所有时间(含周末全天)均为闲时。
- ERNIE 5.5 Flash Preview: 在 OpenRouter 的
:free端点上输入和输出均为 $0(受速率限制)。截至本文撰写时,百度尚未在我们可公开查阅的页面上公布按 token 计费的正式单价,因此在其他渠道看到的任何付费价格均应视为 [待核实]。
以一次不命中缓存、包含 50,000 输入 token 和 2,000 输出 token 的单步 Agent 调用为例:
| 模型 | 单次调用成本 | 1,000 次调用成本 |
|---|---|---|
| GPT-6 Luna | $0.0060 | $6.00 |
| DeepSeek V4.1 Flash(高峰) | $0.0174 | $17.40 |
| DeepSeek V4.1 Flash(闲时) | $0.0087 | $8.70 |
ERNIE 5.5 Flash Preview(:free) |
$0 | $0(在速率限制范围内) |
现在假设其中 90% 的输入命中了缓存(这对于反复读取同一个代码库的 Agent 来说非常普遍):Luna 的单次调用成本降至约 $0.0020(外加一次性缓存写入费用);DeepSeek 在高峰时段降至约 $0.0042,在闲时降至约 $0.0021。在闲时阶段,两款付费模型之间的成本差距几乎消失。
需要注意两个细节:首先,不同厂商使用各自的分词器(tokenizer),同一段提示词计算出的 token 数量会有差异;其次,推理 token 按输出价格计费,因此开启高推理强度会显著拉高输出费用。关于缓存成本和分时定价的详细测算,可参考我们的 DeepSeek V4.1 Flash 定价拆解 与 1 美元以下 API 档位对比。
上下文窗口、输出长度与速度
上下文窗口大小并不是决定性因素,三者差距主要体现在最大输出长度上:DeepSeek 为 384K,Luna 为 128,000,而 ERNIE 免费端点标注为 1,024,000。对于速度宣传则需保持谨慎:
- ERNIE 5.5 Flash Preview: OpenRouter 的模型描述称其速度超过每秒 200 token;但 OpenRouter 自身在过去 3 天内针对单一提供商(百度千帆)实测的 P50 吞吐量为每秒 79 token,P50 延迟为 2.53 秒。
- DeepSeek V4.1 Flash: 定价页面未公布每秒 token 数,仅列出了 2,500 的并发限制。
- GPT-6 Luna: OpenAI 将其速度评级为“Fast(快)”,Build 档位限制为每分钟 5,000 次请求和 2,000,000 tokens。
建议在你所在的地区使用真实提示词进行实测;下文的 Apifox 小节提供了现成的测试配置。
开放权重、免费额度与许可证
- DeepSeek V4.1 Flash 是三者中唯一今天就提供可下载生产级权重的模型,采用 MIT 协议开源。你可以自行部署,也可以从其 Hugging Face 模型卡中选择托管服务商。
- ERNIE 5.5 Flash 包含两个构件:仅预训练的 Base 模型(基于 33.5T token 训练)已上线 Hugging Face;而负责对话和 Agent 任务的 Preview 模型尚未公开权重,百度表示将“很快”按 Apache 2.0 协议开源,网上传播的具体开源日期均未经官方证实 [待核实]。
- GPT-6 Luna 为闭源模型。你可以通过 OpenAI API 或 Amazon Bedrock 调用它,且官方页面将 API 免费档位标注为“不支持(Not supported)”。
对于 $0 零成本测试而言,ERNIE 的 :free 端点是最省事的入口。DeepSeek 和 Luna 也有各自的免费体验途径,详见 如何免费使用 DeepSeek V4.1 Flash 与 如何免费使用 GPT-6 Luna。
编码与 Agent 场景适配度
各家厂商都在各自的测试框架(harness)下运行基准测试,因此不宜将那些分数直接横向等同对比,更应该关注各家侧重的能力。
DeepSeek V4.1 Flash 在最高推理强度下由官方自测的 Terminal-Bench 2.1 得分为 90.6,DeepSWE v1.1 得分为 74.2。其推理强度支持 1 到 100 的精细调节,且端点同时兼容 OpenAI、Anthropic 和 Responses 格式,因此可以直接接入 Claude Code、Codex 或 OpenCode。
ERNIE 5.5 Flash Preview 在百度发布页面上展示了在单次长达 11 小时的编码任务中构建出一款 Unreal Engine 5.8 游戏,以及根据设计文档生成近 100 款移动端小游戏。不过它目前仅支持文本输入,因此暂不支持依赖截图的视觉 Agent 循环。此外,OpenRouter 面板显示其近 3 天的结构化输出错误率为 21.70%,工具调用错误率为 1.01%,因此在流水线中使用时请务必校验 JSON 输出。
GPT-6 Luna 在工具生态广度上胜出。通过 Responses API,它可以使用托管 shell、apply patch、computer use 以及 MCP。需要注意一个限制:在 Chat Completions 接口下,仅当 reasoning_effort 设为 none 时才支持函数调用;如需在开启推理的同时使用工具,请调用 Responses API。
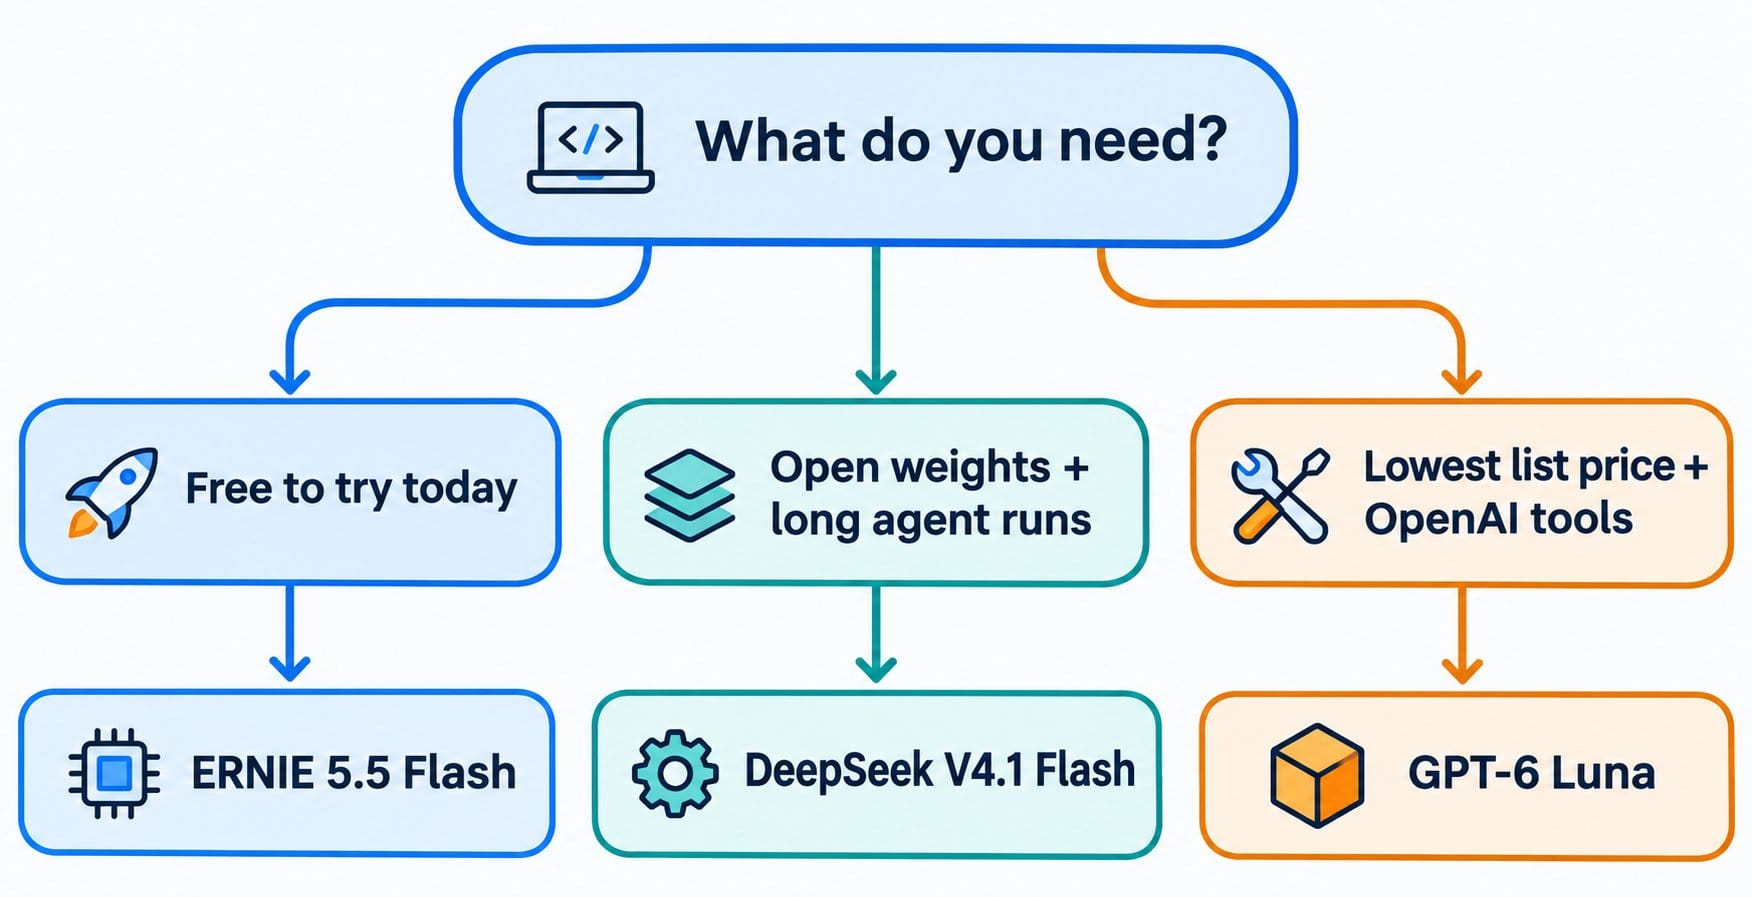
到底应该选哪款高性价比模型?
请根据你的实际约束条件(而非排行榜分数)来选择:
- 今天想以 $0 成本试用新模型: 选择 OpenRouter 上的 ERNIE 5.5 Flash Preview(需接受预览版特性及速率限制)。
- 需要开放权重或计划自托管: 选择 DeepSeek V4.1 Flash。
- Agent 需要运行长上下文、高输入占比的任务,且可以安排在闲时执行: 选择 DeepSeek V4.1 Flash(闲时缓存命中仅需每百万 token $0.003)。
- 追求最低的付费标价以及 OpenAI 的托管工具集: 选择 GPT-6 Luna。
- 需要图像输入支持: 选择 DeepSeek V4.1 Flash 或 GPT-6 Luna,排除 ERNIE。
让你的编码 Agent 使用 Apifox CLI 同时对比三款模型
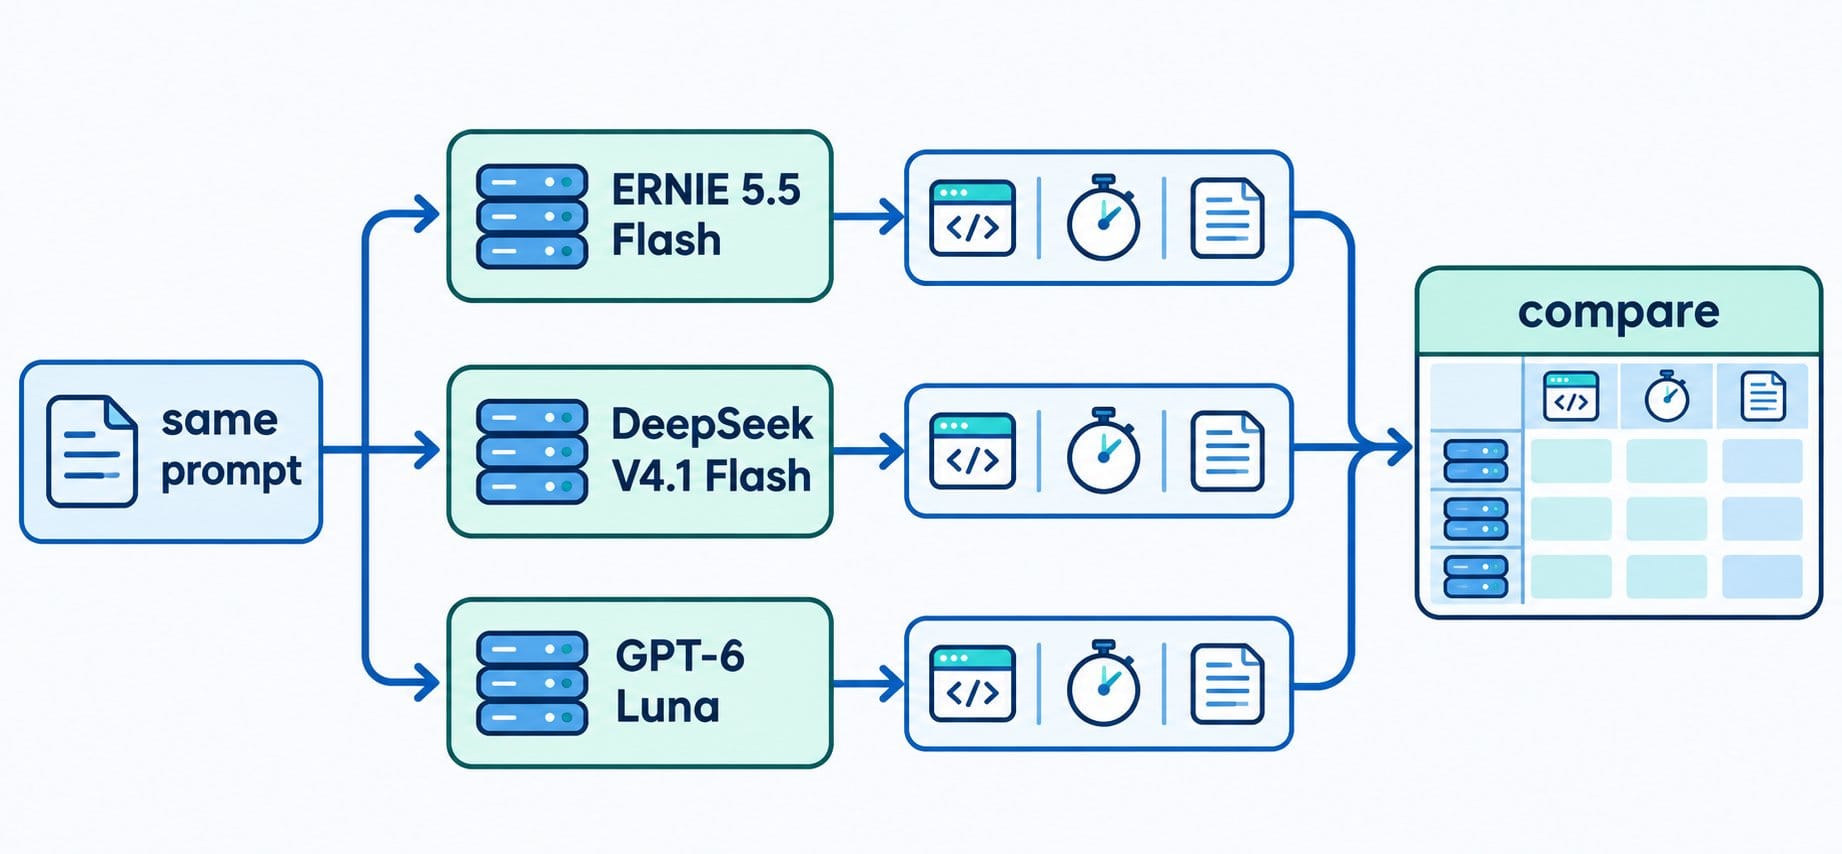
不必每次模型更新都手动去点三次 API 调用。你可以让 Claude Code、Codex 或 Cursor 配合 Apifox CLI 构建一个测试场景,并分别针对三个提供商运行。这三款模型都支持 OpenAI Chat Completions 格式,因此只需切换 base URL、模型 ID 和 API 密钥即可。
只需完成一次 CLI 初始化:
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_TOKEN>
apifox skill install
然后向你的 Agent 发送一条提示词:
In Apifox project <projectId>, create three environments: ernie-flash
(base URL https://openrouter.ai/api/v1, model baidu/ernie-5.5-flash-preview:free),
deepseek-flash (https://api.deepseek.com, model deepseek-flash) and gpt-6-luna
(https://api.openai.com/v1, model gpt-6-luna). Create one test scenario that POSTs
the same prompt to {{baseUrl}}/chat/completions with model {{model}}, asserts
status 200 and a non-empty choices[0].message.content, and records
usage.completion_tokens. Run it 5 times per environment and give me a table of
pass rate, average response time and output tokens.
Agent 会创建这三个环境、对照 schema 校验场景 payload、写入场景并执行测试:
apifox environment create ernie-flash --project <projectId> --base-url https://openrouter.ai/api/v1 --variables '<json>'
apifox environment create deepseek-flash --project <projectId> --base-url https://api.deepseek.com --variables '<json>'
apifox environment create gpt-6-luna --project <projectId> --base-url https://api.openai.com/v1 --variables '<json>'
apifox cli-schema get test-scenario-create
apifox cli-schema validate test-scenario-create --file scenario.json
apifox test-scenario create --project <projectId> --file scenario.json
apifox test-scenario run <scenarioId> --project <projectId> -e <envId> -n 5 -r cli,json --env-var "apiKey=$OPENROUTER_API_KEY"
通过 --env-var 传入密钥可以避免将密钥明文保存在共享环境中。针对每个环境换用对应提供商的密钥重复运行后,生成的 JSON 报告即可汇总成对比表格。同一条运行命令加上 -r junit 即可直接接入 CI;具体配置请参阅 Apifox CLI CI/CD 指南。Apifox 免费版不限制成员数量和协作人数。
常见问题
ERNIE 5.5 Flash 比 DeepSeek V4.1 Flash 更便宜吗? 就目前而言是的:OpenRouter 的 :free 端点在速率限制范围内收费为 $0。由于百度尚未公布可核实的按 token 付费单价,目前还无法进行付费档位对付费档位的直接比较。
哪款模型的上下文窗口最大? 三者非常接近:GPT-6 Luna 标注为 1,050,000 tokens,ERNIE 5.5 Flash Preview 在 OpenRouter 上为 1,024,000 tokens,DeepSeek V4.1 Flash 为 1M tokens。需要注意的是,当输入超过 272K tokens 时,Luna 的输入单价会翻倍。
这几款模型可以在本地运行吗? DeepSeek V4.1 Flash 可以:其 MIT 协议权重已在 Hugging Face 公开。ERNIE 5.5 Flash 的 Base 权重已公开,但 Preview 对话模型尚未发布。GPT-6 Luna 没有公开权重。
哪款最适合用于编码 Agent? 这取决于你的运行框架。DeepSeek V4.1 Flash 在官方自测中取得了很高的 Agent 基准分数,且同时支持 OpenAI 和 Anthropic 格式;GPT-6 Luna 拥有最丰富的托管工具集;ERNIE 5.5 Flash Preview 可以免费试用,但仅支持纯文本且仍处于预览阶段。
GPT-6 Luna 有免费 API 档位吗? 没有。OpenAI 的模型页面将免费档位(Free tier)标注为“Not supported(不支持)”。付费使用起步价为每百万输入 token $0.10。