Anthropic 于 2026 年 9 月 22 日发布了 Claude Opus 5.5。对调用 Claude API 的人来说,这次升级只是一个字符串:claude-opus-5 变成 claude-opus-5-5。
这个字符串背后是:输入和输出每 token 都便宜 20%,单次响应最多输出 128,000 token,官方称输出速度快 30%,并且可以持续在同一个任务上工作 18 小时以上。对于你针对 Opus 5 调优过的代码来说,这些变化都不是没有代价的。
这是该模型线上的第二次迁移,而它的性质与第一次完全不同。从 Opus 4.8 到 Opus 5 是一次正确性迁移:默认值在可运行的代码底下发生了变化,一个此前合法的请求组合开始直接返回 400。而这次迁移关乎预算和运行边界,工作量在于重新测量你曾经测量过的每一个数字,因为它们全都变了。Opus 5.5 还与两个新的 OpenAI 模型在同一天发布,那是另一个话题。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

差异对比:只列出我们能查证的字段
| 项目 | Opus 5 | Opus 5.5 | 变化 |
|---|---|---|---|
| 模型 ID | claude-opus-5 | claude-opus-5-5 | 一个字符串 |
| 输入,每百万 token | $5.00 | $4.00 | 降低 20% |
| 输出,每百万 token | $25.00 | $20.00 | 降低 20% |
| 缓存写入,每百万 | 见厂商页面 | $5.00 | 未知 |
| 缓存读取,每百万 | 见厂商页面 | $0.20 | 未知 |
| Fast 模式,每百万 | 见厂商页面 | 输入 $8.00,输出 $40.00 | 未知 |
| 最大输出 token | 见厂商页面 | 128,000 | 未知 |
| 上下文窗口 | 见厂商页面 | 1,000,000 | 未知 |
表格中留空的单元格是有意为之。Anthropic 在其模型页上公布了 Opus 5.5 一侧的数据,我们不会凭记忆去还原 Opus 5 一侧,因为在成本模型里写错一个数字比缺一个数字更糟。在用这些数据估算节省金额之前,请先从 Anthropic 的定价页上补齐那五行。
1. 模型 ID 的变更是真的,20% 是真的,40% 需要仔细读
换掉这个字符串,你每 token 在两个方向上都少付 20%。这部分是纯算术:输入从 $5 降到 $4,输出从 $25 降到 $20,两侧降幅一致。
Anthropic 还表示 Opus 5.5 的运行成本比 Opus 5 低 40%。这两个数字并不冲突,但它们也不是同一个论断。仅靠每 token 降价 20% 无法带来 40% 的账单下降,另一半必须来自模型用更少的 token 完成同样的工作——而 token 效率与具体负载高度相关,这一点是价目表无法体现的。
所以,把 40% 当作重新测量的理由,而不是直接填进预测表的数字。用完全相同的 prompt 和设置,把上周真实流量中有代表性的一部分分别打到两个模型 ID 上,对比 usage 字段本身而不是你对它的印象,再用实际 token 数乘以新价格。结果会落在 20% 到 40% 之间,而落在哪里能告诉你:你的 prompt 里究竟有多少内容其实从来不需要。
2. 缓存是表格中变化最大的一项价格
Opus 5.5 的缓存读取是每百万 token $0.20,而全新输入是 $4.00,相当于 95% 的折扣。缓存写入是每百万 $5.00,比不缓存直接发送这些 token 需要支付的 $4.00 高出 $1.00。
这笔溢价在第一次命中缓存时就已经回本,而且还有富余。写入一个前缀比不缓存每百万多花 $1.00,而之后每次读取该前缀都省下 $3.80。大约只要复用四分之一次就能回本;实际含义是:只要这个前缀被复用哪怕一次,缓存它就是划算的。
下面是一个 200,000 token 系统提示词的测算——一旦你把 OpenAPI 规范包粘进去,这就是个正常的规模:
| 方案 | 10 次调用的成本 |
|---|---|
| 每次都用全新输入,$4.00/M | $8.00 |
| 写入一次 $5.00/M,之后 9 次读取 $0.20/M | $1.36 |
相同的 prompt、相同的模型,成本降低 83%。要得到第二行的结果,需要在请求里显式标记这个前缀:
{
  "model": "claude-opus-5-5",
  "max_tokens": 4096,
  "system": [
    {
      "type": "text",
      "text": "<your 200k-token spec bundle>",
      "cache_control": {"type": "ephemeral"}
    }
  ],
  "messages": [
    {"role": "user", "content": "Which endpoints changed between v2 and v3?"}
  ]
}
然后读取响应来确认确实命中了缓存,因为“你以为有、实际却没有”的缓存是最贵的一种:
"usage": {
  "input_tokens": 41,
  "cache_creation_input_tokens": 204800,
  "cache_read_input_tokens": 0,
  "output_tokens": 612
}
第一次调用时,cache_creation_input_tokens 承担了全部量;之后每次调用,该数字都应归零,并由 cache_read_input_tokens 接手。如果没有,说明上游有东西在改动你的前缀,通常是时间戳、请求 ID 或工具列表顺序变化。在 Apifox 中保存一个请求并连续发两次,是观察这两个字段哪个发生变化的最快方式。完整算法(包括 1M 上下文究竟值不值得缓存)见 Opus 5.5 缓存成本计算。
3. 128,000 token 的响应,首先是客户端问题,其次才是模型问题
Opus 5.5 单次响应最多返回 128,000 个输出 token。按每百万 $20 计算,一次打满的调用是 $2.56——在有人把重试循环里的 max_tokens 设成上限之前,这个数字值得先知道。
更大的问题在于模型和你的代码之间的一切:
- HTTP 读取超时。这么长的响应耗时以分钟计,而不是秒。大多数 SDK 和反向代理的默认客户端超时都短于这个时间。
- 代理和网关缓冲。在转发前缓冲完整 body 的网关,每个在途请求都要占用数 MB 内存,有些网关会直接断开连接。
- 非流式调用。不使用流式,你就得全程干等,既拿不到任何中间结果,也没有可检查点的位置。
- 被截断的 JSON。在 object 中途撞上
max_tokens会产出非法 JSON,而不是可以挽救的部分 object。解析之前先检查stop_reason。
因为上限提高就把 max_tokens 调大,是简单的那一半;让你的超时链路、缓冲区和解码器都与新上限一致,才是会引发故障的那一半。
4. 输出更快不等于等待更短
Anthropic 称 Opus 5.5 的输出速度比 Opus 5 快 30%。但输出速度只是你实际提供服务的延迟中的一项。首 token 时间、重试和排队与它并列,如果一个模型在首 token 到达前思考更久,即使它的流式输出更快,体感也可能更慢。
所以要测量。从同一个网络位置,把一组固定的代表性 prompt 分别打到两个模型 ID 上,并分别记录首 token 时间和总时间的 p50 与 p95。平均延迟会掩盖那个让你被叫醒的个例。
如果你把 API 测试场景放在 Apifox 里,这件事工作量很小:克隆一个已保存的请求,改掉模型 ID,用定时任务分别运行,然后看响应时间序列而不是掐秒表。关键在于带着一个“迁移前”的数字进入迁移,因为一旦切换完成,就再也拿不到这个数字了。
5. Fast 模式正好是标价的两倍
Opus 5.5 的 fast 模式价格是每百万输入 $8.00、每百万输出 $40.00。和标准的 $4.00 与 $20.00 放在一起看,这条定价规则很好记:fast 模式在两侧都是标准的 2 倍。
这让决策变成算术而不是判断:如果某条路由上的延迟值得让这条路由的 token 账单翻倍,就在那里用;否则就不用。常见的划分是:交互路径用 fast 模式,批处理和后台任务用标准价格。
6. 把基准表当作测试的理由,而不是测试结果
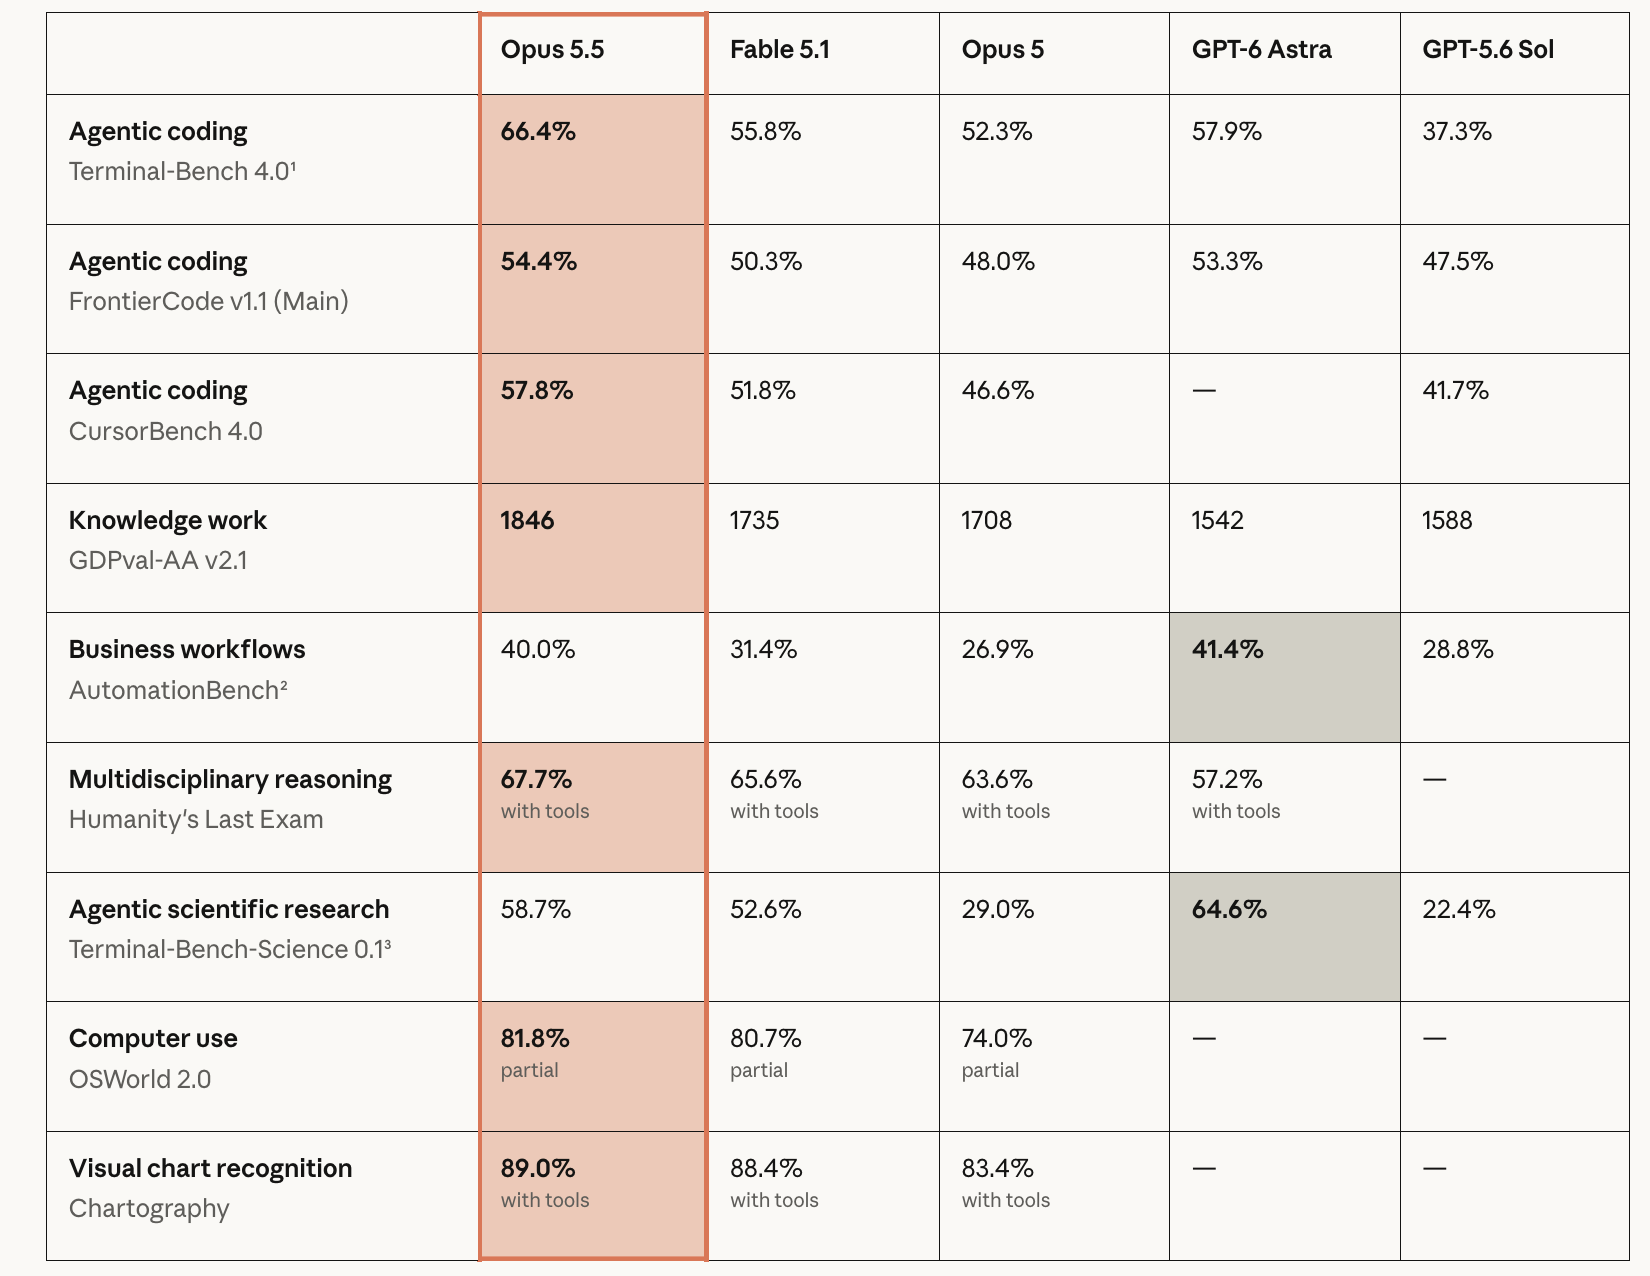
Anthropic 公布的 Opus 5.5 数据很亮眼:Terminal-Bench 4.0 为 66.4%,FrontierCode v1.1 为 54.4%,CursorBench 4.0 为 57.8%,GDPval-AA v2.1 为 1846 Elo,AutomationBench 为 40.0%,带工具的 Humanity’s Last Exam 为 67.7%,OSWorld 2.0 为 81.8%,Chartography 为 89.0%。第三方机构 Artificial Analysis(并非两家厂商中的任何一方)在其指数上将 Opus 5.5 排在 212 个模型中的第一位,得分 58。
还有两项厂商声明在运维上比在竞争上更有意义。Opus 5.5 被设计为可以在单个任务上持续工作 18 小时以上,这打破了许多关于超时、重试与可恢复性的常规假设。另外 Anthropic 报告其成功绕过边界的尝试减少了 85%——这是你自己接口上可测试的一个属性,而不是你能自动继承的属性。
这些都不能告诉你 Opus 5.5 在你的 prompt 上是否更好。在切换生产环境之前,用你自己的评测集在两个模型 ID 上跑一遍——理由和你不会仅凭厂商的基准数字就上线一次数据库升级一样。
迁移清单
- 先在一个服务里把
claude-opus-5改成claude-opus-5-5,而不是所有服务一起改。 - 在假定参数面没有变化之前,先读 Anthropic 针对这次迁移的指南。4.8 到 5 的那次跳跃曾经悄悄地改变了默认值,所以要验证,而不是推断。
- 把一部分真实流量分别打到两个 ID 上,并对比
usage字段的差异。 - 按 $4 和 $20 重新计算月度支出,并单独按 $5 缓存写入和 $0.20 缓存读取再算一遍。
- 通过
cache_read_input_tokens确认缓存命中,而不是相信前缀是稳定的。 - 在有人把
max_tokens设到接近 128,000 之前,先调高 HTTP 读取超时并检查网关缓冲。 - 切换之前,记录两个 ID 上的 p50 和 p95 延迟。
- 按路由逐个决定是否使用 fast 模式,并记住它是标价的 2 倍。
- 重新运行你自己的评测集。厂商基准是测试的理由,而不是测试本身。
Opus 5.5 是你已经在调用的模型的一个更便宜、更快、运行更久的版本。迁移风险不在于字符串替换会失败,而在于你把一个成本模型、一个超时值和一个 max_tokens 沿用下来,而它们都是按另一个模型来设定的。
常见问题
claude-opus-5-5 能直接替换 claude-opus-5 吗?只有在核对了 Anthropic 针对这次迁移的指南之后,才可以当作直接替换。模型 ID 的改动只是一行编辑,但这条模型线上的上一次迁移曾在不改变请求形态的情况下改变了默认值,所以验证是很便宜的保险。
Opus 5.5 便宜多少?两个方向每 token 都便宜 20%,输入从 $5 到 $4,输出从 $25 到 $20。Anthropic 另外声明运行成本下降 40%,这意味着在降价之外还有 token 效率的提升。测量你自己的负载,看最终落在两者之间的哪个位置。
Opus 5.5 的 prompt 缓存成本是多少?写入每百万 token $5.00,读取每百万 $0.20,而未缓存的输入是 $4.00。缓存前缀只要被复用一次,就足以覆盖写入溢价。
128,000 token 的输出上限会改变客户端里的什么东西吗?通常会。检查你的 HTTP 读取超时、网关缓冲,以及是否使用流式。还要在解析之前检查 stop_reason,因为在上限处被打断会产出非法 JSON,而不是一个被截断的 object。
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。