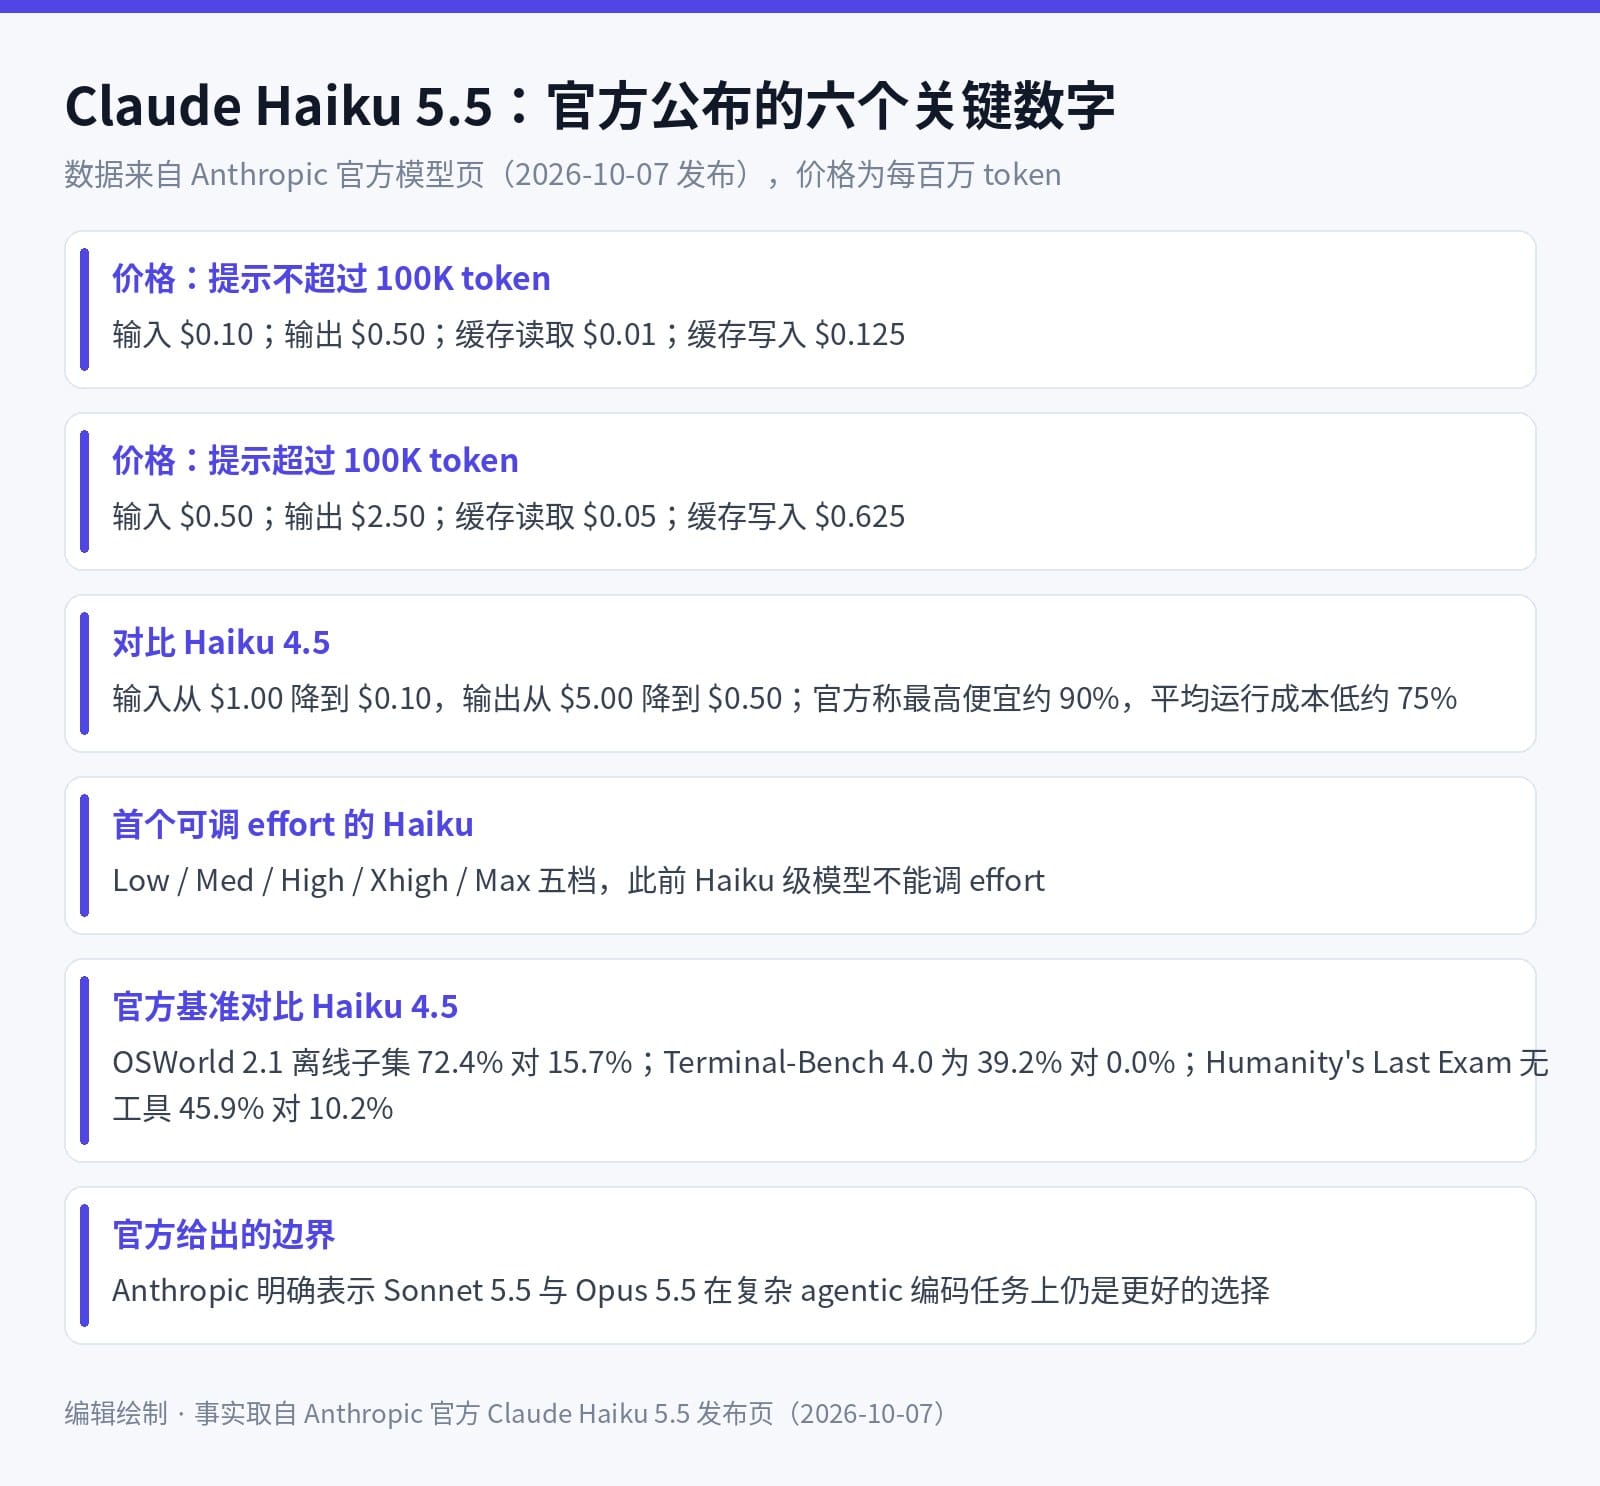
摘要:2026 年 10 月 7 日,Anthropic 发布 Claude Haiku 5.5(模型 ID claude-haiku-5-5),官方把它称为"迄今最便宜、最快、能力最强的小模型"。按官方定价页,提示不超过 10 万 token 时输入 $0.10、输出 $0.50(每百万 token),缓存读取 $0.01、缓存写入 $0.125;相比 Haiku 4.5 的 $1.00 / $5.00,官方称 10 万 token 以内的请求便宜约 90%。同一天,Claude Code 2.1.293 把它设为默认 Haiku 模型,GitHub Copilot 也在模型选择器里上线。它也是第一个可以调 effort 档位的 Haiku 级模型。
导语:过去一年,小模型在 Agent 里的角色一直很尴尬。子 Agent 要做的活——压缩上下文、给文件写摘要、给测试失败分类、把一堆日志归纳成一句话——token 消耗大、单次价值低,用 Sonnet 或 Opus 太贵,用上一代 Haiku 又经常做不对,于是很多团队干脆把子 Agent 也交给大模型,成本就是这么涨上去的。Haiku 5.5 动的是这个位置:把 Haiku 级的价格再压一个数量级,同时第一次把 effort 档位下放到这一档。本文要说清楚三件事:它便宜在哪里、能力到什么程度、以及哪些活仍然不该交给它。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

发生了什么:一天之内,发布、SDK 默认值和 IDE 选择器同时到位
这次更新不是一个孤立的模型发布,而是三个同日动作叠在一起。
第一,Anthropic 在 10 月 7 日发布 Claude Haiku 5.5,并写明它已经成为 Anthropic API 上的默认 Haiku 模型。定价页给出的完整价格是:提示不超过 10 万 token 时,输入 $0.10、输出 $0.50、缓存读取 $0.01、缓存写入 $0.125(均为每百万 token);提示超过 10 万 token 后跳档到 $0.50 / $2.50 / $0.05 / $0.625。作为对照,同一页面列出 Haiku 4.5 为输入 $1.00、输出 $5.00,Sonnet 5.5 为输入 $2.00、输出 $10.00。Anthropic 自己的说法是:10 万 token 以内的请求便宜约 90%,整体平均运行成本低约 75%。
第二,Claude Code 在 v2.1.293(10 月 7 日)的发布说明里写明"新增 Claude Haiku 5.5,现为 Anthropic API 上的默认 Haiku 模型",并给出 1M 上下文。也就是说,用 Claude Code 的人不一定需要改配置,升级之后这一档的默认模型就已经换了。
第三,GitHub 在同日的 Copilot Changelog 里宣布 Claude Haiku 5.5 在 GitHub Copilot 全面可用,面向 Copilot Pro、Pro+、Max、Business 和 Enterprise 用户,可在 VS Code、Visual Studio、Copilot CLI、Copilot cloud agent、GitHub Copilot app、github.com、GitHub Mobile、JetBrains IDE、Xcode 和 Eclipse 的模型选择器里切换,按供应商标价走用量计费。企业版和组织版管理员可以用 Copilot 设置里的模型策略控制是否放开;在默认模型启用策略下,新模型会先被自动启用。
云端可用性方面,Anthropic 表示该模型已在 Amazon Web Services、Google Cloud 和 Microsoft Azure 上提供。
一个具体工作流:把子 Agent 从 Sonnet 换成 Haiku 5.5
设想一个常见场景:你在 Claude Code 里做一次涉及十几个文件的重构。
改造前,典型分工是主 Agent 用 Opus 5.5 做规划和最终判断,遇到"读某个文件、总结它对外暴露了什么接口、判断这次改动会不会影响调用方"这类子任务,就交给一个子 Agent。出于准确率考虑,子 Agent 通常配 Sonnet 5.5。按官方标价直接相乘估算:如果一天里子 Agent 累计消耗 100 万输入 token 和 20 万输出 token,Sonnet 5.5 这一项就是 1×$2.00 + 0.2×$10.00 = $4.00。
换成 Haiku 5.5 之后,同样的 token 量按官方单价算是 1×$0.10 + 0.2×$0.50 = $0.20。数字差距是 20 倍,而这次的工作流变化不止是省钱:因为 Haiku 5.5 是第一个能调 effort 的 Haiku 级模型,你可以给小任务配低档、给需要推理的归因任务配中高档。比如"把这份测试输出归纳成一句话"设 Low,"这次失败是断言问题还是环境问题"设 Med 或 High,而不用在 Sonnet 和 Haiku 之间二选一。
交付与反馈环节才是真正要观察的地方。子 Agent 判断错一次,主 Agent 就得重新读一遍文件、重新推理,省下来的钱会被重复调用吃掉。所以换模型之后第一件该做的事,不是看账单,而是拿过去一周真实跑过的子任务做一次对照:同样的 prompt,Haiku 5.5 的结论和 Sonnet 5.5 差多少。
为什么这件事改变工作流:小模型从"兜底"变成"默认"
官方公布的一组对比数据解释了 Anthropic 为什么敢把这一档当默认。按其发布页,Haiku 5.5 相比 Haiku 4.5:OSWorld 2.1 离线子集从 15.7% 提升到 72.4%,Terminal-Bench 4.0 从 0.0% 提升到 39.2%,Humanity's Last Exam 从无工具 10.2%、有工具 18.7% 提升到 45.9% 和 57.4%,GDPval-AA v2.1 从 735 提升到 1620。需要说明的是,这些是 Anthropic 自己公布的基准结果,属于产品方数据,第三方独立复现才能确认。
更重要的是定价结构。此前"便宜"和"够用"在 Haiku 这一档是互斥的,团队只能把大模型用在所有需要判断力的地方;现在子 Agent 可以在成本上忽略不计的前提下跑量,架构上的直接后果是:上下文压缩可以做得更勤(每次压缩都是一次模型调用)、日志归类和影响面分析可以每个文件跑一次而不是每批跑一次、可以并行开更多子 Agent 再汇总。换句话说,成本约束从"少调用、用大模型"变成"多调用、小模型打底、关键步骤才上大模型"。
限制、边界,以及人应该在哪里接管
第一,官方自己划了边界。Anthropic 在发布页明确写,Sonnet 5.5 与 Opus 5.5 在复杂 agentic 编码任务上仍然是更好的选择,Haiku 5.5 适合更窄的任务。把主循环交给它,等于赌它每一步判断都对,而这正是官方没有承诺的部分。
第二,价格有台阶。超过 10 万 token 提示之后,输入从 $0.10 跳到 $0.50、输出从 $0.50 跳到 $2.50,缓存读取和写入同步上调一个数量级。对长上下文 Agent 循环来说,这意味着"便宜"能不能兑现,取决于你的上下文管理做得如何——如果一个会话每轮都把完整历史重新塞进提示,很快就会被推过 10 万 token 这条线。压缩频率、历史裁剪和缓存策略,直接决定账单落在哪一档。
第三,安全防护的口径是分层的。发布页说明,Haiku 5.5 的网络安全防护比 Haiku 4.5 更严,但比其他近期模型更松:它会拦下渗透测试类请求,同时允许比 Sonnet 5.5 更宽的防御性安全工作;生物安全防护则与 Sonnet 5、Sonnet 5.5 和 Opus 5 同级。如果你的自动化流程里有安全相关调用,这一档的行为需要单独验证。
第四,关于接管点。effort 档位调低会让模型更少检查自己的结论,这是设计意图,不是缺陷。凡是会删除数据、发布制品、改权限或对外发送内容的动作,仍然应该保留人在回路里确认;也不要因为单价便宜就把审批环节省掉——省下的是钱,代价是错误代价没有变便宜。
如何试用
直接调用:模型 ID 为 claude-haiku-5-5,在 Anthropic API 上它已经是默认的 Haiku 模型,无需额外开关。云平台侧官方说明已在 AWS、Google Cloud 和 Microsoft Azure 提供。
Claude Code:升级到 v2.1.293 及以上,用 /model 查看和切换,该版本同时带来 1M 上下文。effort 可在 Low / Med / High / Xhigh / Max 之间按任务选择。
GitHub Copilot:在支持列表中的任意表面(VS Code、Visual Studio、Copilot CLI、Copilot app、github.com、GitHub Mobile、JetBrains、Xcode、Eclipse)打开模型选择器即可看到。官方注明上线是逐步推进的,暂时看不到属正常。企业版和组织版管理员需要在 Copilot 设置的模型策略里确认是否放开,注意默认模型启用策略会让新模型先自动可用。
信息来源
- Anthropic 官方发布页:Claude Haiku 5.5(2026-10-07,价格、基准、可用性、安全口径)
- Claude Code 发布说明:v2.1.293(2026-10-07,默认 Haiku 模型与 1M 上下文)
- GitHub Changelog:Claude Haiku 5.5 in GitHub Copilot(2026-10-07,可选表面与企业策略)
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。