10 月 2 日,Allen Institute for AI(Ai2)开源了 AstaBrief 8B:一个把研究问题和检索到的文献片段直接写成带引用报告的模型,权重放在 Hugging Face,训练数据、检查点和示例工作流一起放出。它在自家产品里以 Fast 模式上线,单篇报告平均 51.1 秒,而原来 Claude 驱动的 Thinking 模式要 178.5 秒。
「让模型写一份带引用的研究报告」这件事,常见的工程做法是分段做:先检索、再分章节多次调用大模型、最后拼接并补引用。链路越长,引用越容易在拼接中错位或丢失,成本也随调用次数线性上涨。AstaBrief 换了一条路——用 8B 的模型一次写完,引用在生成过程中同步产生。
发生了什么:8B 模型、SFT + DPO,权重与数据全放
AstaBrief 8B 基于 Qwen3-8B 起步,任务是「输入一个研究问题 + 检索到的文献片段,输出一份带引用的报告」,特点是整篇一次写完,而不是逐章节生成。训练没有走强化学习,而是选了一条更简单的路径:监督微调加直接偏好优化(DPO)。
数据侧的细节更值得看。SFT 阶段先用 9 万条真实研究查询做过滤,最终得到 4.7 万条可用样本,这些样本由一个 ScholarQA 流水线生成,背后调用的是 Claude 3.5 / 3.7 Sonnet、o3、o4-mini 和 GPT-4.1。DPO 阶段用了约 6000 对偏好数据,由 GPT-4.1 和 DeepSeek-R1 判定,官方称裁判与人类判断的一致率为 95%。在数据清洗上,他们试了四种基于统计量的过滤器,效果最好的一条是「剔除引用密度过低的报告」。
除了权重,Ai2 还放出了训练数据集与各阶段检查点,以及一个可改造的示例工作流(GitHub 上的 ai2-scholarqa-lib),用来从自己的 PDF 生成报告;评测代码另在 ai2-scholarqa-eval 仓库。模型页在 Hugging Face 的 allenai/AstaBrief_8B。需要注意的是,官方博客没有写明模型、权重或数据的许可证,使用前需要到模型卡与数据集页面确认。
完整工作场景:同一产品里的两档模式
这套模型不是论文里的一次演示,而是直接进了 Ai2 的 Asta 产品:它的报告生成功能现在有两个模式,Fast 模式跑 AstaBrief 8B,Thinking 模式仍由 Claude 驱动。这个对照很干净——同一批用户、同一个界面,唯一的差别是选了哪一档。
速度上,官方给的全流水线平均耗时是 Fast 模式 51.1 秒、Thinking 模式 178.5 秒,约 3.5 倍差距。使用数据也有意思:在 374 名试过 Fast 模式的用户里,29.1% 的人在两天的以上使用过它,平均每人跑了 3.67 条报告线程;有 23% 的人试过之后就没再切回 Thinking 模式。反馈满意度上,Fast 模式 84.2%,Thinking 模式 85.2%,差距不到一个百分点。
效果:赢在哪,没赢在哪
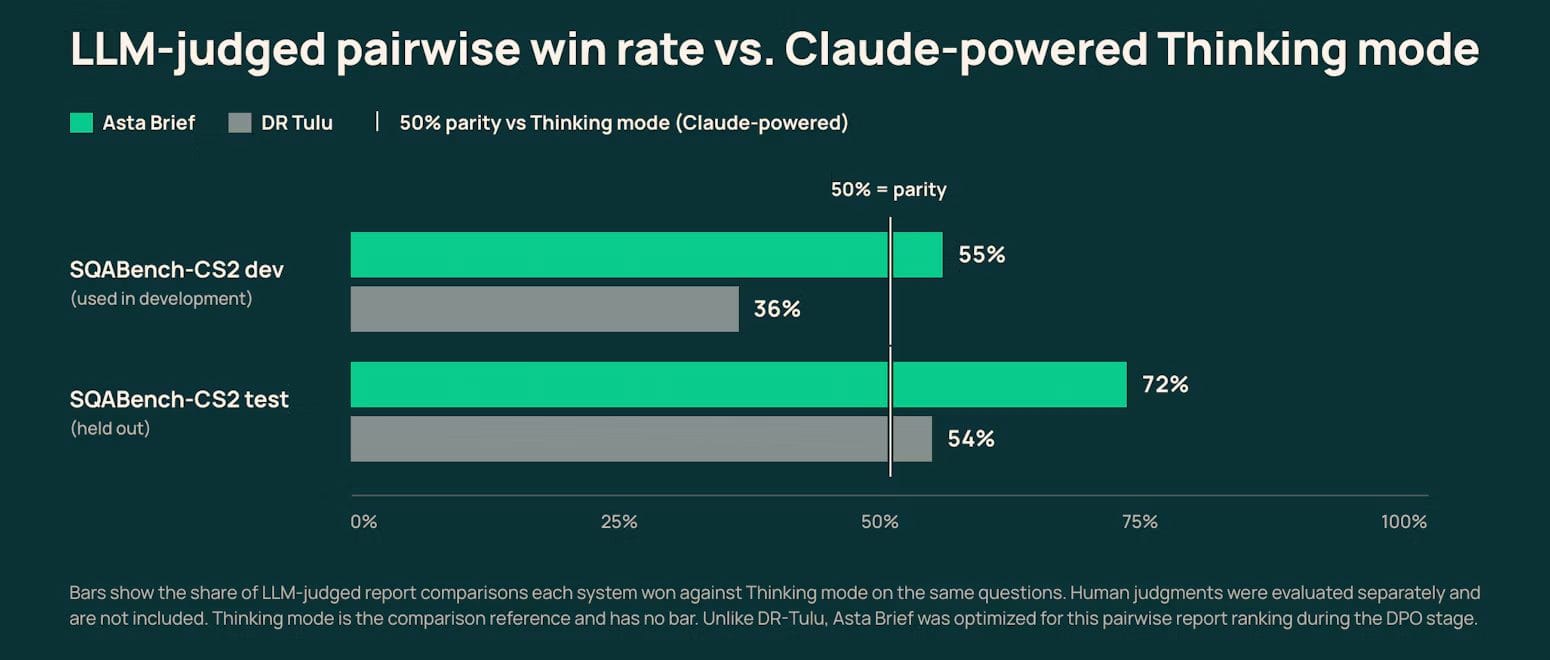
官方主评测是 SQABench-CS2,200 道由用户手写的计算机科学研究问题,跟踪四个指标:评分、答案精度、引用精度和引用召回。同一批问题上,他们用 LLM 做了与 Claude 驱动 Thinking 模式的成对判定:AstaBrief 在开发集胜率 55%、测试集 72%,50% 是持平线;作为对比,DR Tulu 分别是 36% 和 54%。
另一组更能说明问题的是人工研究:3 名研究者、14 个问题。结论是 DR Tulu 在整体偏好上胜出,但三名研究者中有两人在「引用准确度」这一项上更偏好 AstaBrief。这和产品数据对得上——23% 的用户一去不回头,说明它的价值集中体现在「快」和「引用可靠」,而不是「写得更好看」。
为什么这对自建文档生成有意义
关键变化是推理成本与部署位置。8B 的开放权重意味着可以在自己的硬件上跑,包括放在自己的防火墙后面——对有数据出境约束的团队,这是托管 API 给不了的选项。同时,把「一次写完」做成本地小模型的任务,意味着分章节、多次调用、拼接引用那一整层编排代码可以撤掉,链路短了,出错面也就小了。
它的训练配方也可当作参考模板:用强模型(Claude、o3、GPT-4.1)批量生产监督数据,用两个不同的强模型做偏好判定,再用简单过滤器解决数据质量问题——不需要 RL,也不需要自建奖励模型。Ai2 还特意说明了那个反直觉的发现:清洗报告时,「引用密度过低」这一条过滤器带来的收益最大。对同样在做检索增强生成的团队,这是一条可以直接试的启发式规则。
限制与需要注意的地方
最该记住的一条来自作者自己:这些结果大多在 2025 年完成,没有针对当前的前沿模型重新跑过。也就是说,胜率对比基准是当时的 Claude 版本,不是今天的。换到现在的模型上重跑,结论可能不同。
第二,人工研究规模很小——3 名研究者、14 个问题,样本量不足以支撑强结论,官方也没有把它当作主要证据。第三,评测集中在计算机科学研究问题这一域(SQABench-CS2),换到别的垂直领域,引用精度的表现需要重新验证。第四,也是工程上最容易踩的:开放权重模型的输出质量与推理配置强相关,官方给出的时延来自它自己的流水线,自建部署的耗时和显存占用都要自己测。第五,许可证还没写明,商用前务必先确认。
如何试用
三条路可以选。最简单的:直接用 Asta 产品里的 Fast 模式,感受一下 51 秒出一份带引用报告是什么体验。想自己跑的:从 Hugging Face 下载 allenai/AstaBrief_8B 权重,或者拉下那套训练数据与检查点做二次微调。想接进现有系统:参考 ai2-scholarqa-lib 的示例工作流,把它改成从你自己的 PDF 集合生成报告,再用 ai2-scholarqa-eval 的评测代码做回归。建议第一步先固定一份自己的评测问题集,把引用精度和引用召回当作主指标——这两项才是这类模型真正的价值点。
信息来源
- Hugging Face 博客:Open-sourcing AstaBrief, the fast report-generation model in Asta(Ai2,2026-10-02)https://huggingface.co/blog/allenai/astabrief
- 模型权重:https://huggingface.co/allenai/AstaBrief_8B
- 示例工作流与评测代码:ai2-scholarqa-lib、ai2-scholarqa-eval(GitHub)
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
