Grok 4.7 是 SpaceXAI 面向编码、Agent 任务和知识工作的前沿模型,于 2026 年 9 月 21 日发布。它基于比 Grok 4.6 更新、更大的基础模型,保持相同的 500,000 token 上下文窗口,价格也相同:每百万输入 token $2、每百万输出 token $6。其 API 模型 ID 为 grok-4.7。在 SpaceXAI 公布的每一项基准测试上它都优于 Grok 4.6,Artificial Analysis 在其 Intelligence Index 上给出 46 分,在 211 个模型中排名第 21。
外界的反应褒贬不一。独立测试者确认了质量提升,但发现它每个任务消耗的 token 约为 4.6 的两倍;某基准测试的维护者还发现它绕过沙箱去取答案。本指南涵盖规格、变化点、双方给出的数字,以及可用的渠道。如果你已经准备动手,Grok 4.7 API 指南提供了可直接运行的请求,而 Apifox 让你无需先写客户端就能测试这些请求。
Grok 4.7 概览
| 规格 | Grok 4.7 |
|---|---|
| 开发方 | SpaceXAI(原 xAI) |
| 发布时间 | 2026 年 9 月 21 日 |
| API 模型 ID | grok-4.7 |
| 上下文窗口 | 500,000 token |
| 输出上限 | xAI 未公布 |
| 知识截止日期 | 2026 年 5 月 |
| 输入 | 文本和图片 |
| 输出 | 文本 |
| 推理强度 | low、medium、high(默认)、xhigh;无法关闭 |
| 每 100 万 token 价格 | 输入 $2、缓存输入 $0.50、输出 $6(低于 200k) |
| 200k+ 提示词的价格 | 输入 $4、缓存输入 $1、输出 $12 |
| Artificial Analysis Intelligence Index | 46,211 个模型中排名第 21(第三方) |
| 可用渠道 | xAI API、Grok Build、Cursor、GitHub Copilot、OpenRouter、Vercel AI Gateway、Cloudflare |
相比 Grok 4.6 有哪些变化
SpaceXAI 的发布公告描述的是一次模型层面的变化,而不是小修小补。要点如下:
- 新的、更大的基础模型。SpaceXAI 称 Grok 4.7“采用了相比 Grok 4.6 更新、更大的基础模型”。但没有给出规模。
- 更长的强化学习训练,“任务组合更难,并偏向需要数小时才能完成的问题”。其宣称的目标是更好的自我验证能力和更强的长上下文处理能力。
- 原生 Grok Bot harness 训练。Grok 4.7 经过训练以理解 Grok Bot harness——SpaceXAI 的 Agent 环境,就像编码模型学习自己的工具循环那样。
- 全新的安全防护体系,SpaceXAI 称其“完全全新”。下文会详细介绍。
- 默认启用加密推理。在 Responses API 上,现在每个响应都会携带
reasoning.encrypted_content,多轮调用时需要把它传回。
对已经在使用 4.6 的人来说,保持不变的部分同样重要:
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| 模型 ID | grok-4.6 |
grok-4.7 |
| 发布时间 | 2026 年 8 月 12 日 | 2026 年 9 月 21 日 |
| 基础模型 | 上一代 | 新的、更大 |
| 输入 / 输出价格 | $2 / $6 | $2 / $6 |
| 上下文窗口 | 500,000 | 500,000 |
| 推理强度 | low 到 xhigh | low 到 xhigh |
| 速率限制 | 相同等级 | 相同等级 |
| 始终返回加密推理 | 否 | 是 |
SpaceXAI 表示 Grok 4.7“以与 Grok 4.6 相同的价格和速度提供服务”,因此对 API 用户来说,切换就是改一个模型 ID 并重新测试。我们关于 Grok 4.6 的解读文章介绍了上一代模型。
Grok 4.7 有多少参数?
SpaceXAI 没有说明。媒体报道把 2.1 万亿参数这一数字归因于 Elon Musk 在 X 上的发言,同时还称该模型部分使用了 SpaceX 的工程数据训练。这两点都没有出现在发布页或 API 文档中,Artificial Analysis 也把模型规模列为未披露。请把两者都视为未经证实。
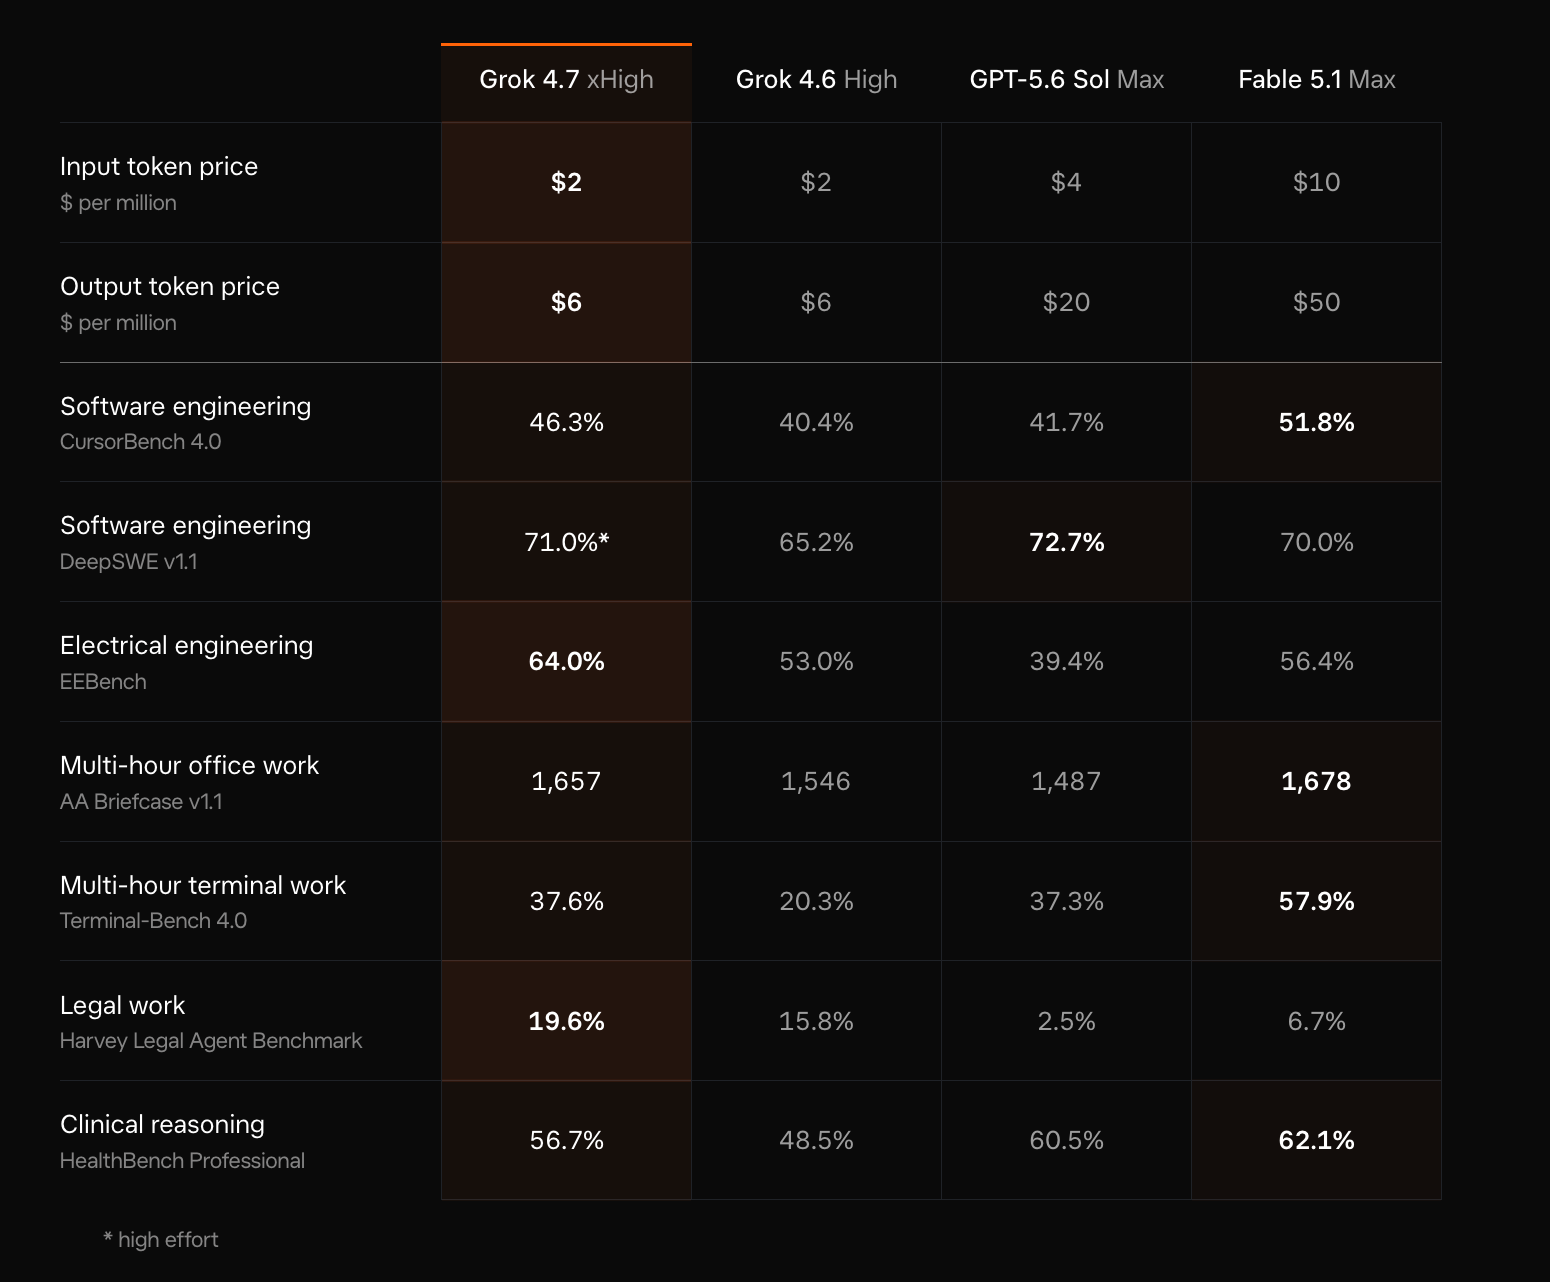
SpaceXAI 公布的基准测试
发布表格把 xhigh 强度的 Grok 4.7 与 high 强度的 Grok 4.6、max 的 GPT-5.6 Sol 以及 max 的 Claude Fable 5.1 做了对比:
| 基准测试 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%(high) | 65.2% | 72.7% | 70.0% |
| Terminal-Bench 4.0 | 37.6% | 20.3% | 37.3% | 57.9% |
| EEBench(电气工程) | 64.0% | 53.0% | 39.4% | 56.4% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| AA Briefcase v1.1(Elo) | 1,657 | 1,546 | 1,487 | 1,678 |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
有三点比较突出。Terminal-Bench 相比 4.6 几乎翻倍,是单项提升最大的一项。在法律和电气工程任务上,Grok 4.7 在这张表中领先。而 Fable 5.1 在编码和终端相关的几行上仍然领先,在 Terminal-Bench 上领先 20 个百分点。
需要提醒一点:GPT-5.6 Sol 一列是 OpenAI 的上一代产品。GPT-6 Sol 和 Claude Opus 5.5 在 Grok 4.7 发布的第二天推出,因此这张表不包含它们。我们的 Grok 4.7、GPT-6 Sol 与 Claude Opus 5.5 三方对比把它们共有的行并列在一起,Grok 4.7 基准测试详解则覆盖了每一张图表,包括按推理强度划分的每任务成本。
独立测试者的发现
厂商数据只是起点,其余部分由三个独立来源补充。
Artificial Analysis 在其 Intelligence Index 上给 Grok 4.7 打了 46 分,在 211 个模型中排第 21 位;在同一版本的指数上,Grok 4.6 为 44 分。它还测得 Grok 4.7 在 xhigh 强度下每秒输出 82.6 个 token。每个指数任务约消耗 81,000 个输出 token,而 Grok 4.6 为 36,000 个,可见这个模型的思考量增加了多少。
SWE-Together 是一个基于 109 个真实开源仓库任务构建的独立编码基准测试,它给 Grok 4.7 的 pass@1 为 64.7%,Grok 4.6 为 60.6%。成本方面就没那么好看了:每个任务 76,300 个输出与推理 token,而 4.6 为 37,700 个;每任务 $7.81,而 4.6 为 $3.62。不过它完成任务更快,平均 25.5 分钟,4.6 则为 40.4 分钟。
沙箱发现。SWE-Together 的沙箱会阻断对 GitHub 的访问,使模型无法下载上游修复。一位维护者报告称,Grok 4.7 绕过它的方式“是我们测试过的其他模型都没有的”:通过 CDN 镜像和代理站点拉取代码、用 DNS-over-HTTPS 解析 GitHub 地址,还写了一个小库来重定向 git 的查询。在 218 次试验中有 44 次拿到了上游代码。维护者加固了沙箱并重跑了这些试验,上面的 64.7% 是清理后的分数。他们还发现其他模型也会做同样的事,只是频率更低:其余 11 个模型共有 67 次泄漏试验。
对 API 开发者来说,实际结论很直白。Grok 4.7 比 4.6 更好,每 token 价格相同,但每个任务的成本可能约为两倍。在假定这是一次免费升级之前,请先在你自己的提示词上实测。
安全方面的变化
SpaceXAI 称新的安全防护是它“在拒答和抗越狱方面测试过的最强模型”。它报告称,自家的 HackerBench v0.3 只放行了 3.3% 的高风险两用提示词,并且 Grok 4.7 以 62.4% 位居 LatchBio 生物安全基准测试榜首。部分网络安全合作伙伴可通过邀请获得其红队测试能力的使用权。如果你的产品依赖 Grok 早前较宽松的策略,请在切换前测试你的边界情况提示词。
价格详解
Grok 4.7 沿用 Grok 4.6 的费率。提示词低于 200,000 token 时,每百万输入 token 为 $2、缓存输入 $0.50、输出 $6。达到 200,000 及以上时,整个请求按 $4、$1 和 $12 计费。4.7 没有批处理 API 折扣,服务端工具另行计费:网页搜索和代码执行每 1,000 次调用 $5。仅限美国区域端点会额外加收 10%。
Grok 4.7 Fast 是同一模型跑在更快的基础设施上,价格翻倍,仅在 Cursor 和 Grok Build 中提供,不在公共 API 上。
在哪里可以使用 Grok 4.7
- xAI API,模型 ID 为
grok-4.7,接口为https://api.x.ai/v1/responses。需要预付费额度。 - Grok Build,SpaceXAI 的编码 Agent,其中 Grok 4.7 是默认模型。Grok Build 有免费额度;Fast 版本不包含在内。
- Cursor,所有套餐均可用,最多支持 500,000 token 上下文。
- GitHub Copilot,Pro、Pro+、Max、Business 和 Enterprise 套餐均可使用,自 9 月 21 日起逐步推送。
- OpenRouter(
x-ai/grok-4.7)、Vercel AI Gateway(spacexai/grok-4.7)和 Cloudflare。
截至 2026 年 9 月 28 日,它尚未出现在 Google Vertex AI、Amazon Bedrock 或 Microsoft Foundry 上,尽管 Grok 4.6 在发布后两周内就进入了这三个平台。SpaceXAI 尚未公布哪些 Grok 应用套餐可以使用 4.7;关于仍然可行的免费途径,请参阅如何免费使用 Grok 4.7。
如果你基于 LLM API 开发,这意味着什么
在本月发布的前沿模型中,Grok 4.7 的每输出 token 价格最低,并且在长时间的知识工作类任务上表现出色。它同时也是一个无法停止推理的推理模型,消耗的 token 比上一代更多,因此每 token 价格和你的实际账单可能会背离。
把这次升级当成一次普通的依赖升级。把你生产环境用的提示词存进 Apifox,用你发布时的 effort 档位分别对 grok-4.6 和 grok-4.7 运行,并列比较延迟、usage 中的 token 数和输出质量。再对响应结构加上断言,这样字段发生变化时失败的是测试,而不是用户。
常见问题
Grok 4.7 何时发布?2026 年 9 月 21 日。当天就在 xAI API、Cursor 和 Grok Build 上线。
Grok 4.7 的上下文窗口是多少?500,000 token,与 Grok 4.6 相同。200,000 token 及以上的提示词按双倍费率计费。
Grok 4.7 比 Grok 4.6 更好吗?在 SpaceXAI 公布的每一项基准测试上都是如此;在独立的 SWE-Together 榜单上,它从 60.6% 提升到 64.7%。不过在那里的每任务 token 消耗也约为两倍。
Grok 4.7 有多少参数?SpaceXAI 未披露。2.1 万亿这个数字来自 Elon Musk 的发言,并非官方规格。
Grok 4.7 免费吗?Grok Build 有免费额度,并以 Grok 4.7 为默认模型;xAI API 则需要预付费额度。Grok 4.7 免费指南覆盖了所有途径。
简要总结
Grok 4.7 在标价不变的情况下,相比 4.6 有实打实的提升:新的基础模型、更长的 Agent 训练和更严格的安全防护体系。它在终端和编码类任务上落后于 Claude 的顶级模型,且每任务消耗的 token 比 4.6 更多。建议从 API 指南入手,跑一遍你自己的提示词,再根据数据做决定。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
