简要回答: Gemini Omni 1.2 Flash 是 Google 于 2026 年 11 月 5 日正式发布(GA)的视频生成与编辑模型。它支持生成 3 至 15 秒带原生音频的视频片段,720p 分辨率下每秒成本约为 $0.07,并通过 Interactions API 以模型 ID gemini-omni-1.2-flash 提供调用。自 2026 年 12 月 3 日起,发往 1.1 的请求将自动路由至该模型。
如果你已经在生产环境中接入了视频生成,最后这个日期尤为关键:原有的 1.1 代码可以继续运行,但在不到一个月后,实际响应请求的将换成新模型。
如果你刚开始接触这一系列,可以先了解 Gemini Omni 是什么;关于 1.1 版本的发布细节,可参考我们的 Omni 1.1 Flash 介绍文章。本文将围绕当前开发者的实际接入需求,解析 1.2 版本带来的变化。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Gemini Omni 1.2 Flash 能做什么
Gemini Omni 1.2 Flash 接收文本、图片和视频作为输入,并返回带声音的视频。它通过同一个 API 即可完成新视频生成、多轮对话式编辑以及视频延展(extension)。你可以按 1 秒为步长选择视频时长,并为每次请求单独设置分辨率。
Google 官方发布公告列出了五项值得关注的能力:
- 参考图遵循度(Reference adherence)。 支持传入角色、产品和风格参考图,在不同镜头角度下保持人脸、服装、包装和品牌配色一致。单次最多可传入 6 张参考图,最多支持 2 个角色、每个角色最多 3 张参考图。
- 画面一致性(Consistency)。 Google 表示角色、物体和场景从首帧到尾帧的稳定性更好,并支持首尾关键帧插值(keyframe interpolation)。
- 多轮编辑(Multi-turn editing)。 可在后续对话轮次中直接替换商品、更改天气或调整画面宽高比,无需从头重新生成。
- 语音表现(Speech)。 Google 宣称对白更加自然、口型同步(lip-sync)更清晰,并支持区分不同说话人的语音控制。
- 运镜控制(Camera control)。 支持第一视角(FPV)穿梭和环绕运镜,减少了非预期的跳切(jump cuts)。
上述画质提升均为 Google 官方表述,官方并未公布基准测试数据,建议将其作为实测方向,而非既定结论。
相比 Gemini Omni 1.1 Flash 有哪些变化
直接影响代码改动的有三点:单段视频时长上限、价格以及提示词语法。两代模型均运行在 Interactions API 上,因此迁移工作主要是修改模型名称字符串并重新验证效果。
| Omni 1.1 Flash | Omni 1.2 Flash | |
|---|---|---|
| 状态 | 上一代模型 | 正式版(GA) |
| 模型 ID | gemini-omni-1.1-flash |
gemini-omni-1.2-flash |
| 单次最长片段 | 10 秒 | 15 秒 |
| 视频输出价格 | $17.50 / 1M tokens | $12.00 / 1M tokens |
| 720p 每秒成本 | 约 $0.10 | 约 $0.07 |
| 输入价格 | $1.50 / 1M tokens | $1.50 / 1M tokens |
| 视频延展时传入参考图 | 不支持 | 最多 2 张(仅限 Agent Platform) |
| Gemini API 免费层级 | 不提供 | 不提供 |
15 秒时长上限存在几项例外限制:首尾帧插值模式仍保持在 3 至 10 秒,超出范围会返回无效参数错误(invalid argument);参考视频的数量上限也会随输出时长缩减——生成 3 至 10 秒视频时最多可传 3 段参考视频,而生成 11 至 15 秒视频时只能传 1 段,且每段参考视频最长不超过 3 秒。因此,如果界面上只有一个直通 15 秒的时长滑块,在关键帧模式下就会触发报错。
文档还提醒不要在提示词中继续使用 <FIRST_FRAME> 和 <IMAGE_REF_0> 等控制标签。Google 已将这些标签列为弃用(deprecated),且未来模型不再支持,建议改用自然语言直接描述每个输入素材的作用。
Gemini Omni 1.2 Flash 各分辨率定价
Omni 按输出 token 计费,Google 的定价页面将其折算成了每秒费率。720p 视频每秒对应 5,792 个 token。下表仅包含输出 token 成本,输入 token 会在此基础上增加少量费用。
| 分辨率 | 每秒成本 | 5 秒片段 | 15 秒片段 |
|---|---|---|---|
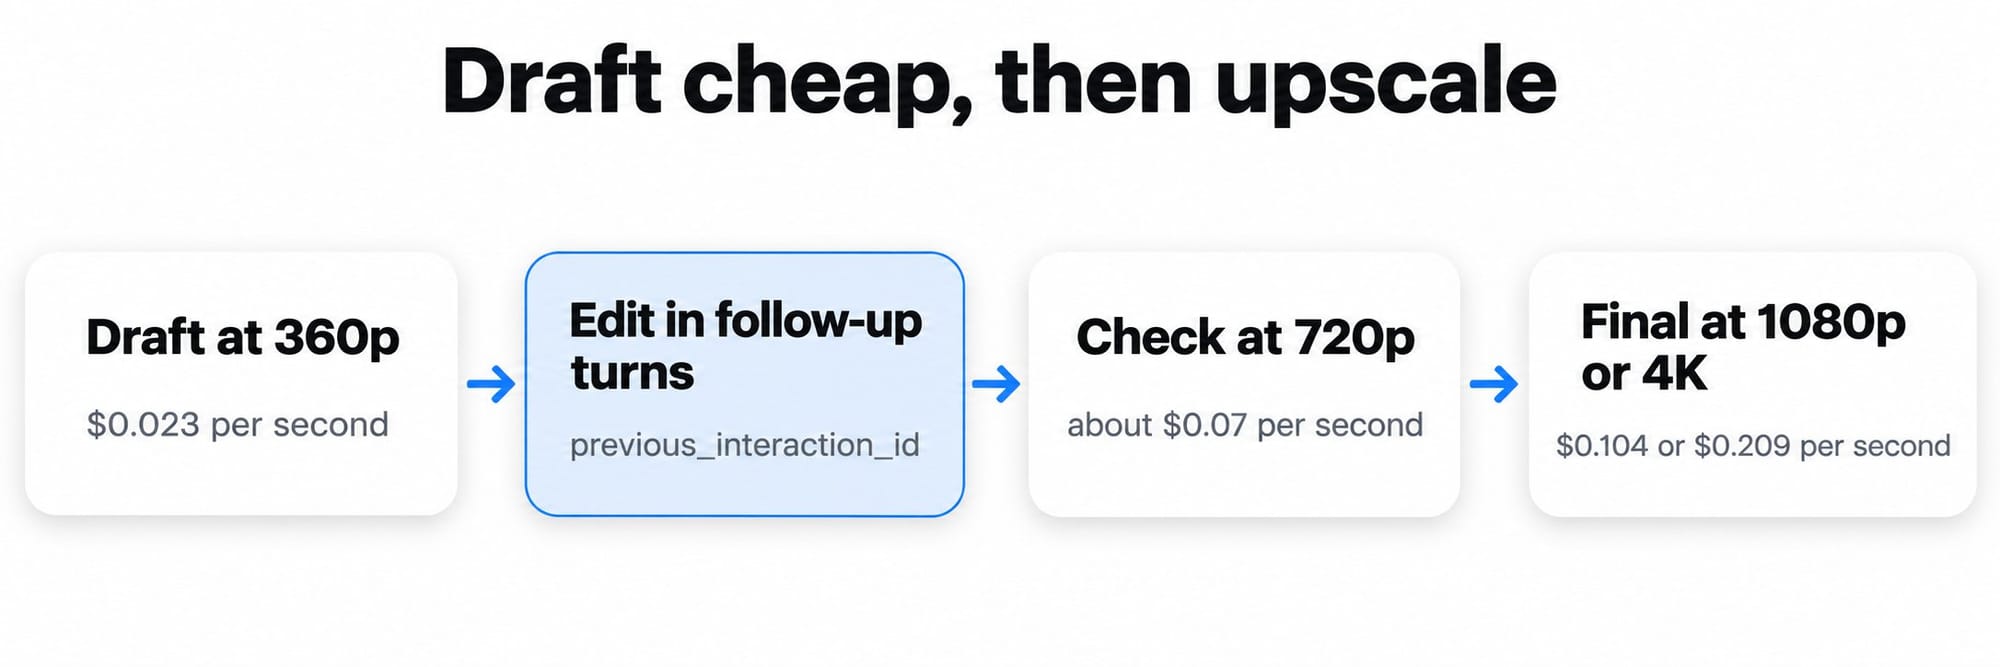
| 360p | $0.023 | $0.12 | $0.35 |
| 720p | 约 $0.07 | 约 $0.35 | 约 $1.04 |
| 1080p(上采样) | $0.104 | $0.52 | $1.56 |
| 4K(上采样) | $0.209 | $1.05 | $3.14 |
Google 推荐的工作流是:先在 360p 或 720p 下生成初稿,通过多轮对话编辑修复问题(而非每次从头生成),最后再升级到 1080p 或 4K。价格数据也印证了这一策略:生成 9 段 15 秒 360p 初稿的成本,大约只相当于渲染 1 段 15 秒 4K 成片。
预算规划时还需注意两点:第一,该模型目前未提供批处理(Batch)折扣定价;第二,我们尚未实测付费上采样(upscale)的计费细节,因此在将其纳入成本预算前,请先确认初稿升级到 1080p 或 4K 时的具体计费方式。如需了解更详细的 token 换算逻辑,可参考我们的 Omni 1.1 定价拆解文章并将单价替换为 $12.00。
可以通过哪些渠道调用 Gemini Omni 1.2 Flash
你可以通过两个 API 和四款 Google 应用使用该模型。面向开发者的接入方式包括:
- Gemini API。 使用 Google AI Studio 签发的 API Key 调用
POST https://generativelanguage.googleapis.com/v1beta/interactions。 - Vertex AI Studio 与 Gemini Enterprise Agent Platform。 使用 Google Cloud 项目和访问令牌调用全局
interactions端点。Google 的视频延展文档展示了完整的请求结构。
无需编写代码的应用端入口包括:
- Flow: 支持多轮场景编辑。
- Google Vids: 拥有 Google 账号或 Workspace 订阅即可生成 15 秒视频片段,无额外费用。
- Gemini 应用: 支持生成 15 秒视频,正逐步向 Google AI Ultra 订阅用户开放。
- Google Ads: 用于视频广告素材生成。
一个最简的 Gemini API 调用示例如下:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-omni-1.2-flash",
    "input": "A marble rolling fast along a chain reaction track, one smooth shot.",
    "response_format": {
      "type": "video",
      "duration": "3s",
      "resolution": "360p",
      "delivery": "uri"
    }
  }'
响应体是一个包含 id、status 和 steps 数组的 interaction 对象。生成的视频位于类型为 model_output 的步骤中,MIME 类型为 video/mp4。默认情况下,视频会以 base64 编码形式放在 data 字段中返回。对于超过 4MB 的视频,请设置 "delivery": "uri",随后轮询 Files API 直至文件状态变为 ACTIVE。注意一个容易踩坑的细节:即使创建请求时指定了返回 URI,后续对该 interaction 发起 GET 请求仍会返回内联的 base64 数据,因此请务必在创建响应中直接保存 URI。Omni 官方文档提供了 Python、JavaScript、Java、Go 和 REST 示例,我们的 Omni 1.1 API 指南也梳理了相同的请求流程。
如需编辑已生成的视频片段,只需在请求中传入 previous_interaction_id 和新的提示词。计划后续继续编辑的视频切勿将 store 设为 false,否则无法进行多轮追问。关于多次拼接延展的用法,可参考我们的视频延展指南;如果还在对比选型,可以阅读 Omni 1.2 Flash 与 Veo 对比。
12 月 3 日自动路由对你的应用意味着什么
自 2026 年 12 月 3 日起,Google 会将所有发往 gemini-omni-1.1-flash 的请求自动路由至 gemini-omni-1.2-flash,并按 1.2 的费率计费。接口不会报错中断,720p 视频每秒成本会下降约 30%,但处理现有提示词的底层模型已经发生了变化。
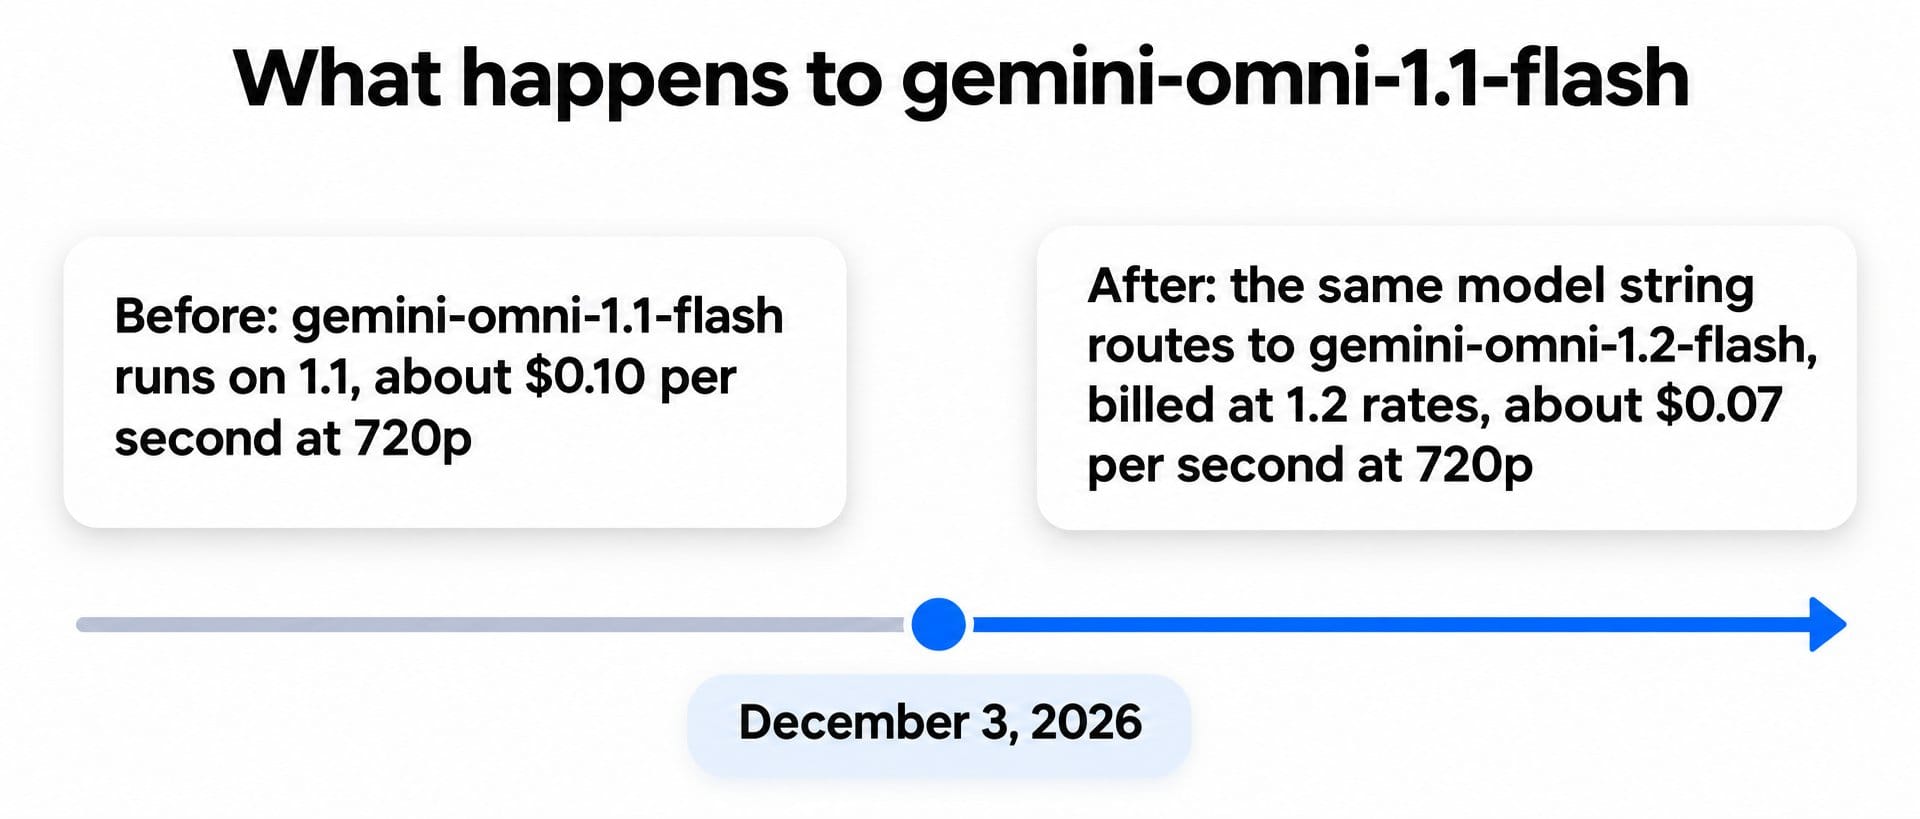
潜在风险在于这种静默切换可能改变生成效果,因此建议按自己的节奏提前迁移:
- 立即切换模型字符串。 自主选择测试与上线时间,而不是被动等待 Google 切流。
- 重新跑一遍存量提示词。 并排对比新旧生成结果,重点检查包含人物对白或品牌素材的场景。
- 更新成本估算逻辑。 代码或报表中写死的每秒 $0.10 费率在切换后将不再准确。
- 按模式限制时长上限。 普通生成模式可放开到 15 秒,关键帧插值模式则需限制在 10 秒以内。
- 移除旧版控制标签。 重写仍在使用
<IMAGE_REF_0>等格式标签的提示词。 - 长视频统一使用 URI 交付。 15 秒的视频输出很容易超过 4MB 的内联返回限制。
上述切流通知发布在 Gemini API 定价页面上。如果你通过 Agent Platform 调用,请查阅对应平台的模型页面以确认其排期。
Gemini Omni 1.2 Flash 仍存在的局限与文档矛盾
Google 明确指出了三个薄弱场景:高速体育运动、剧烈切换的剧本动作以及复杂物理规律。如果你的产品依赖这些场景,请优先针对相关提示词进行测试。
此外,官方文档还列出了几项硬性限制:
- 不支持提示词控制参数。 不支持系统指令(system instructions)、
temperature、top_p、停止序列(stop sequences)和负向提示词(negative prompt)字段,排除项需直接写进正文提示词中。 - 地区限制。 欧洲经济区(EEA)、瑞士和英国不支持对上传的视频进行编辑或延展。
- 仅支持向后追加。 视频延展只能在片段末尾续接,无法在开头插入或修改中间部分。
- 语言支持。 仅完整支持英语,Google 将其他语言标注为“未经测试(untested)”。
- 内容溯源水印。 所有输出视频均带有肉眼不可见的 SynthID 水印。
Google 自己的不同文档页面之间还存在三处不一致,请以你实际部署的调用入口为准进行实测:
- 延展后的总时长上限。 Gemini API 文档写的是总长最多 30 秒,而 Agent Platform 文档写的是最多 40 秒。
- 音频输入。 发布公告提到了可将音频提示(audio cues)作为参考输入,但 Gemini API 文档将音频输入列为不支持。
- 预置吞吐量(Provisioned Throughput)。 发布公告称已面向企业客户开放,但 Gemini API 文档将其列为不支持,预计该能力仅在企业端平台提供。
使用 Apifox CLI 让编程智能体测试接口
模型静默切流正是契约测试应当捕获的变更场景。你可以让编程智能体针对 Interactions API 编写测试用例并在终端执行,自己只需审阅测试结果。先完成 Apifox CLI 的一次性配置:
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_TOKEN>
apifox skill install
随后向 Claude Code、Codex 或 Cursor 提供一条提示词:
In Apifox project <id>, create an endpoint for POST /v1beta/interactions on
generativelanguage.googleapis.com, sending x-goog-api-key from {{GEMINI_API_KEY}}.
Add a test case that requests gemini-omni-1.2-flash at 3s, 360p, delivery uri.
Assert HTTP 200, object is "interaction", status is "completed", and steps holds
a model_output entry of type video with mime_type video/mp4 and a uri.
Run it and summarize any failures.
智能体会依次读取各项 schema、校验请求载荷、写入测试用例并执行运行:
apifox cli-schema get endpoint-create
apifox cli-schema validate endpoint-create --file omni.json
apifox endpoint create --project <id> --file omni.json
apifox test-case category --project <id>
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file case.json
apifox test-case create --project <id> --file case.json
apifox run --test-case <caseId> --project <id> -e <envId> \
  --env-var "GEMINI_API_KEY=$GEMINI_API_KEY" \
  --timeout-request 300000 -r cli,json
每次运行都会产生真实的视频生成费用,这条测试夹具单次成本约为 $0.07,因此建议配置为每晚定时运行,而非每次提交代码都触发。为了提前验证切流影响,可以让智能体克隆一份使用 1.1 模型字符串的测试用例,在 12 月 3 日前同时运行两条用例进行对比。同样的 apifox run 命令加上 -r junit 参数即可直接接入流水线,详见我们的 Apifox CLI CI/CD 指南;关于智能体侧的配置可参考在 Claude Code 中使用 Apifox CLI。
常见问题
Gemini Omni 1.2 Flash 免费吗? API 调用不免费。Google 在 Gemini API 定价页中将该模型的输入和输出免费层级均列为“不提供(Not available)”。不过拥有 Google 账号或 Workspace 订阅的用户可以在 Google Vids 中免费生成 15 秒视频片段。
模型 ID 是什么? gemini-omni-1.2-flash,需通过 Interactions API 而非 generateContent 调用。
Gemini Omni 1.2 Flash 生成的视频最长多少秒? 单次生成支持 3 至 15 秒(以 1 秒为步长,默认 10 秒)。视频延展每次可追加 3 至 10 秒。延展后的总时长上限在 Gemini API 文档中为 30 秒,在 Agent Platform 文档中最高可达 40 秒。
12 月 3 日我的 Omni 1.1 代码会怎样? 代码会继续正常运行。发往 gemini-omni-1.1-flash 的请求会自动路由到 gemini-omni-1.2-flash 并按 1.2 费率计费,建议在此日期前重新测试现有提示词。
Gemini Omni 1.2 Flash 会生成音频吗? 会,生成的视频片段自带原生音频。但你无法通过 Gemini API 上传音频文件作为输入,参考视频中的音轨也会被忽略。
官方有公布 1.2 对比 1.1 的基准测试吗? 没有。Google 未发布任何对比跑分,建议在 12 月 3 日前用自己的业务提示词在两个版本上实测对比。