Claude Sonnet 5.5 是 Anthropic 的中端模型,于 2026 年 9 月 28 日发布,API id 为 claude-sonnet-5-5。它每百万输入 token 收费 $2、每百万输出 token 收费 $10,与 Sonnet 5 相同。在发布公告中,Anthropic 称它比 Sonnet 5“快 30% 以上”,并且在其自己的测试中“每个任务的成本比上一代低至多 30%”。它是 Claude 5.5 家族的第二款模型:作为 Opus 5.5($4/$20)更便宜的补充,并高于 Haiku 4.5。
下面依次介绍:规格、模型阵容、与 Sonnet 5 的差异、基准测试、可以在哪里运行,以及谁应该切换,并附上价格明细等深度指南的链接。想在阅读时顺手调用模型,Apifox 可以发送 Messages 请求、把密钥保存在环境变量中,并同时展示响应和 token 用量。
Claude Sonnet 5.5 规格一览
| 规格 | Claude Sonnet 5.5 |
|---|---|
| 发布日期 | 2026 年 9 月 28 日 |
| 模型 id(Claude API、Google Cloud、Microsoft Foundry、Claude Platform on AWS) | claude-sonnet-5-5 |
| 模型 id(Amazon Bedrock) | anthropic.claude-sonnet-5-5 |
| 上下文窗口 | 100 万 token |
| 最大输出 | 128K;在批处理 API 上配合 output-300k-2026-03-24 beta 可达 300K |
| 思考 | 自适应,默认开启 |
| 默认 effort | Claude Platform 上为 high;Claude Code 和 Claude 应用中为 medium |
| 知识截止日期 | 2026 年 6 月 |
| 退役 | 不早于 2027 年 9 月 28 日 |
| 每 MTok 价格 | 输入 $2,输出 $10,缓存读取 $0.20,缓存写入 $2.50(5 分钟)或 $4(1 小时);批处理 $1 / $5 |
来源:Sonnet 5.5 模型概览与Claude 价格页。
没有长上下文溢价:90 万 token 的请求与 9K token 的请求每 token 价格相同。Fast 模式不可用,仅 Opus 提供。仅限美国境内推理(inference_geo: "us")的费用为 1.1 倍。Sonnet 5 原定于 9 月 1 日涨到 $3/$15 的计划已取消,因此 $2/$10 就是 Sonnet 的标准价格。
Sonnet 5.5 在 Claude 产品线中的位置
| 模型 | 每 MTok 输入 / 输出 | 上下文 / 最大输出 | Claude 免费版可用? | 定位 |
|---|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | 1M / 128K | 否 | 高难度推理、长周期 agentic 工作 |
| Claude Opus 5.5 | $4 / $20 | 1M / 128K | 否 | 复杂、开放式的工作 |
| Claude Sonnet 5.5 | $2 / $10 | 1M / 128K | 是(对话) | 范围明确的日常工作 |
| Claude Haiku 4.5 | $1 / $5 | 200K / 64K | 是 | 成本最低的一档 |
Anthropic 将 Sonnet 5.5 定位为适合范围明确的日常任务、bug 修复,以及打磨文档、幻灯片和电子表格,并称 Opus 5.5“在复杂、开放式工作上依然明显更强”。Haiku 5.5 预计“在未来几周内”推出。想了解更高一档,请阅读什么是 Claude Opus 5.5。
与 Sonnet 5 相比有哪些新变化
价格和 tokenizer 未变,但 API 契约变了。迁移指南列出了五项破坏性变更:
thinking: {"type": "disabled"}已被移除。请改用{"type": "between_tools"},它仅在low、medium或higheffort 下被接受。- 强制工具调用被移除。
tool_choice为any或tool会报错。请发送auto并配合strict: true的工具,同时在提示词中说明何时使用它们。 - 思考块与对话绑定。对于 2026-08-31 及之后创建的账号,在修改较早历史之后再重放思考块会失败。请让对话保持只追加、不回改。
computer_20251124会被拒绝,在 Claude API 和 Google Cloud 上均如此。请使用computer_toolset_20260801。- Advisor 配对受到限制,仅限 Opus 5、Opus 5.5、Sonnet 5.5、Fable 5、Fable 5.1、Mythos 5 或 Mythos 5.1。
第六项变更不会导致失败,但会改变响应结构:工具调用之间的文本现在以进度更新形式的 thinking 块返回,在默认的 display: "omitted" 下为空,因此你的界面可能在任务中途变得安静。设置 display: "updates"(beta header thinking-display-updates-2026-08-18)或 "summarized" 即可看到它们。
其他新增内容:
- 重新校准的 effort。不要照搬 Sonnet 5 的设置。从
high开始(如果是描述明确的 agentic 编码任务,可用medium),然后重新做一轮扫描。 - 网络安全防护。它是首个带此类防护的 Sonnet:在 Anthropic 的应用中,风险较高的网络安全任务“会明显回退到 Sonnet 5”;在 API 上回退需要主动开启(
fallbacks: "default",beta)。 - 思考与账号绑定。思考内容无法跨账号迁移;如果你在 Claude Code 中途切换账号,这一点会有影响。
- 按消息设置 effort。在两次请求之间更改顶层 effort 会使提示词缓存失效;beta 版的按消息设置 effort 可以避免这一点。
- 更低的缓存下限。可缓存的最小提示词为 512 token,此前为 1,024。
Sonnet 5.5 对比 Sonnet 5 指南列出了每项修复对应的具体报错,以及修改前后的 JSON。
Claude Sonnet 5.5 基准测试
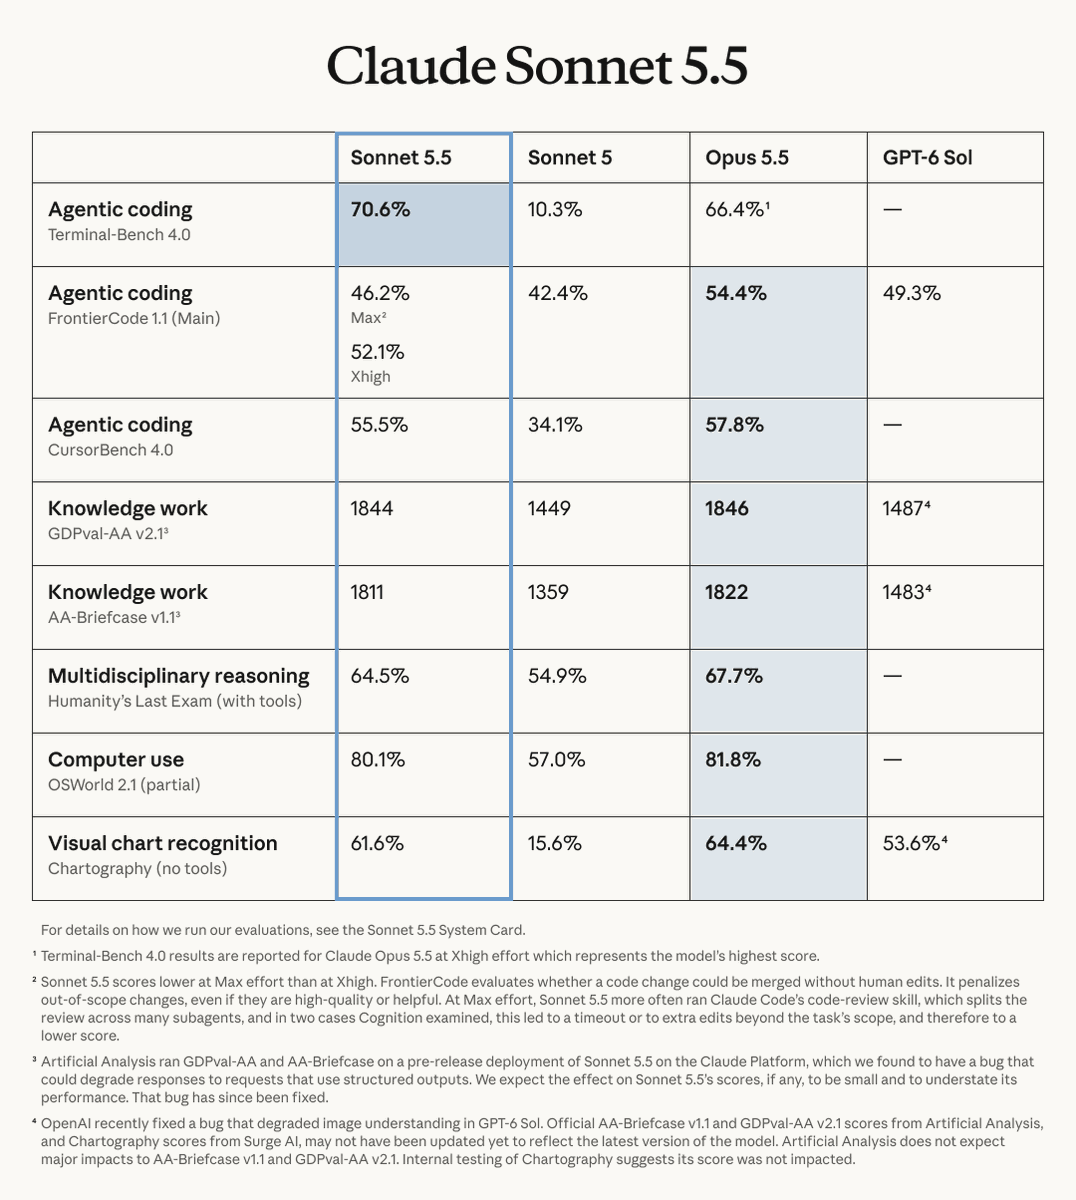
发布表格将 Sonnet 5.5 与 Sonnet 5、Opus 5.5 和 GPT-6 Sol 对比。除非某行另有说明,Sonnet 5.5 均在 max effort 下运行。
| 基准测试 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4%(xhigh) | n/r |
| FrontierCode 1.1 Main(max) | 46.2% | 42.4% | 54.4% | 49.3% |
| FrontierCode 1.1 Main(xhigh) | 52.1% | 42.7% | 51.4% | 48.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | n/r |
| GDPval-AA v2.1(Elo) | 1844 | 1449 | 1846 | 1487 |
| Humanity’s Last Exam(带工具) | 64.5% | 54.9% | 67.7% | n/r |
| OSWorld 2.1(部分) | 80.1% | 57.0% | 81.8% | n/r |
n/r:未公布。xhigh 的 FrontierCode 行来自发布页的分 effort 图表。
Terminal-Bench、Humanity’s Last Exam 和 OSWorld 由 Anthropic 自己运行。FrontierCode 由 Cognition 运行,在该测试中 Sonnet 5.5 在 max 下得分反而更低:它更频繁地展开评审子代理,而在 Cognition 检查的案例中,这导致了超时或范围外的编辑。CursorBench 由 Cursor 运行,GDPval-AA 由 Artificial Analysis 运行。对 Sonnet 在 Terminal-Bench 上领先 Opus 的结论要谨慎解读:Artificial Analysis 在自己的运行中测得 Sonnet 5.5 为 63.6%,而系统卡显示回退影响了 10% 的 Opus 试验,Sonnet 仅为 1.5%。
Sonnet 5.5 在 Artificial Analysis 智能指数上得分为 56,在 216 个模型中排第 3,仅次于两个 Opus 5.5 接口(Sonnet 5 得分为 38)。问题在于冗长:该指数在 max effort 下跑完要花 $8,977,而 high 下为 $1,176。基准测试深度分析中有各 effort 档位的表格。
在哪里可以使用 Claude Sonnet 5.5
| 平台 | 访问方式 | 说明 |
|---|---|---|
| Claude API | claude-sonnet-5-5 |
预付费额度 |
| Amazon Bedrock | anthropic.claude-sonnet-5-5 |
仅支持全球跨区域推理(商业区域);不支持 strict 工具 |
| Google Cloud、Microsoft Foundry、Claude Platform on AWS | claude-sonnet-5-5 |
与 Claude API 相同的 id |
| Claude.ai(Web、iOS、Android) | 对话 | 所有人,包括免费版 |
| Claude Code | claude --model claude-sonnet-5-5 |
付费方案,v2.1.284+;默认仍为 Opus 5.5 |
| GitHub Copilot | VS Code、JetBrains、Copilot CLI 等 | Pro、Pro+、Max、Business、Enterprise |
| Cursor | claude-sonnet-5-5 |
Other Models 池(Pro 及以上) |
| OpenRouter、Vercel AI Gateway | anthropic/claude-sonnet-5.5 |
$2 / $10;没有免费版本 |
在 Claude Code 中,sonnet 别名只在 Anthropic API 上指向 Sonnet 5.5;在 Bedrock、Google Cloud 和 Foundry 上它仍然解析为 Sonnet 4.5,因此请固定使用完整 id。方案和 effort 请参见 Sonnet 5.5 in Claude Code。GitHub 的Copilot 更新日志称此次推送是逐步进行的。
任何人都可以在 Claude 免费版方案上与 Sonnet 5.5 对话,但对话方案不包含 API 密钥,而且 API 使用需要预付费。请参阅如何免费使用 Sonnet 5.5,以及是否存在免费的 Sonnet 5.5 API。
谁应该切换到 Sonnet 5.5
- 你在用 Sonnet 5:换。价格和 tokenizer 一致,而且 Sonnet 5.5 在发布表格的每一行都优于 Sonnet 5。请预留时间处理破坏性变更并做一轮 effort 扫描。
- 你把 Opus 5.5 用于所有场景:把范围明确的工作(bug 修复、文档、简单代码评审、子代理任务)以一半的标价交给 Sonnet 5.5,把 Opus 留给开放式问题。Sonnet 5.5 对比 Opus 5.5 按工作负载做了拆解。
- 你打算在 high 或更高 effort 下运行:也测一下更低 effort 下的 Opus 5.5。在 Terminal-Bench 4.0 上,Sonnet 5.5 在 high 下得分 43.0%,每次尝试 $1.94;Opus 5.5 在 medium 下得分 57.6%,每次 $2.94。Sonnet 在 max 下的 70.6% 每次尝试要花 $12.54。许多 Hacker News 评论者正是这样解读这些图表的:Sonnet 的定位在 low 或 medium effort,或作为 Opus 编排器下的子代理工作。
- 你的工作涉及大量安全内容:Anthropic 警告称“即便是在良性的网络安全相关任务上”,拒绝率也会上升。
早期客户反馈
以下是 Anthropic 发布页上的客户说法,并非独立测试:
- Slack:在几乎所有离线 Slackbot 评测中它都优于 Sonnet 5,无需修改提示词,且输出 token 减少约 14%。
- Base44:在 118 次应用构建中,它达到了 Opus 5 的质量,每次构建迭代 3.6 次,而 Opus 5 为 7.7 次。
- Balyasny Asset Management:在 2,441 个金融任务上,它每个答案约消耗 121K token,而 Sonnet 5 为 497K。
发送你的第一个 Sonnet 5.5 请求
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [
      {"role": "user", "content": "List three risks of retrying a POST request without an idempotency key."}
    ]
  }'
思考默认开启,因此可以跳过 thinking 字段。不要传 temperature、top_p 和 top_k:非默认值会返回 400。拒绝会以 HTTP 200 返回,并带有 stop_reason: "refusal" 和 stop_details 类别,因此要检查响应体,而不能只看状态码。
在 Apifox 中,把 curl 命令粘贴到新建的请求里,把密钥移入 ANTHROPIC_API_KEY 环境变量,并断言 stop_reason 不是 refusal 或 max_tokens。在 low 和 high effort 下各复制一份,用来对比 usage。Sonnet 5.5 API 指南涵盖流式、工具和缓存;如果你需要密钥,我们的 Anthropic API 密钥指南会有所帮助。
常见问题
Claude Sonnet 5.5 是什么时候发布的?2026 年 9 月 28 日,比 Opus 5.5 晚六天。
Claude Sonnet 5.5 的上下文窗口有多大?100 万 token,最大输出 128K(在批处理 API 上配合 beta header 可达 300K)。长提示词与短提示词的每 token 价格相同。
Claude Sonnet 5.5 免费吗?在 Claude.ai 对话应用中免费,包括免费版方案。API 需要预付费,Claude Code 则需要付费方案。请查看所有免费途径。
Claude Sonnet 5.5 的知识截止日期是什么时候?2026 年 6 月。
Sonnet 5.5 是 Claude Code 的默认模型吗?不是。在所有付费方案中默认仍为 Opus 5.5。可用 /model 或 claude --model claude-sonnet-5-5 切换。
下一步
挑一个你现在跑在 Sonnet 5 或 Opus 5.5 上的任务,把它以 claude-sonnet-5-5 发给 low、medium 和 high 三档,比较质量与 usage,然后保留能通过你校验的最便宜档位。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
