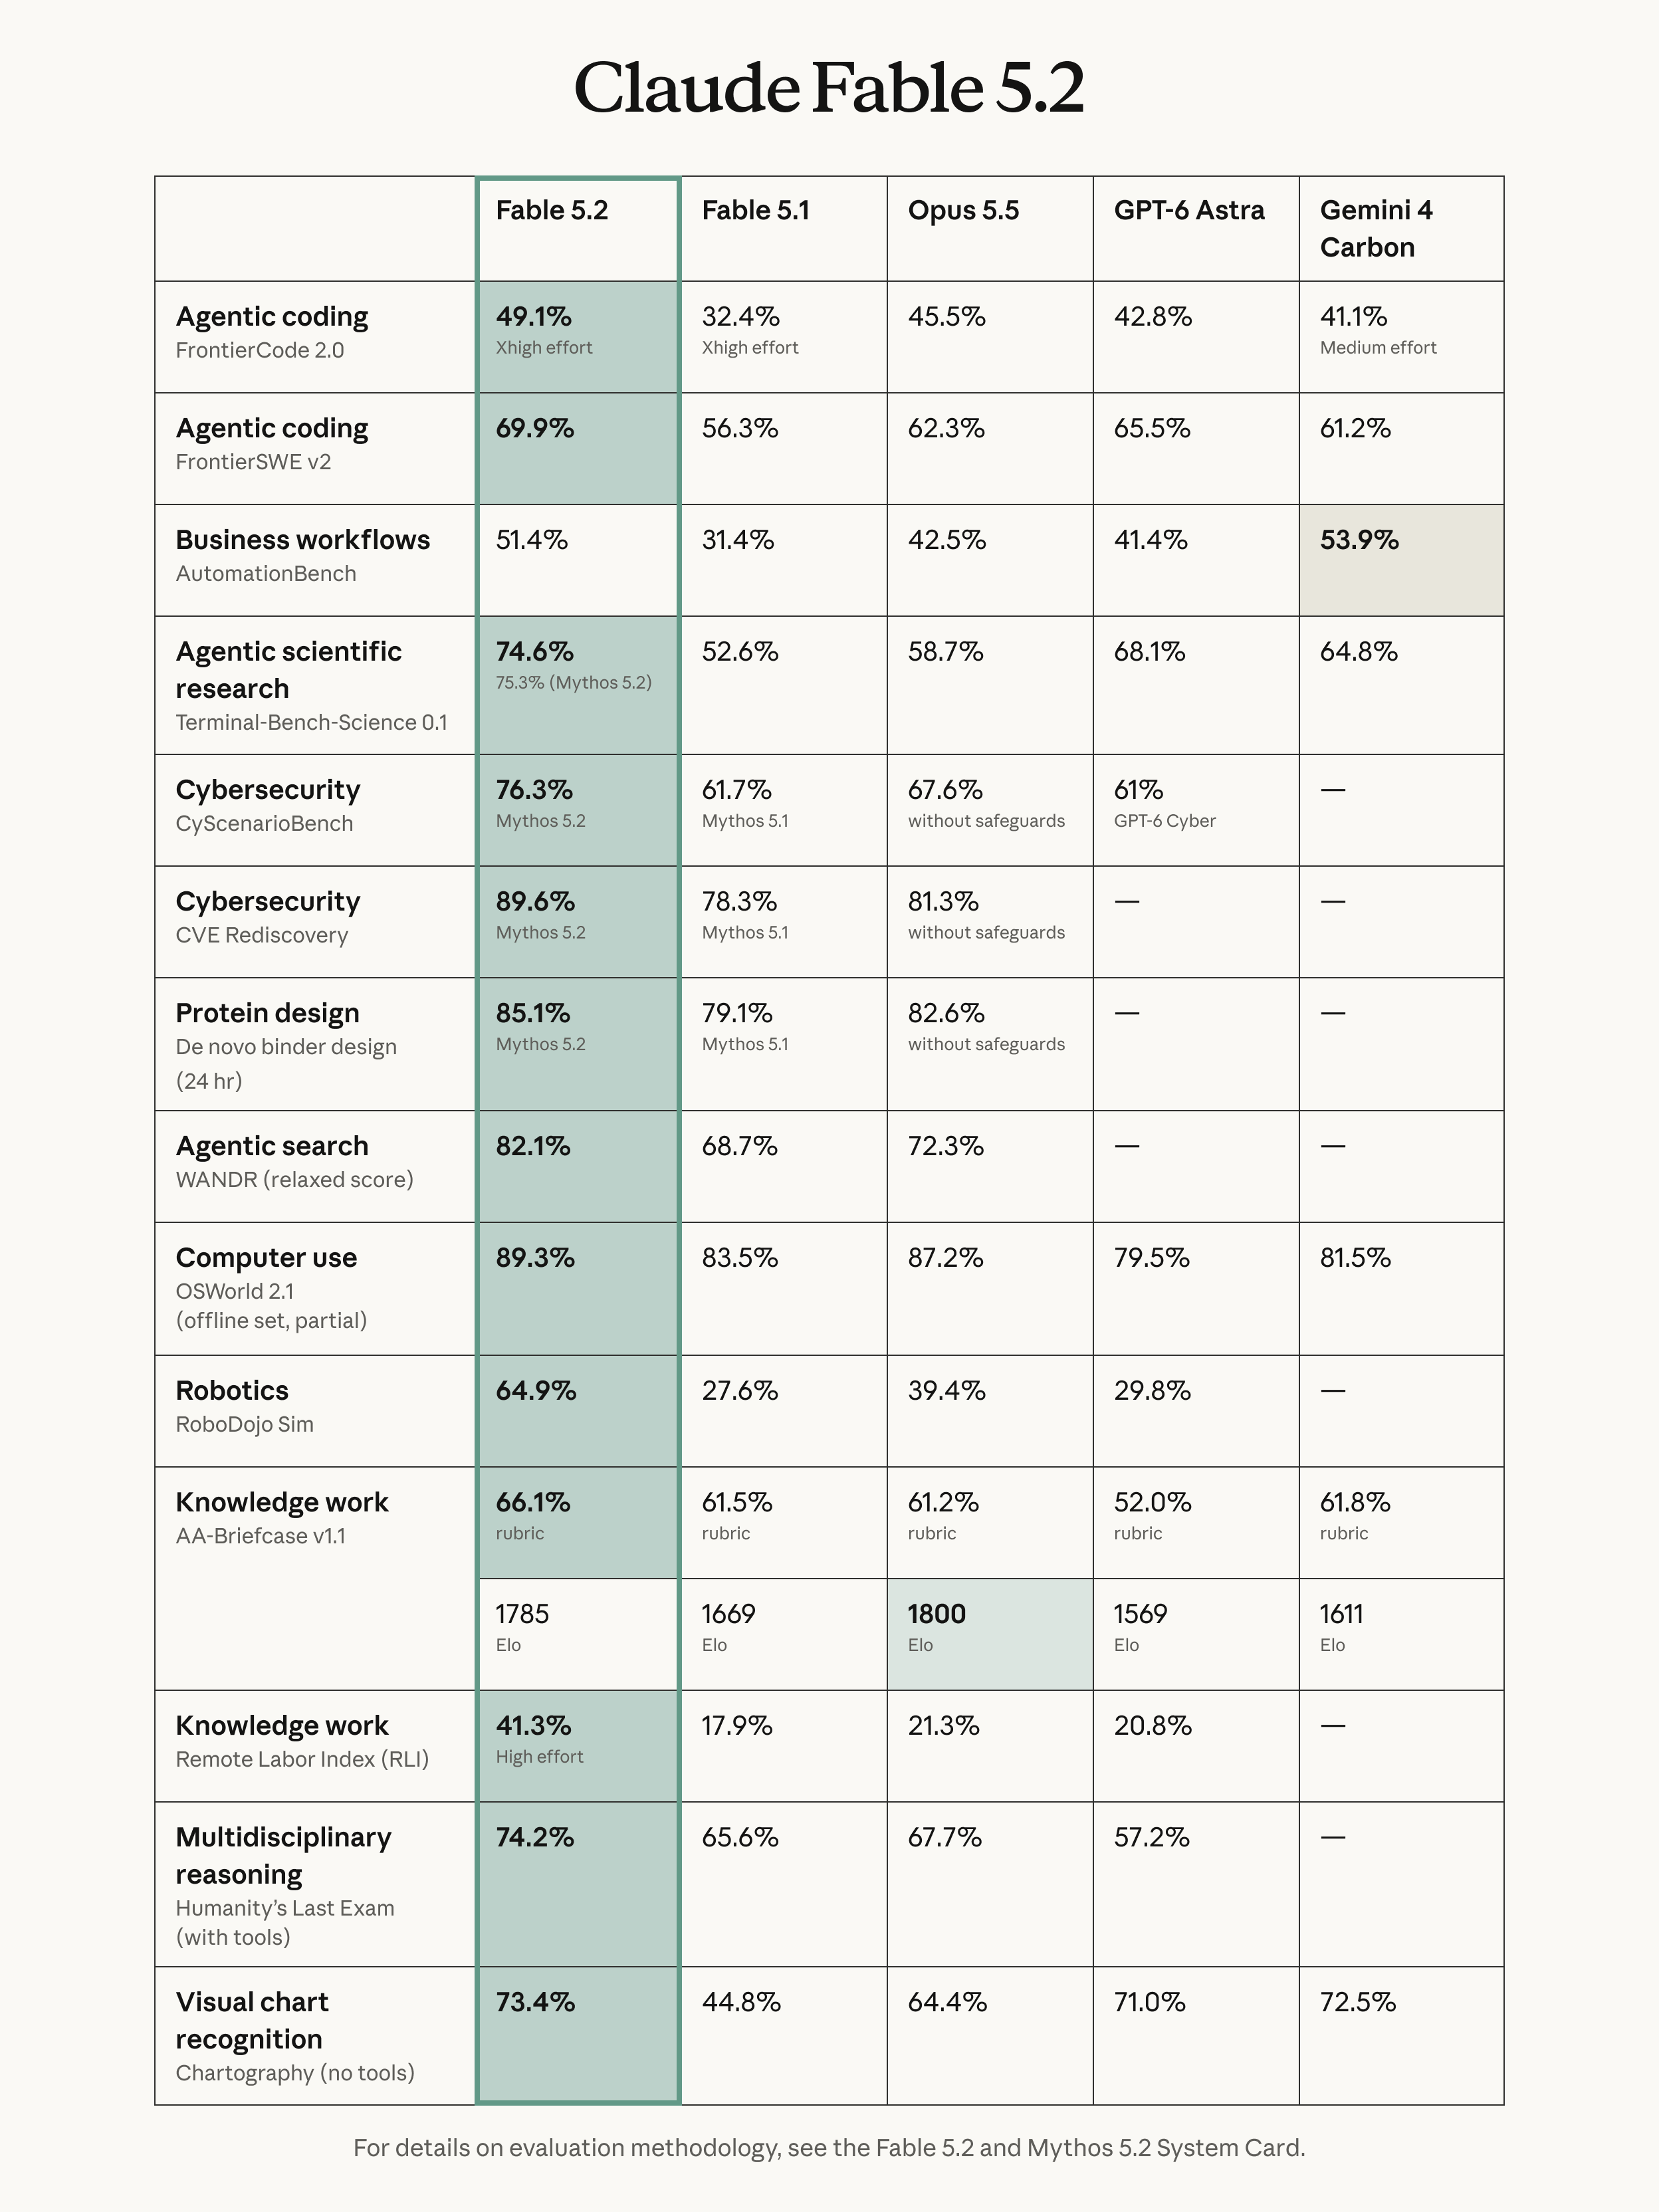
要测试 Claude Fable 5.2 API 集成,应验证身份验证、Messages 请求体、带类型的内容块和可预期的失败。然后把这些检查保存为可重复的 Apifox 测试用例,让编码 Agent 通过 CLI 运行。把传输层断言与任务质量检查分开,这样 HTTP 成功响应就无法掩盖不可用的回答。
Anthropic 的公告将 claude-fable-5-2 标识为 Claude Platform 的模型 ID。本指南围绕该模型构建回归工作流,而不是在一次成功响应后就结束。Apifox 为 Agent 提供一个共享位置,用来维护端点、测试用例和运行报告。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Claude Fable 5.2 API 测试应覆盖什么?
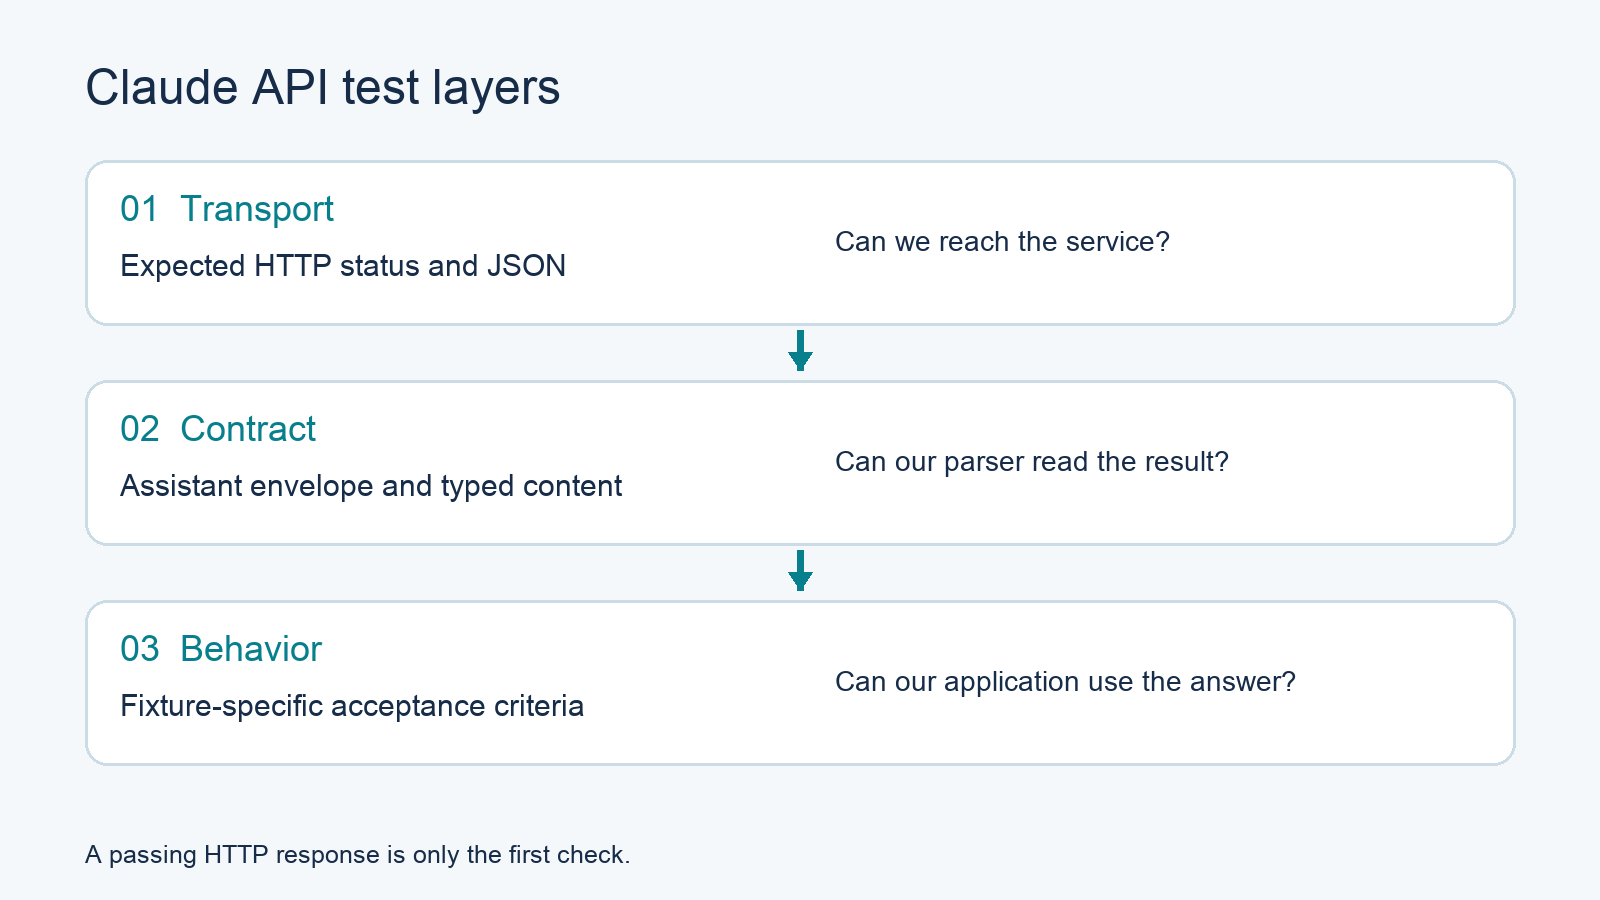
使用三个层次:传输检查确认请求是否到达服务;契约检查验证响应结构;行为检查确认你的应用能否使用结果。每个 fixture 都要运行前两层。为每个任务定义行为验收标准,而不是逐字节比较整个生成答案。
| 层次 | 断言示例 | 失败意味着 |
|---|---|---|
| 传输 | 预期状态码和 JSON 响应 | 凭据、网络或服务问题 |
| 契约 | 包含带类型内容块的助手消息 | 解析器或 API 契约不匹配 |
| 行为 | 提取文本中的正确算术结果 | 输出不满足该 fixture |
从一个极小、无害的 fixture 开始:“What is 2 + 2? Reply with the numeral only.” 它让验收规则清晰可见,又不引入文件、工具或对话历史。基础契约跑通后,再加入有代表性的应用 fixture。
不要把该 fixture 当作推理基准。它的目的是发现集成回归,例如把思考块提取成面向用户的文本,或接受被截断的响应。
测试前先固定身份验证和请求设置
对于 Claude API 直连,使用 Messages 端点、工作区范围的 API 凭据、显式的 API 版本和固定的请求体。让这些输入在多次运行之间保持不变。API 概览记录了 Bearer 身份验证、工作区选择和版本头。这些设置与云提供商的 IAM 身份验证不同。
使用通过本地密钥环境提供的 Claude Console API 密钥。Apifox 访问令牌用于让 CLI 通过 Apifox 的身份验证,不能用它向 Anthropic 验证请求。两种凭据要分开。
下面的请求遵循 2026 年 11 月 10 日核对的当前 Messages 文档。把 JSON 保存为 request.json:
{
  "model": "claude-fable-5-2",
  "max_tokens": 1024,
  "stream": false,
  "thinking": { "type": "adaptive" },
  "messages": [
    {
      "role": "user",
      "content": "What is 2 + 2? Reply with the numeral only."
    }
  ]
}
然后从终端发送,或让编码 Agent 执行:
curl https://api.anthropic.com/v1/messages \
  -H "Authorization: Bearer $ANTHROPIC_API_KEY" \
  -H 'anthropic-version: 2026-10-21' \
  -H 'Content-Type: application/json' \
  --max-time 600 \
  --dump-header response.headers \
  --output response.json \
  --write-out '%{http_code}\n' \
  --data-binary @request.json
如果你的密钥不是工作区范围的,请为目标工作区加上文档中的 anthropic-workspace-id 头。永远不要把字面凭据放进保存的 fixture 或生成的报告。
创建 Message 参考定义了 model、messages 和 max_tokens,以及返回的消息字段。这里的 1,024 是选定的输出预算,不是文档规定的最低值,也不保证每个任务都能装下。当 fixture 需要更多空间时,再有意识地调高。
这是一个经文档核对的模板。在记录通过的基线之前,请用你自己的授权 API 账户运行它;本文没有声称真实 Fable 响应或延迟测量结果。
添加能容忍生成变化的响应断言
先断言响应信封,再检查块类型、提取文本,最后应用 fixture 的验收规则。Messages 响应包含 content 数组,所以不要假设 content[0].text 就是答案。如果应用要在后续对话轮次中回传完整消息,请单独保留原始消息。
对于算术 fixture,让 Agent 把下面的响应后脚本附加到 Apifox 测试用例:
pm.test("HTTP success", function () {
  pm.response.to.have.status(200);
});

const body = pm.response.json();

pm.test("Assistant message contract", function () {
  pm.expect(body.type).to.eql("message");
  pm.expect(body.role).to.eql("assistant");
  pm.expect(body.id).to.be.a("string");
  pm.expect(body.model).to.be.a("string");
  pm.expect(body.content).to.be.an("array");
});

const text = body.content
  .filter(block => block.type === "text")
  .map(block => block.text)
  .join("\n").trim();

pm.test("Arithmetic fixture is complete", function () {
  pm.expect(body.stop_reason).to.eql("end_turn");
  pm.expect(text).to.eql("4");
});
对于这个刻意受限的数字,精确相等是合理的。对于摘要,应使用必需事实、禁止的无依据声明和长度边界等标准。无害的措辞变化不应破坏有用的摘要测试。
记录 usage 和响应的 request-id 头以便诊断。将返回的模型标识符与你所选标识符的文档行为进行比较;不要静默地把降级响应重新标记为 Fable 结果。
max_tokens 停止原因意味着回答触达了输出上限。让这个算术 fixture 失败,并检查 token 预算。其他任务可能合法地返回不同的停止原因,包括工具请求,所以每个用例都应有自己的完成规则。
测试 Claude Fable 5.2 API 的负向用例
为每个无效输入创建单独用例,一次只改一个字段。检查 HTTP 状态码和结构化错误类型,而不是匹配完整的可读错误消息。保持有效基线不变,避免负向 fixture 污染下一次正向运行。
官方错误指南记录了以下有用用例:
| 用例 | 相对基线的改动 | 预期结果 |
|---|---|---|
| 无效身份验证 | 把 Bearer 凭据替换为假值 | 401,authentication_error |
| 禁用思考 | 把 thinking.type 设为 disabled |
400,invalid_request_error |
| 旧版扩展思考 | 把 thinking.type 设为 enabled |
400,invalid_request_error |
| 助手预填 | 用助手预填结束对话 | 400,invalid_request_error |
Fable 5.2 使用始终开启的思考。不要照抄关闭思考或配置扩展思考预算的旧 Claude 教程。升级共享的请求构建代码时,禁用思考用例尤其有用。
每个错误用例都要断言 body.type === "error"、预期的 body.error.type 和非空错误消息。有请求 ID 时保留它。把 DNS 失败和客户端超时视为单独结果,因为它们可能根本不会产生 Claude JSON 错误。
用受控 fixture 或 mock 测试应用对速率限制和服务故障的处理。不要为了制造 429 而洪泛真实 API。区分可重试的容量问题与身份验证、验证失败,并围绕应用的重试逻辑设置有限的重试预算。
让编码 Agent 构建 Apifox 回归用例
把端点、fixture、断言和目标项目交给 Agent。它可以读取当前 CLI schema、校验每个 payload、创建测试用例并运行。你负责审查生成的用例和失败摘要。这样可重复的工作流就留在 Apifox 中。
Apifox CLI 2.2.12 提供完整的测试用例写入与运行命令。安装并登录后,先获取测试用例分组 ID,再按当前 schema 生成和校验 payload,最后创建并运行用例:
npm i -g apifox-cli@latest --registry=https://registry.npmmirror.com/
apifox auth login --with-token "$APIFOX_ACCESS_TOKEN"
apifox test-case category --project <PROJECT_ID>
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file ./case.json
apifox test-case create --project <PROJECT_ID> --file ./case.json
apifox test-case run <CASE_ID> --project <PROJECT_ID> -e <ENVIRONMENT_ID> -r cli,json --out-dir ./apifox-reports
categoryId 是测试用例在客户端显示的必填字段:把 apifox test-case category 返回的分组 ID 写进 case.json,否则用例可能创建成功,却在客户端分类里看不到。Anthropic 凭据放在私有运行时变量中,不要写进 case.json。在 Apifox 项目中定义 Claude API 的 POST /v1/messages,创建算术成功用例和上面的四个负向用例。
可以给 Agent 这样的提示:
In Apifox project <PROJECT_ID>, define POST /v1/messages for the
Claude API. Use model claude-fable-5-2 and version 2026-10-21.
Keep the Anthropic credential in a private runtime variable.
Create the arithmetic success case and four negative cases above.
Read CLI help and input schemas before generating payloads.
Discover valid endpoint and category IDs; validate every payload.
Attach the response assertions, then run each case against
<ENVIRONMENT_ID>. Report failures, request IDs, and token usage.
Do not print credentials or claim unexecuted cases passed.
Agent 需要真实的端点 ID 和分类 ID;测试用例由端点派生,因此创建一个无关的独立 JSON 请求是不够的。当端点不存在时,让 Agent 查看端点命令的帮助和 schema。使用返回的 ID,不要从其他项目复制示例编号。写入前校验 case.json,然后读回创建的用例,确认预期的头、请求体和断言已经保存。
在 CI 中运行 Claude API 回归测试
在身份验证、消息序列化、块解析或重试处理发生变化后,运行同一组用例。导出机器可读报告,并把 fixture 版本与应用变更放在一起。在比较之前先建立通过的基线,然后逐个调查失败,而不是反复重跑直到构建碰巧通过。
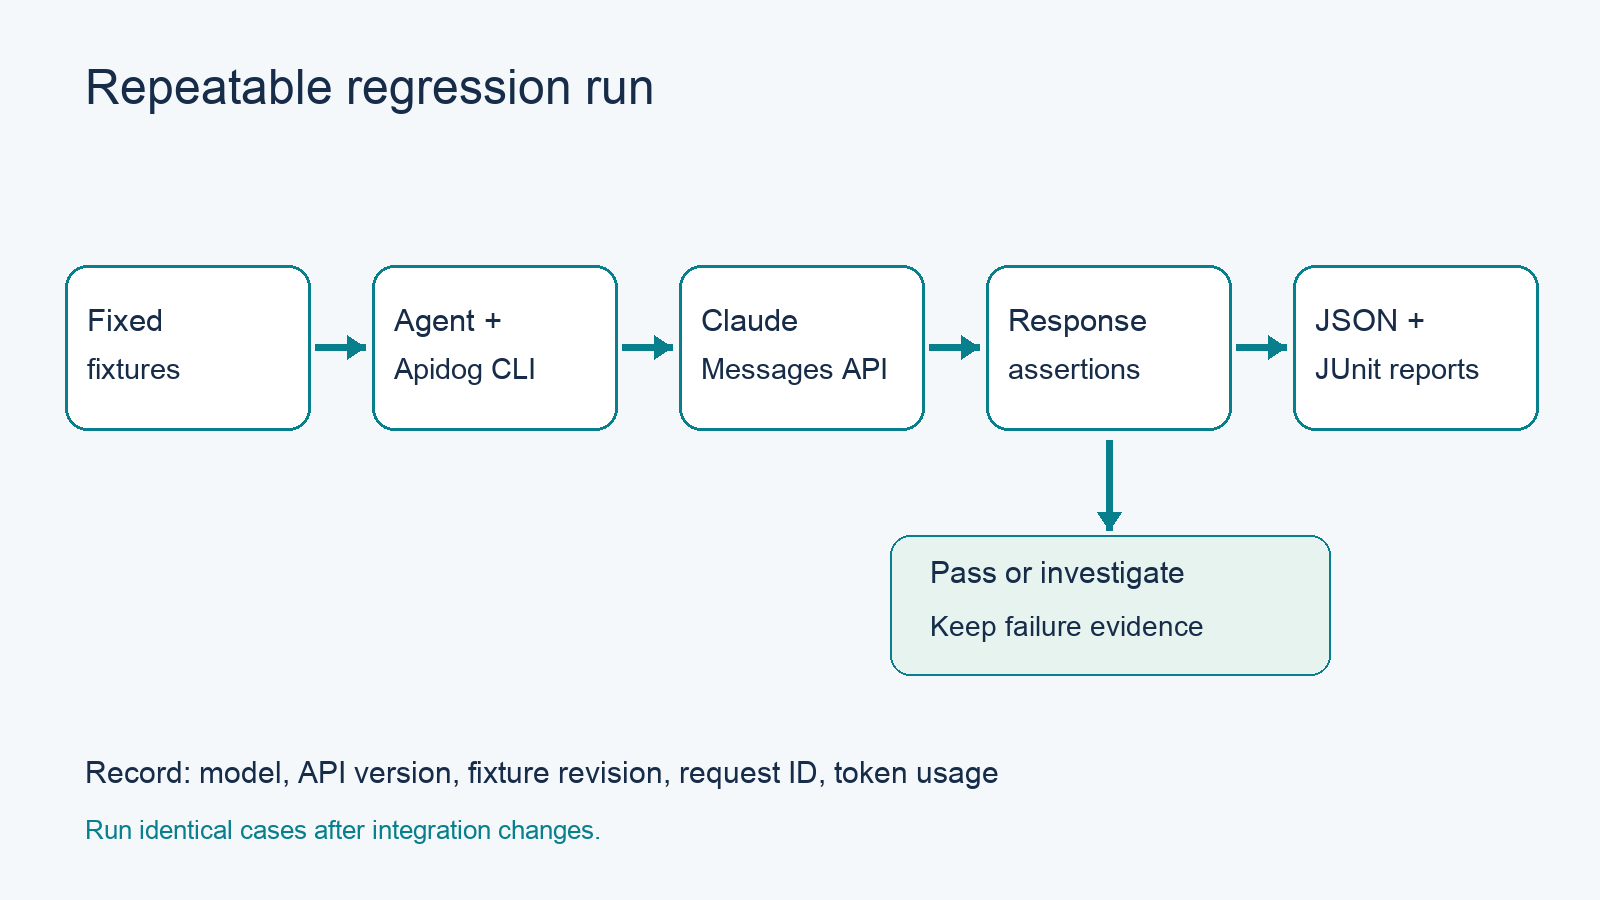
对于已在 Apifox 中创建的用例,在 CI 中复用同一组用例并导出报告。按单个用例运行时使用 apifox test-case run <CASE_ID> --project <PROJECT_ID> -e <ENVIRONMENT_ID> -r cli,json,junit --out-dir ./apifox-reports;若要运行某个接口下的全部用例,把 <CASE_ID> 换成 --endpoint <ENDPOINT_ID>。CI 访问令牌放在流水线密钥里,运行结束后保留 --out-dir 生成的报告文件。
在运行记录中保留模型、API 版本、请求体、输出预算、fixture 修订版和 CLI 版本。通过 CI 密钥机制保存凭据。共享报告前,检查其中是否包含敏感请求数据。
日常变更使用小规模的真实冒烟集,发布前使用更广泛的行为集。设置你自己的支出和时长预算。API 契约通过只说明集成兼容;应用特定的验收测试才说明输出是否有用。
常见问题
应该测试哪个模型 ID?
这个 Claude Platform 直连工作流使用 claude-fable-5-2。保存基线前,先确认你的账户可用。
HTTP 200 就足够通过吗?
不够。检查消息信封、带类型的内容、完成原因和 fixture 验收标准。流式传输还需要额外的事件级检查,因为响应头到达后仍可能发生失败。
可以禁用 Fable 5.2 的思考吗?
不可以。Anthropic 文档说明该模型始终开启思考。把禁用思考保留为预期验证错误的负向用例。
每个回答都应该精确匹配吗?
对数字示例这类受限 fixture 使用精确匹配。对于开放式任务,定义允许合理措辞变化的事实和结构标准。
修复后可以让 Agent 重跑测试吗?
可以。把保存的用例 ID 和环境交给它,让它运行相同的 CLI 命令并汇总报告。如果需要配置 Agent,可先参考 Claude Code 的 CLI 工作流。