要在本地运行 Qwen 3.8 27B(待核实:该模型版本及参数信息请以通义千问官方发布为准),只需安装 Ollama 并依次运行 ollama pull qwen3.8:27b 和 ollama run qwen3.8:27b。默认版本是一个 18 GB 的 4-bit 量化下载包,因此建议使用配备 24 GB 显存(VRAM)的 GPU,或拥有 32 GB 统一内存的 Mac。模型权重采用 Apache-2.0 许可证开源,模型本身完全免费,唯一的成本只有硬件和电费。
以上是简明步骤。本文将详细介绍值得使用的四款本地运行工具(Ollama、LM Studio、llama.cpp 与 MLX)、不同量化版本所需的内存容量、真实硬件上的实测推理速度,以及在服务启动后如何让编码智能体搭配 Apifox CLI 测试本地接口。
如果你刚开始接触这一系列模型,可以先了解 2.4T 参数的旗舰版 Qwen 3.8-Max;而本文聚焦于能够直接跑在桌面设备上的紧凑型稠密(Dense)版本。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
什么是 Qwen 3.8 27B?
Qwen 3.8 27B 是阿里巴巴通义千问(Qwen)团队于 2026 年 8 月基于 Apache-2.0 许可证发布的 270 亿参数稠密视觉语言模型(待核实)。它支持读取文本、图像和视频,默认开启思考(Thinking)模式后再作答,原生支持 262,144 token 的上下文窗口,并可通过 YaRN 扩展至 100 万 token。
官方模型卡列出的核心规格如下(待核实):
| 规格项 | Qwen 3.8 27B |
|---|---|
| 参数量 | 27B 稠密模型(Hugging Face Hub 计入视觉编码器后显示为 28B) |
| 层数 | 64 层,混合采用 Gated DeltaNet 与 Gated Attention 模块 |
| 上下文窗口 | 原生 262,144,通过 YaRN 最高可扩展至 1,000,000 |
| 输入模态 | 文本、图像、视频 |
| 思考模式 | 默认开启,reasoning_effort 支持 xhigh、medium 或 low |
| 附加特性 | 多词元预测(MTP,Multi-token prediction)层 |
| 开源协议 | Apache-2.0 |
在 Qwen 官方公布的基准测试表中,它在 SWE-bench Pro 上得分为 61.7,在 Terminal Bench 2.1 上得分为 73.0,在 GPQA Diamond 上得分为 89.2(待核实)。这些均为厂商公布的数据,阅读时建议留意哪些测试集属于官方自建评测。
为什么它适合本地部署:4-bit 量化下的 27B 稠密模型可以塞进单张消费级显卡,并且在同一个模型文件中同时具备工具调用(Tool Calling)、视觉理解与深度思考能力。
运行 Qwen 3.8 27B 需要多少内存(RAM)与显存(VRAM)?
规划硬件时,请按所选量化模型的文件大小再加上 3 到 6 GB 的 KV 缓存与运行时开销来计算。对于默认的 Q4_K_M 量化版本,意味着需要 24 GB 显存的 GPU 或 32 GB 统一内存的 Mac。
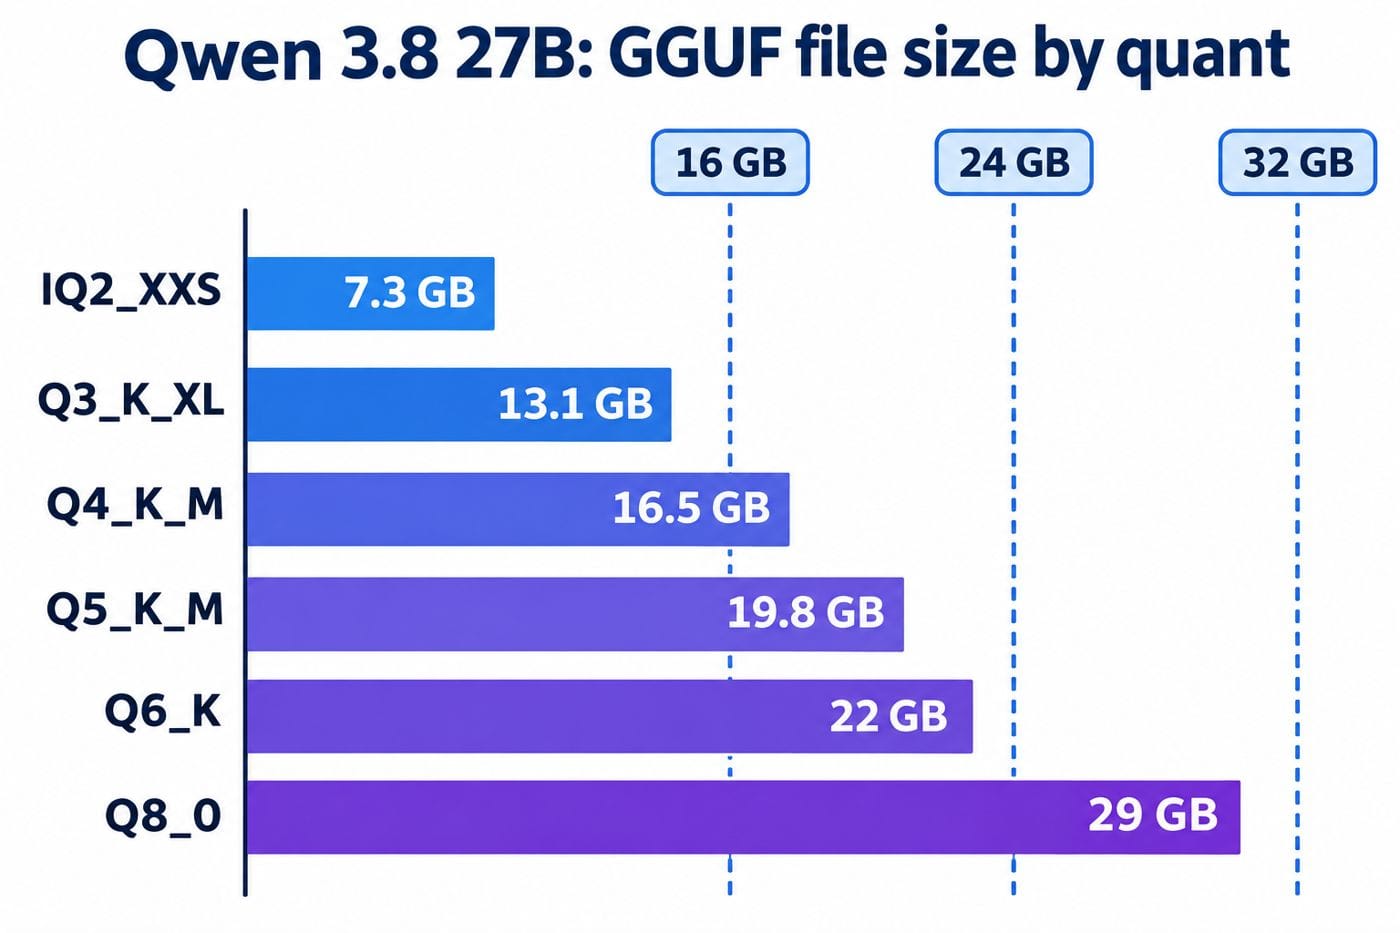
以下是于 2026 年 11 月 9 日核对的 unsloth 量化仓库中的 GGUF 文件大小(待核实):
| 量化版本 | 文件大小 | 推荐硬件配置 |
|---|---|---|
| UD-IQ2_XXS | 7.27 GB | 16 GB Mac 或 12 GB 显存 GPU,有明显质量损失 |
| UD-Q3_K_XL | 13.1 GB | 16 GB 显存 GPU,24 GB Mac |
| UD-Q4_K_M | 16.5 GB | 24 GB 显存 GPU,32 GB Mac(性价比甜点档) |
| UD-Q5_K_M | 19.8 GB | 24 GB 显存 GPU(短上下文),32 GB Mac |
| UD-Q6_K | 22 GB | 32 GB 显存 GPU,48 GB Mac |
| Q8_0 | 29 GB | 48 GB 显存 GPU,64 GB Mac |
如果需要图像输入能力,视觉投影器(mmproj-F16.gguf)会额外增加 928 MB。Ollama 默认的 qwen3.8:27b 镜像体积为 18 GB,正是因为它打包了视觉模块。
上下文长度是容易被忽视的隐性开销。根据 llm-speed 的容量测算(待核实),开启 32,000 token 上下文时,Q4_K_M 大约会占用 21.9 GB。这也是为什么 24 GB 显卡是运行 Q4 的实用底线,而且除非内存非常充裕,否则不建议直接拉满 262K 的完整上下文窗口。
在 Mac 上还要注意,macOS 会为系统保留一部分统一内存。24 GB 的 Mac 理论上也能加载 Q4_K_M,但留给长上下文或浏览器的余量会非常紧张,因此在 24 GB Mac 上更建议选择 Q3_K_XL。
Qwen 3.8 27B 在本地运行有多快?
使用 llama.cpp 运行 Q4_K_M 时,RTX 3090 或 4090 的生成速度大约在 38 到 44 token/s,RTX 5090 可达 65 到 75 token/s;搭载 M3 Ultra 的 Mac Studio 解码速度约为 25 到 27 token/s(待核实)。
这些并非我们自行跑分的结果,而是由 llm-speed 公布的实测数据及其声明的硬件与运行时环境(待核实):
| 硬件设备 | 量化版本 / 运行时 | 解码速度 (Decode tok/s) | 预填充速度 (Prefill tok/s) |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38.6(短对话,4K 上下文) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43.4(短对话,4K 上下文) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75.2(短对话,4K 上下文) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34.3(短对话) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25.2(短对话) | 45 |
| M3 Ultra 96 GB | 4-bit, MLX 0.31.3 | 27.3(短对话) | 12 |
在独立 GPU 上,解码速度几乎不会随上下文增长而明显下降:输入 33,133 token 的提示词后,RTX 4090 依然能保持 39.0 tok/s。而预填充(Prefill)则是 Mac 落后的地方:面对 11,827 token 的提示词,M3 Ultra 的处理速度约为 283 tok/s,而 RTX 4090 约为 2,000 到 3,000 tok/s,因此读取大型代码库时需要等待几十秒才会输出第一个 token。
思考模式同样会消耗大量时间预算。当 Simon Willison 让本地 Qwen 3.8 27B 从原始模型权重中识别游戏时(待核实),其中一次回答耗时 46 分钟并生成了 43,506 个推理 token。对于日常任务,建议将 reasoning_effort 调低至 low 或直接关闭思考模式。
使用 Ollama 运行 Qwen 3.8 27B
Ollama 是各大操作系统上最省事的启动方式。从 ollama.com 安装后,执行以下命令:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
在 Apple Silicon 设备上,可以尝试 qwen3.8:27b-mlx 标签,它会使用 MLX 后端,体积同样为 18 GB。
Ollama 的默认上下文长度较小,在长对话的智能体会话中容易截断报错。建议在启动服务前调大上下文窗口:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
Ollama 还会在 http://localhost:11434/v1 暴露兼容 OpenAI 的 API,因此任何 OpenAI SDK 只需修改 Base URL 即可直接调用:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
想直接接入编码智能体?Ollama 内置了快捷启动命令:ollama launch claude --model qwen3.8 可以让 Claude Code 直接连接本地模型启动,ollama launch opencode --model qwen3.8 则可用于启动 OpenCode(待核实)。
使用 LM Studio 运行
如果你偏好图形界面(GUI)并希望按模型独立配置加载参数,LM Studio 是理想选择。在应用中搜索 Qwen 3.8 27B,下载 Q4_K_M 版本的 lmstudio-community/Qwen3.8-27B-GGUF(16.8 GB)并加载。
有一项设置尤为关键:加载模型时务必调高上下文长度。Simon Willison 在实测中发现,默认的 8,192 token 上下文在处理长提示词时会报错失败,必须加载更大的上下文窗口才能顺利运行。
随后打开 Developer(开发者)标签页并启动本地服务器,或在终端运行 lms server start。兼容 OpenAI 的接口地址位于 http://localhost:1234/v1。
使用 llama.cpp 运行
llama.cpp 提供了最精细的控制能力,前面列出的绝大多数基准测试也是基于它运行的。在 macOS 或 Linux 上可执行:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
其中 -hf 会直接从 Hugging Face 下载对应的量化文件,--jinja 会应用模型的聊天模板(工具调用与思考模式所必需),-c 用于设置上下文长度,-ngl 99 则会将所有网络层卸载到 GPU 上。上述采样参数是 Qwen 官方针对思考模式给出的推荐值;如果使用非思考模式,模型卡建议将参数设为 temperature 0.7、top_p 0.8、top_k 20 以及 presence_penalty 1.5。
如果只想在单次请求中关闭思考模式,可以在请求体中传入 "chat_template_kwargs": {"enable_thinking": false}。
在 Mac 上使用 MLX 运行
MLX 是 Apple 官方推出的数组计算框架,在 Apple Silicon 上通常能提供最快的解码速度。安装 mlx-lm 并使用 mlx-community 转换的 4-bit 版本:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server 会暴露一个兼容 OpenAI 的 /v1/chat/completions 路由。如果你希望在内存占用、输出质量与推理速度之间做不同权衡,mlx-community 组织还发布了 8-bit、mxfp4 以及 MTP 等多种变体。
让编码智能体通过 Apifox CLI 测试本地接口
虽然各款运行工具都提供相同结构的 OpenAI 兼容接口,但它们对思考块(Thinking Blocks)、工具调用和超时时间的处理方式各不相同。在把业务应用指向 localhost 之前,可以让你的编码智能体使用 Apifox CLI 构建一套可重复执行的测试,以便在几秒内揪出损坏的聊天模板或上下文截断问题,而不是等到任务执行到一半才报错(待核实:以下 Apifox CLI 具体子命令及参数请以 Apifox 官方文档为准)。
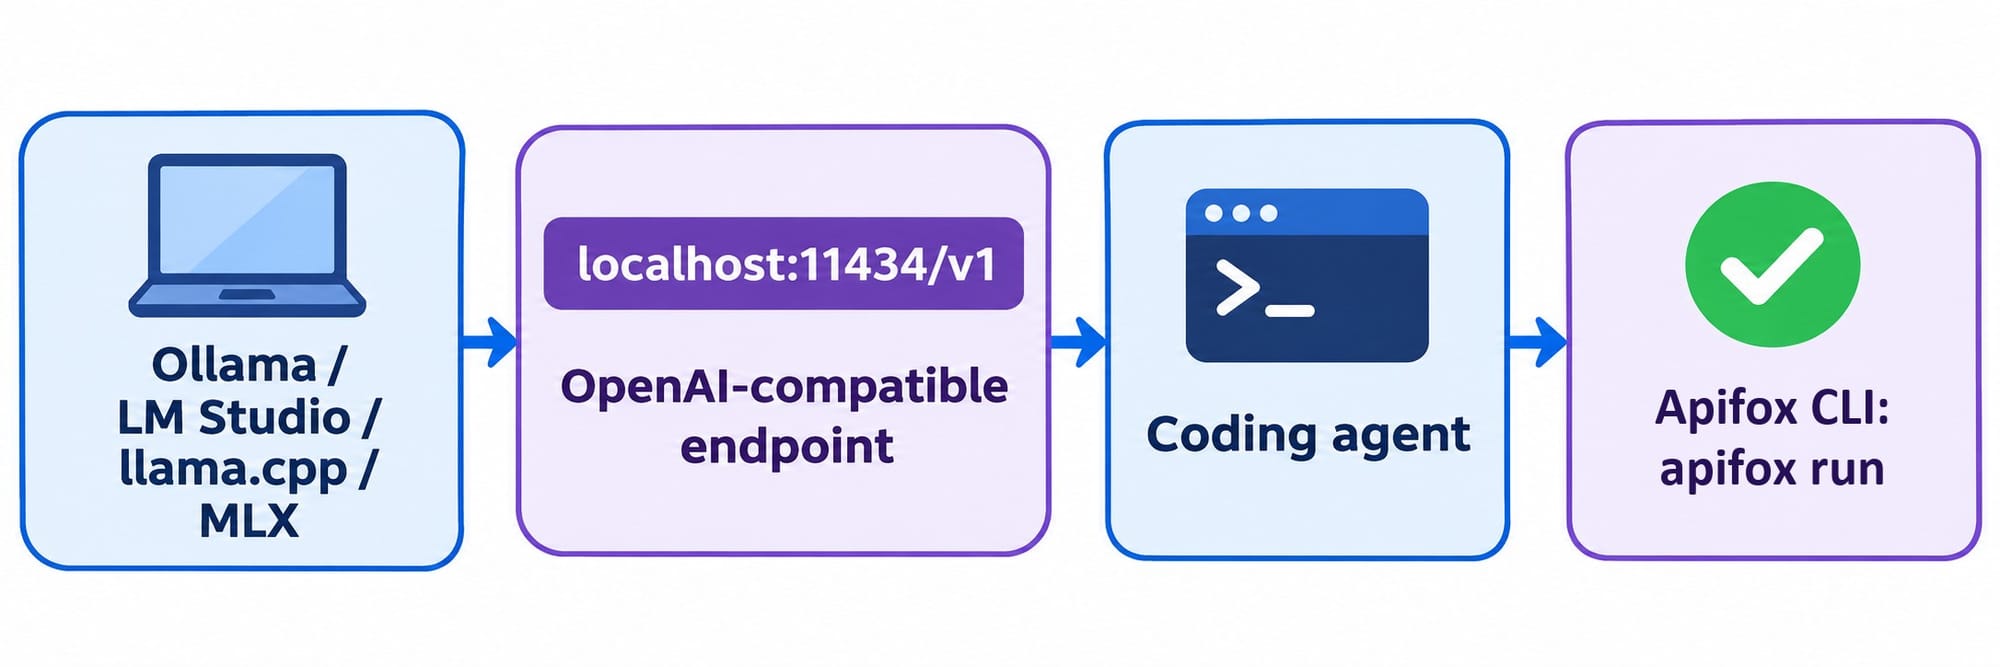
只需初始化配置一次:
npm install -g apifox-cli@latest
apifox login --with-token <YOUR_TOKEN>
npx -y skills add https://apifox.com   # 出现提示时选择你使用的智能体
接着向 Claude Code、Codex 或 Cursor 发送一段提示词:
In Apifox project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
智能体会读取对应的载荷 Schema、校验 JSON、创建资源并执行测试用例:
apifox environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apifox cli-schema get endpoint-create
apifox cli-schema validate endpoint-create --file endpoint.json
apifox endpoint create --project <projectId> --file endpoint.json
apifox cli-schema get test-case-create
apifox test-case create --project <projectId> --file case.json
apifox run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
这里的长超时参数 --timeout-request 非常关键:开启思考模式的 27B 模型在 Mac 上可能需要数分钟才能完成推理。只需将 Base URL 切换为 http://localhost:1234/v1 或 :8080/v1,同一个测试用例就能直接验证 LM Studio、llama.cpp 或 MLX。如需了解更多智能体配置方式,可参考在 Claude Code 中使用 Apifox CLI 的相关指南以及 apifox run 命令参考文档。
本地部署 vs 托管版 Qwen 3.8 API
在本地运行能够让提示词数据留在本地设备、支持离线工作且免除按 token 计费的开销。代价则是速度与模型规模:云端托管接口运行的是体量庞大得多的 Qwen 3.8-Max,具备 100 万上下文窗口且几乎没有预填充等待。如果你需要旗舰级能力,可以查阅 Qwen 3.8 API 指南或免费调用渠道说明;如果打算用任意尺寸的模型进行智能体编程,也可以参考 Qwen 3.8 编程对比评测来挑选合适的脚手架。
常见问题(FAQ)
在本地运行 Qwen 3.8 27B 是免费的吗? 是的。模型权重以 Apache-2.0 协议发布在 Hugging Face 上,Ollama、LM Studio、llama.cpp 和 MLX 也全部免费,你只需承担硬件和电费成本。
我可以在 16 GB 内存的 Mac 上运行 Qwen 3.8 27B 吗? 只能在短上下文下运行 2-bit 量化版本(如 7.27 GB 的 UD-IQ2_XXS),且生成质量会有明显下降。32 GB 内存的 Mac 搭配 Q4_K_M 才是较为舒适的配置。
Qwen 3.8 27B 能在 RTX 3090 上运行吗? 可以。Q4_K_M 能够装进 24 GB 显存,并留有容纳 16K 至 32K 上下文的空间;根据 llm-speed 在 llama.cpp 上的实测,生成速度约为 38 token/s。
如何关闭思考模式? 在 llama.cpp 或 vLLM 上发送请求时传入 "chat_template_kwargs": {"enable_thinking": false},或者将 reasoning_effort 调低为 low。Qwen 官方建议在非思考模式下使用 temperature 0.7 与 top_p 0.8。
本地模型支持图像输入吗? 支持。Ollama 的 18 GB 默认镜像已内置视觉能力;如果使用 llama.cpp,只需在下载模型的同时一并下载 mmproj-F16.gguf 文件即可。
Qwen 3.8 27B 与 Qwen 3.8-Max 有什么区别? Max 是通过阿里云 API 提供的 2.4T 参数混合专家(MoE)旗舰模型;而 27B 是稠密模型,体积足够小,可在单张消费级 GPU 或 32 GB Mac 上独立运行。