要在本地运行 ERNIE 5.5 Flash,需安装 vLLM 0.32.0 以及百度的 vLLM-ERNIE 插件,然后在多 GPU 节点上结合数据并行和专家并行运行 vllm serve baidu/ERNIE-5.5-Flash-Base。这样你就会在 8000 端口获得一个兼容 OpenAI 的服务端。需要注意的是:目前公开的权重是 Base 模型,即仅用于文本续写的预训练检查点,而非对话模型。
下文将介绍可下载的权重版本、百度列出的硬件要求、完整的服务启动命令以及如何测试该端点。文中所有命令和数据均于 2026 年 11 月 12 日核对自百度的 Hugging Face 模型卡与 vLLM-ERNIE 仓库。
如果是第一次接触该模型,可以先阅读什么是 ERNIE 5.5 Flash。如果你想在不搭建 GPU 集群的情况下直接使用对话模型,参考 ERNIE 5.5 Flash API 指南会更快。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
目前可以在本地运行哪个版本?
目前可以运行在 Hugging Face 上发布的 ERNIE 5.5 Flash Base(提供 FP8 和 BF16 格式)。它是一个总参数量 280B、每个 token 激活 14B 参数的稀疏混合专家(MoE)模型,基于 33.5T token 训练而成。经过对话微调的 ERNIE 5.5 Flash Preview 暂时仅通过 API 提供;百度表示其权重将“很快”以 Apache 2.0 协议开源。
两个版本在自托管场景下的对比如下:
| 对比维度 | ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview |
|---|---|---|
| 模型定位 | 预训练结束时的检查点 | 首个后训练(对话、推理、Agent)模型 |
| 权重发布情况 | 已上线 Hugging Face 和 ModelScope,提供 FP8 和 BF16 | 截至 2026 年 11 月 12 日尚未发布 |
| 调用的端点 | /v1/completions(文本续写) |
支持推理和工具调用的 Chat Completions |
| 许可证 | ERNIE 5.5 Flash Base Model License v1.0 | 发布时承诺采用 Apache 2.0 |
| 当前使用方式 | 自有 GPU 服务器 | 千帆 API、OpenRouter |
目前百度的 ERNIE-5.5-Flash 合集中仅包含两个 Base 检查点,vLLM-ERNIE 的 README 也将对话模型标记为“Coming soon”。Preview 发布公告中未公布具体开源日期。
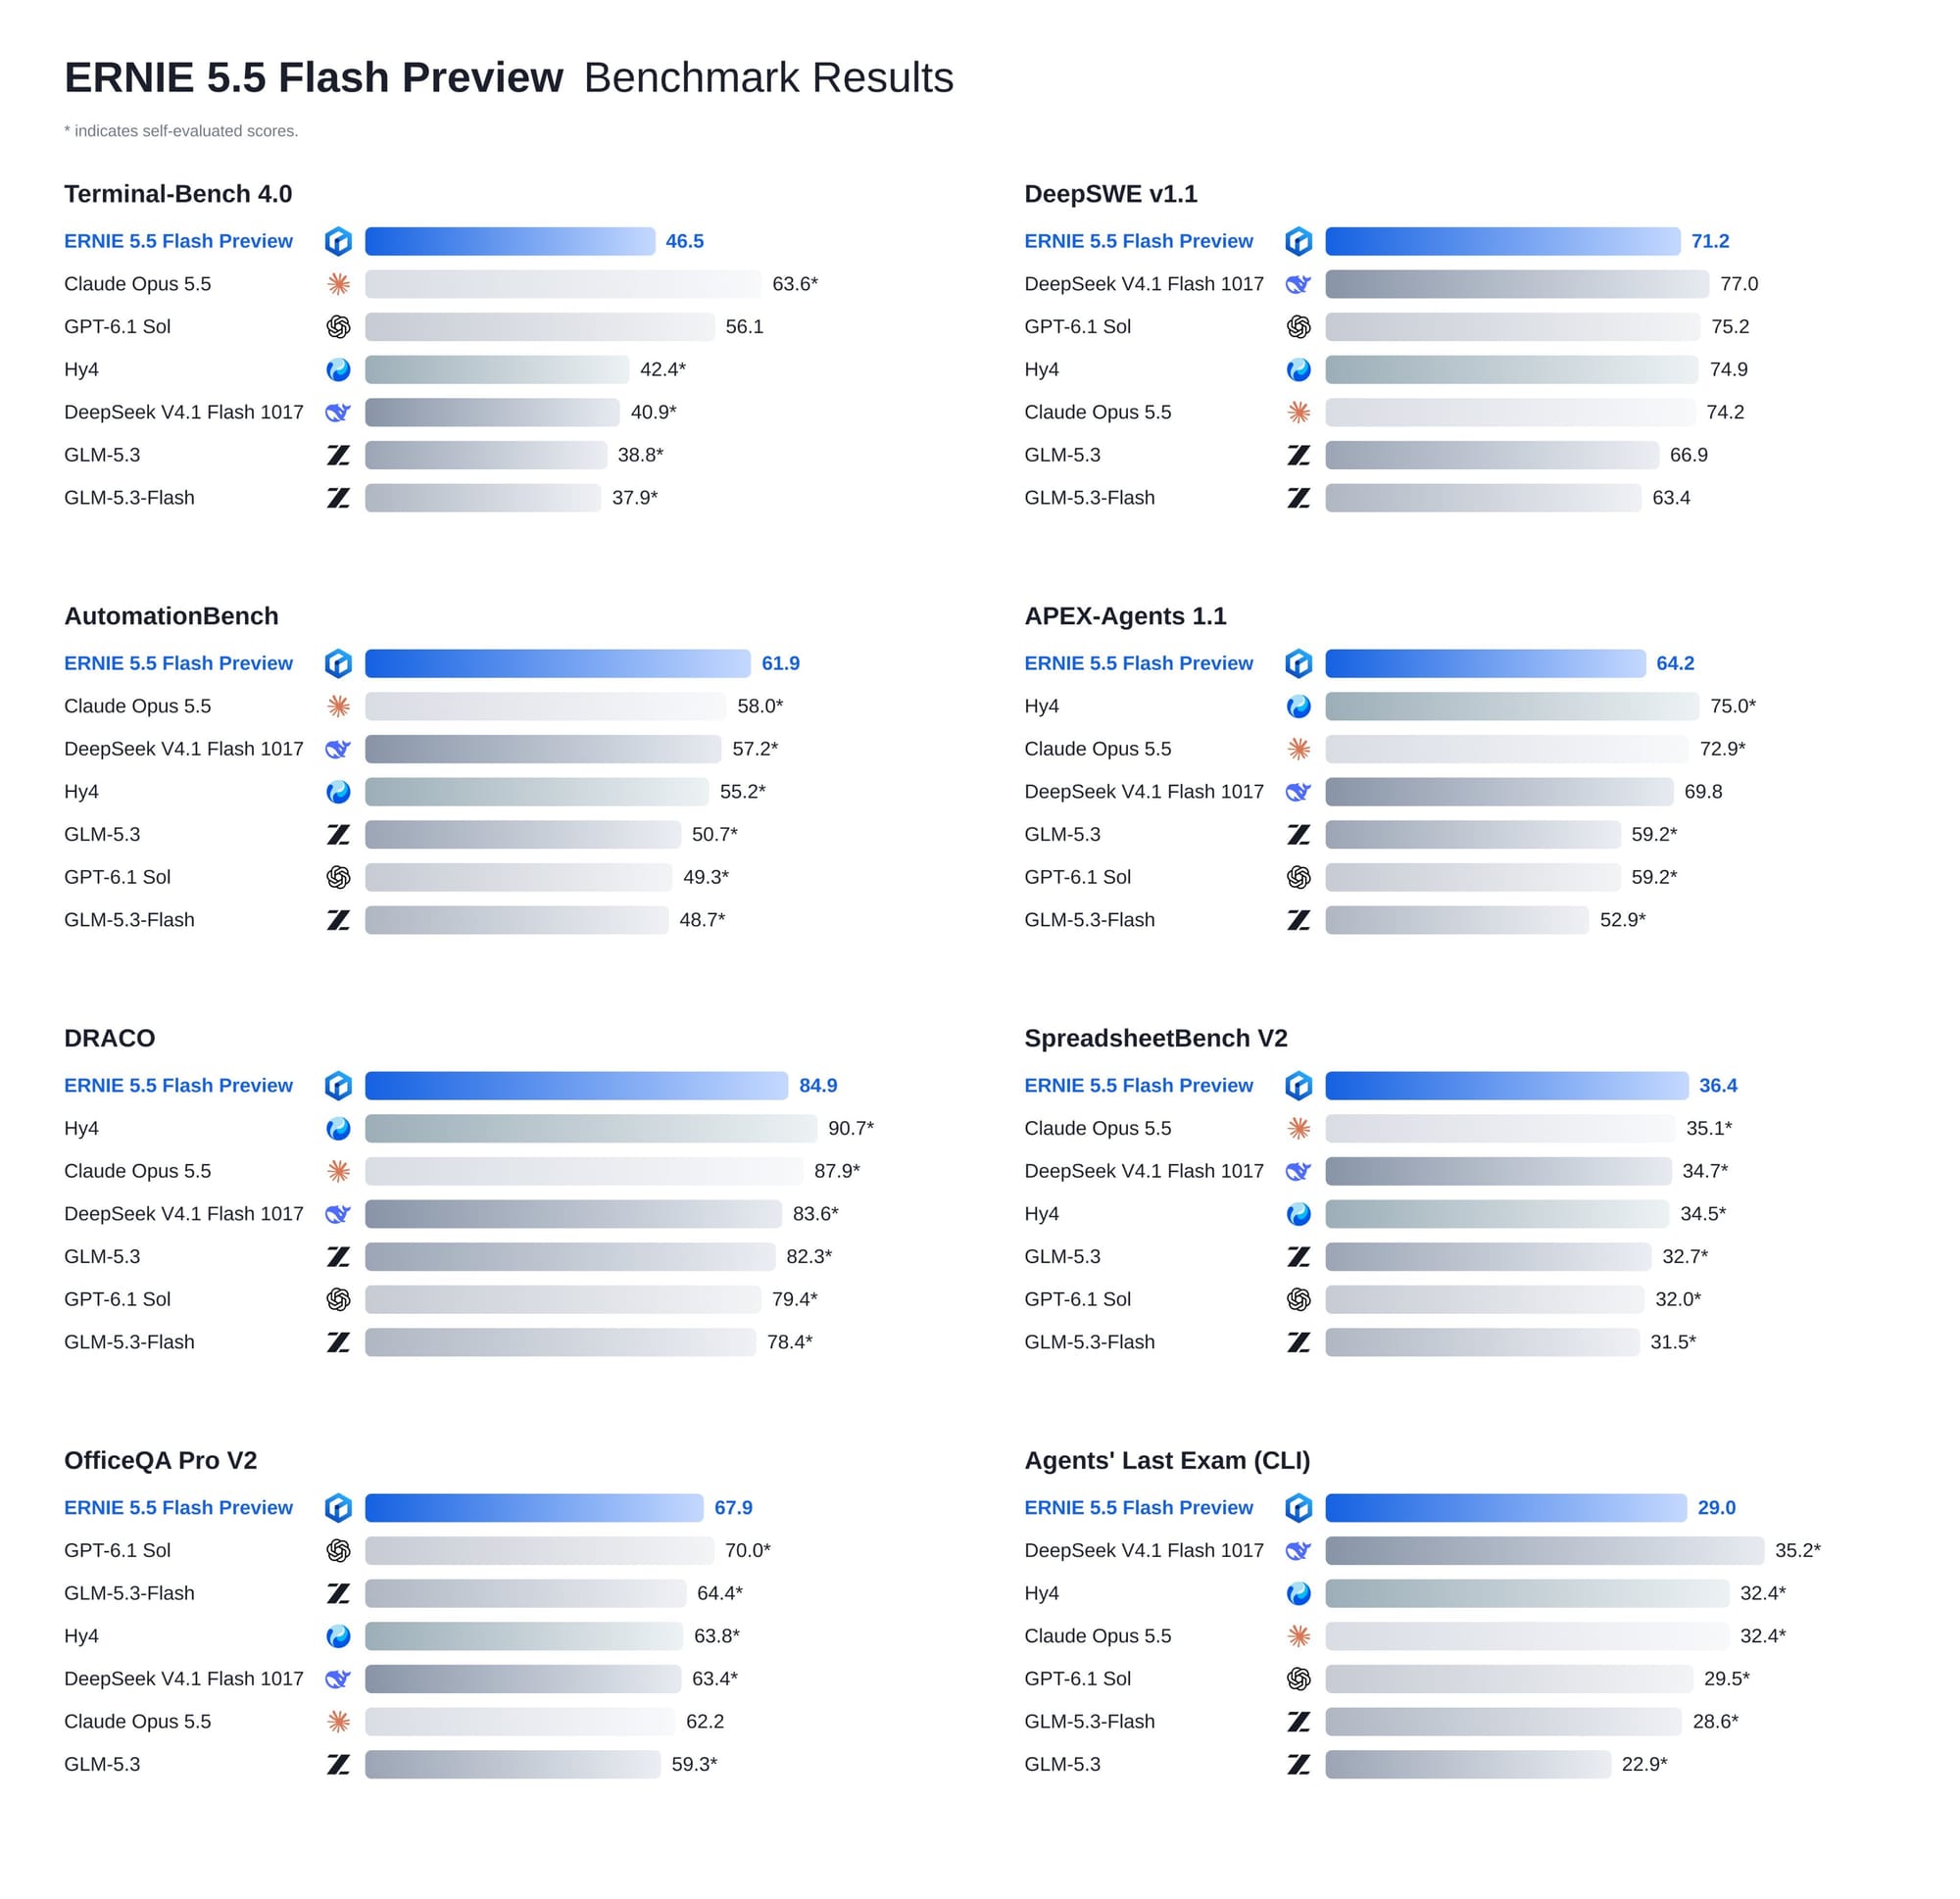
如果你现在就需要一个编码助手,本地部署的 Base 模型无法直接胜任;但如果你需要一个用于微调或少样本(few-shot)研究的起点,Base 正是百度为此打造的基座。
ERNIE 5.5 Flash 硬件要求
FP8 权重约占 280 GB 显存,BF16 权重约占 560 GB 显存,因此这是一项需要多 GPU 服务器的任务,无法在普通笔记本电脑上运行。vLLM-ERNIE README 列出了能够装下权重的最少 GPU 数量,且该插件仅支持在 NVIDIA GPU 上运行。
| 单卡显存容量 | FP8(约 280 GB 权重) | BF16(约 560 GB 权重) |
|---|---|---|
| 288 GB | 2 块 GPU | 4 块 GPU |
| 192 GB | 4 块 GPU | 8 块 GPU(或 2 节点 x 4 GPU) |
| 80 GB | 8 块 GPU | 2 节点 x 8 GPU |
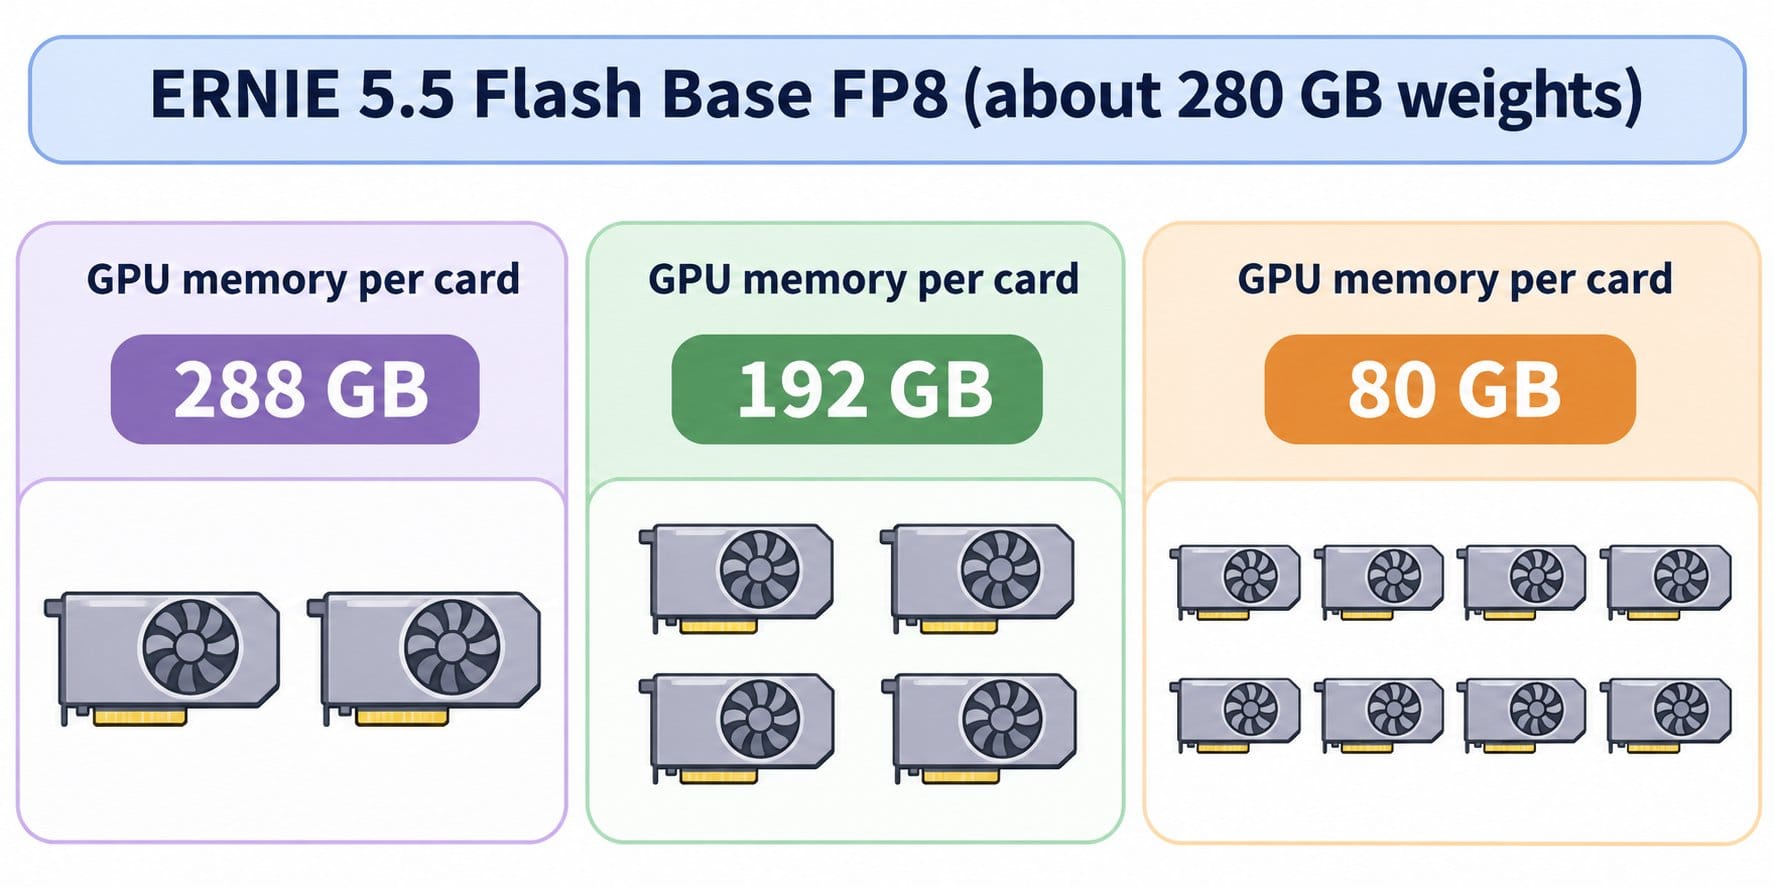
以上只是加载权重的最低显存要求。KV 缓存还需要额外空间,因此你实际能支持的上下文长度取决于所使用的显卡:
- 80 GB GPU: 在 8 块 GPU 上通过
--data-parallel-size 8和--gpu-memory-utilization 0.93部署 FP8 权重,最高可容纳 262,144 token 上下文,但装不下 1M 上下文。 - 1M token 上下文: 百度给出的参数基于单卡 184 GiB 显存的 GPU,并将显存利用率下调至 0.85,因为 1M token 的预填充(prefill)阶段需要数十 GB 的临时显存。
- 显卡架构差异: FP8 启动命令中传入了
--moe-backend humming,用于在 Blackwell 架构 GPU 上支持该模型的 SiTU 激活函数与 FP8 权重。如果使用的是 Hopper 架构 GPU,请去掉该参数并保持使用 vLLM 默认的 MoE 内核。
这里的“本地(Locally)”是指由你完全掌控的硬件环境:无论是租用的 8 卡节点、机房本地服务器还是实验室集群。
安装 vLLM 与 ERNIE 插件
vLLM 原生并不直接支持 ERNIE 5.5 架构(Ernie5_5_MoeForCausalLM)。百度将其封装为一个独立插件,可直接运行在未修改的官方 vLLM 0.32.0 wheel 包之上。创建一个 Python 3.12 环境并同时安装两者:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
该插件会通过 vLLM 的 vllm.general_plugins 入口点在每个 vLLM 进程中自动加载。如果后续运行 vllm serve 时报错 Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported,说明运行 vllm 的环境中未安装该插件,或者设置了 VLLM_PLUGINS 环境变量但其中未包含 ernie。
如果想从魔搭社区(ModelScope)而非 Hugging Face 拉取权重,可以设置 VLLM_USE_MODELSCOPE=True。两个平台上的仓库名称完全一致。如果你刚开始接触 vLLM,我们的 vLLM 概览详细介绍了其服务端架构与兼容 OpenAI 的 API。
ERNIE 5.5 Flash 的 vLLM serve 启动命令
以下是来自 vLLM-ERNIE README 的 FP8 启动命令,适用于单台 4 卡节点、128K 训练上下文长度,并开启了 ECHO 投机解码(speculative decoding):
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
根据百度的文档说明,各项参数的作用如下:
- 数据并行注意力 + 专家并行 MoE(
--data-parallel-size 4 --enable-expert-parallel):能够保留最大的 KV 缓存空间并提供最高吞吐量。张量并行(--tensor-parallel-size设为 2、4 或 8)虽然能在低并发下降低延迟,但可容纳的 KV 缓存较小。 - FP8 KV 缓存(
--kv-cache-dtype fp8):以 FP8 格式存储缓存;若设为auto则保持使用 BF16。 - ECHO 投机解码:复用模型自身的最后一层作为内置草稿模型(draft model)。此处配置为每次起草 2 步,设为 1 或 3 同样可行。去掉
--speculative-config则以不带投机解码的常规模式运行。
模型卡中还展示了一个运行在 30000 端口、不带投机解码配置的精简版命令。
务必做好安全防护。 上述命令默认绑定 0.0.0.0 且未开启身份认证。百度的 README 提醒,除非所处网络完全可信,否则应添加 --api-key <key> 或改为绑定 127.0.0.1。在暴露端口前请务必采取其中一种措施。
BF16 与 1M 上下文配置
BF16 权重需要跨两台 4 卡节点运行(DP8 加 EP8),需配置 --data-parallel-size 8、--data-parallel-size-local 4、--data-parallel-address ${HEAD_IP} 和 --data-parallel-hybrid-lb;第二个节点还需加上 --data-parallel-start-rank 4。你可以直接从 README 复制完整命令,其中还包含了节点间网卡接口的设置。
如需开启完整的 1,048,576 token 上下文窗口,请传入 --max-model-len 1048576 和 --gpu-memory-utilization 0.85,同时调低 --max-num-seqs,确保每个 rank 的 KV 缓存能够装下完整的 1M token 请求。
调用兼容 OpenAI 的端点
vLLM 暴露了 OpenAI 风格的路由,但由于基座模型没有对话模板(chat template),你需要向 /v1/completions 发送原始提示词。在少样本(few-shot)场景下,可以将示例直接写进 prompt,并设置在一个回答结束时停止生成:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
百度的 README 指出,该请求返回的补全文本为 36。有三个细节容易踩坑:
- 传入
"temperature": 0以使用贪婪解码(greedy decoding)。 模型的generation_config.json默认设置了do_sample=false、temperature=1.0和top_p=0.95。vLLM 会应用其中的 temperature 和 top_p,但会忽略do_sample,因此如果不显式覆盖,实际执行的是随机采样。 - 不要手动添加
<|ERNIE_MASK|>。 分词器(tokenizer)会自动在补全提示词前加上该标记(token id 为 2)。 - 模型名称需严格匹配。 部署 BF16 权重时,请使用
baidu/ERNIE-5.5-Flash-Base-BF16。
任何 OpenAI SDK 只要将 base_url 指向 http://<host>:8000/v1 并调用 completions(而非 chat completions)接口,都可以正常对接。
Base 与 Preview:应该选择哪一个?
如果计划在基座之上继续训练或微调,请选择 Base;如果现在就需要一个开箱即用的助手,请选择 Preview。Base 能让你完全掌控模型,且数据永远不会离开自有服务器;Preview 则提供对话、推理和工具调用能力,但目前仅能通过千帆或 OpenRouter 调用。
等到 Preview 权重正式开源时,当前这套插件已经提前做好了适配。README 中已经记录了标有“Coming soon”的额外参数:--reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice,以及用于投机解码的 DSpark 草稿模型。届时推理思考过程将通过 reasoning_content 返回,工具调用将通过 message.tool_calls 返回,因此你今天搭建的服务端只需替换权重并加上三个参数,就能直接变成对话后端。
另一个核心区别在于许可证。Base 采用 ERNIE 5.5 Flash Base Model License Agreement v1.0 协议发布,而非 Apache 2.0。在基于它构建产品之前,请仔细阅读完整许可证。截至 2026 年 11 月 12 日,其主要条款包括:
- 非商业用途免费,且无需发送通知。
- 相关产品年营收不超过 5,000 万美元的商业用途免收许可费,但必须展示“Powered by ERNIE”标识,并向百度发送一次性使用通知。
- 年营收超过 5,000 万美元时,需事先获得百度的单独书面授权。
- 许可证的“适用地区(Territory)”排除了欧盟、英国和韩国。
如果你想找一个用更少 GPU 就能自托管的小尺寸开放权重模型,可以参考我们的自托管 GLM-5.3 指南。
让你的编码 Agent 使用 Apifox CLI 测试该端点
新部署好的 vLLM 服务需要一套在每次调整启动参数后都能重复运行的冒烟测试:检查状态码、响应结构以及每秒生成的 token 数。与其反复手敲 curl 命令,不如把这项工作交给你的编码 Agent 和 Apifox CLI。
只需完成一次 CLI 初始化:
npm install -g apifox-cli@latest
apifox login --with-token <YOUR_TOKEN>
npx -y skills add https://apifox.com   # 按提示选择你的 Agent
然后向 Claude Code、Codex 或 Cursor 发送一条提示词:
In Apifox project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?
Answer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
Agent 会读取 payload schema、完成校验、创建测试用例并执行:
apifox environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file case.json
apifox test-case create --project <projectId> --file case.json
apifox run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
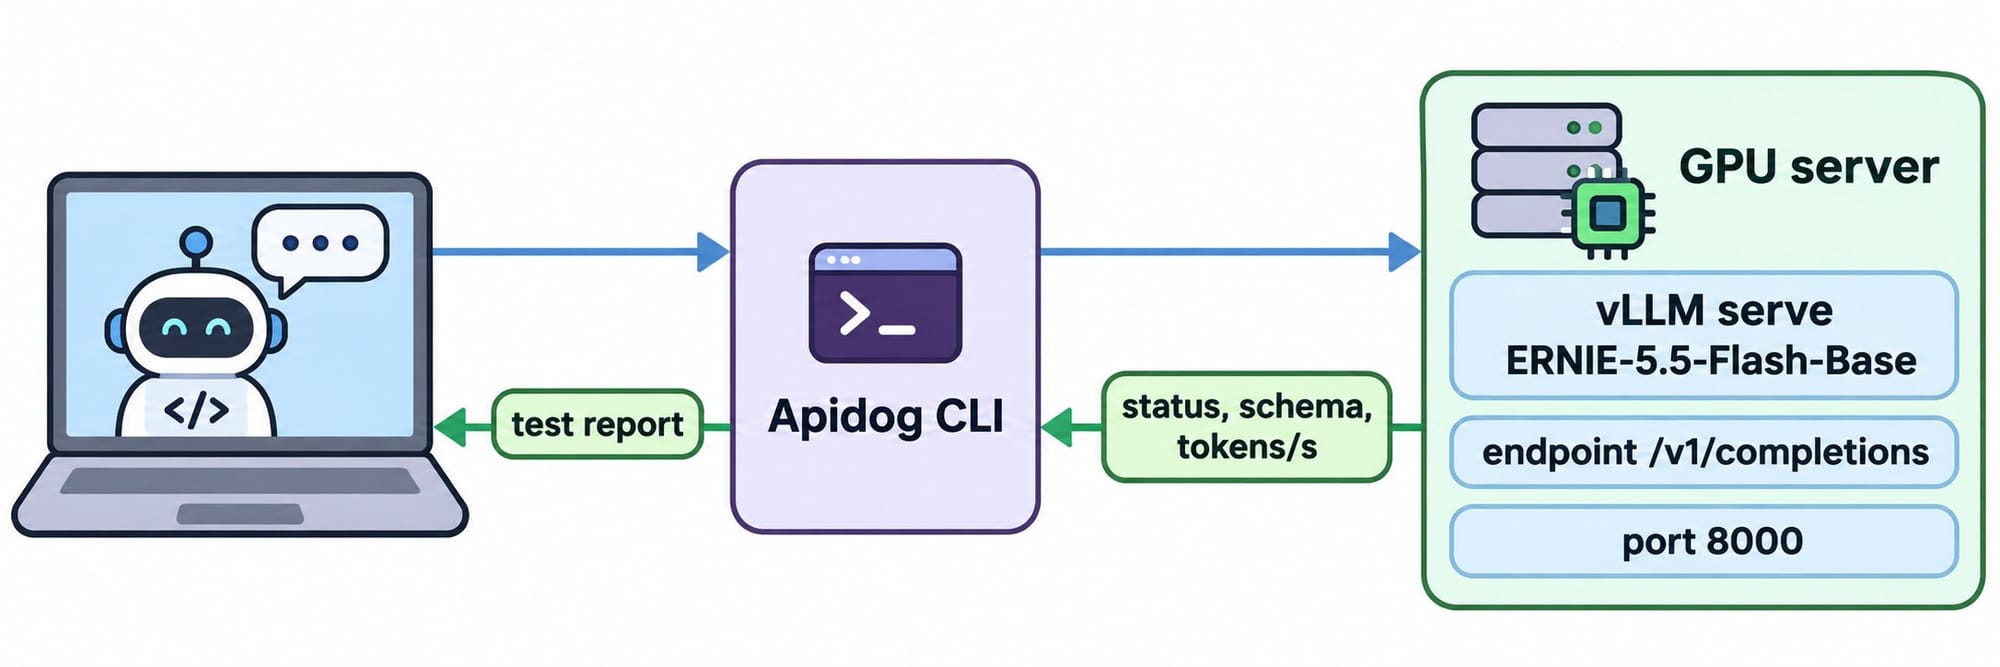
请在一台能够访问 8000 端口的机器上运行 CLI。如果在服务端设置了 --api-key,可以让 Agent 将其保存为环境变量并作为 Bearer token 发送。当你调整 --tensor-parallel-size、去掉投机解码或调高 --max-model-len 后,重新运行同一个用例即可获得直观的横向对比。加上 -r junit 参数后,同一条运行命令还可以直接接入 CI 流水线。关于 Agent 配置的分步详解,请参阅 Claude Code 中的 Apifox CLI 指南。Apifox 免费版不限制成员数量和协作人数。
常见问题
我可以在单张消费级 GPU 上运行 ERNIE 5.5 Flash 吗? 不能。FP8 权重约为 280 GB,百度列出的最小配置是 2 块各 288 GB 显存的 GPU;如果使用 80 GB 显卡则需要 8 块。如果没有这样的硬件条件,请通过 API 使用 Preview 版本。
ERNIE 5.5 Flash Preview 的权重已经开放下载了吗? 截至 2026 年 11 月 12 日尚未开放。百度表示将很快以 Apache 2.0 协议开源,vLLM-ERNIE 插件中也将其列为“Coming soon”。目前 Hugging Face 上只有 Base 权重(FP8 和 BF16)。
为什么在 Base 模型上调用 /v1/chat/completions 会失败? Base 模型没有经过对话微调,也没有内置对话模板。百度通过 /v1/completions 接口配合原始文本提示词来提供服务。你可以在提示词中放入少样本示例并设置停止序列(stop sequence)。
vLLM 原生支持 ERNIE 5.5 吗? 核心版 vLLM 暂未内置支持。你需要在 vLLM 0.32.0 之上安装百度的 vLLM-ERNIE 插件,且仅支持 NVIDIA GPU。此外,SGLang 也通过模型卡中指定的专用 Docker 镜像支持部署该模型。
我可以将 ERNIE 5.5 Flash Base 用于商业用途吗? 可以,但需满足特定条件。相关产品年营收不超过 5,000 万美元时可免许可费商用,但必须保留“Powered by ERNIE”署名并向百度发送一次性通知;超过该营收门槛需事先获得书面授权,且许可证适用地区不包含欧盟、英国和韩国。