借助开源的 llama.cpp 补丁集 llama-modchip,你可以在没有独立 GPU 的情况下直接在本地运行 DeepSeek V4 Flash [待核实]——它将 284B 参数的模型压缩为平均每权重 1.71 bit(1.71 bpw)、体积仅 56.56 GiB 的 GGUF 文件。在配备 64 GB 内存的 16 核 AMD Zen 5 笔记本处理器上,它的预填充(Prefill)速度约为 44 token/s,解码(Decode)速度可达 9 到 15 token/s,且全程零交换分区(Zero Swap)开销。
本文将详细介绍所需的硬件配置、运行命令、画质与精度权衡,以及如何让你的编码智能体自动测试该本地接口。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
llama-modchip 究竟做了什么?
llama-modchip 是一套针对 ggml 与 llama.cpp 的内核补丁、量化转码器及运行时工具集,专门用于将稀疏混合专家(MoE)模型完全装入系统内存(RAM)中运行。其 v2.4.0 版本 [待核实] 主要面向两类模型规模:在 64 GB 机器上运行 284B 的 DeepSeek-V4-Flash,以及在 16 至 32 GB 机器上运行 30B 规模的 MoE 模型。
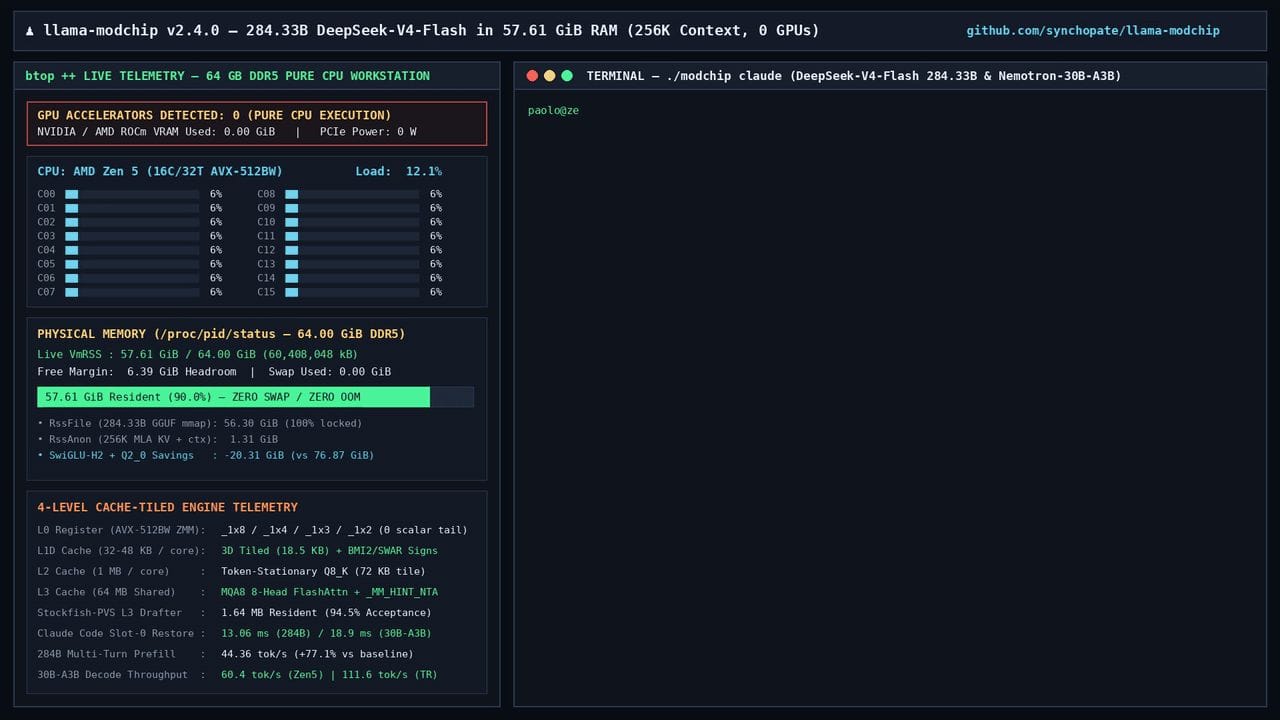
该项目于 2026 年 11 月 8 日登上 Hacker News 并获得超过 370 分 [待核实],其 GitHub 仓库采用 Apache 2.0 开源协议。
让 284B 模型塞进 64 GB 内存并跑出实用速度的核心在于三项改进:
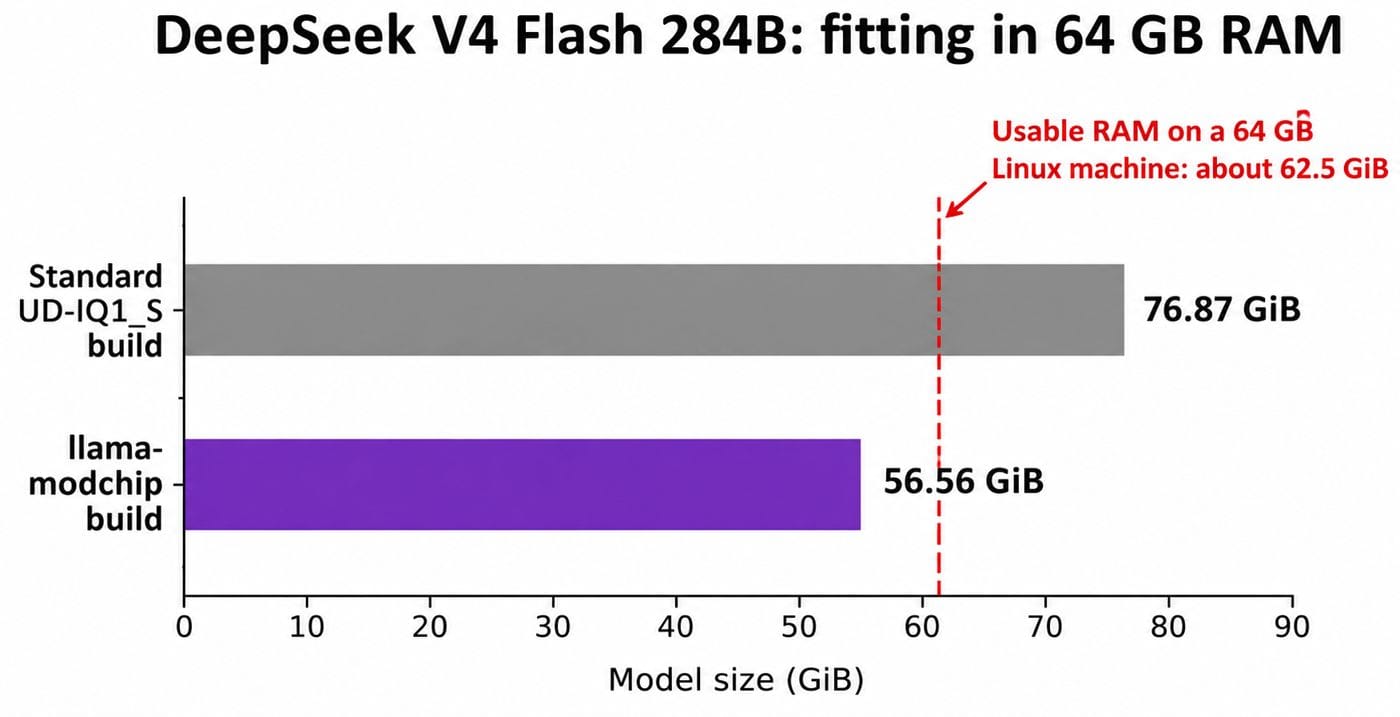
- 更紧凑的权重文件。 标准的 Unsloth
UD-IQ1_S构建版本体积为 76.87 GiB,超过了 64 GB Linux 主机约 62.5 GiB 的实际可用内存上限;而 llama-modchip 将其重新转码压缩至 56.56 GiB。 - CPU 缓存分块(Cache Tiling)。 预填充内核将计算任务分块调度到寄存器及 L1 至 L3 缓存中,在 16 核 Zen 5 上实现了 25.0 至 44.36 token/s 的预填充速度,性能提升达 77%。
- 自投机解码草稿器(Self-speculative Drafting)。 一个仅 1.64 MB 的 n-gram 草稿器将解码速度从约 9 token/s 提升至最高 14.7 token/s。
默认配置下,每一层的所有 6 个路由专家(Routed Experts)外加共享专家(Shared Expert)都会完整参与计算,没有对任何专家层做裁剪。
在本地运行 DeepSeek V4 Flash 所需的硬件配置
你需要至少 64 GB 的系统内存以及一颗较新的 x86_64 CPU(最好支持 AVX-512 指令集)。本文引用的所有 284B 实测数据均由项目维护者在同一台无 GPU 的 Linux 设备上测得:搭载 AMD Ryzen 9 9955HX(16 核 32 线程,64 MB L3 缓存)与 64 GB DDR5 内存 [待核实]。
| 设备类型 | 内存容量 | README 推荐搭配的模型 | 实测速度(0 GPU) |
|---|---|---|---|
| 笔记本电脑或迷你主机 | 16 至 32 GB | Nemotron-3.5-30B-A3B,14.35 GiB | 25.0 至 60.4 tok/s |
| 台式机或服务器 | 64 GB | DeepSeek-V4-Flash 284B,56.56 GiB | 预填充 44.4 tok/s,解码 9.1 至 14.7 tok/s |
| 八通道工作站 | 128 GB+ | DeepSeek 284B 或 Nemotron 30B | 111.62 tok/s(仅限 30B 模型) |
- 在 256K 上下文下,内存峰值约为 57.61 至 58.9 GiB,低于 62.5 GiB 的可用内存上限。在加载模型前请务必关闭其他占用内存的程序。
- 预编译二进制文件仅支持 Linux x86_64(
llama-server-modchip-linux-x86_64)。虽然./modchip安装脚本同时兼容 Linux 与 macOS,但仓库 README 中展示的 Apple Silicon 测试结果仅针对 30B 模型,而非 284B [待核实]。 - 内存带宽是真正的性能天花板。 项目 FAQ 指出,8 通道或 12 通道服务器主板的解码速度相比双通道 DDR5 大约能实现 3 到 4 倍的线性扩展。
代码仓库提供了一个无需下载模型即可运行的硬件兼容性检查脚本:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
建议在将脚本通过管道传给 Python 执行前,先审阅一下脚本源码。
如何在无 GPU 环境下分步运行 DeepSeek V4 Flash
方案一:向导式一键启动
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat 会在终端内直接打开一个带有实时 token/s 速率显示的对话窗口。其他常用子命令如下:
| 命令 | 功能说明 |
|---|---|
./modchip web |
在 http://127.0.0.1:8787 启动网页聊天界面与遥测面板 |
./modchip bench |
运行 30 秒基准测速并生成可分享的评分卡 |
./modchip claude |
启动已直接挂载到本地推理引擎的 Claude Code |
./modchip status / stop |
检查运行就绪状态或停止后台服务 |
方案二:直接运行二进制服务端
该方式会从 Hugging Face 仓库拉取 GGUF 权重文件与预编译服务端,并在 8080 端口启动服务:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
请将 -t 设置为你的物理 CPU 核心数。上面的示例使用了 32K 上下文窗口;若要复现 256K 上下文的测试数据,请使用 -c 262144。
注意一个兼容性坑:原版未打补丁的 llama.cpp、Ollama 和 LM Studio 无法直接加载这个模型文件。因为该检查点使用了自定义张量类型(ID 40),未打补丁的运行时会直接报错 unknown tensor type 40。请务必使用仓库自带的 ./modchip 脚本或打包好的二进制文件。
由于该服务端本质上是打过补丁的 llama.cpp llama-server,它原生支持兼容 OpenAI 格式的 /v1/chat/completions 路由:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
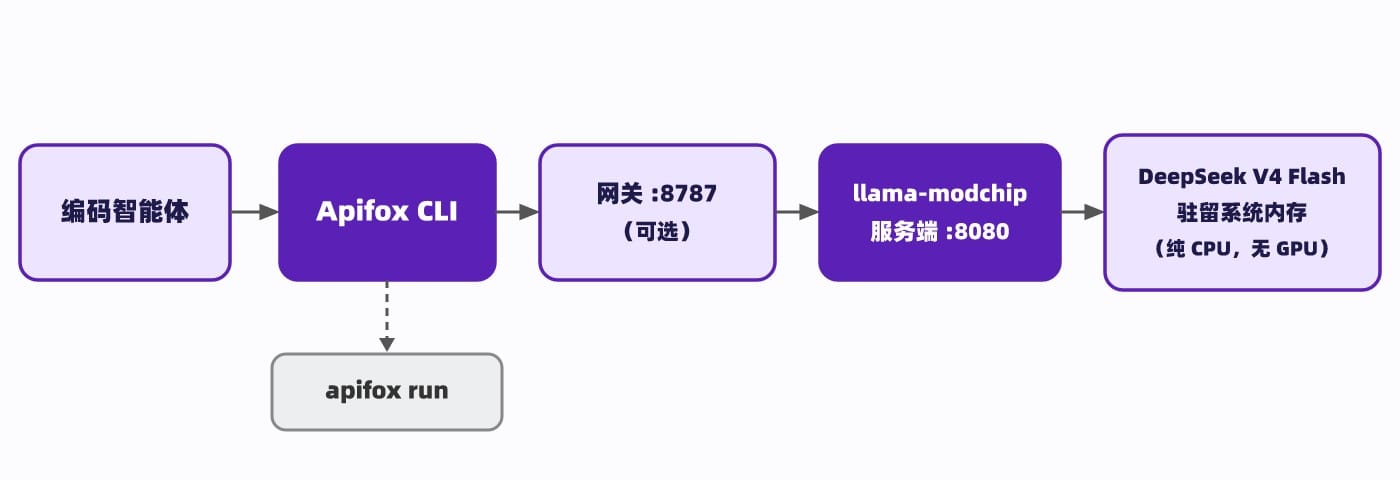
运行在 8787 端口的网关服务
gateway/sse_gateway.py 是运行在 127.0.0.1:8787 上的代理网关,负责将请求转发给底层推理引擎(可通过 LLAMA_BACKEND_URL 指定上游地址)。它同时暴露了 /v1/chat/completions、/v1/messages、/v1/models 和 /health 接口。如果设置了环境变量 GATEWAY_API_KEY,网关就会强制校验 Bearer Token。运行 ./modchip claude 时,Claude Code 正是连接到这个网关。
速度与质量的权衡:1.71 bpw 量化意味着什么?
上述速度数据是真实可复现的,但高度依赖特定配置。以下是维护者在 Ryzen 9 9955HX 上开启 256K 上下文运行 DeepSeek-V4-Flash 时的实测对比表 [待核实]:
| 配置方案 | 预填充速度 (Prefill) | 解码速度 (Decode) | 开启草稿器后的解码速度 |
|---|---|---|---|
未打补丁的 UD-IQ1_S(76.87 GiB) |
在 64 GB 内存上 OOM 或触发 Swap | 5.91 tok/s | 不适用 |
| v2.4.0 默认配置(Top-6,56.56 GiB) | 43.16 至 44.36 tok/s | 9.06 至 9.95 tok/s | 11.5 至 14.7 tok/s |
| 后半层采用 Top-5 | 43.16 至 44.36 tok/s | 9.68 至 9.87 tok/s | 12.2 至 15.1 tok/s |
| Top-4 加门控优先 SwiGLU | 43.16 至 44.36 tok/s | 10.12 至 10.74 tok/s | 13.0 至 16.0 tok/s |
你可以通过设置环境变量 LLAMA_MOE_TOP_K=5 或 4 切换到速度更快的档位。根据 README 说明,Top-5 相比默认配置的困惑度(Perplexity)大约只增加 0.42%。
不过在 Hacker News 的讨论中,有两个局限性被反复提及:
- 所谓的“无损(Lossless)”是指相对于 1.71 bpw 量化文件无损,而非相对于原始全精度权重无损。 文档中提到的 1.00000 余弦相似度,对比的是打补丁与未打补丁运行时在同一个极限压缩检查点上的输出(其中绝大多数路由专家处于约 1.56 bit 的
IQ1_S精度)。评论者普遍指出,模型量化低于 4 bit 后生成质量通常会出现肉眼可见的下降,且项目 README 并未提供与全精度原始输出的横向对比。 - 对于智能体工作流而言,预填充依然是最大瓶颈。 在 44 token/s 的预填充速度下,一段 10,000 token 的长提示词需要等待约 225 秒才能吐出第一个 token。虽然 KV 快照(包含 40 个工具定义的 Claude Code 提示词可在 13.1 至 32.6 毫秒内恢复)能加速多轮对话的后续轮次,但在面对全新上下文时依然需要完整预填充。
另外还要注意:该项目基于 7 月发布的 0731 版 V4-Flash 检查点构建,而 DeepSeek 此后已经发布了更新的 V4.1 Flash [待核实]。如果你更看重最新权重,可以先了解 DeepSeek V4.1 Flash 与 V4 Pro 及 V4 Flash 的对比评测。
因此,建议将本地运行的 284B 模型定位为用于草稿生成、离线批处理和本地实验的私密模型,并在投入实际使用前先用你自己的业务提示词做一轮充分验证。
让编码智能体通过 Apifox CLI 自动测试本地接口
本地运行的模型本质上依然是一个 API:它能否正常响应?返回的 JSON 格式是否合法?刚刚修改的启动参数有没有破坏输出结构?你可以结合 Apifox 与 Apifox CLI 让编码智能体自动执行这些检查——CLI 直接运行在你的本机上,能够直连 127.0.0.1 [待核实]。
首先在 Apifox 客户端中创建一个指向 http://127.0.0.1:8080 的本地环境(例如 local-dsv4),并为 POST /v1/chat/completions 接口配置自动化测试用例或测试场景:发送一段简短提示词,并添加状态码为 200、响应内容 choices[0].message.content 非空以及响应耗时低于 120 秒的断言 [待核实]。
接着在本机全局安装 Apifox CLI:
npm install -g apifox-cli@latest
配置完成后,即可让编码智能体(例如 Claude Code)调用 apifox run 命令自动运行该测试场景并汇总失败断言 [待核实]:
apifox run <collection-url-or-file> -r cli,json --timeout-request 180000 --upload-report
这里的 --timeout-request(单位为毫秒)非常关键 [待核实]:纯 CPU 运行的 284B 模型推理较慢,很容易触发默认的短超时限制。
这样做最大的价值在于横向对比:你可以在 Apifox 中再配置一个指向 DeepSeek 官方云端 API 的环境,对两边运行完全相同的测试场景,从而直观对比本地极低比特量化模型与 DeepSeek 官方云端 API 的输出差异。加上 --upload-report 参数还能将运行报告上传回 Apifox 客户端中查看 [待核实]。更多配置细节可参考在 Claude Code 中使用 Apifox CLI 及 Apifox CLI 安装指南。
本地纯 CPU vs 本地 GPU vs 云端托管 API
| 部署方案 | 所需条件 | 适用场景 |
|---|---|---|
| CPU 上运行 llama-modchip | 64 GB 内存,较新的 x86_64 CPU | 注重隐私、离线可用且零 API 账单成本(需接受较慢的预填充速度) |
| 使用 vLLM 或 SGLang 的 GPU 部署 | 大显存显卡或多卡服务器 | 追求高吞吐与更高精度的私有化自建部署 |
| DeepSeek 官方托管 API | 一个 API Key | 以生产级响应速度获取完整精度的模型输出 |
如果你打算采用 GPU 本地部署方案,可以参考如何在本地运行 DeepSeek V4(涵盖 vLLM 与 SGLang 配置);如果想了解新版检查点的显存计算方式,可查阅如何在本地运行 DeepSeek V4.1 Flash;关于将任意本地大模型作为 API 进行自动化测试的通用方法,可参考将本地 LLM 作为 API 测试的实战指南。
常见问题(FAQ)
我真的能在没有 GPU 的情况下运行 DeepSeek V4 Flash 吗?
可以,只需配合 llama-modchip 与 64 GB 系统内存。项目维护者在 16 核 Ryzen 9 9955HX 上实测预填充速度为 44.36 token/s,解码速度为 9 到 15 token/s,整个 56.56 GiB 模型完全驻留在内存中,无需动用交换分区(Swap)。
这个模型文件能在 Ollama 或 LM Studio 中直接加载吗?
不能。该检查点使用了自定义张量类型,未打补丁的原版 llama.cpp、Ollama 和 LM Studio 会报错 unknown tensor type 40 并拒绝加载。请使用项目仓库提供的 ./modchip 脚本或内置的 llama-server-modchip-linux-x86_64 二进制文件。
如果我只有 16 GB 或 32 GB 内存怎么办?
建议改跑 30B 规模的 MoE 模型。项目 README 推荐在该内存档位下搭配 14.35 GiB 的 Nemotron-3.5-30B-A3B,纯 CPU 下的实测生成速度可达 25.0 至 60.4 token/s。
每权重 1.71 bit(1.71 bpw)下的输出质量到底如何?
该项目并未提供与全精度 DeepSeek 的基准对比,Hacker News 上的不少评论者也对如此激进的量化精度持谨慎态度。在正式依赖它之前,建议先用你的真实提示词与官方托管 API 做一轮输出对比。
本地服务兼容 OpenAI 接口吗?
兼容。它本质上是打过补丁的 llama.cpp llama-server,因此在 8080 端口上原生提供 /v1/chat/completions 路由;此外,运行在 8787 端口的可选网关还提供了 Claude Code 所使用的 Anthropic 风格 /v1/messages 路由。
我的编码智能体可以自动测试这个本地模型吗?
可以。在 Apifox 中配置好指向 http://127.0.0.1:8080 的环境与 /v1/chat/completions 测试场景后,由智能体调用 Apifox CLI 的 apifox run 执行测试并汇总失败断言 [待核实]。