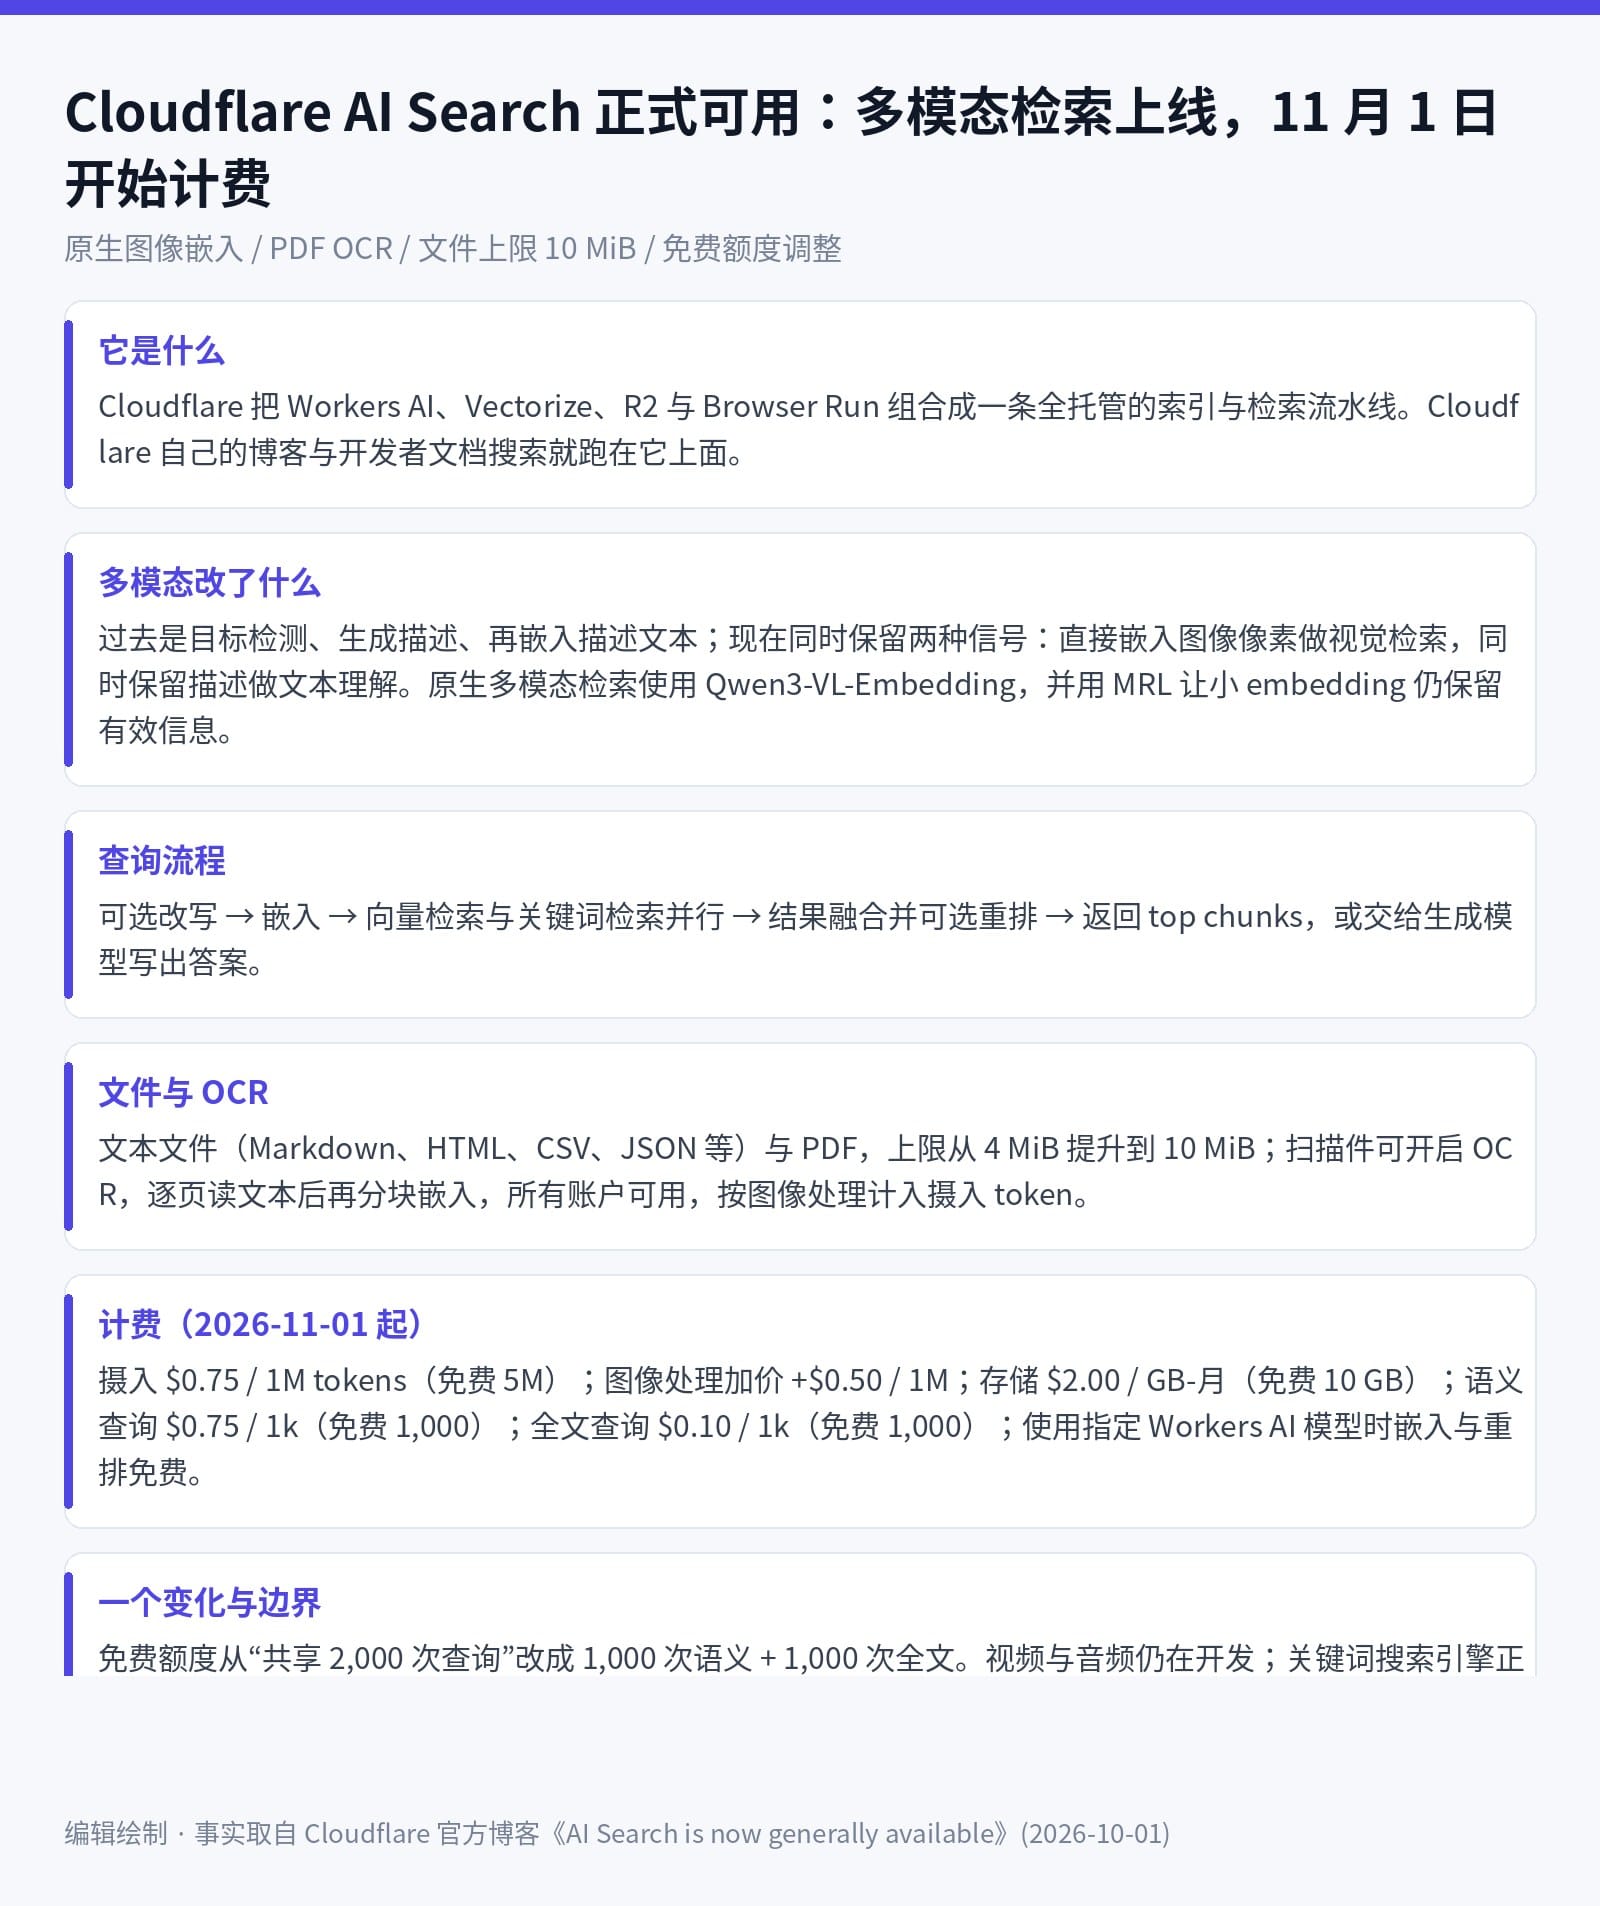
一句话概括:Cloudflare 的 AI Search 正式 GA,重点不是"能用",而是图片终于可以被直接检索:像素被原生嵌入,扫描版 PDF 可以开 OCR,单文件上限从 4 MiB 提到 10 MiB。同时官方宣布 2026 年 11 月 1 日开始计费,免费额度从"共享 2,000 次查询"改成 1,000 次语义 + 1,000 次全文。
做 RAG 的人对"图片命中率"这件事多半认命了:文档里那张架构图、那张截图,检索时永远搜不到,因为管道里只有文本。Cloudflare 在 2026 年 10 月 1 日的官方博客里,把 AI Search 推到了正式可用,并且专门改了这一点——管道的输入不再只是文字。
发生了什么:从"给图片写描述"到"直接嵌入像素"
AI Search 本身不是新产品。按官方说法,它是把 Workers AI、Vectorize、R2 和 Browser Run 组合成一条全托管的索引与检索流水线,上线一年多,Cloudflare 自己的博客搜索和开发者文档搜索就跑在它上面。这次 GA 的增量集中在多模态:原生图像嵌入、PDF 的 OCR,以及更大的文件上限。
官方对旧实现的描述很坦白:以前的做法是"naive"的——先做目标检测,生成一段描述,然后嵌入这段文字。结果是产品质感、截图里的界面状态、图表之间的关系、文档版式这些信息,在像素被压缩成一句描述的时候就丢掉了。新的实现同时保留两种信号:像素被直接嵌入用于视觉检索,描述被保留用于文本理解。为了保证更丰富的表示不会撑爆存储,官方引入了 Matryoshka Representation Learning(MRL),让小尺寸的 embedding 依然保留有效信息。原生多模态检索目前由 Qwen3-VL-Embedding 模型提供。
查询时的行为也做了兼容处理:系统会先看当前实例的 embedding 模型是否支持图片。支持,则查询图片被直接嵌入,落在与索引里的图片、文本同一个向量空间;不支持,就把查询图片用 ToMarkdown 转成文本、以描述的形式去搜。官方把这个设计说成"给所有模型基本的多模态支持,而原生支持图片的模型能拿到完整的视觉信号"。
一个完整场景:把内部文档站接进检索
假设你要给自己团队的知识库做检索,材料是产品文档、几十份 PDF 白皮书,以及一批历史截图。整条链路按官方描述是这样的:文件进入摄入管道,文本文件按常规分块并嵌入,扫描版 PDF 打开 OCR 开关后逐页读出文本再分块;查询进来后,可选的改写先跑一遍,然后嵌入,向量检索和关键词检索并行执行,结果被融合、可选重排,最后返回 top chunks,或者直接交给一个生成模型写出答案。
对做 Agent 的人来说,最有价值的一步是最后那句"或交给生成模型写出答案"——它意味着检索不是一个需要你自己拼装向量库、解析器和重排器的项目,而是一段可以接进 Agent 工具调用链的服务。OCR 的工作方式也值得注意:它逐页读取再分块,按图像处理计入摄入 token,而不是按页数或按次收费。
计费:11 月 1 日这条线怎么划
GA 同时是一个计费节点,官方明确从 2026 年 11 月 1 日起开始对 AI Search 收费,并说会在此前发提醒邮件。口径按三类算:摄入、存储、查询。基础摄入 $0.75 / 1M tokens,图像处理作为附加项再加 $0.50 / 1M tokens;存储 $2.00 / GB-月;语义查询(混合与向量检索)$0.75 / 1k 次,全文查询 $0.10 / 1k 次。解析、分块、用 Workers AI 模型做嵌入、关键词索引、重排都包含在内,没有实例小时费、容量单位或月度最低消费。
免费额度覆盖所有 Workers 套餐:每月 5M 摄入 tokens(这是一个跨文件类型的单一池子,文本和图片共用)、10 GB 存储、1,000 次语义查询、1,000 次全文查询。这里有一个官方主动标注的变化:预览阶段公布的是一个共享的 2,000 次查询池,现在改成语义和全文各 1,000 次。对绝大多数小规模知识库来说,这个额度的实际约束仍然是存储的 10 GB 和摄入的 5M tokens。
为什么这会改变 AI Agent 的检索工作流
第一,它把"多模态检索"从自建项目变成了一个开关。过去要支持图片检索,你得自己选一个多模态 embedding 模型、自己处理查询图与索引图不同空间的问题、自己决定文本查询和图片查询怎么融合。现在这件事被收进了一条托管管道,而且文本模型和原生多模态模型走的是同一条路径,只是精度不同。
第二,它为"扫描件"这个长期例外项给出了默认答案。企业知识库里有大量 PDF 其实是扫描图像,没有可提取文本;OCR 从"自己外挂的预处理步骤"变成了管道里的一个选项,代价被明确标成图像处理的 token 消耗,可预算。
第三,对 Agent 而言,检索质量的上限往往由"能不能找到那张图/那份表"决定,而不是由生成模型决定。像素级嵌入直接把这条上限抬高一截,尤其在截图、图表、版式这类内容上。
限制与人应该在哪儿接管
官方列出的后续工作同时也是当前的边界:视频与音频的处理管道还在建,现在还不能把富媒体资产丢进去搜;关键词搜索引擎正在重构,官方说明当前实现在大数据量下有上限,也就是说数据规模越大,越应该关注全文检索这一路的召回表现;另外"为已经在 Cloudflare 上的网站提供更简单的启用方式和索引创建"也仍在开发中。
需要人接管的地方有三处。一是文件上限:10 MiB 是硬边界,超过的文档必须自己在摄入前切分。二是 OCR 的开启判断:扫描件开 OCR 是对的,但含大量图片的正常 PDF 也打开它,会把摄入成本推上去。三是重排是否启用——官方描述里重排是"可选"的一步,它影响延迟和结果质量之间的取舍,这个取舍应该由你的场景决定,而不是默认值。
如何试用
AI Search 在 Cloudflare 的 Workers 生态内,配置入口、数据源、模型与限制都在 AI Search 的开发者文档里;计费从 11 月 1 日开始,此前使用不产生费用。建议先用一份包含扫描件和截图的真实文档集跑一轮查询,重点看两个指标:纯文本查询能否命中图片内容,以及开启 OCR 之后的摄入 token 消耗是否符合预期——这两个数字决定了它在你的成本结构里是不是划算。
信息来源
- Cloudflare 官方博客《AI Search is now generally available》(2026-10-01,作者 Gabriel Massadas、Nelson Duarte、Ashish Vinodkumar):blog.cloudflare.com/ai-search-ga/
- AI Search 开发者文档(配置、数据源、模型与限制):developers.cloudflare.com/ai-search/
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
