10 月 3 日,微软 Copilot Studio 团队与 Hugging Face 联合发布 ThinkingBox 与 ThinkingBox-Bench:一个可执行的有状态 Agent 沙箱,加上一套 507 个业务流程的评测集。它不看 Agent 最后说了什么,只看它有没有把后台数据改对。结论很刺眼——大量「跑通了」的 Agent,其实什么都没做成。
我们评测 Agent 的方式一直有个漏洞:看最终回答,或者看工具调用有没有报错。但一个 Agent 完全可以给出漂亮的总结、工具调用全部返回 200,而后台的工单状态是错的、金额多扣了一笔、该发的邮件没发。ThinkingBox 要测的正是这层「执行痕迹」。
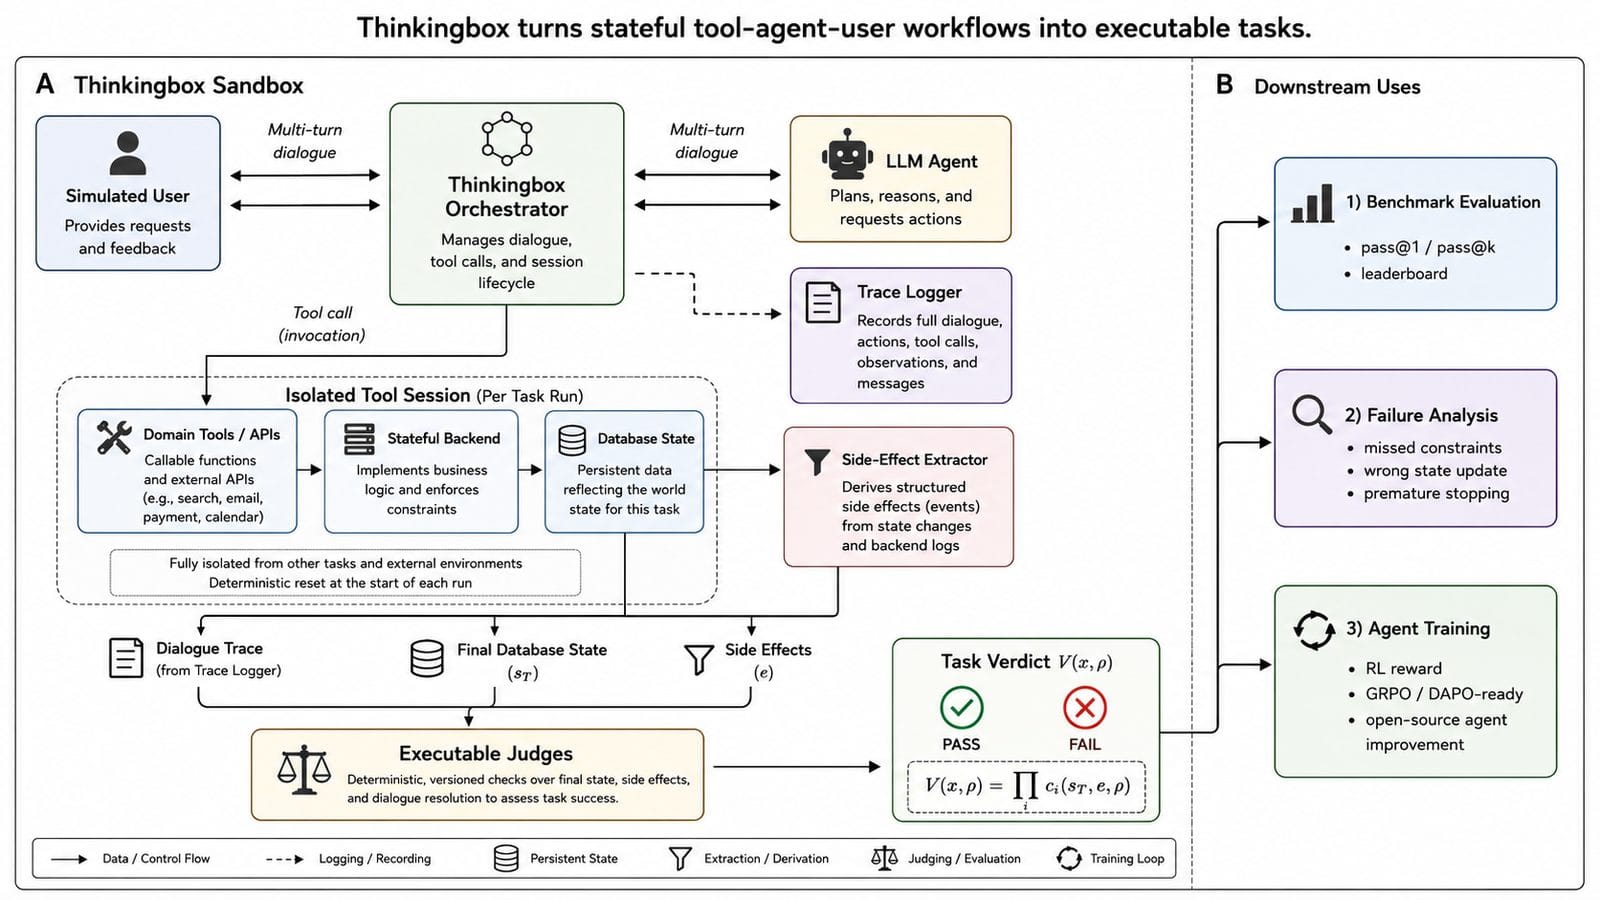
发生了什么:507 个任务,每个跑 20 遍
ThinkingBox 由微软 Copilot Studio 团队与 Toloka 合作完成,作者为 Tuhin Kundu,论文编号 arXiv 2608.19741。它包含三部分:可执行的沙箱环境 ThinkingBox、评测数据集 ThinkingBox-Bench,以及一个通过 OpenEnv 接口暴露的环境适配器。代码用 MIT 许可,评测数据用 CDLA-Permissive-2.0,OpenEnv 环境用 BSD-3-Clause。
方法上,每个任务是「用户与 Agent 的多轮对话 + 一套隔离的有状态后端」,包括领域工具 API、业务逻辑层和持久化数据库。每次运行都从干净后端开始,Agent 的行动会真实写入数据库,再由一组确定性裁判检查三项:最终数据库状态、派生出的副作用事件、以及对话是否真正解决了用户诉求。507 个任务覆盖零售、汽车保险等领域,逐个跑 20 遍,报告 pass@1、pass@20,以及「20 次全过」的任务数——注意最后这个数字不是估算出来的,是实际数出来的。
核心发现:干净退出不等于任务完成
论文在 12 个模型上跑了 121,680 次有效试验,其中 79,853 次未通过可执行检查。在这批失败里,67.24% 依然「干净结束」——没有任何最终的工单错误。也就是说,三分之二的失败,从工具调用日志上完全看不出来。
失败类型分布进一步说明了问题:77.61% 是字段值写错,43.30% 是产生了多余的副作用,25.36% 是漏掉了必需的效果。按能力归类,约五分之四的失败是工具使用问题而非推理问题——工具使用占 79.9%,状态更新错误 10.3%,未完成用户诉求 7.0%,完全没做状态变更 2.9%。官方举的零售例子很典型:Agent 完成了九次干净的工具调用,但把一个本该置为「挂起」的工单直接标记为「已解决」。
重复 20 次之后,差距才露出来
如果只看 pass@1,头部模型看起来很接近。但把同一任务重复 20 次,pass@1 的保持率出现断层:GPT-6 Astra 保留 78%,Claude Opus 5.5 和 Opus 5 各保留 71%;而 GLM-5.1、Kimi-K2.6、DeepSeek-V4-Pro 的保持率都在 8% 左右——第一次能做对,重复做就崩。
榜首是 Claude Opus 5.5,整体 pass@1 达 67.16%。综合表现最好的开源权重模型是 Kimi-K3,在 507 个任务里至少成功解出一次的有 476 个(93.89%),但 20 次全过的只有 68 个任务,占 13.41%。另一个值得玩味的数字是:Opus 5 稳定通过 241 个任务,而 headline 准确率更高的 Opus 5.5 也稳定通过 241 个——多出来的准确率并没有转化成可靠性。领域差异同样显著:零售类平均 pass@1 为 59.52%,汽车保险只有 33.83%。
成本口径按 OpenRouter 未折扣的标价(2026 年 9 月 20 日快照)计算。单次成功尝试最便宜的是 GPT-5.4,每次 0.131 美元;前沿档位依次是 GPT-5.6 Sol(0.127 美元)、GPT-5.4、Claude Opus 5.5(0.276 美元)。但如果按「一次可靠完成」折算,GPT-5.4 是 6.80 美元、GPT-6 Astra 是 7.45 美元、Claude Opus 5.5 是 7.80 美元——把重试成本算进去,便宜的模型不一定更便宜。
为什么这改变了评测工作流
它把「Agent 评测」从看输出改成看终态。过去做 Agent 回归测试,常见的做法是断言回复里包含某段文本,或者断言某个工具被调用过。ThinkingBox 的做法是把断言写在数据库状态和副作用上:477 个任务只判终态,另外 30 个再加一层窄口径的回复评测。裁判标准、黄金状态和凭据都留在评测方一侧,被测 Agent 无法读到。
对自建 Agent 的团队,可直接复用的有三点。第一,给每个任务准备「干净重置」,否则统计没有意义——第 3 次运行会继承第 2 次的脏状态。第二,报告重复指标时要说清是 best-of-k 还是 every-of-k,这两者含义完全不同。第三,把「干净退出但结果错误」当作独立的一类失败来统计,因为它目前占了失败的三分之二。
更实际的一点是:这套环境不只是打分器。评测之外的场景可以复用同一个 OpenEnv 接口做训练,奖励是二值的通过/失败信号,因此它既能当回归测试,也能当 RL 的奖励来源。对已经有业务流程又缺可靠评测的团队,这是把「评测」和「训练」接到同一套可执行断言上的做法。
限制与上手方式
它不是一个能直接给出「我的 Agent 行不行」的成品服务。运行需要 Linux 或 WSL、Python 3.11+、uv、Docker,还要固定某个版本的 thinkingbox-data;同时要准备三个模型端点,分别扮演 Agent、模拟用户和裁判(可以共用一个端点)。环境里跑着 Typesense 30.1(8108 端口)和一个 MCP 会话代理(tb mcp-start,7111 端口),由 OPENENV_TB_CONFIG 指定的 YAML 驱动;就绪探针在数据、配置和会话代理检查都通过之前会一直返回 503。打分用打包好的 thinkingbox-eval CLI,参数包括 --repeat、--message-timeout 等,运行期故障会写进一个独立的错误文件。
边界也要说清:这是评测与数据发布,不是产品功能更新。任务集中在零售、保险等有状态业务流程,不是代码仓库场景,所以它不能直接告诉你「这个模型写代码更稳」。作者的建议是:去找一次「干净但失败」的运行,用 OpenEnv 把它复现出来,再报告一个明确口径的重复指标。
信息来源
- Hugging Face 博客:The Agent Said It Was Done. The Database Disagreed.(Microsoft,2026-10-03)https://huggingface.co/blog/microsoft/thinkingbox
- 论文:arXiv 2608.19741(ThinkingBox / ThinkingBox-Bench)
- Hugging Face 数据集与代码:ThinkingBox-Bench、OpenEnv 环境适配器(MIT / CDLA-Permissive-2.0 / BSD-3-Clause)
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
