Jev 是 TypeSafe AI 的 System One Model:你向它发送程序状态和带类型的问题,它返回带有校准概率的决策,而不是一段散文式的文字。(这里说的是 Jev 模型,不是主播 FaZe Jev,也不是 JEV 疫苗。)它权重闭源、只提供 API,服务端点为 POST https://api.typesafe.ai/v1/systemone,模型标识为 jev-latest。所以“在本地运行 Jev”不可能指 Jev 本身,而是指一批几天前才出现的社区项目——以 OpenJev 为首——它们用开源模型复现这个思路。如果你还不了解这个模型本身,先读一读 Jev 是什么;本文讲的是这些模仿者。
这既是一篇盘点,也是一次现实检验:每个 README 声称了什么、还原度有多高、需要什么硬件,以及如何像测试 TypeSafe API 那样,通过 Apifox 中的本地 HTTP 接口来测试它们。这些项目没有一个是第三方基准测试的结果,也没有一个出自 TypeSafe。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

“在本地运行 Jev”可以指什么
TypeSafe 的 发布文章描述了一个用 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)训练的模型,包含三个原语(noul、choice、score),响应时间 70ms 到 500ms,输入 token 每百万 $0.042,输出免费。这些都是厂商说法;训练方案并未公开。一个社区帖子称 Jev 完全使用合成数据训练。请把这当作未经证实的传闻。
由于训练方案保密,每一个“开源 Jev”都走了三条捷径之一:
- 从冻结的对话模型上读取 logits。向一个小型 Qwen 提一个多选题,跳过生成,把每个选项对应的下一 token logits 转成概率。OpenJev 和 mini-jev 就是这么做的。
- 从零训练一个小型打分器。模型唯一的工作就是在一次前向传播中针对上下文为 N 个选项打分。jevlike 就是如此。
- 改造解码引擎。保留基础模型,在受限候选集上并行评估每个字段。Hugging Face 上的 Apple Silicon 引擎和那个 vLLM pull request 属于这一类。
它们都没有复现 RLCD。这才是最诚实的结论。
OpenJev:在一块 3090 上从冻结的 Qwen 读取 logits
OpenJev 提出的问题是“我们能在家里用一块 3090 跑一个类似 Jev 的东西吗?”,给出的答案是一个 MIT 许可的 Python 包。它的 README 措辞谨慎:它“用开源模型复现了那种接口模式,但并没有复现 Jev 未公开的模型或训练方法”。
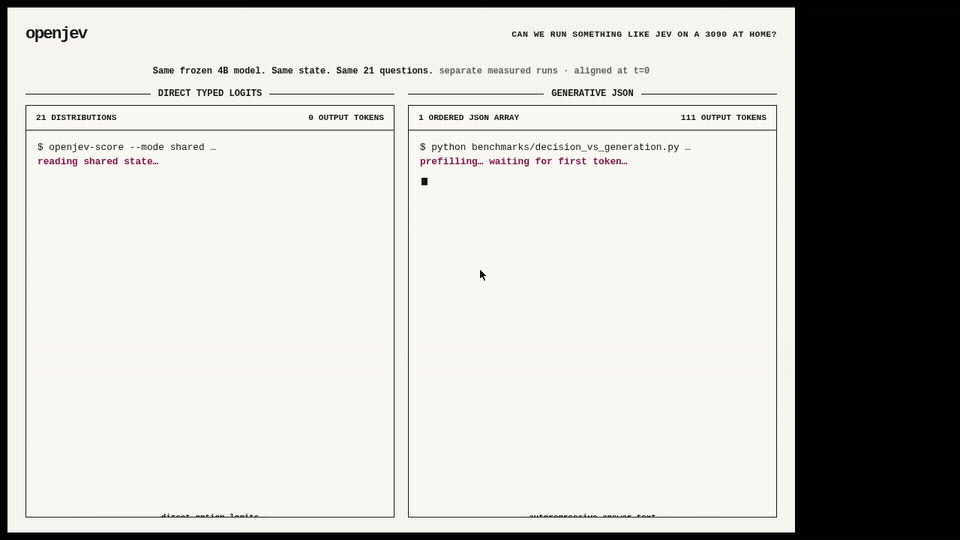
它的机制是一次前向传播读取声明好的选项 logits,不采样任何答案 token。判定标准和选项随每次请求传入,所以不需要针对任务做任何微调。主模型是 Qwen3.5-4B。
README 在一块 RTX 3090 上使用 Qwen3.5-4B 报告的数据:
- 直接读取带类型的 logits:21 组概率耗时 1.023 秒,而自回归生成 JSON 数组耗时 5.332 秒,慢 5.21 倍。
- 在 102 行的 TypeSafe 子集上,众数一致率为 0.845,而已发布的 Jev 为 0.883。
输入是 JSONL,包含 id、state、question,以及由 {id, description} 组成的 options 数组;输出是每个选项的概率。仓库里没有 HTTP 服务:你运行 openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl,或者试试 openjev.com 上的 WebGPU 演示。硬件要求:CUDA,以及一块能以 BF16 装下 4B 模型的 GPU。
它缺少的东西:没有 noul 和 score 原语,而且这些概率只是选项 logits 的 softmax,不是经 RLCD 校准的置信度。
mini-jev:带本地服务的一次预注册研究
mini-jev 更像一次实验,而不是一个产品。它的标语是:“在一个冻结的 Qwen3-4B 上,Jev 风格的接口长什么样——读取选项字母的 logits,而不是生成 JSON。”它在 CLINC150 意图分类任务上运行 Qwen3-4B-Instruct-2507,把语法约束的 JSON 生成与读取选项字母 logit 的方式做对比。
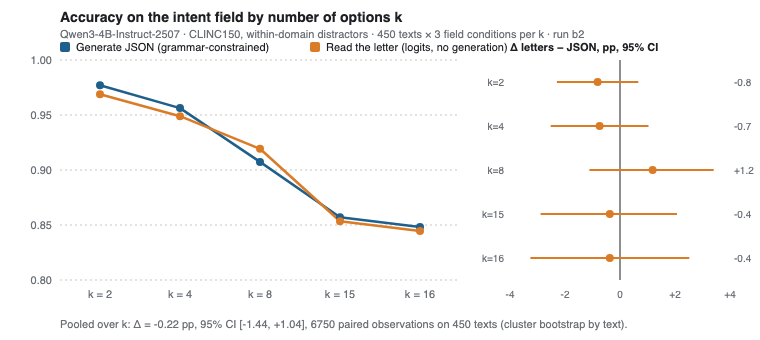
结果来自 6,750 组配对观测:JSON 准确率 0.909,字母方式 0.907,相差 -0.22 个百分点,落在 95% 置信区间 [-1.44, +1.04] 之内。在 32 个 token 的文本上,读取字母大约快 4 倍。
README 把它的术语对应到 TypeSafe 的术语上:choice 和 noul 是“本研究在冻结模型上测量的东西,分别对应字母读取和布尔值;score(一种有序量表)没有被测量”。它称这是“术语上的对应,而不是对其模型的复现”,并加上了每个项目都该照抄的那句提醒:“字母占比是一种带置信度差距的排序,不是校准过的概率。”
它自带一个 HTTP 演示。MINIJEV_DEVICE=mps uv run python demo/server.py 会在 127.0.0.1:8765 上提供服务,接口是 POST /run,接受 schema 和 text,返回每个字段的 letter、p、gap 和 answer。在 Apple Silicon 或 NVIDIA GPU 上大约需要 8.5 GB 内存。MIT 许可,写作时有 11 个 star。
jevlike:从零训练的选项打分器
jevlike 被当作一个“逆向工程出的类 Jev 模型”流传。README 说的却不是这样:“TypeSafe 并未公开其设计。本仓库是一个独立的入门模型,只是输入输出形状相同。”作者还补充说,他们“没有证明与 Jev 质量相当,也没有复现 TypeSafe 的私有训练方法”。
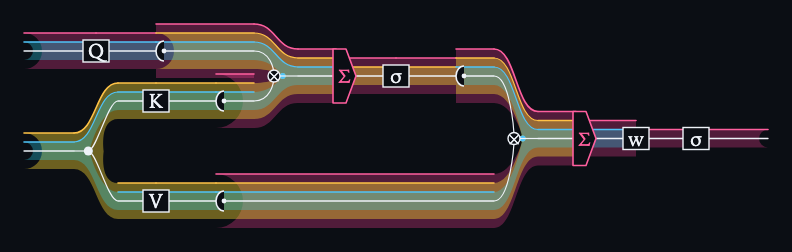
它的设计很简单。每个选项得到一个 query 向量,对上下文 token 做注意力;用一个共享的点积为每一对打分;softmax 把分数转成概率。默认编码器是从零学习的字节嵌入,也可以选用冻结的 Hugging Face 编码器。
报告的数据:合成菜单任务上约 98%;在 Wikispeedia 上,用冻结的 Qwen2.5-0.5B 编码器达到 26%,而打乱对照组为 8%;一次前向传播“比被迫输出 400 个 token 的小型解码器快约 100 倍”。它可以在 CPU、MPS 或 CUDA 上运行。MIT 许可,764 个 star。
还原度是这几者中最低的。你要用自己的标注数据训练它,所以它是你构建的分类器,而不是能接受任意判定标准的决策模型。没有 noul 或 score,没有关于校准的说法,也没有 HTTP 服务。
并行约束解码:Apple Silicon 引擎
Hugging Face Space parallel-constrained-decoding 被当作“Typesafe.ai Jev 的开源替代品”流传,但它的 README 从未提到 Jev、TypeSafe 或 RLCD。它的标题是“Parallel Constrained Decoding for Apple Silicon”:一个用于结构化抽取的 MLX 推理引擎,基于 mlx-community/Qwen2.5-1.5B-Instruct-4bit,任何 mlx-lm 解码器都可以替换进来。
方法:把上下文一次性 prefill 进 KV 缓存,广播到每个 schema 字段,只评估每个字段合法的候选 token ID,在这个集合上做 softmax,然后在代码里拼装 JSON。README 在 M4 Max 上报告:4 字段的欺诈分诊自回归 420 ms、并行 75 ms(5.6 倍);28 字段的客服分诊 1,900 ms 对 270 ms(7.0 倍)。它声称 schema 有效率为 100%,这源于从不采样自由文本。
它通过 uvicorn 在 8000 端口提供 HTTP 服务,返回 parsed_json 以及带每个字段置信度的 field_telemetry。要求:M1 或更新的 Mac,macOS 14+。Apache 2.0 许可。没有准确率数据,只有延迟;这里的“校准”指的是对候选集做精确的 softmax,而不是训练出来的校准。
vLLM PR 57250:为 DiffusionGemma 加一个类 Jev 模式
vLLM pull request #57250 于 9 月 16 日提交,至今仍处于 open 状态,它把 DiffusionGemma 变成作者所说的“校准过的多选题机器”:一块带种子的画布,配单 token 答案槽,在步数上限处读取,置信度来自 logprobs 和熵。新增的 vllm_xargs 字段包括 diffusion_seed_canvas、diffusion_max_steps 和 diffusion_read_only,另有一个示例 structured_server.py 把 schema 翻译成画布。
该 PR 报告单次画布读取每秒 8.7 个请求,32 路并发时达到 54 个,在一个语言分类语料上准确率约 90%。一位 reviewer 指出缺少竞态条件测试和线程无限创建属于阻塞项。在合并之前,它是一个值得阅读的设计,而不是可以部署的东西。
各自的还原度如何?
| 项目 | 基础模型 | 原语 | 校准方式 | HTTP 服务 | 硬件 |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B,冻结 | choice | 对选项 logits 做 softmax | 否(CLI + 浏览器演示) | RTX 3090 级别,CUDA |
| mini-jev | Qwen3-4B-Instruct,冻结 | choice、noul | 带差距的排序 | 是,8765 端口 | 8.5 GB 内存,MPS 或 CUDA |
| jevlike | 自行训练的编码器 | choice | 未声称 | 否 | CPU、MPS 或 CUDA |
| MLX 引擎 | Qwen2.5-1.5B-Instruct-4bit | schema 字段 | 对候选集做 softmax | 是,8000 端口 | Apple Silicon,macOS 14+ |
| vLLM PR | DiffusionGemma | yes/no、choice、scale | logprobs 加熵 | 是,兼容 OpenAI | vLLM 级别 GPU,未合并 |
每一行都是冻结的或自行训练的模型在读取 logits。这样你能得到 Jev 的形态:带类型的答案、每个选项一个概率、一次前向传播。但你得不到 Jev 的核心主张——RLCD 让这些概率变得诚实。OpenJev 的 0.845 对 0.883 是唯一与真实模型的对比,而且它来自作者自己的评测。部署条件与我们那篇在本地运行 Kimi K3 的指南一致:权重、一块 GPU 或 M 系列 Mac、一个本地端口。
在 Apifox 里像测试真实 Jev API 一样测试它们
做本地复现的意义在于:不必重写集成代码就能把它换成真实 API,所以你的测试应该向两者发送相同的 body。这些项目没有一个原生支持 Jev 的 {model, state, questions} schema。在你实际运行的那个前面放一层轻量适配器:一个 40 行的 FastAPI 应用,接受 Jev 的 body,调用该工具,并返回带 choice、probabilities 和 confidence 键的 {"answers": {...}}。这样 Apifox 看到的就只有一份契约。
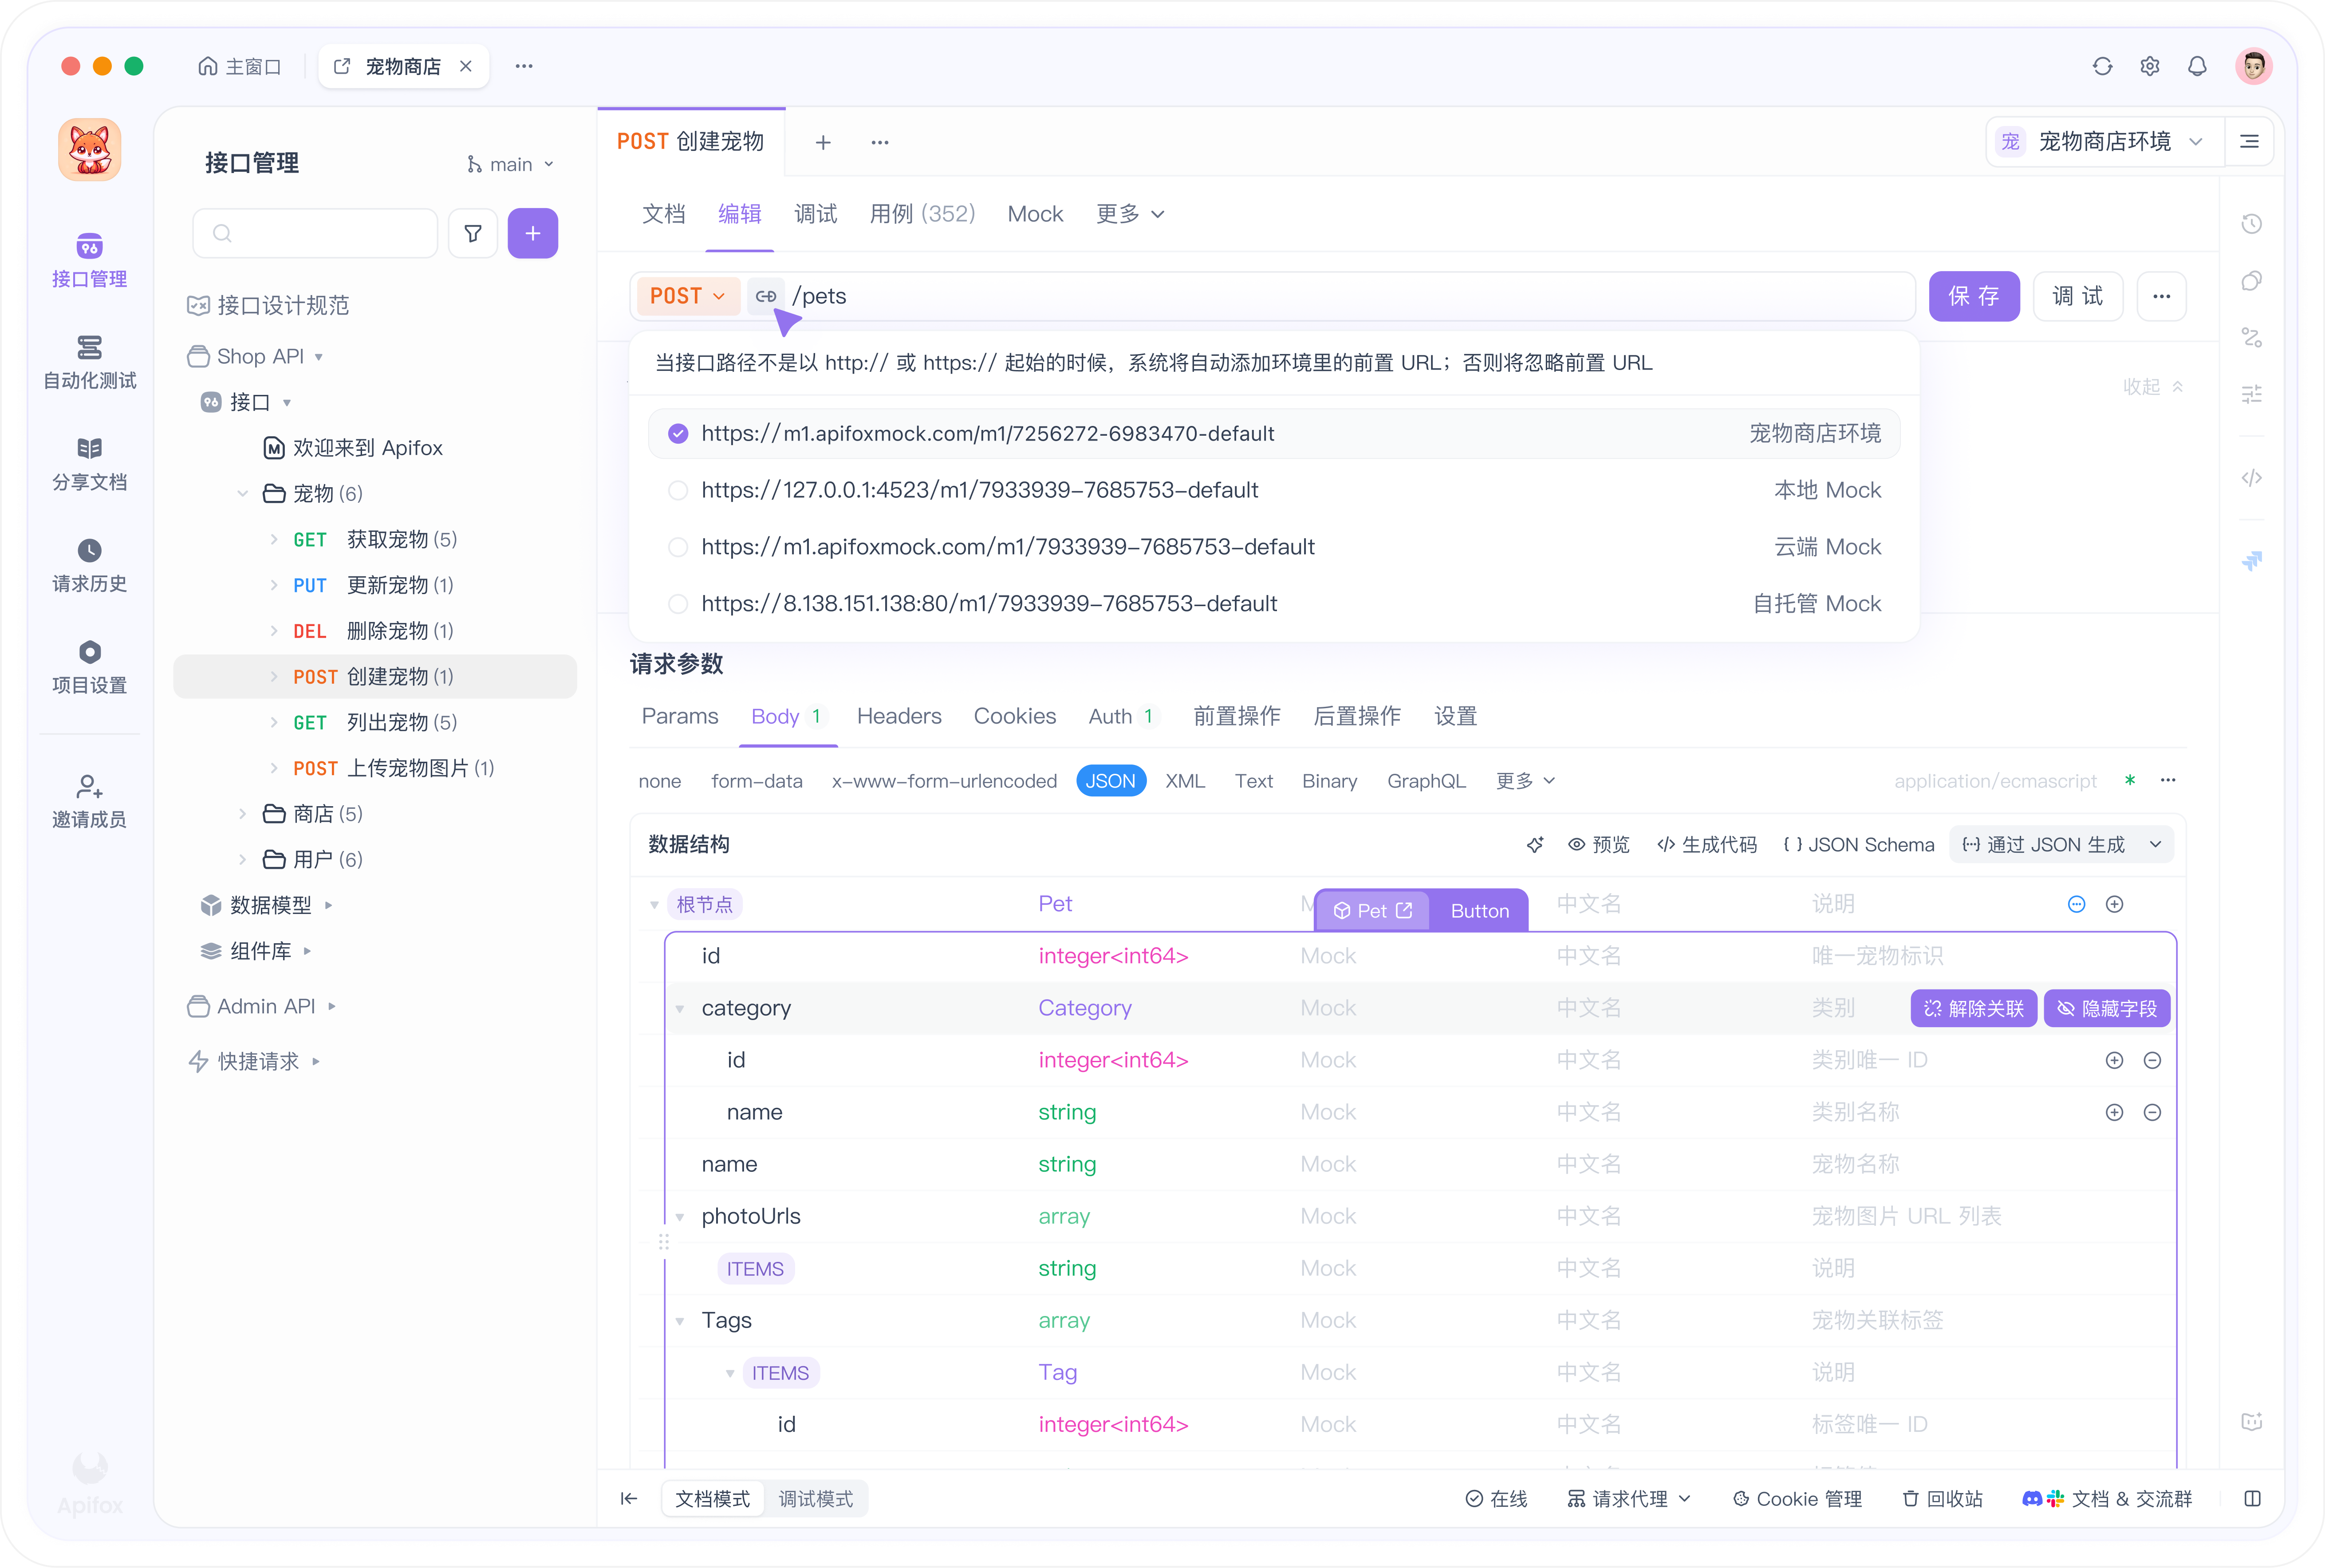
两个环境,一套请求。创建 Local reproduction,设置 BASE_URL = http://localhost:8765,不带 key;再创建 TypeSafe API,设置 BASE_URL = https://api.typesafe.ai,并把 TYPESAFE_API_KEY 放在本地字段中,这样它永远不会同步给队友(作用域规则见这里)。每个请求都使用 {{BASE_URL}}/v1/systemone 和 Bearer {{TYPESAFE_API_KEY}};本地服务会忽略这个 header。
发送 Jev 的 body。用你要发给 jev-latest 的 state 和 questions,发起 POST {{BASE_URL}}/v1/systemone:
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
对概率字段做断言。添加后置处理器断言:answers.department.choice 等于 billing;answers.department.probabilities.billing 大于 0.7;answers.wants_refund.noul 大于 0.8。切换环境下拉框,对 TypeSafe 跑同一个测试场景。两次运行之间的差距就是你的还原度数字,它比任何 README 表格都更有价值。
把本地运行结果保存为 mock,这样前端就能在零 GPU 开销下基于一个稳定的 answers 对象开发。聊天模型的相同套路见“把本地 LLM 当作 API 来测试”。
常见问题
OpenJev 和 Jev 是同一个东西吗?
不是。OpenJev 从一个冻结的 Qwen3.5-4B 读取选项 logits,并在 README 中如实说明。Jev 是 TypeSafe 用 RLCD 训练的闭源模型。OpenJev 报告在 102 行子集上与 Jev 的众数一致率为 0.845,数据来自作者自己的评测。
我应该先试哪一个?
如果你用 Mac,并且今天就想有一个 HTTP 接口,选 mini-jev;如果你有 NVIDIA GPU,并且想要与 Jev 最接近的公开对比,选 OpenJev。只有当你手头有可用于训练的标注数据时,才选 jevlike。
我能从冻结模型得到校准过的概率吗?
仅靠读取 logits 不行。正如 mini-jev 的 README 所说,对选项 token 做 softmax 得到的是一种带差距的排序。校准需要训练,或者在你的标注集上做温度缩放之类的后处理步骤,而这些项目都没有提供。
运行这些项目比付费使用 TypeSafe 更便宜吗?
输入 token 每百万 $0.042、输出免费,Jev 已经处于最便宜的 LLM API 提供商的价格下限。一旦把 GPU 时间算进去,本地方案的优势在隐私和离线使用,而不在成本。
这意味着什么
OpenJev、mini-jev、jevlike、MLX 引擎以及那个 vLLM PR 都证明了一个观点:决策不需要生成文本,一次前向传播读完 logits 更快。它们都没能证明自己是校准过的,也都不是 Jev。把一个跑在 Jev 形状的适配层后面,保留第二个指向 TypeSafe 的环境,让你的断言来决定两者相差多远。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。

值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会

