大多数 Agent 代码库中都包含一个没人愿意维护的文件。它保存着四十个工具定义,每一个都是手写的 JSON Schema,用于描述一个在别处早已定义好数据模型的接口。一旦 API 团队发布了一个新的必填字段,规范更新了,文档更新了,但 Agent 依然在发送旧的数据 payload,直到有人注意到 400 错误。
实际上,你已经拥有了每个接口的机器可读描述,那就是 OpenAPI 文档。现在的任务是将这些文档转换为模型可以调用的工具定义,并让两者保持自动同步,而不是依靠人工记忆。
本指南将介绍 OpenAPI 操作如何映射到工具数据模型、生成器在此过程中需要修复哪些问题、如何将包含 200 个接口的规范精简到模型可以推理的合理范围,以及如何测试生成的工具是否能正常工作。如果你处于技术栈的更上游,我们关于“当 Agent 编写代码时是否仍需要 API 工具”的文章提供了更广泛的背景信息。
Apifox 在这里至关重要,因为只有规范本身正确,基于它生成的内容才可能正确。工具定义会继承源文档中的每一个缺陷。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
手写工具定义的代价
当只有五个接口时,手写工具定义感觉还行。但当数量达到二十个左右时,由于以下三个原因,这种方式就难以为继了。
定义漂移。 规范是由代码生成的,或者由 API 团队维护。而工具文件则由构建 Agent 的人维护。由于两者之间没有任何关联,它们会悄无声息地产生偏差,而最先出现的症状就是 Agent “突然”停止工作。
描述变得简陋。 当一个人手动编写四十个数据模型时,最后二十个往往只配有一行简短的描述。模型是通过阅读这些描述来选择工具的,因此简陋的文本会直接降低工具选择的准确性。我们关于 Agent 工具数据模型设计的文章深入探讨了为什么措辞如此重要。
错误在运行时才会暴露。 如果手写的数据模型将某个字段声明为字符串,而 API 实际上需要一个整数,那么在生产环境中,当 Agent 第一次尝试执行真实任务时,就会产生 422 错误。
从规范中自动生成可以一次性解决这三个问题。这样就有了单一的事实来源,描述使用的是与文档相同的文本,而类型则来自于服务端进行校验所依据的相同数据模型。
OpenAPI 操作如何转换为工具
这种映射关系比看起来更加直接。以单个操作为例:
paths:
  /orders/{orderId}/refund:
    post:
      operationId: refundOrder
      summary: Refund an order
      description: >
        Issues a full or partial refund against a completed order.
        Refunds are irreversible. Partial refunds require an amount
        no greater than the remaining refundable balance.
      parameters:
        - name: orderId
          in: path
          required: true
          schema: { type: string }
          description: The order to refund.
      requestBody:
        required: true
        content:
          application/json:
            schema:
              type: object
              required: [reason]
              properties:
                amount:
                  type: integer
                  description: Amount in cents. Omit for a full refund.
                reason:
                  type: string
                  enum: [duplicate, fraudulent, requested_by_customer]
由此生成的工具定义如下:
{
  "name": "refundOrder",
  "description": "Issues a full or partial refund against a completed order. Refunds are irreversible. Partial refunds require an amount no greater than the remaining refundable balance.",
  "input_schema": {
    "type": "object",
    "required": ["orderId", "reason"],
    "properties": {
      "orderId": { "type": "string", "description": "The order to refund." },
      "amount": { "type": "integer", "description": "Amount in cents. Omit for a full refund." },
      "reason": { "type": "string", "enum": ["duplicate", "fraudulent", "requested_by_customer"] }
    }
  }
}
以下四个规则完成了大部分工作:
operationId成为工具名称。如果某个操作没有operationId,则根据方法加路径生成一个稳定的名称,然后将其添加到接口规范中。- Path、query 和 body parameter 扁平化为一个 properties 对象。模型并不关心值在网络传输中处于什么位置,但你的执行器关心,因此需要维护一个辅助表来记录每个 parameter 的具体位置。
summary加上description成为工具描述。两者拼接在一起。仅凭 summary 通常过于简短,不足以指导工具的选择。- 合并 required 数组。必填的 path 参数和必填的 body 字段都会归入同一个
required列表中。
执行器是另一半工作,且非常简短:
def execute(tool_name, args, spec_index, http):
    op = spec_index[tool_name]          # method, path template, param locations
    path = op.path
    query, body = {}, {}

    for name, value in args.items():
        location = op.locations[name]   # "path" | "query" | "header" | "body"
        if location == "path":
            path = path.replace("{" + name + "}", str(value))
        elif location == "query":
            query[name] = value
        elif location == "body":
            body[name] = value

    return http.request(op.method, path, params=query, json=body or None)
这就是完整的桥接。其余的工作只是过程中的清理。
生成器需要解决的问题
将接口规范直接粗暴地导出为工具数据模型,会导致模型难以处理这些工具。以下五个调整至关重要。
解析 $ref 指针。 大多数工具调用 API 仅支持 JSON Schema 的子集,并且不会跟踪指向组件库(components)部分的引用。因此需要将它们内联。注意防范递归数据模型,因为内联会导致无限展开;请在固定深度截断递归,并用自然语言描述更深层的结构。
丢弃不支持的关键字。 oneOf、allOf、discriminator 和 nullable 在接口规范中很常见,但工具数据模型对其支持较差。可以通过合并属性来消除 allOf。对于 oneOf,要么选择最主要的变体,要么将操作拆分为两个工具(每个工具对应一种结构)。无论如何,第二种方案通常能实现更好的工具选择效果。
扁平化深层嵌套。 超过三层嵌套的 body 很难被模型正确填充。如果你的创建订单 payload 中嵌套了 customer.address.postal_code,可以考虑设计一个更扁平的工具接口,并在执行器中重新组装嵌套的结构。
精简响应数据模型。 工具定义描述的是输入。完整的响应数据模型不应该包含在定义中,包含它会浪费上下文空间。只有当结果返回时,响应的结构才重要。这是一个独立的问题,我们在关于如何将 API 响应保持在 Agent 上下文窗口内的文章中对此进行了探讨。
保留安全标记。 应当对写操作进行标记,以便执行器可以将其路由到审批流程中。如果你的接口规范使用了类似 x-agent-requires-approval 的扩展属性,请读取并遵守它。这可以与我们 AI Agent 安全护栏指南中的模式配合使用。
不要把所有 200 个接口都交给模型
实际上面临的最大问题不是转换,而是数量。一个成熟的 API 拥有数百个操作,如果把它们全部粘贴到工具列表中,会同时导致两个失败:在任务开始之前,上下文就已经被各种数据模型填满了;同时,由于模型要在近乎相同的选项中进行选择,工具选择的准确度也会下降。
以下是减少接口数量的三种方法,大致按其效果排序:
按标签过滤。 OpenAPI 操作带有标签,而标签通常会映射到不同的业务领域。一个处理退款的 Agent 需要 orders 和 payments 标签,而不需要 admin 或 analytics。这只是一个单行过滤规则,通常能过滤掉大部分接口。
维护允许调用的白名单。 根据 operationId 列出允许该 Agent 调用的操作,并仅生成这些操作。这同时也起到安全控制的作用,因为如果 Agent 没有某个接口对应的工具,就无法意外调用它。我们在关于防止 Agent 搞垮你的 API 的文章中,极力推荐采用这种精简接口的设计。
按需检索工具。 对于非常庞大的 API,可以对操作进行索引,并在每次对话中根据任务选择少数几个。这增加了一个检索步骤,并且会引入其特有的失败模式,因此建议仅在过滤和白名单维护不足以解决问题时才使用此方法。
此外,还有协议路线。Model Context Protocol 规范了服务端向客户端公开工具的方式,而基于 OpenAPI 文档的 MCP 服务端为您提供了一个统一的集成点,无需为每个框架分别进行集成。我们关于 MCP 的科普文章介绍了该模型,而使用 Apifox 构建 MCP 服务端则涵盖了具体的构建过程。
首先要保证接口定义/规范的正确性
工具生成将质量问题转移到了上游。OpenAPI 文档中模糊的描述会变成模糊的工具描述,导致模型选择错误的接口。服务端实际上必填的 optional(可选)字段,会导致 Agent 在首次尝试调用工具时就发生错误。
因此,在生成任何内容之前,请站在 Agent 的角度审计接口定义/规范:
- 每个操作都有一个
operationId,且读起来像“动词 + 名词”。 - 每个操作都有一个描述,说明它的作用、它会改变什么以及何时不该使用它。仅写 “Deletes a user” 是不够的,而 “Permanently deletes a user and all their sessions. Cannot be undone. Use deactivateUser to disable access temporarily.” 才是合格的描述。
- 每个 parameter 都有包含单位和格式的描述。
amount是模糊的,而 “Amount in cents, minimum 50” 则很清晰。 - 枚举(Enums)应当被声明式地定义,而不是用文字描述,这样模型就能获得一个闭集,而不是去猜测。
- Required(必填项)标注要准确。接口定义/规范在演进过程中往往容易将所有内容都标记为 optional,这会将校验失败的风险推迟到运行时。
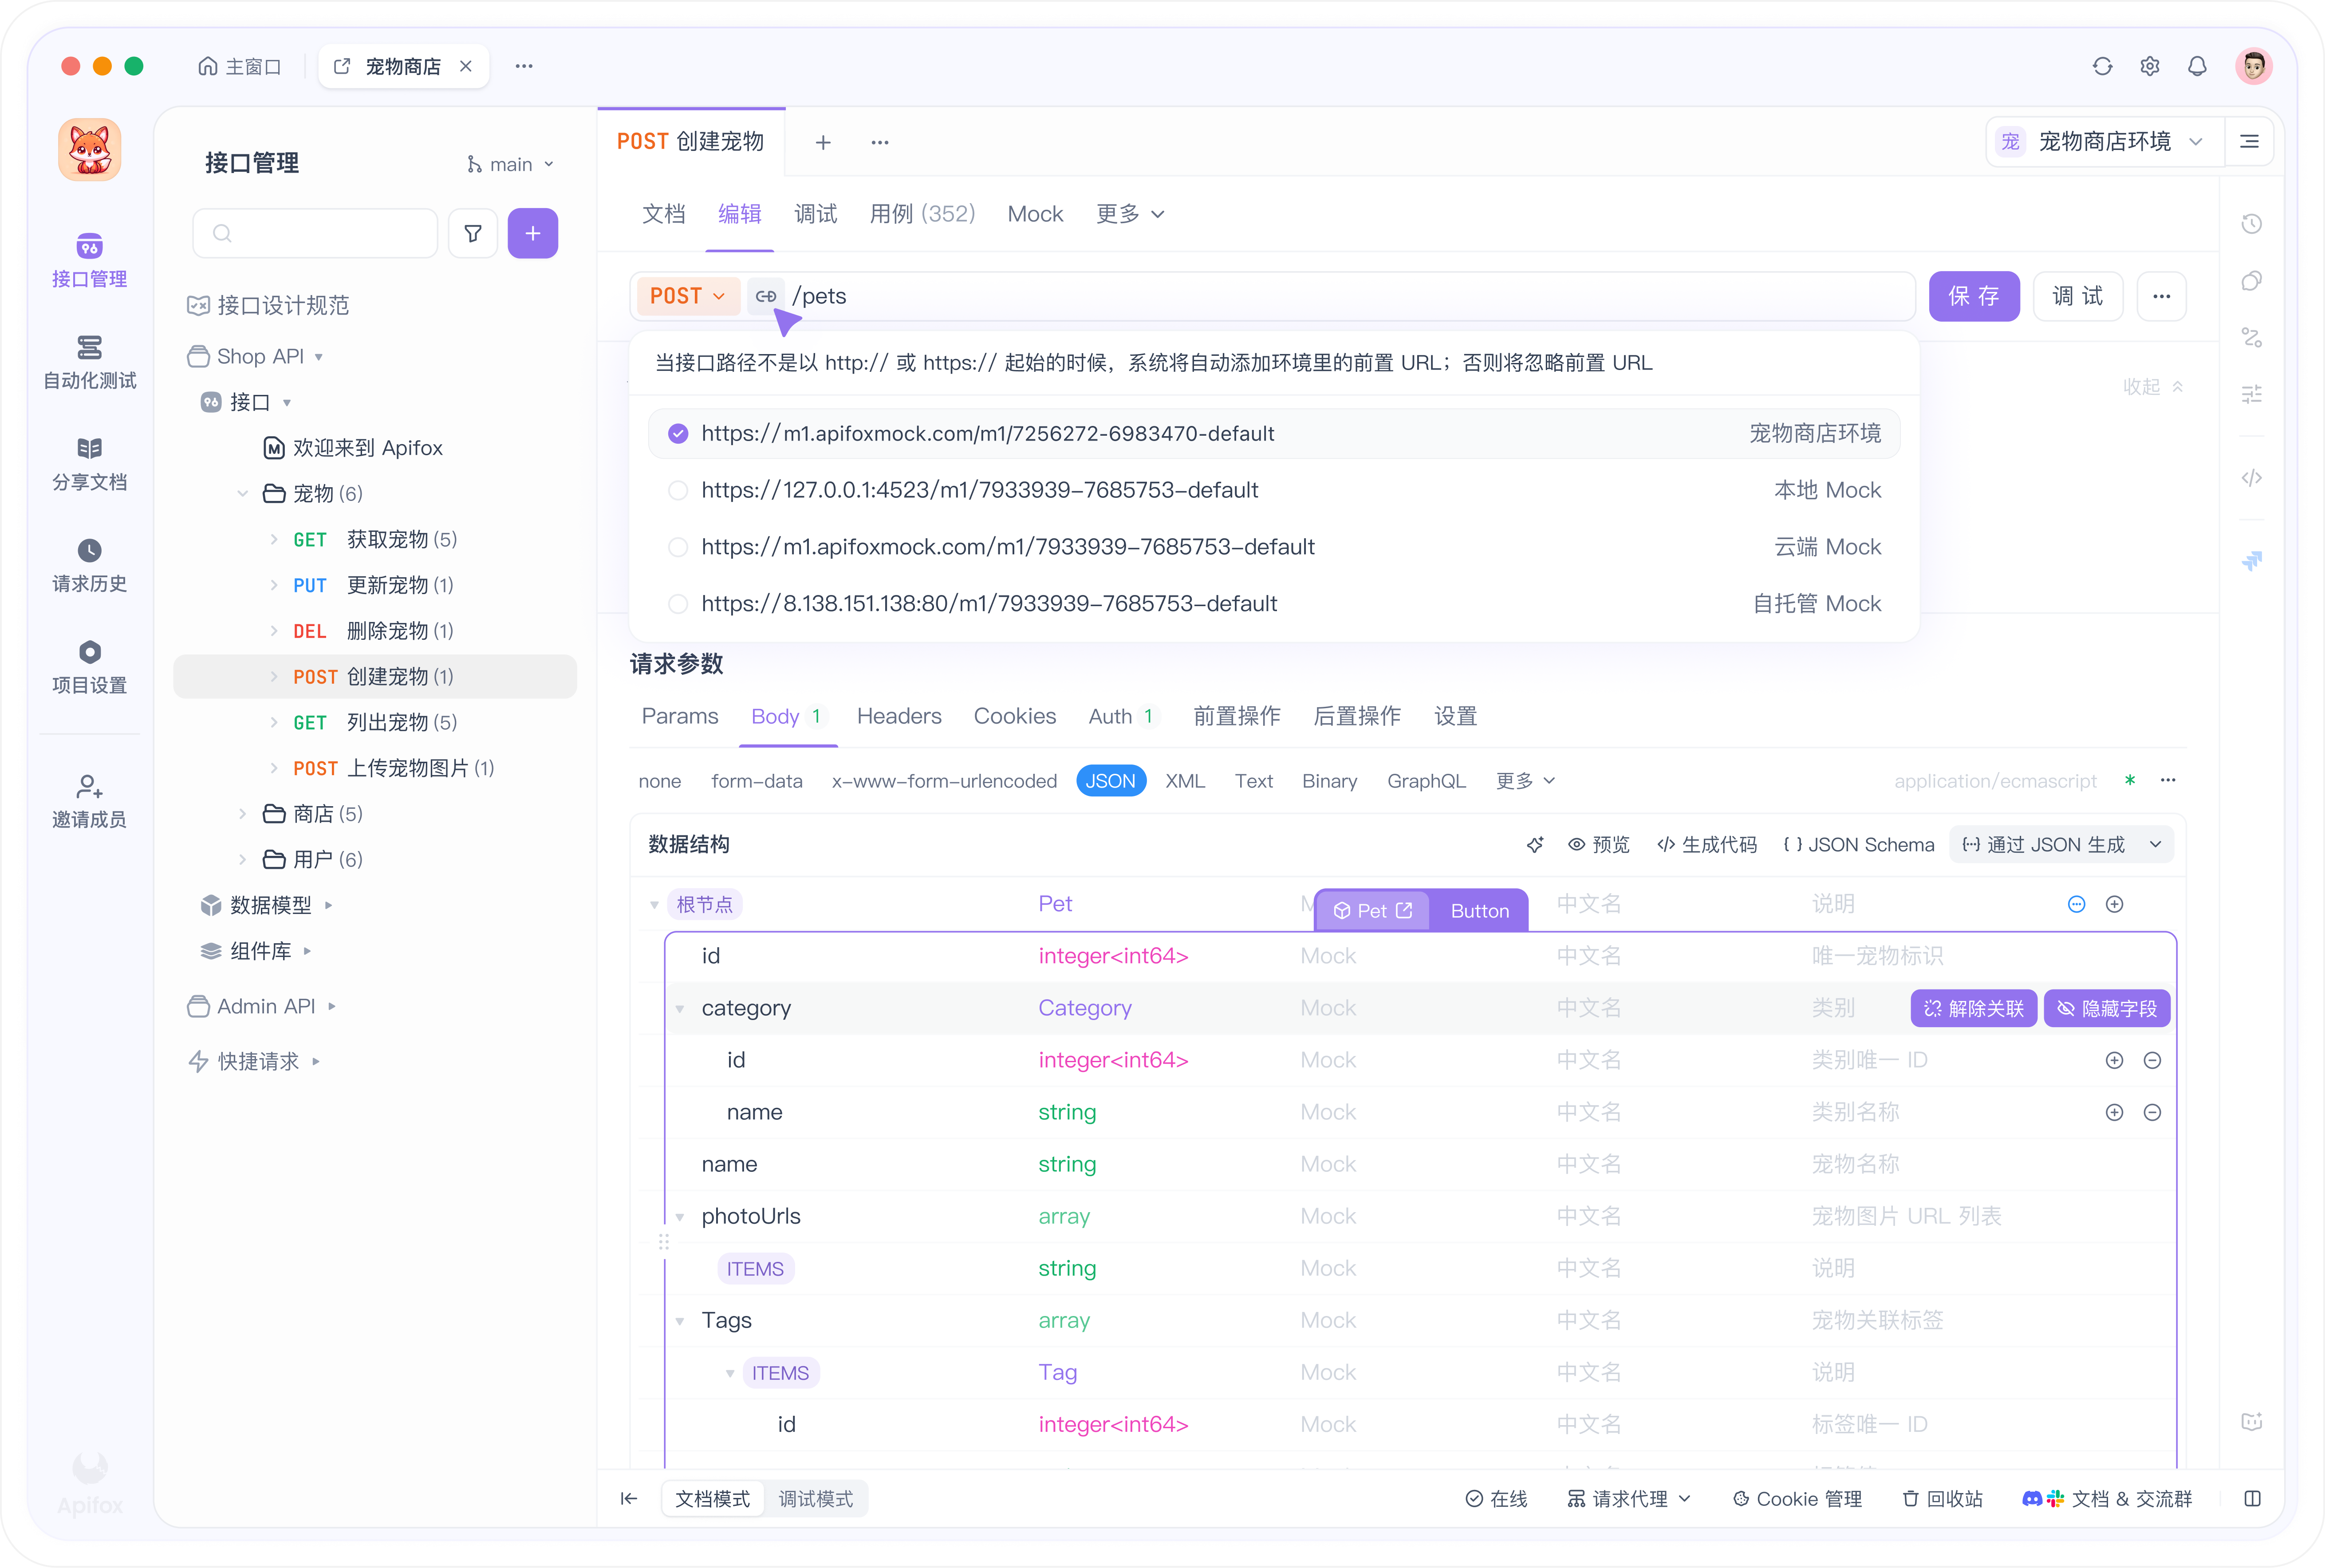
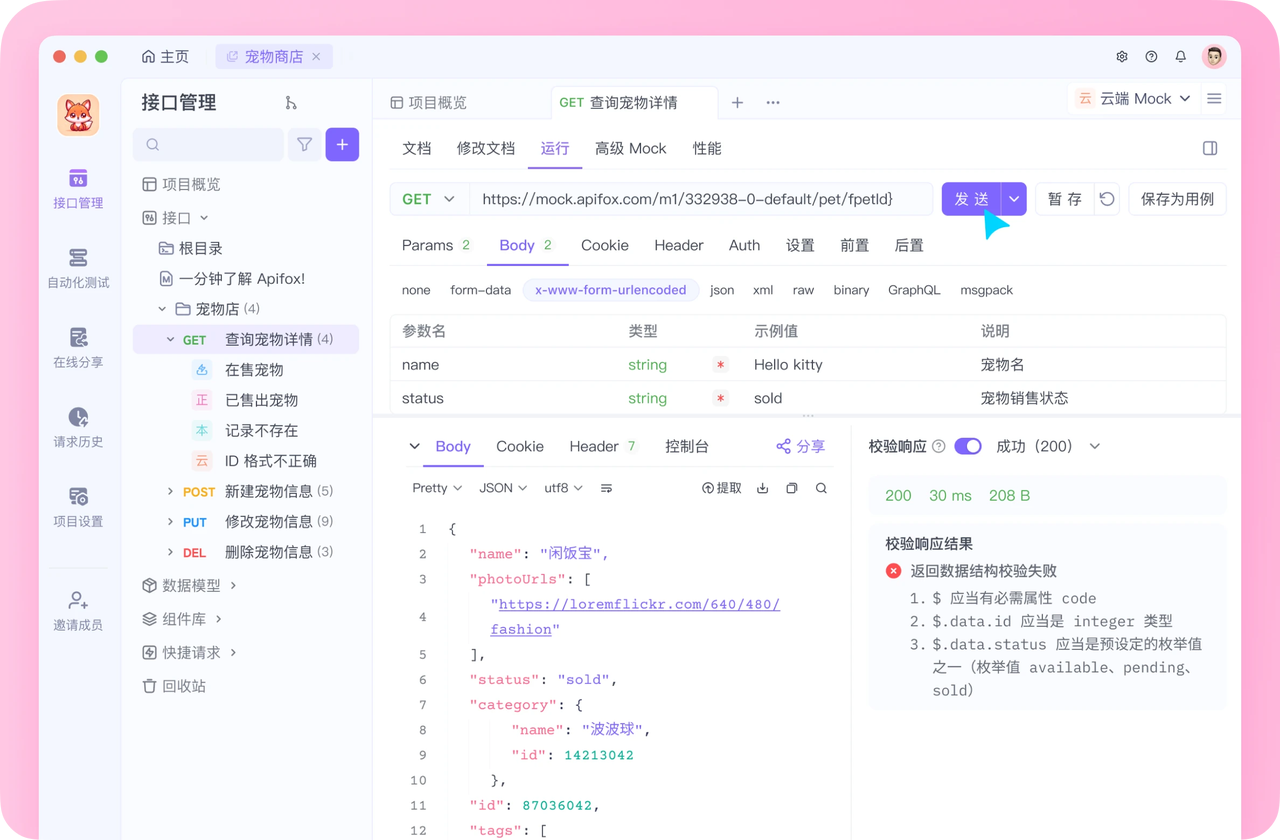
这是基本的接口定义/规范规范化工作,并且能带来双重收益,因为相同的文本也会用于生成你发布的文档。在 Apifox 中,接口定义/规范、文档、mock 服务端和测试都来自同一个项目,因此完善一个描述就能同时改进所有这些内容。我们关于在 Apifox 中管理 API 版本的指南则涵盖了另一半内容——如何在长期演进中确保生成的工具保持准确。
共享工具集,而不是复制它
生成的工具集本质上是配置,而仅存在于单个开发人员本地检出分支中的配置,就像手写的数据模型一样容易产生偏差。过滤列表、白名单和固定的接口定义/规范版本应当是共享的产出物,与它们所源自的接口定义/规范并存并进行版本管理。
一些平台将此作为默认单元。在 HiFox 中,Agent 是保存的工作配置,而不是一次性的提示词:它的指令、Runtime、Skills、代码仓库和运行设置都会随之移动,并可以在空间(Space)中共享。因此,一个行之有效的工具配置会成为团队复用的资产,而不是每个人都去重新构建。底层的 runtime 仍然是 Claude Code、Codex 或你已经在运行的其他工具。改变的是,围绕它的配置不再局限于本地。
测试生成的工具
生成的工具会以手写工具所不具备的方式发生故障,因此既要测试工具的调用,也要测试其生成过程。
首先进行数据模型往返校验。对于每个生成的工具,根据数据模型构建一个有效的示例并发送。任何返回 400 或 422 的响应都意味着工具数据模型与服务端不一致,而这正是需要修复接口规范的地方。
然后测试选择机制。编写一小组已知正确工具的任务提示词,运行它们,并记录模型选择了哪个工具。这是一个低成本的回归测试套件,可以及时发现有人重命名操作或缩短描述的情况。由于输出是非确定性的,因此应该对工具名称进行断言,而不是对具体的参数进行精确断言,这与我们关于测试非确定性 Agent 的指南一致。
最后,在正式上线前,在 mock 上运行 Agent。根据同一接口规范生成的 mock 服务端可以提供真实的响应且没有副作用,并且它允许你注入重试逻辑应该处理的 500 错误和超时。
总结与展望
接口规范是契约,工具列表应该是它的映射,而不是手动维护的平行副本。自动生成工具,严格筛选它们,保持描述真实,并对数据结构和选择机制进行测试。
首先导出你的 OpenAPI 文档,并统计没有描述的操作数量。这个数字代表了你与构建出值得信赖的 Agent 工具之间还有多少工作要做。如果你希望在修复过程中将接口规范、mock 和测试整合在一处,可以下载 Apifox。
常见问题解答
我能从 Swagger 2.0 文档生成工具吗? 可以,但首先应将其转换为 OpenAPI 3.x。2.0 的 body 模型差异较大,以至于生成器对其处理不一致,而 3.x 是目前工具链主要支持的版本。OpenAPI 规范仓库记录了这些差异。
一个模型可以同时处理多少个工具? 在达到技术上限之前,准确率就已经开始下降了,实际的上限通常是几十个。如果工具列表超过了这个数量,应将其视为需要通过标签过滤或整理白名单的信号,而不是用来测试极限的阈值。
工具名称应该与 operationId 完全一致吗? 是的,前提是 operationId 具有可读性。这样你可以直接从工具调用追溯到接口规范操作,从而让追踪和调试变得更加容易。如果名称不好,请在接口规范中重命名,而不是在生成器中修改。
GraphQL API 呢? 同样的思路也适用,只是数据源不同:通过内省数据模型,并为每个查询(query)或变更(mutation)生成一个工具。由于 GraphQL 数据模型暴露了更多的表层,数量问题会更加严重,因此过滤就显得尤为重要。
我还需要手动编写工具吗? 少数情况下需要。例如将多个调用串联成一个动作的复合工具,以及封装非 HTTP 协议的工具,仍然需要手动编写。关键在于,那些常规的单接口封装器不再需要手工编写了。
如何在测试期间阻止 Agent 调用写入接口? 通过过滤 HTTP 方法为测试运行生成一个只读工具集,并将 Agent 指向针对任何写入操作的 mock。我们关于为什么 Agent 应该调用 mock 而非生产环境的博文介绍了具体配置。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会