当任务是分类、分派、打分或放行,并且你想要概率时,用 Decisions API:它运行在 GPT-6 Luna 上,返回带类型的答案而不是文本,只按输入计费(每 100 万 token 0.10 美元,无输出、缓存读或缓存写费用),OpenAI 称其比 Responses API 快约 10 倍。需要生成文本、自定义 schema 的 JSON、工具调用、流式或会话状态时,用 Responses API。Decisions 已于 2026-10-06 进入公测。
本文用同一个任务(分派一条客服工单)跑两个接口,对比各自的返回,算一次账,并以迁移说明和在同一个 Apifox 项目里测试两者的方法收尾。想了解接口结构,从「Decisions API 主指南」开始;想看基线,见我们的「Responses API 指南」。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

功能对照表
| Decisions API | Responses API (GPT-6 Luna) | |
|---|---|---|
| 接口 | POST /v1/decisions |
POST /v1/responses |
| 输出 | predicate、choice、score 答案(外加 refusal),带接口返回的概率与置信度 |
生成文本,或经 text.format 遵循你 schema 的 JSON |
| 自定义 JSON schema | 否 | 是,json_schema 搭配 strict: true |
| 工具 / function calling | 否 | 是 |
| 流式 | 否 | 是 |
| 会话状态 | 否 | 是 |
| 提示词缓存 | 无缓存费用;据 OpenAI 论坛,目前尚无缓存 | 有,缓存输入每 100 万 0.01 美元 |
| Batch | 未文档化 | 有,标准价 5 折 |
| 图片 | 支持,base64 data URL;参考还列出公开 HTTP(S) URL,每请求最多 128 张 | 支持,Luna 接受文本和图片 |
| 链式(依赖)决策 | 拆分为多个请求 | 一次生成响应可携带依赖字段 |
| 短上下文每百万价格 | $0.10 输入;无输出费用 | $0.10 输入,$0.50 输出(含 reasoning token) |
| ZDR / HIPAA | 面向符合条件的客户支持;美国和欧盟支持区域处理 | 本对比未覆盖;见 OpenAI 数据管控页面 |
每一行都来自 OpenAI 的 Decisions 指南、API 参考和定价页。
同一个任务,两种做法:分派一条客服工单
工单内容是“我的订单被扣了两次款。”部门为 billing、technical、shipping 和 other。下面是带 Structured Outputs 的 Responses 请求,也是如今大多数团队的做法:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Route this support ticket to one department.\n\nTicket: I was charged twice for my order.",
    "text": {
      "format": {
        "type": "json_schema",
        "name": "ticket_route",
        "strict": true,
        "schema": {
          "type": "object",
          "properties": {
            "department": {
              "type": "string",
              "enum": ["billing", "technical", "shipping", "other"]
            }
          },
          "required": ["department"],
          "additionalProperties": false
        }
      }
    }
  }'
同一个工单的 Decisions 请求:
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this ticket?",
        "choices": [
          {"value": "billing", "description": "Charges, refunds, invoices"},
          {"value": "technical", "description": "Bugs, errors, login problems"},
          {"value": "shipping", "description": "Delivery, tracking, returns in transit"},
          {"value": "other", "description": "Anything else"}
        ]
      }
    ]
  }'
Responses 的请求体把问题写进提示词、把允许的答案写进 schema。Decisions 的请求体把工单原文作为 input,把问题作为一个带 2 到 255 个不重复取值的 choice;它没有 temperature、reasoning、stream 或 text 字段,因为这个接口上根本不存在这些参数。
各自的返回
Responses 返回生成文本。在严格 schema 下这段文本是合法 JSON,解析后你拿到一个标签:
{"department": "billing"}
想要置信度数字,你得在 schema 里加一个字段让模型自己写;返回的是看起来像概率的生成文本,而不是测量得到的概率。
Decisions 返回标签及其背后的分布。下面的数字是 OpenAI 指南针对这个输入的示例:
{
  "model": "gpt-6-luna",
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        {"value": "billing", "probability": 0.95},
        {"value": "technical", "probability": 0.02},
        {"value": "shipping", "probability": 0.01},
        {"value": "other", "probability": 0.02}
      ],
      "confidence": 0.93
    }
  ]
}
answers 之后跟着一个 usage 对象(见计费一节)。无需解析器,无需正则。confidence 就是你设阈值的字段;OpenAI 的建议是基于你自己的标注样本设阈值,因为官方没有公布准确率或校准数据。拒答会以 {"type": "refusal", "name": "department"} 的形式出现;同一请求中的其他问题仍会拿到答案。
成本:算一次账
短上下文(最多 272K 输入 token)下,两个接口的 Luna 输入都是每 100 万 token 0.10 美元。差别在输出。按一条 500 token 的工单、100 万次请求计算:
- Decisions:500 / 1,000,000 x $0.10 = $0.00005 每次请求,一百万次共 50 美元,没有输出或缓存项要加。
- Responses:同样 50 美元的输入,输出按每 100 万 0.50 美元计。40 token 的 JSON 标签是 40 / 1,000,000 x $0.50 = $0.00002 每次请求,一百万次共 20 美元。再加上 reasoning token——Luna 按同样的 0.50 美元把它记入输出。
只看标签,差距是 50 美元对 70 美元。更大的差距在 reasoning 一项;如实的表述是 Decisions 完全不收输出 token。OpenAI 的参考示例里两个计数器都是 0:
"usage": {
  "input_tokens": 42,
  "input_tokens_details": {"cached_tokens": 0, "cache_write_tokens": 0},
  "output_tokens": 0,
  "output_tokens_details": {"reasoning_tokens": 0},
  "total_tokens": 42
}
两点注意。Responses 有 Decisions 没有的手段:Luna 上 reasoning.effort 可降到 none,提示词缓存能把重复输入降到每 100 万 0.01 美元,Batch API 则是标准价 5 折。这些在 Decisions 上都没有文档。另外,长上下文输入(超过 272K token)在两个接口上都让输入费率翻倍,所以一条长的 Decisions 请求是每 100 万输入 0.20 美元(由定价页倍率推算);区域处理加收 10%。
速度
OpenAI 称 Decisions API 比 Responses API 快约 10 倍。官方没有公布绝对延迟数字,把这句话当作方向而不是预算,把热路径迁过去之前先测好自己的 p50 和 p95。OpenAI 论坛有开发者反馈慢速网络下图片输入的决策约 0.8 秒返回;这是孤例,不是基准。方向本身说得通:Responses 在生成 token(含 reasoning),你要等到最后一个 token。
选型规则
当输出属于以下情况时选 Decisions:
- 带概率的是/否判断(
predicate):“这条消息是垃圾信息吗?” - N 个无序类别之一(
choice):部门、意图、下一步调用哪个模型或工具。记得加“other”之类的兜底项。 - 有序等级(
score):严重程度、优先级、紧急度。score 是 0 起始等级索引的概率加权平均,1.1 表示介于等级 1 和等级 2 之间、更靠近 1。 - 放行门槛:把
confidence或probability与阈值比较,低置信度的进入人工队列。
只要出现以下任一情况,选 Responses:
- 你需要给人看的文本:摘要、回复、解释。
- 你需要自定义形状的对象:抽取字段、嵌套结构、长度不定的数组。这是 Structured Outputs 的地盘,OpenAI 的指南也是这么说的。
- 模型应发起带参数的工具调用:function calling。
- 你需要流式、会话状态,或 Luna 以外的模型。
- 一个决策依赖另一个决策,且你想在一个来回里拿到两者。Decisions 可以在一次输入上放多个相互独立的问题,但有依赖关系的决策必须拆成多个请求。
很多流水线两者都要:用 Decisions 分类和放行,用 Responses 写回复。
把分类器从 Responses 迁到 Decisions
如果你已经在用严格 enum schema 分派工单,迁移很小:
- 保留相同的
input,还原为工单原文;问题从提示词里移出去。 - 把问题放进
questions,作为choice,enum 值变成choices[].value,每个配一行description。取值可以是字符串或布尔值,true与"true"是不同的。 - 删掉解析器。直接读
answers[0].choice和answers[0].confidence;答案按提问顺序返回,并回显你设置的name。然后基于标注样本设阈值。 - 检查输入路径。Decisions 只接受用户消息:没有 system 或 assistant 角色,没有函数调用,没有文件,没有
file_id。把系统提示词里的规则折进instructions或选项描述。图片以 base64 data URL 传入;参考还列出公开 HTTP(S) URL,托管图片先测再上。 - 拆开链条。“先分类,如果是 billing 再判断退款资格”会变成两个请求。
在一个 Apifox 项目里测试两者
最干脆的比较方法是把两个请求跑在同一批标注工单上再对比。在 Apifox 里,把密钥保存为环境变量,两个请求的 Authorization: Bearer 请求头都引用 {{OPENAI_API_KEY}},密钥原文就不会落在保存的请求体里。
给两个请求配同一条断言:department 等于 billing。Decisions 请求上是对 $.answers[0].choice 的 JSONPath 断言,旁边再加 $.answers[0].confidence 大于 0.8、$.usage.output_tokens 等于 0。Responses 请求的标签在生成文本里,用一小段后置脚本把它解析进变量供断言检查。再对比两个响应的 usage:Decisions 的输出和 reasoning token 是零,Responses 不是。
把这一对请求做成基于 CSV(工单文本 + 期望部门)的数据驱动测试场景,运行结果会显示每个接口在你的置信线之上分对了多少工单。像「条件 mock 响应」那样 mock answers 数组,让分派逻辑先行开发;用 Apifox CLI 把场景接入 CI,让措辞或模型别名变更在测试中失败,而不是错分工单。更多断言模式见「测试 LLM 应用」。
常见问题
Responses API 能像 Decisions 那样返回概率吗?作为测量值,不能。JSON schema 里的 confidence 字段得到的是模型写出的数字,本质是生成文本。Decisions 的概率是接口本身对你所给选项的输出。
Decisions 上能用 GPT-6 Luna 以外的模型吗?不能。指南明确 gpt-6-luna 是当前唯一可用模型。见我们的「GPT-6 Luna 概览」。
Decisions 与 TypeSafe 的 Jev 有何不同?两者都返回带概率的类型化答案、都只按输入计费;差异在价格、输入和响应形状。见「Decisions API 与 Jev 对比」。
Decisions API 免费吗?不免费。输入每 100 万 token 0.10 美元,没有文档化的免费档。Luna 本身的免费途径见「如何免费用 GPT-6 Luna」。
下一步
挑一个你现在跑在 Responses 上的分类器,把它重写成一个 choice 问题,在 Apifox 里用同一条断言对 50 条标注工单跑两个接口。如果置信度阈值站得住、usage 显示零输出 token,你就有答案了。下载 Apifox,然后跟着「如何使用 Decisions API」完成第一次调用和完整测试流程。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
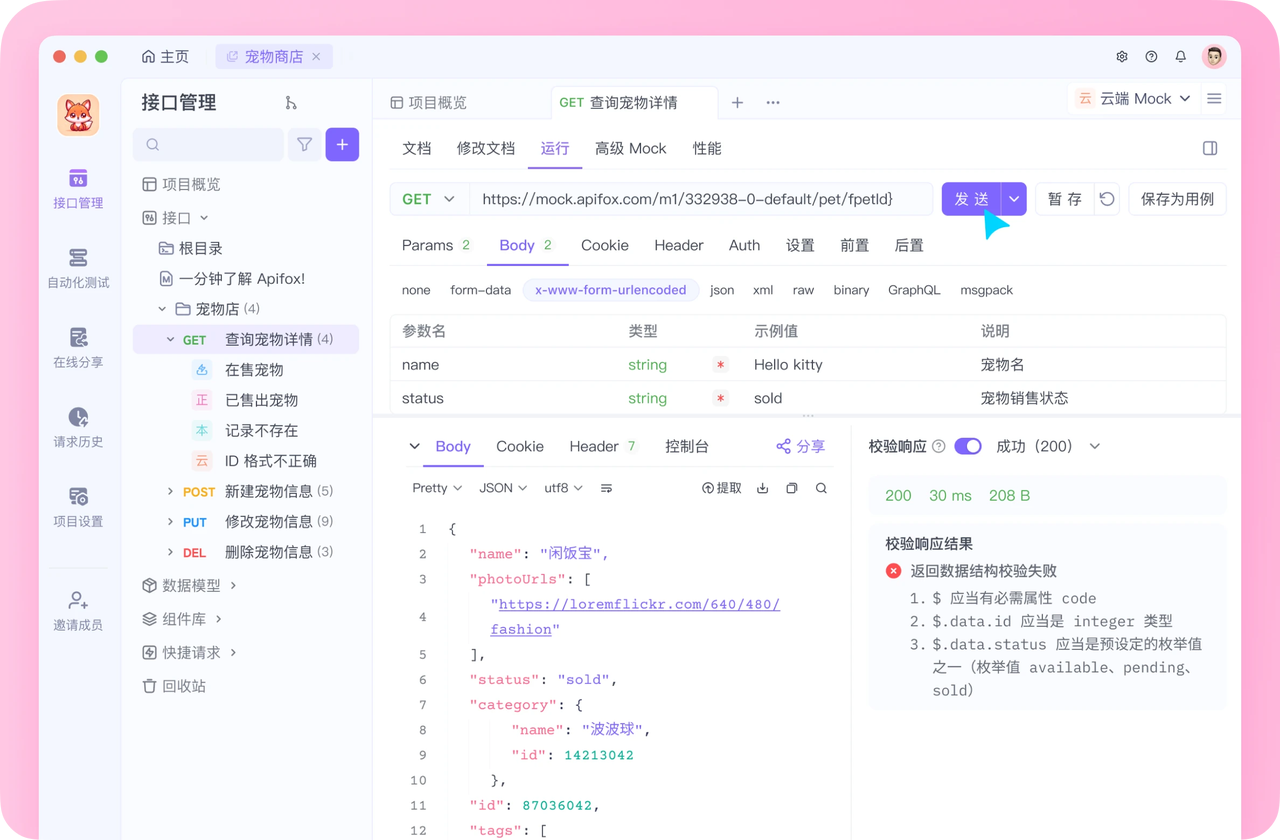
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会