摘要:OpenAI 上线了 Decisions API 公开测试版:一个专用端点 POST /v1/decisions,模型不再生成自由文本,而是对同一份输入一次回答多个类型化问题,直接返回概率、选项或分数。官方文档称其速度比 Responses API 快约 10 倍;当前唯一可用模型是 gpt-6-luna,并且只按输入 tokens 计费,每百万 0.1 美元。Vercel AI Gateway 已于 10 月 7 日同步接入。本文讲清三种问题类型、计费方式与四条接入路径。
做过后端的人对这类调用都很熟:给工单分流、判断一句话是不是投诉、给回复按评分标准打分、决定该走哪个模型。这些"判定型"任务过去只有一种做法——发起一次完整的生成式补全,在提示词里千叮万嘱让它只输出 JSON,然后在代码里解析、校验、重试。为了拿一个"是或否",你付出了整段生成的延迟和费用,还要承担解析失败的概率。Decisions API 把这件事从生成里拆了出来。
发生了什么:一个专用的 /v1/decisions 端点
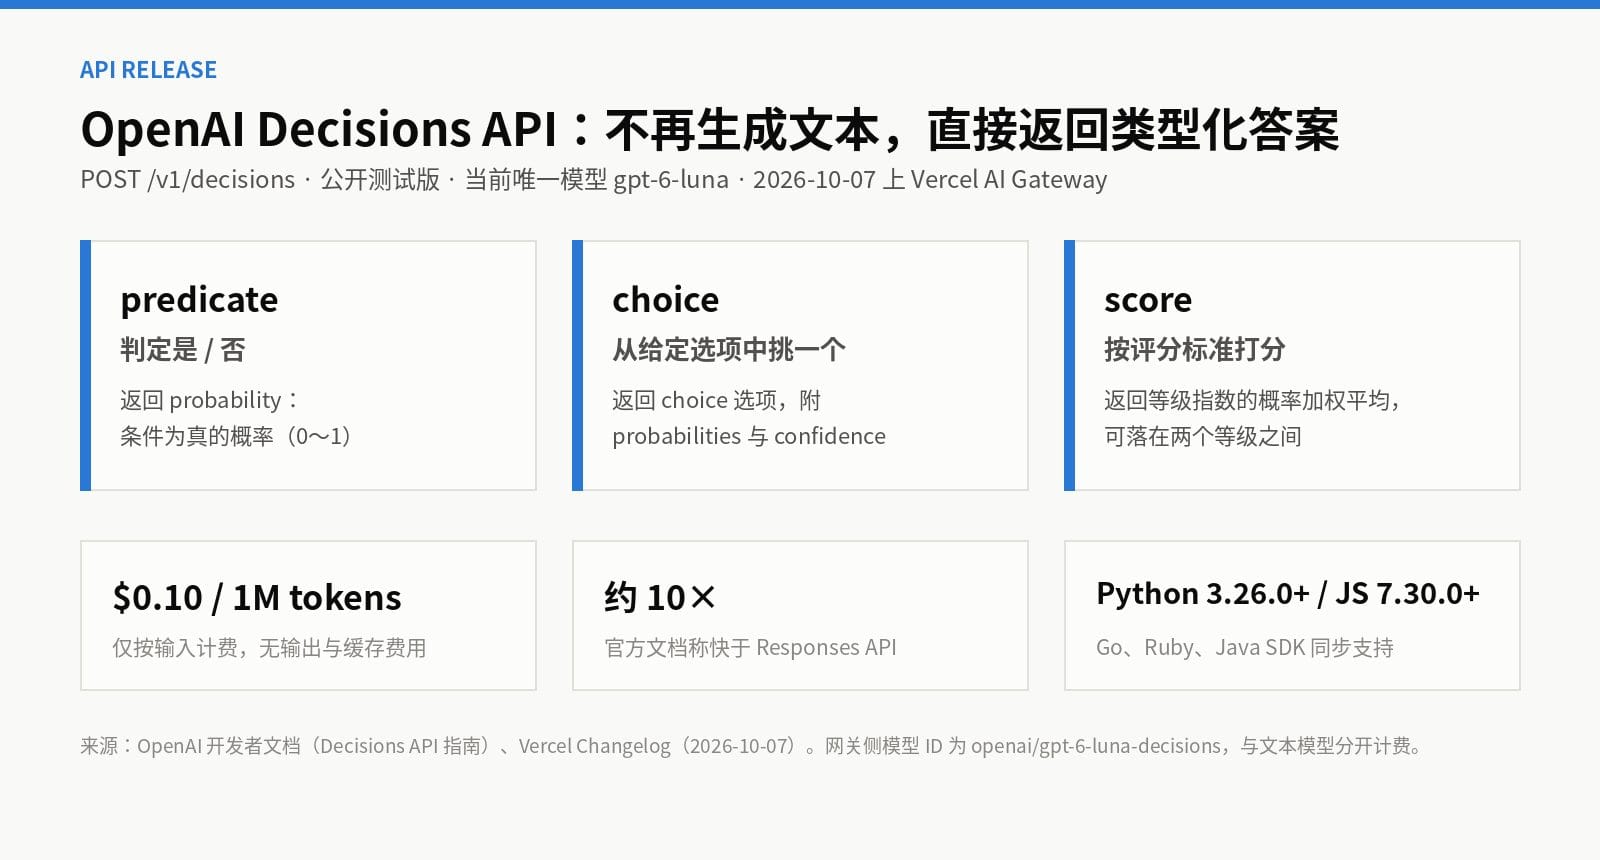
根据 OpenAI 开发者文档,Decisions API 评估文本、图片或两者,返回类型化的答案,官方文档的原话是"比 Responses API 快约 10 倍"。请求带 model、input、questions 三个字段,每个问题有唯一的 name,多个相互独立的问题可以共用同一份输入、放进同一次请求,答案按问题顺序以数组返回。问题分三种:predicate 回答是或否,返回 0 到 1 之间的 probability;choice 从你给定的取值里挑一个,附 probabilities 数组和 confidence;score 按你定义的评分等级打分,返回等级指数的概率加权平均——因为做了加权,分数可能落在两个等级之间,比如 2.6。
还有一个值得注意的细节:"多个问题共享同一份输入"不是简单的语法糖。过去你要为意图、部门、紧急程度发三次请求,同一段上下文被计费三遍、延迟叠加三回;现在三次判定合并进一次请求,输入 tokens 只算一次,答案仍按问题顺序逐一返回。这也是它整体成本和延迟能压下来的另一半原因——省的不只是输出,还有重复的输入。
计费:只收输入的钱
费用结构是这次最反直觉也最友好的部分:gpt-6-luna 输入每百万 tokens 0.1 美元,没有缓存读取、缓存写入和输出 token 的任何计费——判定答案本身不占输出费用。区域处理溢价与长上下文乘数照常适用。合规面上,官方支持零数据保留(ZDR)与 HIPAA 场景,数据驻留可选美国或欧洲(EEA 加瑞士)。图片输入只能用 base64 内联的 data URL,不支持外链地址,也不支持 file_id 引用。Vercel 侧的接入值得单独说一句:网关把它挂成了独立的模型 ID openai/gpt-6-luna-decisions,与文本模型 openai/gpt-6-luna 分开,请求打到 decisions ID 就按 Decisions API 的费率走;同一个网关里还能选 Jev、Liquid d1、Laya 等其他决策模型。
完整工作场景:客服工单一次请求完成分流
假设你在维护一个客服系统,用户留言"我被重复扣了两次款"。旧做法是拼一段提示词,让模型输出 JSON,解析出意图、部门和紧急程度三个字段,任何一个字段不合法就整体重试。现在一次 decisions.create 调用带上三个问题:一个 predicate 问"这是否是账单类投诉",一个 choice 在 billing 和 technical 里二选一,一个 score 按 1 到 5 的等级给紧急程度打分。三个答案按 name 取回:predicate 给出 0.97 的概率,choice 直接落到 billing,score 返回 4.2——按分数划进高优先级队列。整段调用没有任何自由文本需要解析。同样的套路还可以放在质检环节:按评分标准给模型的回复打分,低于阈值的会话转人工,整条流水线里没有一个节点需要解析自由文本。SDK 侧,OpenAI SDK 需要 JavaScript 7.30.0 或 Python 3.26.0 以上才有 decisions.create;用 Vercel AI SDK 的话,ai 7.0.128 起提供 experimental_decide,布尔问题写作 boolean 类型;此外还有现成的 HTTP 接口 /v1/evaluate 和 AI CLI 两条路。
为什么这改变工作流
把镜头拉远一点,这不是孤立动作。llama.cpp 上线了 Decision Models,Cloudflare 开源了决策模型 Clef,Vercel 一周前刚给 AI Gateway 加了置信度回退——判定类调用正在从文本生成里被系统地拆出来,单独定价、单独优化延迟。对调用方来说,变化有三层:解析失败这个错误类别基本消失;判定延迟显著下降(官方口径是 10 倍量级);成本变成只跟输入规模线性相关,账单第一次可以精确预估。算一笔账就能感受到量级:一个每天 50 万次、平均输入 400 tokens 的分类服务,按每百万 0.1 美元的输入价折算约 20 美元一天,而且不存在输出费用的变数;同样的调用量换成生成式补全,每一笔回复文本都要另算钱。那些过去"不值得用大模型"的轻判定——路由、过滤、打标——现在重新值得做一遍技术选型。
限制与需要人接管的点
边界也要说清楚。这是公开测试版,官方明确写着预计数周内正式 GA,接口细节可能调整;当前只有 gpt-6-luna 一个模型可选,没有更高能力档位;score 的连续值特性意味着你的阈值逻辑要按浮点数设计,而不是整数档位;经 Vercel 网关调用时必须使用带 -decisions 后缀的模型 ID,写成 openai/gpt-6-luna 会按普通文本模型计费。还有一个容易忽略的点:判定结果的概率值不等于业务上的置信度,高风险动作(比如自动退款)仍应设人工复核阈值,模型给的是参考分,不是决策本身。
如何试用
两条路:直连官方端点 api.openai.com/v1/decisions,或者把 base URL 指到 ai-gateway.vercel.sh/v1 走 Vercel 网关。升级 OpenAI SDK 到 JS 7.30.0 或 Python 3.26.0 以上,把现有的一次性分类调用改写成多问题请求,先从客服分流、内容审核这类低风险场景开始试。官方文档给出了 TypeScript、Python、Bash 和 AI SDK 四种示例。
信息来源
- OpenAI 开发者文档:Decisions API 指南
- Vercel Changelog:OpenAI Decisions API now available on AI Gateway(2026-10-07)
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
