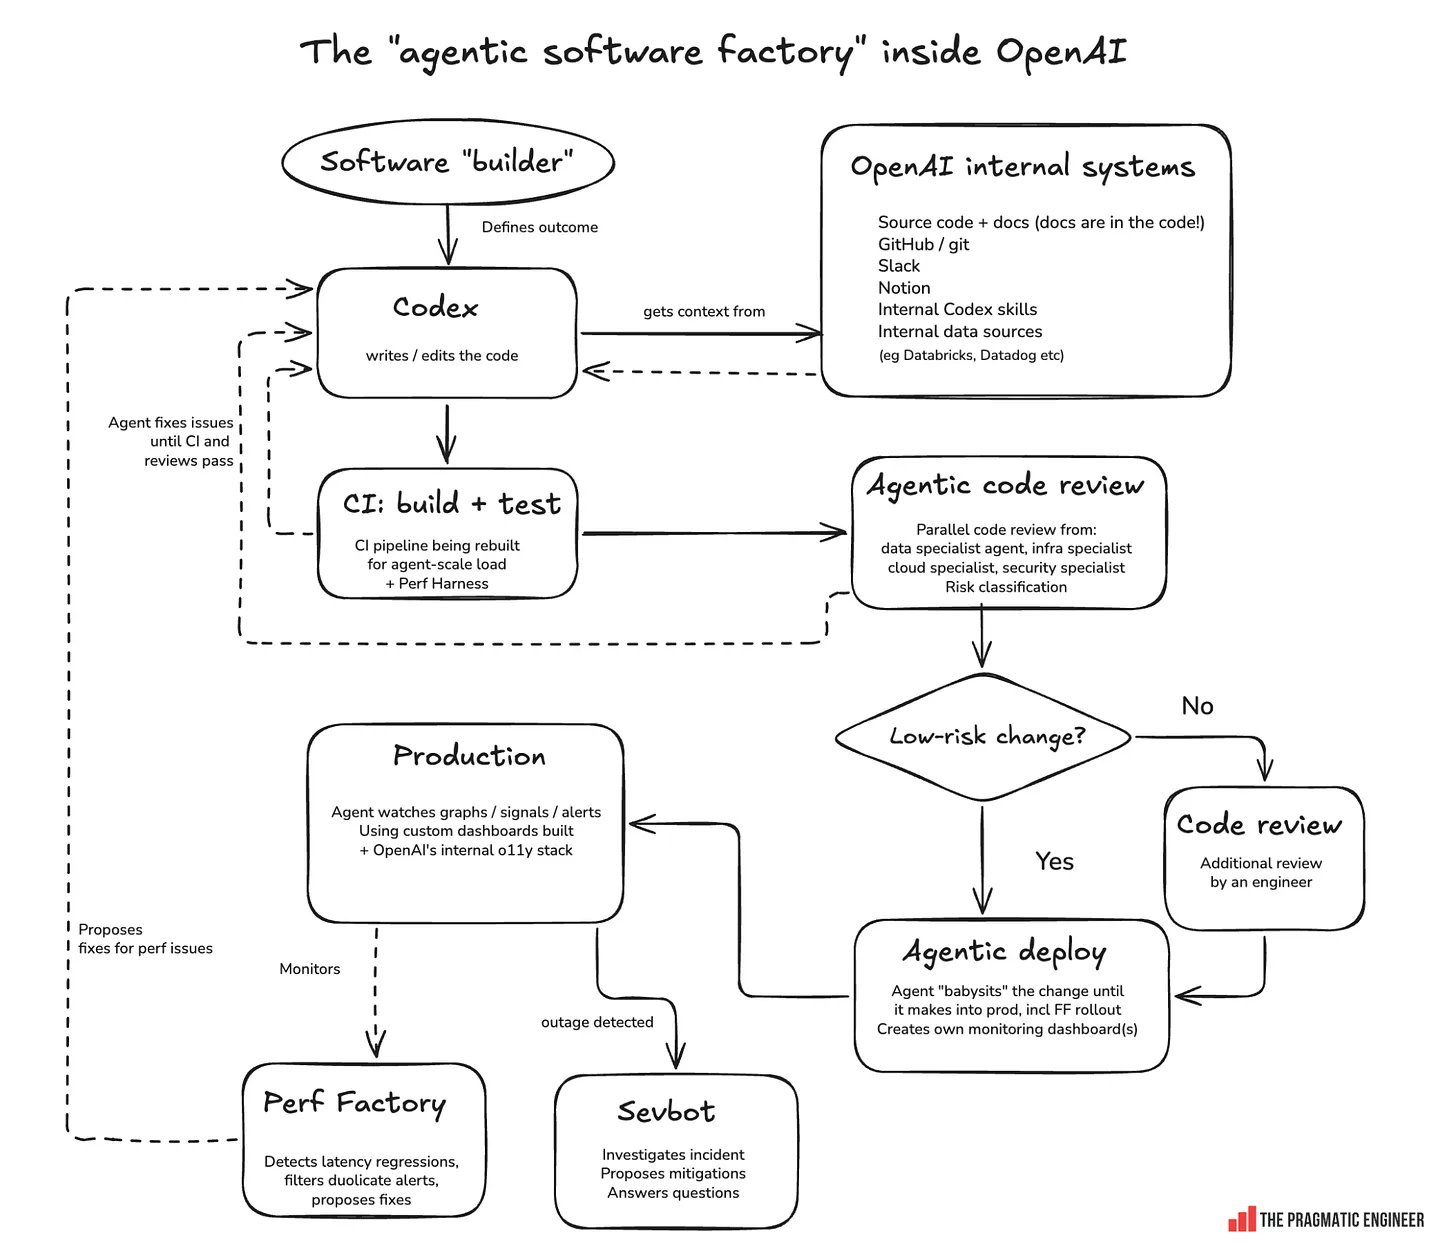
一张 OpenAI 内部工程流水线图这周在 X 上半病毒式传开。图里有十个框,从 “software builder defines outcome” 一直画到一个看着生产图表、自己提单的 Agent。来源是 Gergely Orosz 的 newsletter The Pragmatic Engineer,那篇叫 “OpenAI’s agentic software factory”,图本身也在 X 上快速散开。
大多数反应跳过了一个关键细节:这十个框里有好几格描述的是 OpenAI 的内部工程配置,而不是你今天就能装的 Codex 产品。把两者混为一谈,是围绕这张图最常见的错误。本文按框拆开,并停在外部团队真正能复制的那一阶段:CI。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
十个阶段,按顺序
图从左到右是一个闭环:人设目标,Agent 写代码,自动化闸门检查,Agent 一直迭代直到闸门通过。下面是完整序列,每一阶段都标了“仅内部 / 已在 Codex 交付”。
| # | 阶段 | 发生了什么 | 仅内部,还是已在 Codex 交付 |
|---|---|---|---|
| 1 | Software builder | 工程师或 PM 定义 outcome | 人的步骤,不是软件 |
| 2 | Codex writes/edits code | 从源码、文档、GitHub、Slack、Notion、内部 skill,以及 Databricks、Datadog 这类数据系统拉上下文 | 已交付的 Codex 会写代码;内部上下文图(Slack、Notion、内部数据)仅内部 |
| 3 | CI: build + test | 一条正在按 Agent 规模负载重建的流水线,外加一个 “Perf Harness” | 已交付(你自己的 CI);OpenAI 特定的扩容工作仅内部 |
| 4 | Agentic code review | 来自 data、infra、cloud、security 专科 Agent 的并行 review,外加风险分类 | 仅内部 |
| 5 | Low-risk decision | 低风险改动继续走;更高风险的改动再加一轮人类工程师审查 | 仅内部 |
| 6 | Agentic deploy | 一个 Agent “babysits” 改动进入生产,包括 feature-flag 放量,并给自己搭 dashboard | 仅内部 |
| 7 | Production monitoring | Agent 在 OpenAI 内部可观测性栈上看图表、信号和告警 | 仅内部 |
| 8 | Outage detected -> Sevbot | 调查事故、提出缓解、回答问题 | 仅内部 |
| 9 | Perf Factory | 过滤重复告警、找出延迟回退、提出修复 | 仅内部 |
| 10 | Loop back | Agent 修问题直到 CI 和 review 通过,然后 builder 拿到提议的修复 | 描述的是内部闭环 |
真正能让外部团队指着说“我们也有这个”的,恰好只有一个阶段:CI 这一步,外加第 2 阶段的一小片。从 agentic review 一直到 Sevbot,都是 OpenAI 的内部建设。
那一列“仅内部”同时也是采购问题。OpenAI 留在防火墙后面的部分——编排、review 闸门、人的签字——正是大多数团队完全空着的那一层。Sharkly 是一个提供商中立的落点:builder 把 outcome 定义成 Task,分给 Agent,Agent 在 Computer 上跑你已经有的 Runtime,Claude Code 或 Codex。Ready for Release 是人必须亲手改掉、任务才能到 Done 的状态,所以签字仍然是人的工作,不是流水线的。Sharkly 不替代 Codex,自己也不写代码;它跑你已经在付费的 Runtime,并给周围的闭环一个住的地方。
阶段 1-2:目标仍由人定,代码仍由 Codex 写
Software builder,也就是工程师或产品经理,定义想要的 outcome。Codex 随后做一系列代码改动,直到达到目标并验证结果能工作。这条验证闭环就是今天 Codex 已经交付的部分:桌面应用(Mac 在 2026 年 2 月,Windows 在 3 月)、2026 年 7 月起的 ChatGPT Work 集成、基于角色的 plugin 和 skill,以及给跑很长时间的任务用的 /goal 命令。若要看这条命令的机制,我们另外写过 /goal 用于自主 Agent run 的说明。
没有交付的是内部喂给 Codex 的上下文图:几乎每一个 OpenAI 系统,从 Slack 线程到 Databricks dashboard。Orosz 的文章说得很直接:OpenAI 内部的 Codex “is a lot more advanced than its external counterpart because it’s plugged into pretty much every OpenAI system.” 内部 Codex 和外部 Codex 之间的这条缝,才是这篇文章真正的论点。
阶段 3:闭环真正被执行的地方是 CI
这一阶段值得放慢,因为它是整条流水线里任何团队——不只是 OpenAI——已经拥有的那一格。文章提到 OpenAI 的 CI 正在按大约六个月内 10 倍负载重建,因为现在是 Agent 在往流水线里推远超人类单独能推的改动。旁边还有一个 “Perf Harness”,用来在进入 review 之前抓住性能回退。
常被漏掉的是这一句:一个 “fixes issues until CI and reviews pass” 的 Agent,可信度完全取决于 CI 实际检查了什么。如果测试套件覆盖了单元逻辑却没覆盖 API 契约,Agent 可以循环到一次仍然会带上 breaking change 的绿 build。Status codes、schema 形态、auth 行为,以及负载下的响应时间预算,正是大多数团队相对单元测试投入不足的那一类检查。这就是 Apifox 出现的位置:把 Apifox 的测试场景通过 Apifox CLI 跑进 CI,给 Agent 的闸门会比 “代码编译过了” 硬得多。我们在 Apifox CLI inside Codex 里写过怎么接。Apifox 在这条流水线里只扮演这一个角色。它不是 Agent,也不碰 deploy、review 或事故响应。
阶段 4-5:专科 review Agent 和风险决策
CI 通过之后,OpenAI 的内部配置会把改动交给 data、infrastructure、cloud、security 专科 Agent 并行 review。Orosz 的说法是 “the equivalent of having a human domain expert from each relevant infrastructure team review every change”,这个审查门槛比大多数人类团队能为每个 PR 配得起的更重。Codex 已交付的 code review 功能,和这些内部专科 Agent 不是一回事,也轻得多;如果你在评估通用 agentic reviewer 能给自己的栈做什么,我们的 AI code review tools 盘点是一个还算公平的起点,关于 OpenAI 的 agentic review 和风险闸门设计的姊妹篇会把这一格挖得更深(sibling,链接前请确认是否已上线)。
接下来由风险分类决定走向。代码库的低风险区域可以让 Agent 自动批准自己的 PR,把人的签字完全从这类改动里拿掉。更高风险的改动会多几轮 AI review、强制人审,或两者都要。OpenAI 没有公布“低风险”的精确规则,这里也不猜。一个可以推广到 OpenAI 特定配置之外的想法:对公开 API 契约的 breaking change,无论 diff 看起来多小,都绝不该被标成低风险。把 OpenAPI 定义和测试放在同一处的 spec-first 工具,更容易自动执行这个区分,因为 schema diff 作为风险信号,比按行数看 diff 干净得多。
阶段 6-8:发布、观察、响应,不必先把人 pager 响起来
改动过了 review,一个内部 Agent 会 “babysits” 它进入生产,包括 feature-flag 放量,并为这次改动自己搭监控 dashboard。上线后,同一个 Agent(或相关的一个)在 OpenAI 内部可观测性栈上看图表和告警。出事时 Sevbot 接手:调查事故、提出缓解,并在 Slack 回答开发者问题。Sevbot 不做什么,需要说清楚。它提议,它不执行。人仍然授权缓解,人仍然值班 oncall。文章写得很白:“oncall duty is not a thing of the past.” 阶段 6 到 8 都不存在于你能买到的 Codex 产品里。
阶段 9-10:性能回退和绕回
Perf Factory 和事故路径并排。它筛告警和 dashboard,滤掉重复信号,挖出真正的延迟回退,并提出修复,再回流给原来的 builder。和 Sevbot 加在一起,这是 OpenAI 对告警疲劳的回答:不是每次 ping 都由值班工程师分诊,而是先由 Agent 预过滤、预诊断。闭环在阶段 10 合上:Agent 一直改到 CI 和每一层 review 都通过。
内部 / 外部这条线对你的团队意味着什么
如果你在评估“OpenAI 式” agentic 工程这季度能不能在团队落地,诚实的答案是:阶段 1 到 3 今天就能采用;阶段 4 到 9 描述的是方向,不是可购买功能。这不是在贬 OpenAI;那种规模的内部工具要好几年。一个开源项目 orchflows 试图用给 Claude Code 和 Codex 的 /software-factory 命令公开近似这个闭环;它的 README 目标写得很直,认为你只需要两个 skill,而不是一整库。这是早期、非官方项目,不是 OpenAI 发布,所以当参考实现,而不是即插即用的工厂。
OpenAI 内部本身,在不需要定制内部管道的部分推进很快:非工程团队的 Codex 使用率在四个月里从大约 0% 到 90%,2026 年 2 月到 5 月。这比流水线图本身更尖:容易的部分(对着既定目标写代码的 Agent)在 OpenAI 已经日常,难的部分(接到每个内部系统上的 agentic deploy、review 和事故响应)仍然是定制件。
哪些仍然是人的
文章对不变的部分很小心。Builder 仍然定义 outcome。人仍然批准高风险改动、授权事故缓解。仍然有人事后看 Sevbot 做了什么,oncall 轮值仍然存在。文章收尾那句话比任何统计都更能抓住这个转变:“Judgment, prioritization, and taste are becoming more important.” 两个 caveat 也把讨论按在地上:移动应用商店审核仍是 Agent 绕不开的人工瓶颈;基础设施扩容是每月都要打的仗,不是已解决的问题。
如果你要自己做阶段 1 到 3 的版本,而不是等供应商把阶段 4 到 9 卖给你,从流水线里已经存在的闸门开始:CI。姊妹篇 building a lighter-weight software factory around Codex 会走一遍那个搭建(sibling,链接前请确认是否已上线),Sevbot / Perf Factory 的设计会在 our piece on OpenAI’s perf factory and Sevbot 里单独处理(sibling,链接前请确认是否已上线)。一个循环到测试通过为止的 Agent,只有在它对着的测试真的断言了什么时,才是好主意。Apifox 把 API 契约测试放在 spec 旁边,这样当 Agent——而不只是人——开始往闸门里推改动时,这扇门仍然诚实。
开发必备:API 全流程管理神器 Apifox
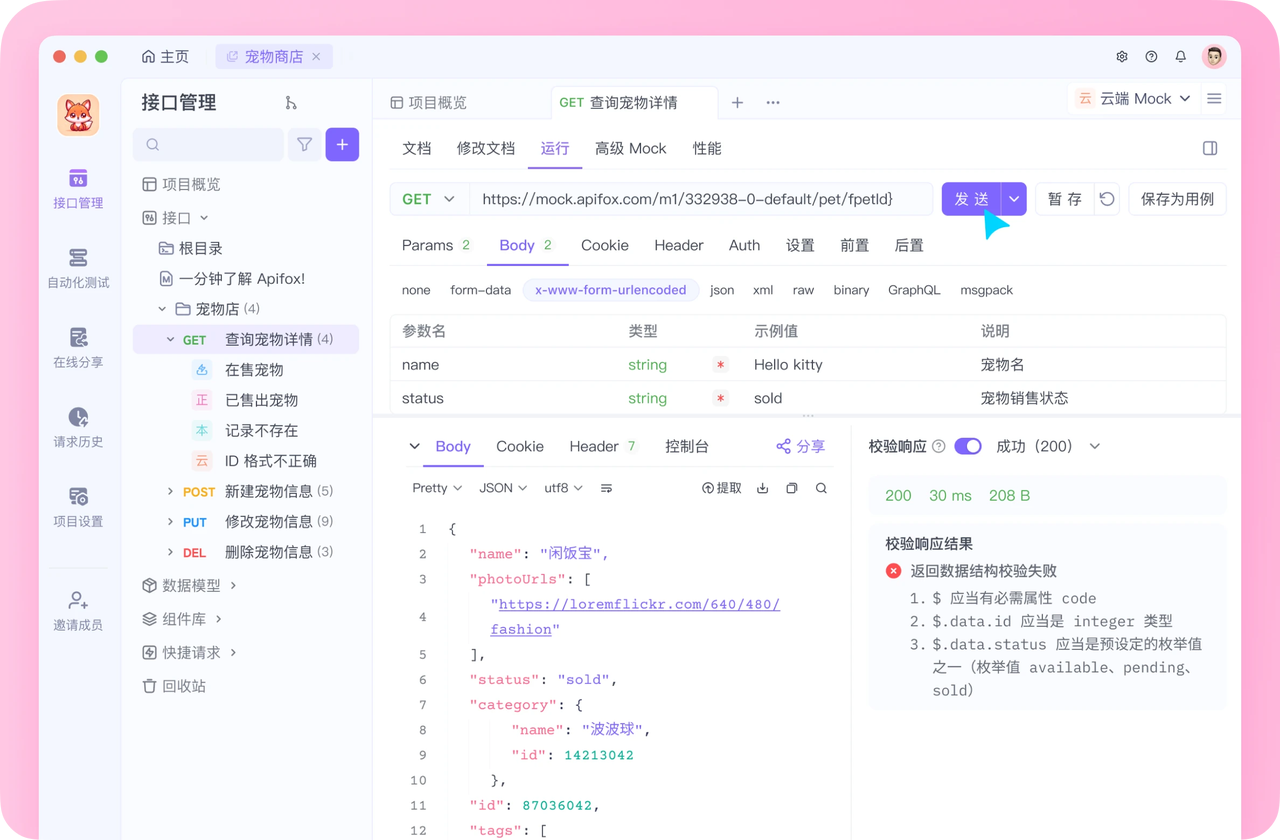
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会