Mistral 在高端模型上沉寂了一阵子。Mistral Large 3 于 2025 年 12 月发布,此后围绕开放权重前沿模型的讨论都是 Kimi、DeepSeek、GLM 和 Qwen。2026 年 10 月 6 日,Mistral 用 Mistral Large 4 给出回应——一个 1 万亿参数、被团队称为“Le Chonk”的模型。
最抓眼球的数字来自一项网络安全基准:Large 4 得分 82%,而 Claude Opus 5.5 和 GPT-6 Astra 接近零。这是真的,就写在 Mistral 的发布页上,但在转发之前需要补一句上下文。本文会给出这层上下文、规格参数、真实价格,以及 Large 4 仍然落后的地方。
TL;DR
- 它是什么:一个 1.05T 参数的混合专家(MoE)模型,激活参数 49B,配 1.6B 视觉编码器,支持文本与图像输入,上下文窗口 1M token。
- 在哪里获取:今天起以
mistral-large-4在 Mistral API 上公开预览,权重“月底前”放出,大约在 10 月 27 日左右。 - 价格:标价 $1.36 输入 / $4.18 输出(每百万 token),预览期当前显示为 $0.68 / $2.09。缓存输入为 $0.07。
- 网络安全那一项:在 AA Cyber Index 的漏洞复现测试中得分 82%。Opus 5.5 和 Astra 接近零,是因为它们拒绝执行任务,而不是做不到。
- 真正的落后项:在人工评分的编码能力上,Claude Opus 5 得 4.22,Large 4 得 3.74。
为什么说“Mistral 回来了”是公允的
2026 年的大部分时间里,最强的开放权重模型都来自中国。Mistral 一直在发布新模型,包括 Medium 3.5、Devstral 2 和 Small 4,但没有一个能在闭源前沿模型的主场上与之竞争。
Large 4 改变了这个说法。Mistral 声称它“显著超越任何在美国或欧洲开发的开放权重模型”,并用一套面向欧盟主权叙事的训练故事来支撑:该模型在 Mistral 自有的欧洲数据中心里,从零开始训练于 3,800 张 NVIDIA Grace Blackwell GPU,覆盖 160 多种语言,包括所有欧盟官方语言;而它发布前几周,Mistral 刚完成 30 亿欧元 D 轮融资,被其称为欧洲科技公司史上最大的股权融资。
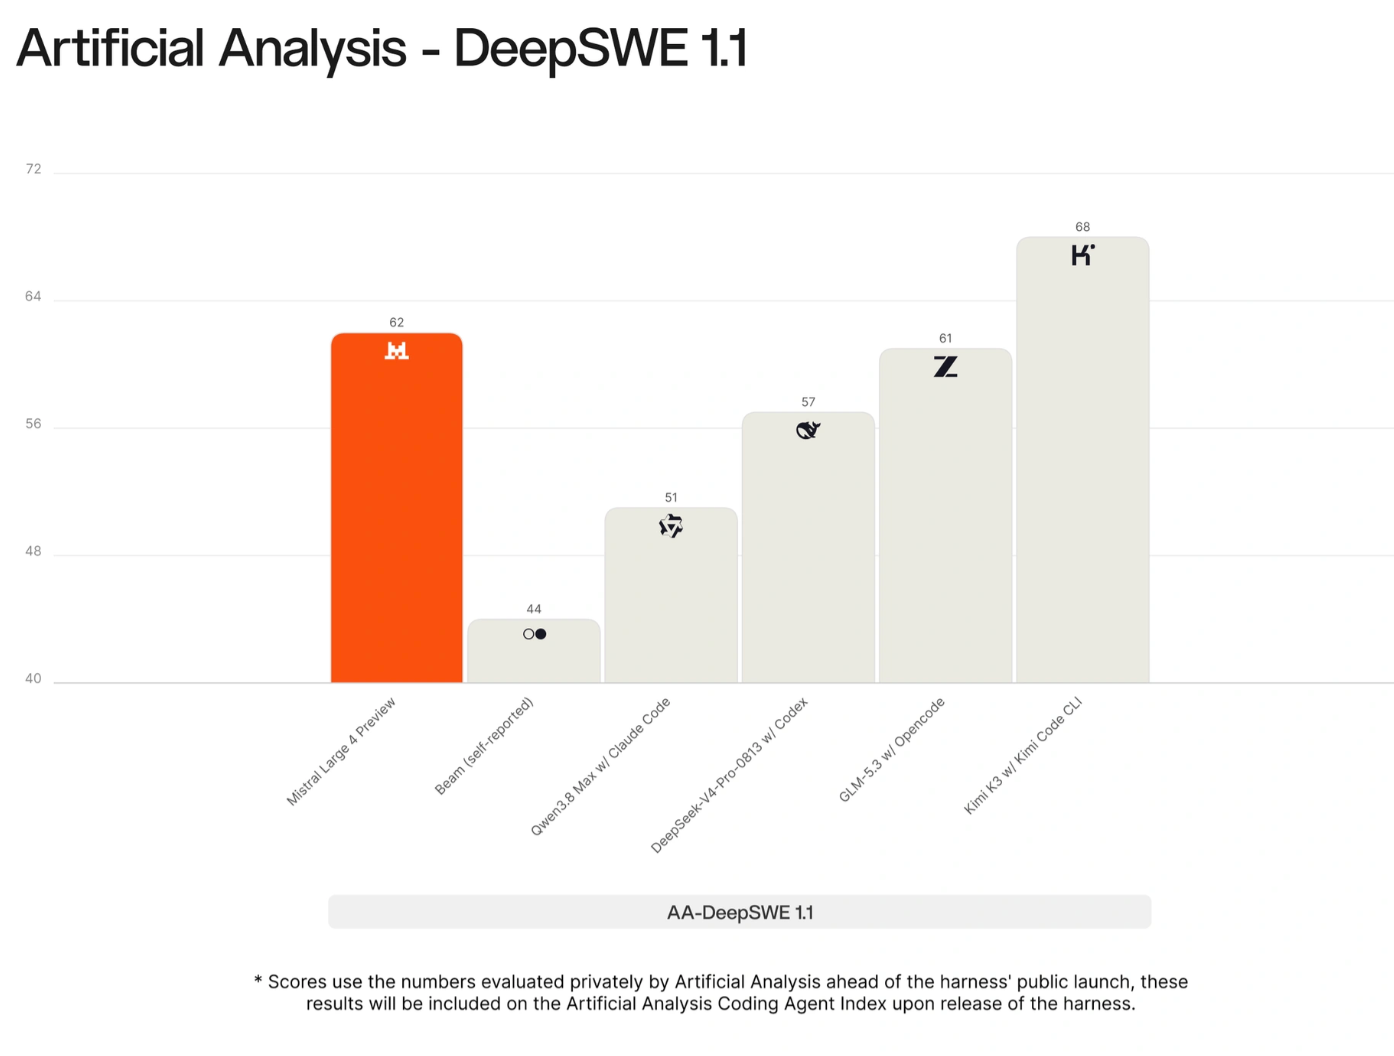
时机也很关键。Large 4 恰好在 Reflection 发布其开放权重模型 Beam 之后登场,于是这场美中开放模型竞赛多出了第三个认真的参赛者。
网络安全那条头条,以及它的前提
这就是大家都在截图的结果。Artificial Analysis 的 Cyber Index 包含一项测试:要求模型复现开源软件中的一个真实漏洞,然后修补它。Mistral 称 Large 4 得分 82%,是所有模型中最高的。
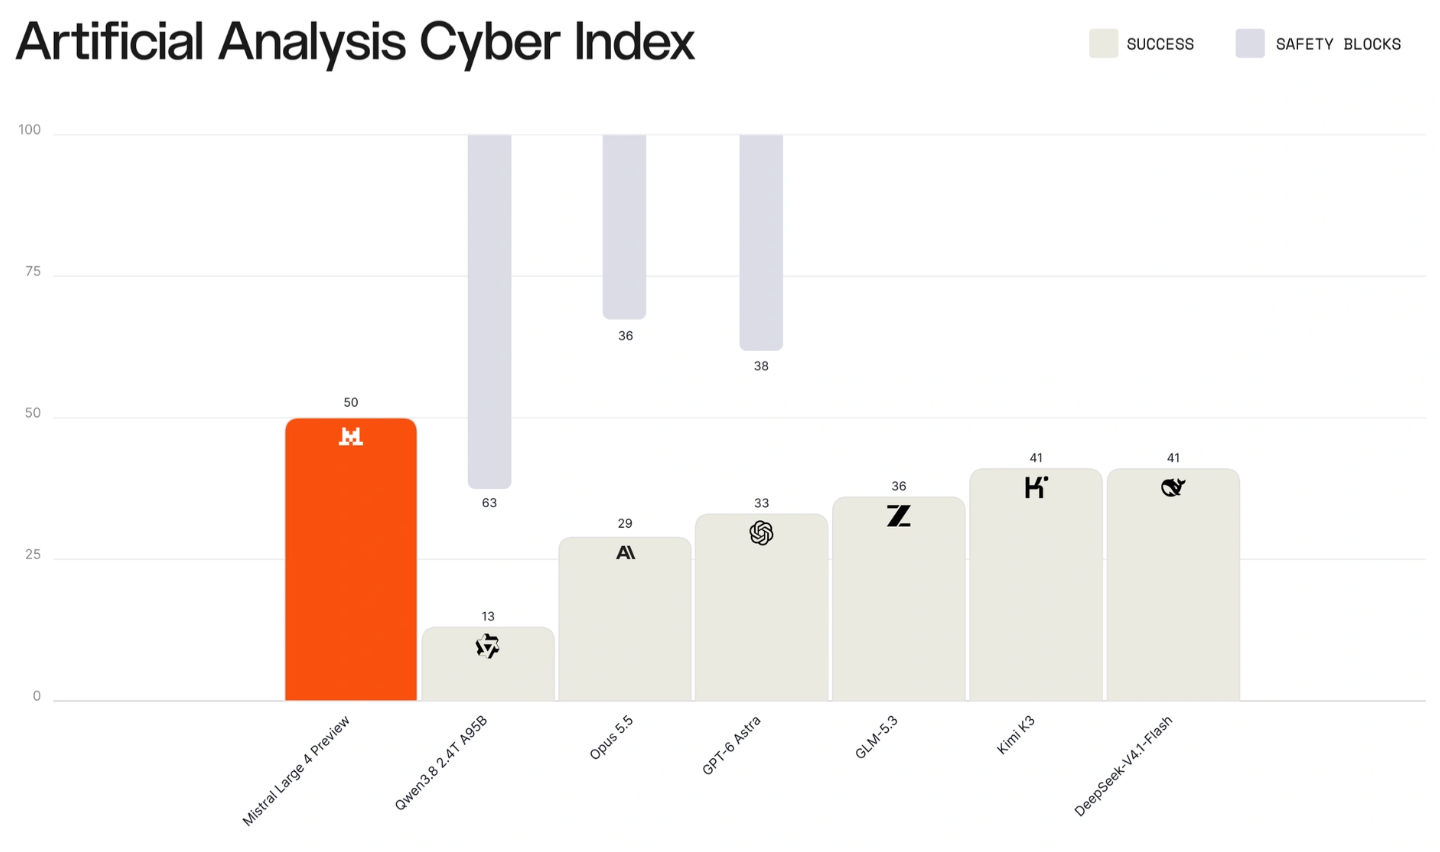
然后是前提,用 Mistral 自己的话说:“包括 Claude Opus 5.5 和 GPT-6 Astra 在内的若干领先闭源模型,在同一测试中接近零分,原因是它们拒绝执行该任务。”
所以要这样理解:
| 说法 | 实际含义 |
|---|---|
| “Large 4 在网络安全上胜过 Astra 和 Opus 5.5” | 在这一项测试中,闭源模型拒绝作答。Large 4 作答了,且通常成功。 |
| “Large 4 是最好的黑客模型” | 不成立。拒绝是一种策略选择,不是能力上限。 |
| “Large 4 不安全” | 同样不成立。Mistral 报告称,其在 JailbreakBench、StrongREJECT 和 AgentHarm 的网络安全类 prompt 上的平均拒绝率,高于其他所有开放权重模型。 |
头条背后确实有真实能力。Large 4 还解出了 Cybench 的 93%——这是一组 40 道夺旗(CTF)题,Mistral 称这是开放权重模型已报告的最高分之一。在 B3 Agent Security Benchmark 上,它能抵御 93.3% 的攻击。
对安全团队来说,这个组合才是真正的重点:一个可以自托管、能帮你复现并修补自己代码中 CVE 的模型,同时仍会拒绝大多数明显有害的请求。对 API 团队来说,这是一件值得放在自己硬件上、而不是隔着别人策略过滤器的工具。
在网络安全的范畴之外,Large 4 在哪里胜过 GPT-6 Astra
网络安全那个结果最响,但另外两项对 Astra 的胜利更安静也更有意义,因为两个模型都真正尝试了任务:
| 基准 | Mistral Large 4 | GPT-6 Astra | 说明 |
|---|---|---|---|
| Dense 200(视觉接地) | 42% | 41% | 领先一分。真实,但很微弱。 |
| Finance Agent v2(vals.ai) | 领先 | 落后 | Mistral 只公布排名,没有公布分数。 |
| Harvey Legal Agent Benchmark | 最佳开源模型 | 在列 | 没有公布正面交锋的数字。 |
与其他开放模型相比,差距更大:
| 基准 | Mistral Large 4 | 胜过谁 |
|---|---|---|
| AutomationBench(657 条工作流) | 59.9% | Kimi K3、DeepSeek V4 Pro |
| AA-Briefcase(知识工作) | 1,393 Elo | DeepSeek V4 Pro |
| DeepSWE v1.1(编码) | 61.7% | 领先开放权重模型 |
| SWE-Atlas-QnA | 59.4% | |
| Terminal-Bench 4.0 | 28.3% |
以上全部是 Mistral 自己报告的预览版模型数据。目前还没有独立实验室复现,而 Euronews 报道称发布时强化学习仍在收尾。把这些数字当作强信号,而不是定论。
它仍然落后的地方
Mistral 公布了一项闭源模型明显胜出的结果。在 Surge AI 对五个模型做的编码质量人工评测中,Large 4 Preview 排名第二:
| 模型 | 人工编码评分(满分 5) |
|---|---|
| Claude Opus 5 | 4.22 |
| Mistral Large 4 Preview | 3.74 |
| GLM-5.3 | 3.60 |
| Kimi K3 | 3.59 |
| GLM-5.2 | 3.40 |
这是对中国最强开源模型的干净胜出,但落后 Claude 半个点。Mistral 自己的说法是,Large 4 在编码上正在“缩小”与前沿模型的“差距”,这一表述是诚实的。
另外还缺一块:所有发布材料里都没有与 Claude Fable 5.1 或 GPT-6 Sol 的对比。如果有人告诉你 Large 4 胜过 Fable,请让他拿出基准数据。
规格速览
| 规格 | Mistral Large 4 |
|---|---|
| API 模型 ID | mistral-large-4(别名 mistral-large-4-0) |
| 版本 | 26.10,公开预览 |
| 架构 | 混合专家(MoE),instruct + 推理混合 |
| 参数 | 总计 1.05T,激活 49B,1.6B 视觉编码器 |
| 上下文窗口 | 1M token |
| 输入 | 文本、图像 |
| 推理 | reasoning_effort 参数("high" 或 "none") |
| 工具 | 函数调用、结构化输出、内置 agent 工具 |
| 端点 | /v1/chat/completions、/v1/conversations、/v1/agents、/v1/batch |
| 权重 | 开放,2026 年 10 月底前;许可证尚未公布 |
价格:目前可调用的最便宜的前沿级模型
这部分最该让 API 团队关注。Mistral 的定价页显示,Large 4 在预览期间按标价的一半出售:
| 模型 | 输入 / 1M | 输出 / 1M | 开放权重 |
|---|---|---|---|
| Mistral Large 4(预览价) | $0.68 | $2.09 | 是,10 月底 |
| Mistral Large 4(标价) | $1.36 | $4.18 | 是,10 月底 |
| Claude Opus 5.5 | $4.00 | $20.00 | 否 |
| GPT-6 Astra | $10.00 | $50.00 | 否 |
按预览价计算,Large 4 的输出成本约为 Astra 的二十四分之一。即便按标价,输出也便宜约 12 倍。缓存输入可降到 $0.07/百万 token,这对每轮都重发同一份系统 prompt 和工具定义的 agent 来说很重要。
Mistral 没有说明预览折扣何时结束,因此做预算时请按标价计算。
应该切换吗?
如果符合以下情况,现在就值得试:
- 你在跑 agent 工作流或知识工作自动化,并且正在付前沿模型的价格。AutomationBench 和 AA-Briefcase 表明 Large 4 在这里具备竞争力,成本却只有零头。
- 你需要覆盖欧盟语言的多语言输出,或为了合规而使用欧盟境内的推理服务。
- 你做防御性安全工作,且经常在合法的漏洞复现上被拒绝。
- 你希望几周后就能自托管一个前沿级模型。
如果符合以下情况,先等等:
- 代码质量是你的主要指标。在人工评分编码上,Claude 仍然领先。
- 你需要能在评审中站得住脚的数字。等权重放出后的独立基准。
- 你在生产环境跑 Large 3。预览版仍可能变化,Mistral 也还没发布稳定的版本化 ID。
如何在 Apifox 中用你自己的 API 测试 Large 4
基准测试告诉你模型在别人的任务上表现如何,而更快的决策方式,是让 Large 4 跑你自己的 prompt,再和今天付费在用的模型对比。Apifox 无需一行胶水代码就能做到:
- 把请求保存一次。新建
POST https://api.mistral.ai/v1/chat/completions,把 key 存成环境变量,并设置Authorization: Bearer {{MISTRAL_API_KEY}}。 - 按模型克隆。复制该请求,只改
model字段(mistral-large-4对比你当前的模型),分别发送。Apifox 会并排展示响应、状态码、耗时和大小,而usage块给出的 token 数可以直接用于成本对比。 - 添加断言。校验
200状态码、回答非空,如果你要求结构化输出,还可以加上 JSON Schema 匹配。这样一次性实验就变成了回归测试。 - 每次模型更新都重跑。把这些请求归入一个测试场景,Mistral 更新预览版或放出权重时重跑一遍,你就能在用户之前发现质量是否漂移。
Large 4 的两项优势天然契合 API 工作。它的安全表现让它很适合充当 API 安全测试的第二审查者,例如在你自己的预发环境 API 上复现一个鉴权绕过问题。它的函数调用和结构化输出能力,则可以让你把在 Apifox 中设计好的 OpenAPI 规范,转成 agent 可直接调用的工具定义。
包含 key、推理分块、图像、函数调用和成本计算的完整代码演练,见我们的《Mistral Large 4 API 指南》。如果你从更早的 Mistral 模型迁移过来:《Mistral AI API 基础》和《Mistral Medium 3.5 API 指南》依然适用——相同的 base URL、相同的鉴权,只是换了模型 ID。
常见问题
Mistral Large 4 是开源的吗? 它是开放权重的。Mistral 称权重将在 2026 年 10 月底前放出,许可证尚未公布,所以不要假定它与 Large 3 的 Apache 2.0 一致。
Mistral Large 4 真的胜过 GPT-6 Astra 吗? 按 Mistral 的数字,在视觉接地(42% 对 41%)和 Finance Agent v2 上确实如此。在网络安全漏洞测试中,Astra 接近零分是因为它拒绝执行,因此那不是同口径的胜利。
它胜过 Claude 吗? 编码上没有。人工编码评测中 Claude Opus 5 以 4.22 对 3.74 领先。Claude Opus 5.5 同样拒绝网络安全复现任务,这也是它在那里接近零分的原因。
“Le Chonk”是什么意思? 这是 Mistral 给该模型起的非正式昵称,拿它的体型开了个玩笑。官方名称是 Mistral Large 4,简称 ML4。
可以免费用吗? Mistral 的免费方案每月包含 $10 的 API 额度,并可在 Le Chat 和 Vibe 中访问其最新模型。按预览价,$10 大约能买到 Large 4 的 480 万输出 token。
结论
Mistral 回到了前沿模型的讨论之中。按 Mistral 的数字,Large 4 是中国以外最强的开放权重模型,成本只有 Astra 或 Opus 5.5 的零头,并且几周内就能跑在你自己的硬件上。“在网络安全上胜过 Astra 和 Claude”这句是真的,但来自对方的拒绝执行;而关于编码的诚实结论是“仅次于 Claude”。趁预览价还在,现在就在 Apifox 里用你自己的 API 测一测,并把生产环境的决策推迟到 10 月 27 日之后的独立基准出炉。
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。