Mistral Large 4 于 2026 年 10 月 6 日在 Mistral API 上线,比开放权重早了三周。想现在就试这个 1 万亿参数的“Le Chonk”,API 是唯一入口,而且目前也是最便宜的入口:公开预览期 Mistral 标价为每百万输入 token $0.68、每百万输出 token $2.09,是 $1.36 / $4.18 官方标价的一半。
本指南带你在五分钟左右完成第一次可用的调用,然后覆盖最容易踩坑的部分:推理块、图片输入、函数调用、JSON 输出和成本。每个请求都可以保存到 Apifox 里反复回放,方便你把 Large 4 和现在在用的模型做对比。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

对模型本身还不熟?先读《Mistral Is Back: Le Chonk Beats GPT-6 Astra and Claude at Cyber》,了解基准成绩和 cyber 标题背后的注意事项。
准备工作
| 项目 | 内容 |
|---|---|
| Base URL | https://api.mistral.ai/v1 |
| Auth | Authorization: Bearer $MISTRAL_API_KEY |
| Model ID | mistral-large-4(别名 mistral-large-4-0) |
| 主接口 | POST /v1/chat/completions |
| 上下文窗口 | 1M token |
| 输入类型 | 文本、图片 |
| Python SDK | pip install mistralai |
| TypeScript SDK | npm install @mistralai/mistralai |
第 1 步:获取 API key
- 登录 Mistral Studio(原 La Plateforme)。
- 打开 API Keys,创建一个新 key。命名时写清它用在哪里,比如
local-dev或ci-staging。 - 只复制这一次。Studio 不会再次显示它。
- 在 shell 里导出:
export MISTRAL_API_KEY="your-key-here"
不要把 key 提交进版本库。如果要接入多个工具,《API key 管理最佳实践》讲了轮换和权限范围。
第 2 步:发出第一次调用
最快的验证方式是裸 curl:
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4",
    "messages": [
      {"role": "user", "content": "Give me three edge cases to test on a pagination API."}
    ]
  }'
成功响应会在 choices[0].message.content 里返回答案,并带一个包含 prompt_tokens、completion_tokens 和 total_tokens 的 usage 块。返回 401 说明 key 错了或没导出;模型返回 404 通常是 model ID 打错了。
同样的调用,Python 版
import os
from mistralai import Mistral

client = Mistral(api_key=os.environ["MISTRAL_API_KEY"])

response = client.chat.complete(
    model="mistral-large-4",
    messages=[
        {"role": "user", "content": "Give me three edge cases to test on a pagination API."}
    ],
)

print(response.choices[0].message.content)
以及 TypeScript 版
import { Mistral } from "@mistralai/mistralai";

const client = new Mistral({ apiKey: process.env.MISTRAL_API_KEY });

const response = await client.chat.complete({
  model: "mistral-large-4",
  messages: [
    { role: "user", content: "Give me three edge cases to test on a pagination API." },
  ],
});

console.log(response.choices[0].message.content);
第 3 步:保存到 Apifox
一旦开始对比模型,手敲 curl 就累了。在 Apifox 里:
- 新建 HTTP 请求:
POST https://api.mistral.ai/v1/chat/completions。 - 添加环境变量
MISTRAL_API_KEY,header 设为Authorization: Bearer {{MISTRAL_API_KEY}}。 - 粘贴第 2 步的 JSON body,点击发送。
- 复制该请求,把
model改成你现在用的模型(比如mistral-medium-3-5),两个都跑一遍。
这样你就有了两个提示词相同的保存请求。Apifox 会分别显示响应体、状态码、耗时和大小,不用写脚本就能对比回答质量、延迟和 usage token 数。再加一条 choices[0].message.content 非空的后置断言,就得到了一个冒烟测试,Mistral 更新预览时随时重跑。
第 4 步:开与关推理
Large 4 是混合模型:同一个模型既能快答,也能逐步推理。用一个参数 reasoning_effort 控制:
| 取值 | 行为 | 适用场景 |
|---|---|---|
"none" |
最少思考,响应里没有 thinking 块 | 聊天、抽取、分类,一切对延迟敏感的场景 |
"high" |
最终答案前输出完整 thinking 块 | 调试、多步规划、数学、代码评审 |
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4",
    "messages": [
      {"role": "user", "content": "Our API returns 200 with an empty body under load. List likely causes in order of probability."}
    ],
    "reasoning_effort": "high"
  }'
这是最容易弄坏解析器的地方。开 reasoning_effort: "high" 后,message.content 不再是字符串,而变成块列表:
- 一个
thinking块装推理轨迹, - 一个
text块装最终答案。
所以 response.choices[0].message.content 打印出来是一个列表,不是你的答案。要显式取出 text 块:
response = client.chat.complete(
    model="mistral-large-4",
    messages=[{"role": "user", "content": "Why would a 200 response have an empty body?"}],
    reasoning_effort="high",
)

content = response.choices[0].message.content
if isinstance(content, str):
    answer = content
else:
    answer = "".join(c.text for c in content if c.type == "text")

print(answer)
思考 token 按输出 token 计费,"high" 每次请求都更贵。默认用 "none",只给确实需要的调用开 "high"。
第 5 步:发送图片
Large 4 原生多模态,带 1.6B 参数的视觉编码器。把图片作为内容部分和文本一起传:
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4",
    "messages": [
      {
        "role": "user",
        "content": [
          {"type": "text", "text": "This is a screenshot of our API error dashboard. Which endpoint is failing most and what is the error code?"},
          {"type": "image_url", "image_url": "https://example.com/dashboard.png"}
        ]
      }
    ]
  }'
本地文件改用 base64 data URL:"image_url": "data:image/png;base64,<encoded>"。Mistral 称 Large 4 在 Dense 200 视觉落地基准上得 42%,略高于 GPT-6 Astra 的 41%,所以仪表盘、图表和 UI 状态的截图是合理的用例。
第 6 步:函数调用
函数调用是 Large 4 的 agent 基准(AutomationBench 59.9%)真正派上用场的地方。你描述工具,模型决定何时调用,调用由你的代码执行。
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_order_status",
            "description": "Look up the status of an order by its ID.",
            "parameters": {
                "type": "object",
                "properties": {
                    "order_id": {"type": "string", "description": "The order ID, e.g. ORD-1042"}
                },
                "required": ["order_id"],
            },
        },
    }
]

messages = [{"role": "user", "content": "Where is order ORD-1042?"}]

response = client.chat.complete(
    model="mistral-large-4",
    messages=messages,
    tools=tools,
    tool_choice="auto",
)

tool_call = response.choices[0].message.tool_calls[0]
print(tool_call.function.name, tool_call.function.arguments)
函数由你自己执行,然后把结果连同对应的 tool_call_id 发回去:
import json

result = {"order_id": "ORD-1042", "status": "shipped", "eta": "2026-10-09"}

messages.append(response.choices[0].message)
messages.append({
    "role": "tool",
    "name": "get_order_status",
    "content": json.dumps(result),
    "tool_call_id": tool_call.id,
})

final = client.chat.complete(model="mistral-large-4", messages=messages, tools=tools)
print(final.choices[0].message.content)
工具 schema 就是普通 JSON Schema。如果你的 API 本来就有 OpenAPI 定义,可以把每个 operation 的请求 schema 直接搬进 parameters。先在 Apifox 里设计接口定义,工具定义和真实 API 就能保持同步。
第 7 步:拿到 JSON 输出
需要机器可读输出时,设置 response_format:
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4",
    "messages": [
      {"role": "user", "content": "Extract method, path and status code from: GET /v1/users/42 returned 404. Reply in JSON."}
    ],
    "response_format": {"type": "json_object"}
  }'
除了 response_format,提示词里也要提到 JSON。要严格形状的话,Mistral 还支持带完整 schema 的 {"type": "json_schema", "json_schema": {...}}。在 Apifox 里给响应加一条 JSON Schema 断言,形状一漂移就大声报错,而不是悄悄弄坏下游服务。
价格
| 用量 | 预览价 | 标价 |
|---|---|---|
| 输入,每 1M token | $0.68 | $1.36 |
| 缓存输入,每 1M token | $0.07 | $0.14 |
| 输出,每 1M token | $2.09 | $4.18 |
算笔账:一个每天调用 1 万次的 agent,每次 3000 输入 token(大头是缓存的系统提示词和工具)加 500 输出 token。
- 输入:3000 万 token。若每 3000 里有 2500 命中缓存,就是 2500 万按 $0.07、500 万按 $0.68,约 $5.15/天。
- 输出:500 万 token 按 $2.09,约 $10.45/天。
- 合计:按预览价约 $15.60/天,按标价约 $31。
同样的负载放到 GPT-6 Astra(每百万 $10 / $50,缓存折扣前)每天要几百美元。Mistral 没说预览价什么时候结束,做预算请按标价来。
常见错误
| 错误 | 可能原因 | 处理办法 |
|---|---|---|
401 Unauthorized |
key 缺失或错误 | 检查 echo $MISTRAL_API_KEY 和 Bearer 前缀 |
404 / invalid model |
model ID 打错 | 严格使用 mistral-large-4 |
422 Unprocessable Entity |
body 格式错误,常见于 tools schema 写错 |
校验每个工具 parameters 里的 JSON Schema |
429 Too Many Requests |
工作区档位的速率限制 | 退避重试,或在 Studio 里提额 |
| 答案打印成列表 | reasoning_effort: "high" 返回块列表 |
提取 text 块(第 4 步) |
常见问题
Mistral Large 4 兼容 OpenAI 格式吗?请求形状非常接近:model、messages、tools、tool_choice 和 response_format 都按你预期的方式工作。稳妥起见用 Mistral 官方 SDK 或裸 HTTP。推理输出用的是 Mistral 自己的块格式。
什么时候能本地跑?Mistral 说权重在 2026 年 10 月底前发布。总参数 1.05T,需要多 GPU 服务器。在那之前,《本地运行 Mistral 3 指南》介绍了较小模型的工具链。
预览版稳定到能上生产吗?还不能。模型标记为 public preview,权重发布前可能变动。把测试固定住,Mistral 更新模型时重跑,并配置一个兜底模型。
现有 Mistral 代码能直接用 Large 4 吗?能。base URL、auth、SDK 都不变,把 model 字符串改成 mistral-large-4 即可。从 Medium 3.5 过来的话,《Mistral Medium 3.5 API 指南》讲了哪些部分可以直接沿用。
小结
五分钟就能跑通第一次调用。接下来这一小时,更值得把你的真实提示词在 Large 4 和现有模型上并排跑。把两个请求都保存进 Apifox,加上状态码和响应形状的断言,一天之内你就能知道 Le Chonk 值不值得进你的技术栈——趁预览价还在打五折。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
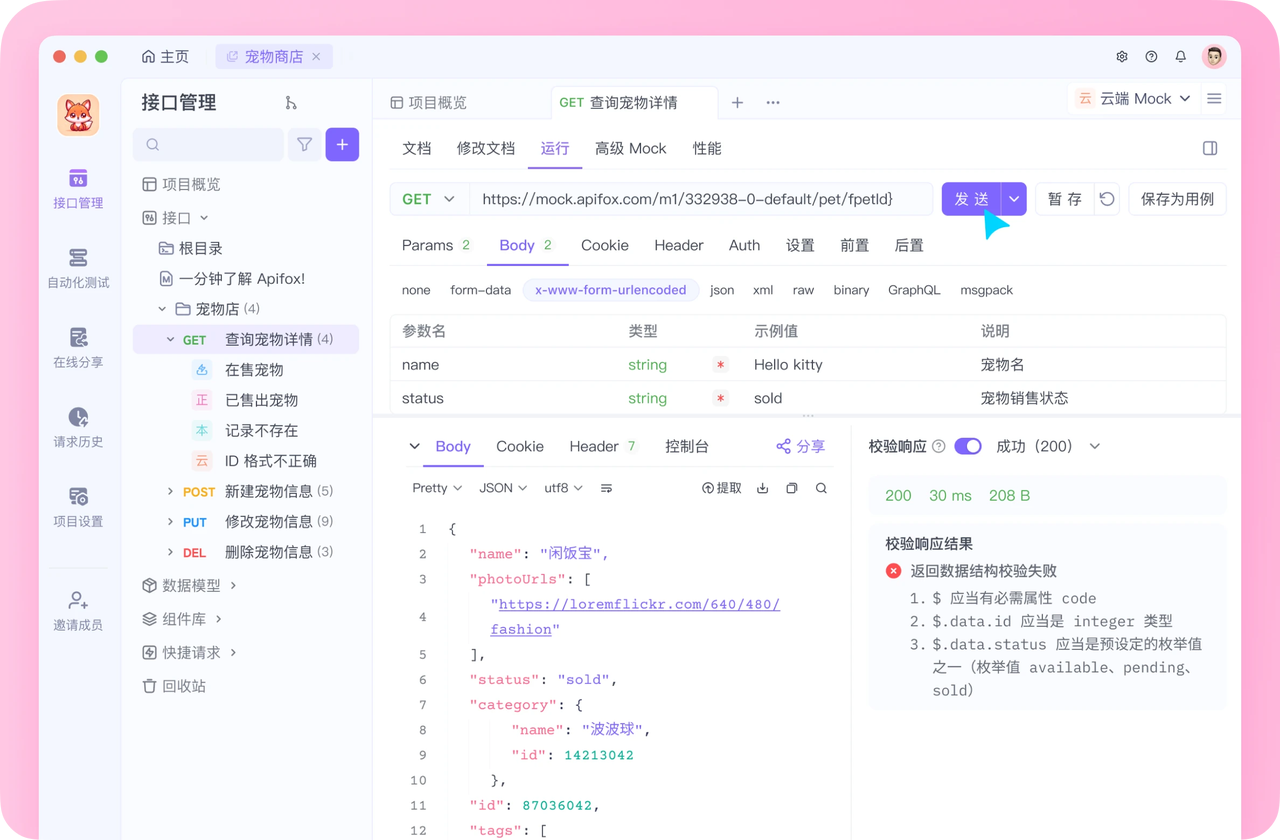
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会