Swagger 不是敌人。它把 API 文档从 Word 里解放出来,让 OpenAPI 成为事实标准。
问题是,很多团队只用了 Swagger 的“渲染”能力:
- 文档是生成了,但没人维护。
- Mock 另起一套,和文档对不上。
- 测试在 Postman 里,和文档又是两份。
- 接口改完,文档、Mock、测试三处同步,早晚有一处漏。
- 规范越写越乱,最后连自己都不敢信。
从 Swagger 迁到 Apifox,不是换一个文档页面,而是把 OpenAPI 规范变成设计、Mock、测试、CI 的同一份源头。
一、Swagger/OpenAPI 能解决什么,不能解决什么
| 能力 | Swagger/OpenAPI | 迁移后要补的 |
|---|---|---|
| 描述接口 | 强 | 业务语义、错误码、示例 |
| 生成文档 | 强 | 权限、分享、版本、搜索 |
| 交互调试 | 中 | 环境、鉴权、变量、团队共享 |
| Mock | 弱 | 智能 Mock、自定义脚本、私有 Mock |
| 自动化测试 | 无 | 场景编排、断言、数据库校验、CI |
| 规范治理 | 弱 | 规范检查、公共 Schema、分支审核 |
| AI 可读 | 弱 | MCP、结构化规范 |
所以迁移的第一步不是“导入”,而是承认:OpenAPI 是契约,不是完整协作平台。
二、迁移前先把规范清理干净
导入工具只能导入你写的东西。规范里的坑,导入后会原样放大。
建议先做一轮 lint:
openapi/swagger版本是否统一?servers是否指向正确环境?- 每个接口是否有
summary和description? - 参数是否写了类型、必填、示例、枚举?
- 响应是否覆盖 200、4xx、5xx?
- 错误结构是否统一?
components/schemas是否有重复模型?securitySchemes是否和真实鉴权一致?- 是否有废弃接口没标注?
- 示例是否含真实密钥/用户数据?
如果规范里有大量 example: "string"、空描述、重复 Schema,先修一轮再导。否则迁移后只是把混乱换了个界面。
三、导入 Apifox 的 5 步
第 1 步:导出 OpenAPI/Swagger 文件
从现有网关、代码注解、Swagger UI 或文件仓库导出 JSON/YAML。建议同时保留:
- 原始文件(归档)
- 清理后的文件(导入)
- 版本说明(改了什么)

导出前先在 Swagger Editor 里核对分组、方法和路径。图来自《替代 Swagger 的最佳工具平台》。
第 2 步:在 Apifox 新建项目并导入
选择 OpenAPI/Swagger 导入,按提示选择文件和环境。建议先导入到测试项目,不要直接覆盖生产项目。
第 3 步:核对目录和模型
重点看:
- 接口分组是否合理
- 数据模型是否重复
- 公共响应结构是否抽取
- 枚举、示例、默认值是否保留
- 鉴权配置是否识别

导入后重点核对目录、数据结构和示例是否还在。
第 4 步:配置环境
把开发、测试、预发、生产环境拆开,配置:
- Base URL
- 鉴权参数
- 公共变量
- 数据库连接(如果测试要用)
第 5 步:跑通一条最小链路
选一个核心接口,走完:
导入 → 文档 → 调试 → Mock → 测试场景 → CI
这条链路跑通,再批量迁移。
四、设计:把 Schema 变成可复用资产
迁移后最容易重复的老习惯,是“每个接口都重新定义一遍用户、分页、错误结构”。
Apifox 的公共数据模型可以解决这个问题:
- 用户、订单、分页、错误响应定义一次。
- 多个接口引用同一个 Schema。
- 改基础字段,关联接口自动感知。
- 跨项目复用,减少重复定义。
建议先抽三类公共模型:
- 分页结构:
page、pageSize、total、list。 - 统一响应:
code、message、data、traceId。 - 错误结构:错误码、错误信息、可恢复建议、请求 ID。
然后再做规范检查:
- 命名是否统一(camelCase/snake_case)
- 必填字段是否有说明
- 枚举是否有含义
- 示例是否脱敏
- 错误码是否登记
五、Mock:让前端不再等后端
Swagger 也能生成 Mock,但通常是“按 Schema 随机返回”。Apifox 的 Mock 可以更进一步:
- 智能 Mock:根据字段名生成手机号、姓名、地址、头像等合理数据。
- 自定义脚本:根据入参返回不同结果。
- 环境隔离:开发/测试环境用不同 Mock。
- 私有 Mock:部署在内网,不依赖公网。
迁移时要注意:
- 旧 Mock 地址是否被前端引用?需要同步替换。
- Mock 返回结构是否和文档一致?
- 是否有真实数据混进 Mock?
- 异常场景(429、500、超时)是否要模拟?
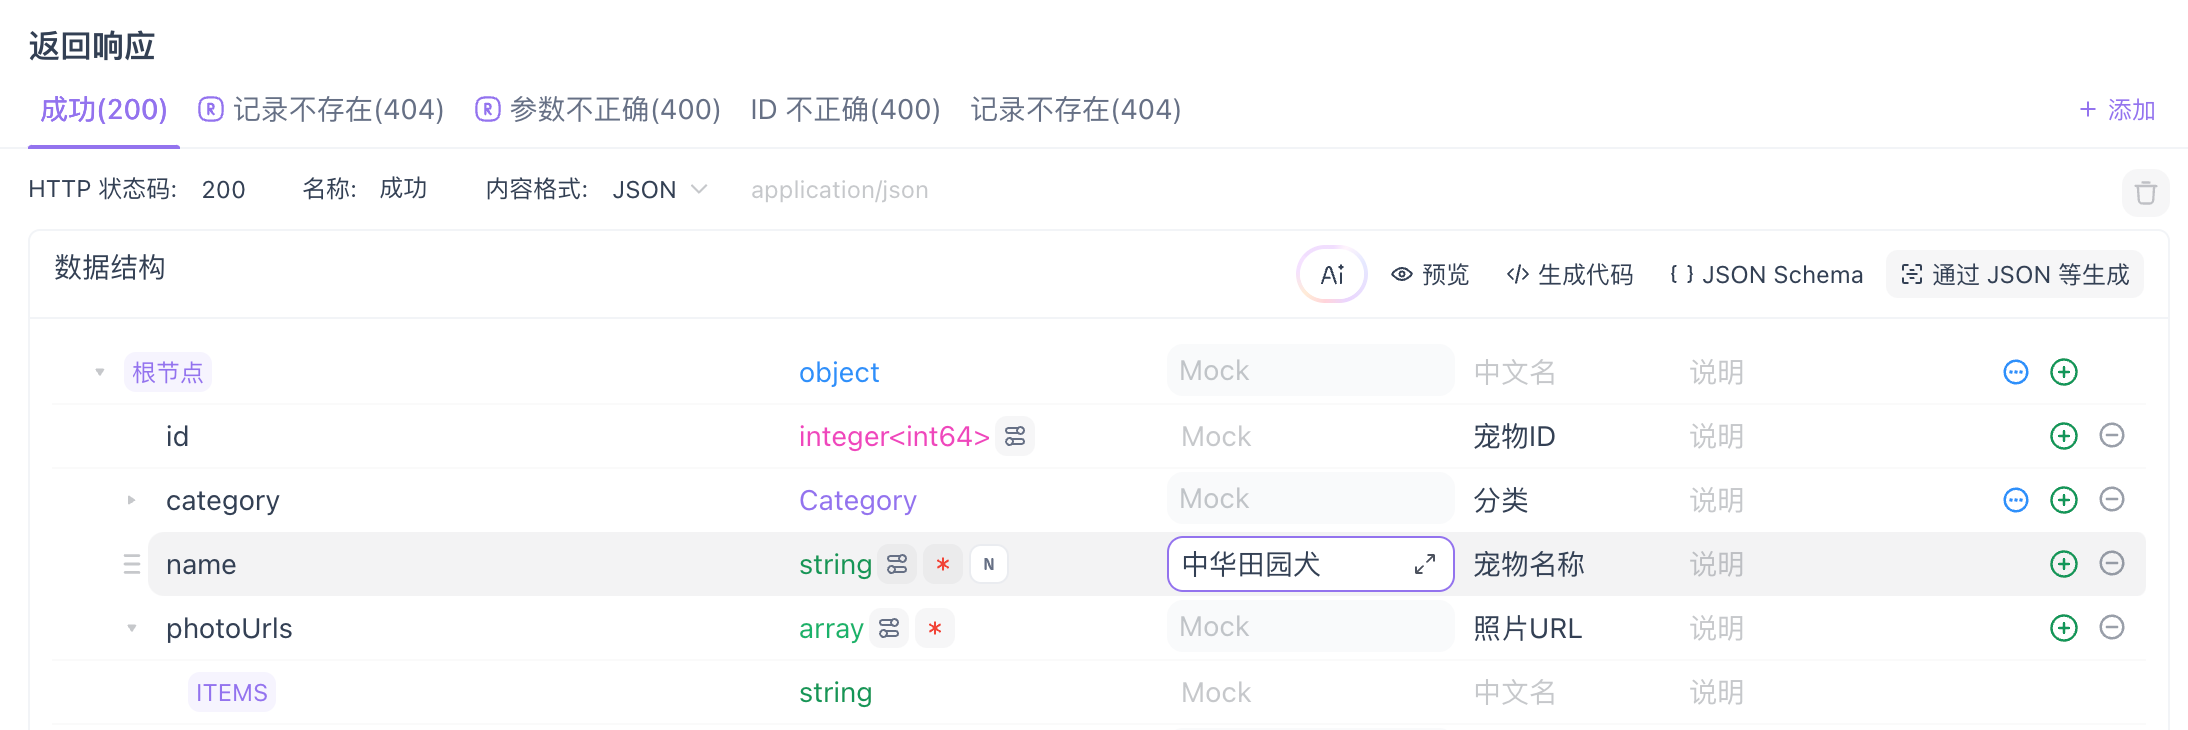
Mock 要跟文档里的数据结构一致。这张图来自《如何在 Apifox 中返回条件 Mock 数据》。
六、测试:把文档里的契约跑起来
文档写得好,不代表接口实现正确。迁移后建议把核心接口补上测试:
1. 测试场景
把“登录 → 查询 → 下单 → 支付 → 查订单”串成场景,前后置提取变量。
2. 断言
不要只看 HTTP 200:
- 业务 code 是否正确
- 关键字段是否存在
- 数据类型是否正确
- 数据库是否写入
- 响应时间是否可接受
3. 数据驱动
用 CSV/JSON 跑多组参数,覆盖正常、边界、异常。
4. CI 集成
用 Apifox CLI 在流水线里跑:
npm install -g apifox-cli
apifox run \
  --access-token "$APIFOX_ACCESS_TOKEN" \
  -t <测试场景ID> \
  -e <环境ID> \
  -r cli,junit
失败返回非零退出码,可以直接作为质量门禁。
七、迁移验收清单
| # | 检查项 | 通过标准 |
|---|---|---|
| 1 | 规范文件 | OpenAPI/Swagger 可正常导入 |
| 2 | 接口数量 | 与旧平台一致,无漏导 |
| 3 | 数据模型 | 重复模型已合并,公共 Schema 已抽取 |
| 4 | 文档 | 描述、示例、错误码完整 |
| 5 | 环境 | 开发/测试/预发/生产齐全 |
| 6 | 鉴权 | API Key/Bearer/OAuth 可用 |
| 7 | Mock | 前端可联调,旧地址已替换 |
| 8 | 测试 | 核心场景可跑通 |
| 9 | CI | 流水线可执行并产出报告 |
| 10 | 权限 | 团队/项目权限符合预期 |
| 11 | 回滚 | 旧平台仍可用,可随时回退 |
| 12 | 培训 | 相关角色完成培训 |
八、结论
从 Swagger 迁到 Apifox,正确的顺序是:
- 先清理 OpenAPI 规范。
- 再导入并核对模型。
- 然后补文档、Mock、测试。
- 最后接 CI 和权限。
不要把它当成“换一个文档皮肤”。真正的收益,是让同一份契约驱动设计、文档、Mock、测试和 CI,减少三处同步的成本。
想直接导入现有的 Swagger/OpenAPI 文件,可以访问 Apifox 官网 下载体验;如果团队需要内网部署,可以看 私有化方案。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
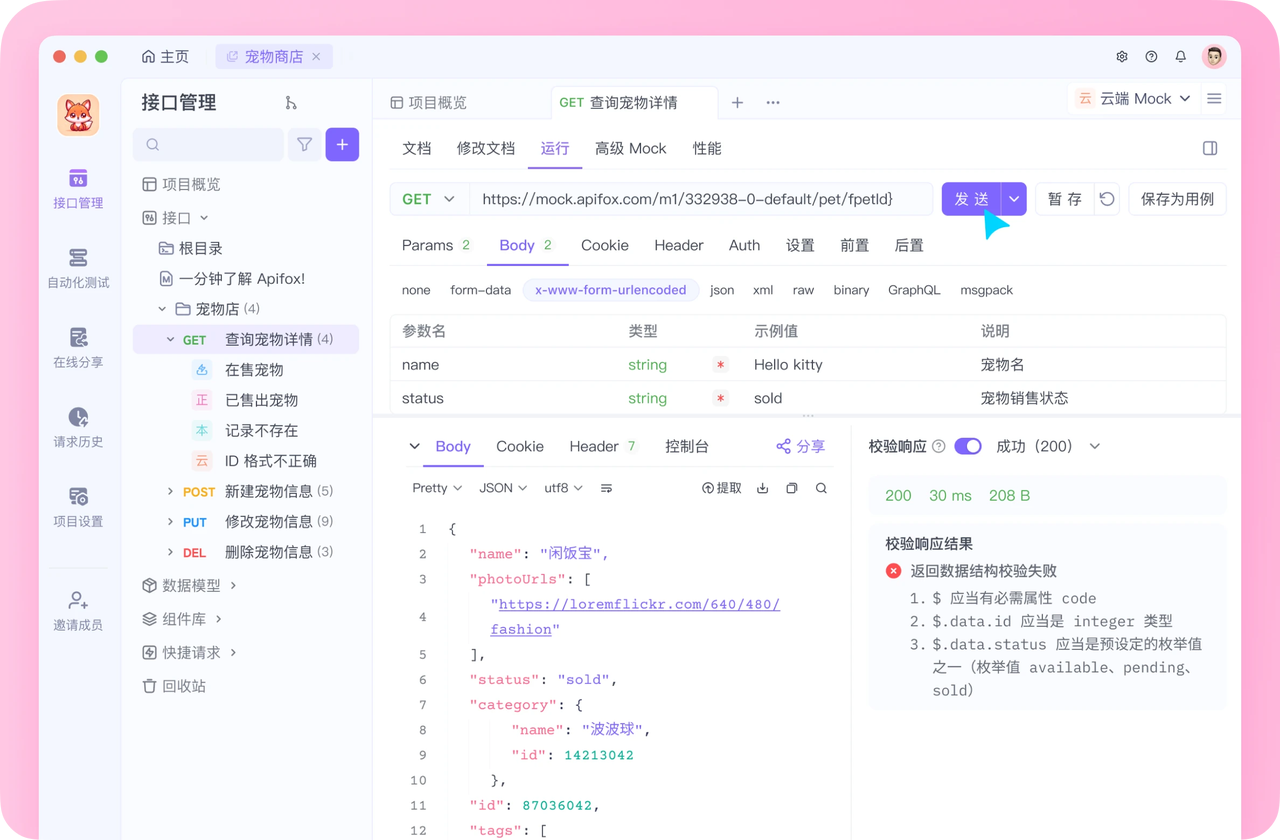
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会