MCP 与 CLI 的差别,归根结底在于 Agent 什么时候为工具付出成本。MCP Server 会在你输入任何内容之前,就把每个工具的名称、描述和 JSON Schema 发给模型。CLI 则不产生任何成本,直到 Agent 运行它并读取 --help 或输出。在一次实测中,四个常见的 MCP Server 合计增加了 11,923 个 token 的工具定义;Apifox CLI skill 只增加了 112 个。
这个差距正是本周两篇 Dev.to 文章的主题。一位开发者向编码 Agent 输入“运行测试”,结果第一次请求就产生了 28,400 个输入 token,既没有附带文件,也没有历史记录。罪魁祸首是七个 MCP Server。另一位作者则认为,MCP 构建起来极其简单,而真正困难的部分(认证、审批、重复调用)恰恰在 demo 跑通之后才开始。
本文只回答一个问题:工具定义会占用多少上下文窗口,以及当 Agent 按需调用 CLI 时,成本何时会更低?如果你面对的问题反而是工具返回结果过大,那么重点应放在精简 API 响应上,而不是削减工具定义。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
为什么 MCP Server 会占用上下文窗口 token
MCP Server 通过 tools/list 方法公布自己的工具。按照 MCP 工具规范,每个工具都带有 name、description 和 inputSchema(描述其参数的 JSON Schema)。模型要选择工具,客户端就必须把这些定义放进请求。在经典配置下,无论 Agent 是否调用该工具,每一次对话的每一轮都会发生这件事。
因此,成本会随三件事增长:
- 工具数量。 一个完整的 GitHub 集成可能暴露数十个工具。
- Schema 深度。 嵌套对象、枚举和冗长的描述都会变成 token。
- 轮次。 Agent 循环会在每一步重新发送这些定义。
necoz 的文章给出了具体数字:一个包含 52 个工具的组合在第一轮消耗了 24,600 个 token 的 schema,而 4 个工具的组合只消耗 640 个;在一个 10 步循环中,前者总计约 246,000 个 token。请把这些数字视为一位开发者的测量结果,而不是基准测试。提示词缓存可以降低重复定义带来的费用,但这些 token 仍然占据窗口,并与你的代码争夺模型的注意力。
质量同样有代价。Anthropic 的工具搜索文档指出,同时接入 GitHub、Slack、Sentry、Grafana 和 Splunk 的多 Server 配置“在 Claude 开始任何工作之前,就可能消耗约 55k token 的定义”;而且一旦可用工具超过 30 到 50 个,Claude 的工具选择准确率就会下降。
MCP 工具定义 token:一次可复现的测量
2026-11-16,我在本地通过 stdio 启动了五个 MCP Server,用一个 30 行的 Node 脚本发送 initialize 和 tools/list,并统计每个工具 name、description 和 inputSchema 中的 token。
先说一个前提:我使用 OpenAI 的 tiktoken o200k_base 编码来计数,因为它可以离线运行。Claude、Gemini 和其他模型使用各自的分词器,所以你的统计结果会有一定差异。这里真正重要的是不同配置之间的比例。
| MCP Server(版本) | 工具数 | 定义 token | 平均每工具 token |
|---|---|---|---|
@playwright/mcp 0.0.85 |
25 | 4,634 | 185 |
@modelcontextprotocol/server-filesystem 2.3.0 |
16 | 3,281 | 205 |
@modelcontextprotocol/server-memory 2.1.1 |
9 | 2,013 | 224 |
@modelcontextprotocol/server-everything 2.3.0 |
16 | 1,995 | 125 |
| 四个合计 | 66 | 11,923 | 181 |
apifox-mcp-server 0.0.18 |
3 | 291 | 97 |
四个普通 Server 在 Agent 读取任何文件之前,就要花掉约 12,000 个 token。
最后一行是有用的反例。Apifox MCP Server 只暴露三个范围很窄的工具(读取项目的 OpenAPI 规范、读取 $ref 文件、刷新规范),因此只消耗 291 个 token。决定账单的是工具数量和 schema 深度,而不是协议本身。
在 CLI 这一侧,我测量了 Agent 使用 Apifox CLI 2.2.12 时实际会读到什么:
| CLI 文本 | 何时进入上下文 | token |
|---|---|---|
| Apifox CLI skill 描述(frontmatter) | 每个会话,作为 skill 列表项 | 112 |
| Apifox CLI skill 正文 | 仅当任务匹配时 | 1,189 |
apifox --help |
仅当 Agent 运行时 | 668 |
apifox test-case --help |
仅当 Agent 运行时 | 511 |
apifox run --help |
仅当 Agent 运行时 | 1,036 |
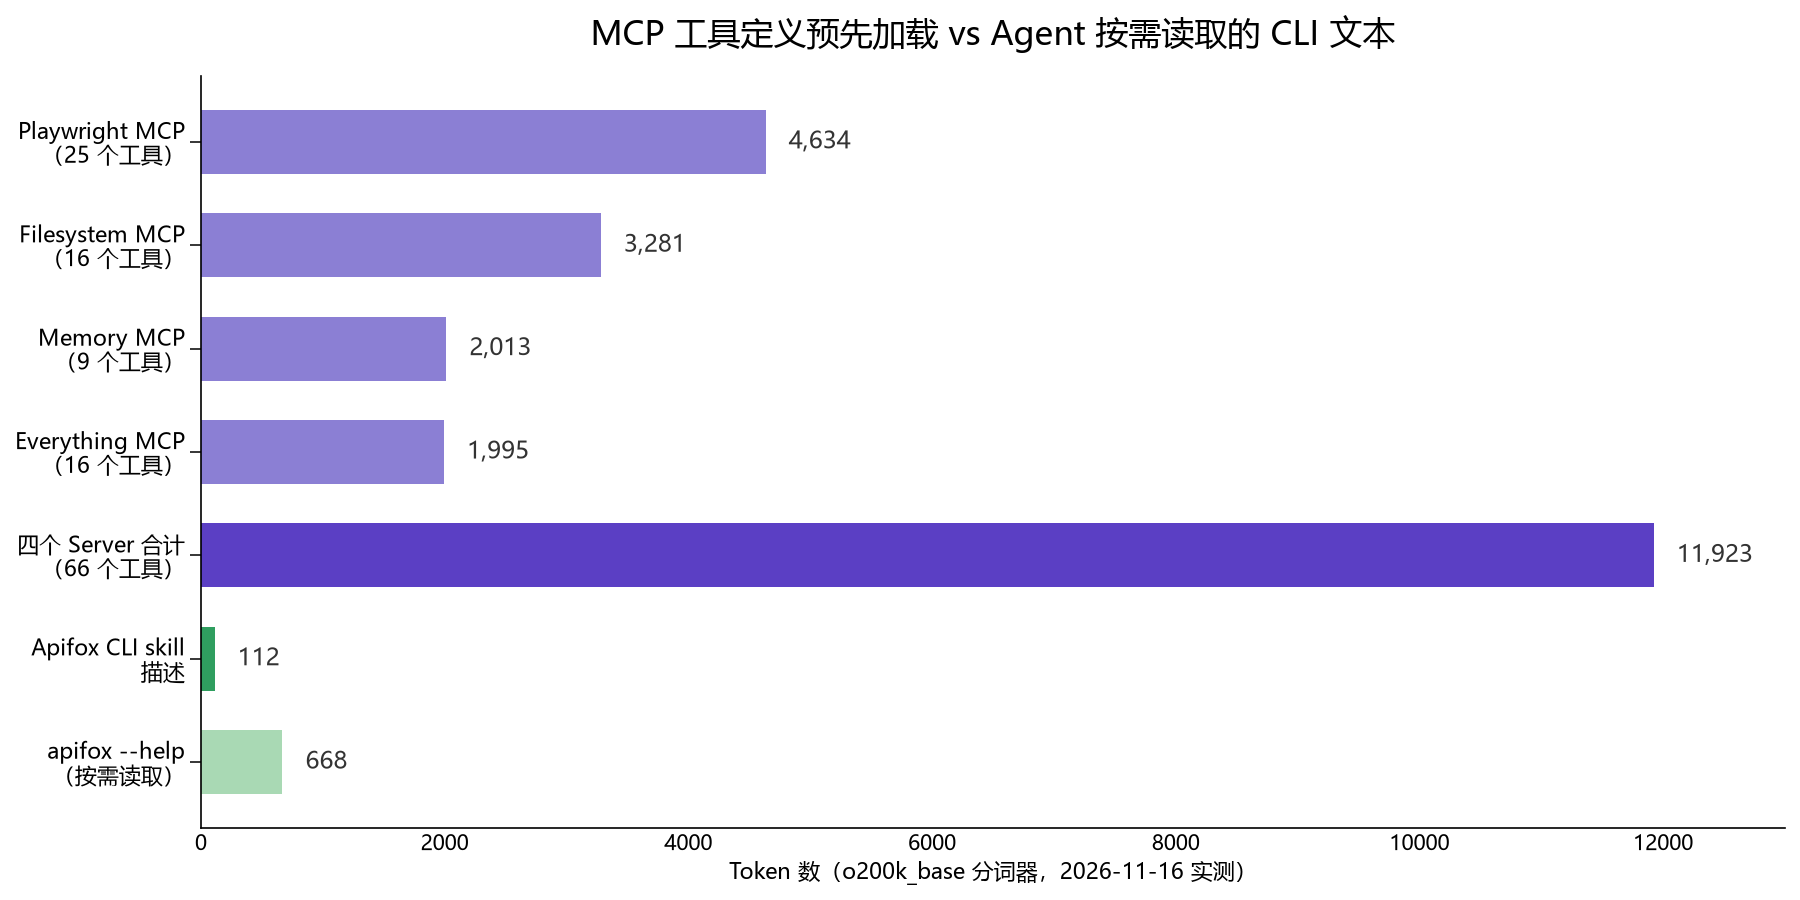
CLI 路线的常驻成本是 112 个 token。即使 Agent 加载完整的 skill 并读取三个帮助页面,总量也接近 3,500 个 token,而且只发生在真正需要它的那次对话里。
MCP vs CLI:token 成本对比
| MCP Server(定义预先加载) | 通过 shell 调用的 CLI | |
|---|---|---|
| 前期成本 | 每轮都发送每个工具的 schema | 零,或一段简短的 skill 描述 |
| 发现方式 | 结构化的 tools/list |
--help 文本,需要时读取 |
| 输出 | 工具返回什么就是什么 | 命令打印什么就是什么(可以过滤) |
| 跨客户端 | 任何 MCP 客户端,一份配置 | 任何带 shell 工具的 Agent |
| 类型化参数 | 支持,通过 JSON Schema | 命令行参数;请求体文件单独校验 |
| 认证与权限 | 由 Server 负责(远程 HTTP Server 使用 OAuth) | 本地登录与 shell 权限 |
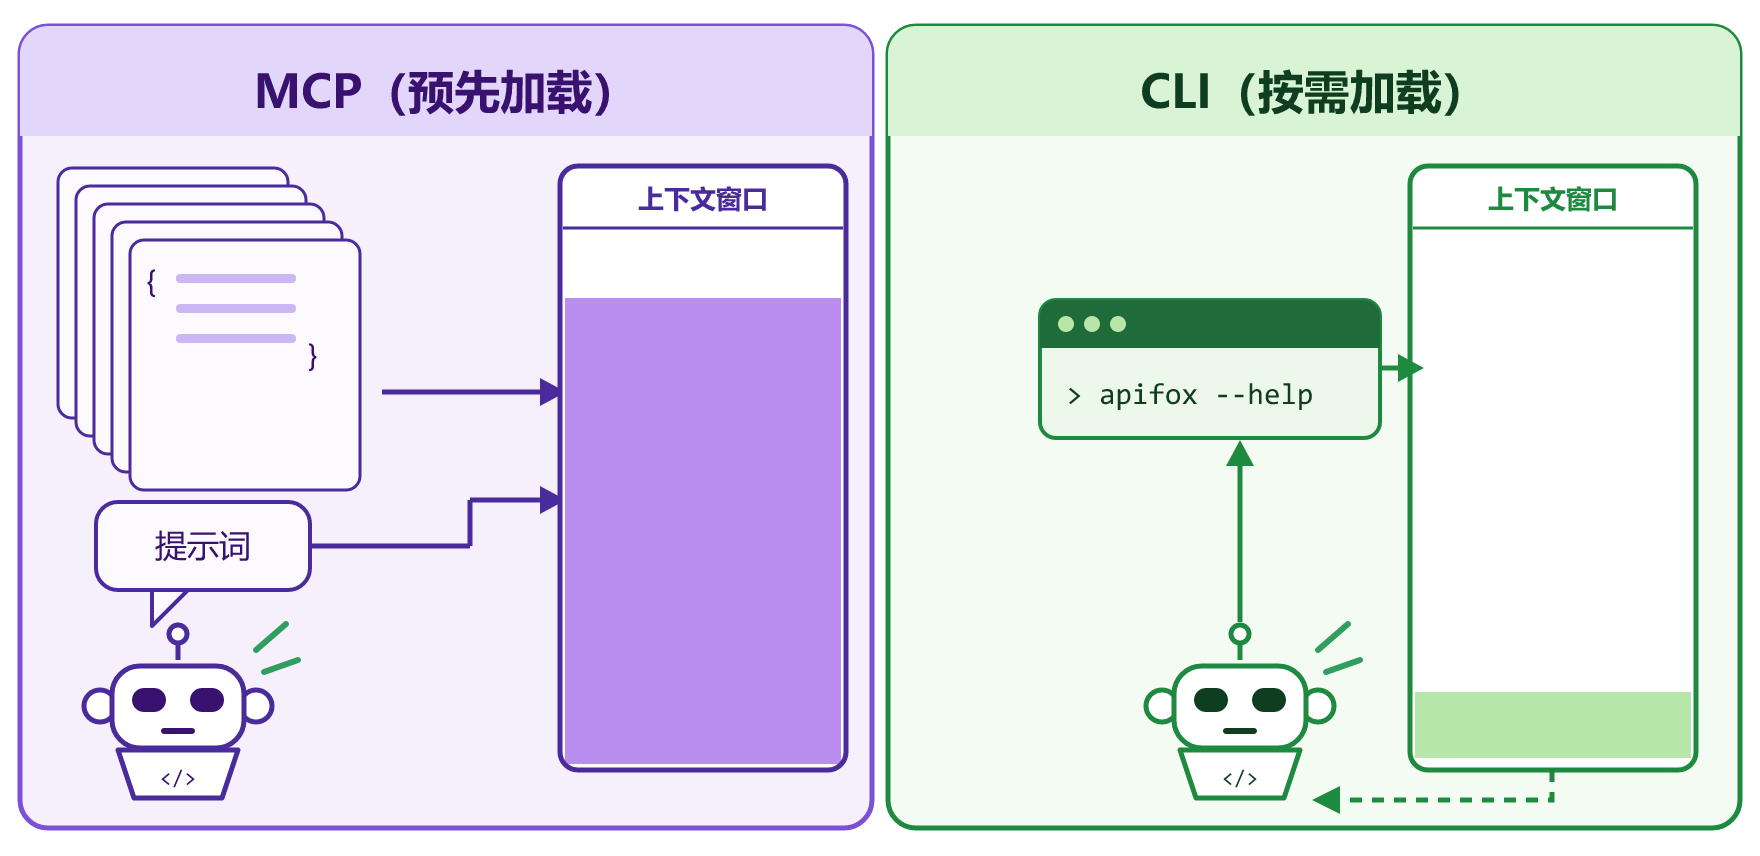
CLI 在前期成本上胜出,因为 Agent 本来就有 shell 工具。运行 apifox endpoint list --project 123 使用的是它无论如何都要加载的 Bash 工具。当你需要在多个客户端中获得同样的能力,又不想为每个客户端分别编写集成时,MCP 路线更合适——这也正是 Sylwia Lask 的观点:MCP 不是 REST 的替代品,而是 AI 客户端发现并调用工具的一种标准方式。
你的客户端可能已经延迟加载 MCP 工具
在把所有 Server 都拆掉之前,先看看你的 Agent 实际怎么做。上面的成本假设定义会预先加载。一些客户端已经不再默认这样做。
Claude Code 的 MCP 文档指出,tool search 默认开启:“会话开始时只加载工具名称和 Server 指令”,完整定义会在 Claude 搜索工具时加载。你可以通过 ENABLE_TOOL_SEARCH 控制这一行为:
- 未设置或设为
true:MCP 工具延迟加载,按需获取 auto:当定义总量低于上下文窗口的 10% 时,工具预先加载auto:N:同上,但使用你设定的百分比false:所有 MCP 工具都预先加载
有两个例外值得注意。Opus 4 和 Sonnet 4 之前的模型无论配置如何都会预先加载 MCP 工具;设置为 alwaysLoad: true 的 Server 会跳过延迟加载。在 Claude Code 中运行 /context,可以看到哪些工具被标记为延迟加载。在 Claude API 本身,同样的思路对应 tool search tool:对不应预先加载的工具设置 defer_loading: true,Anthropic 称这通常能把定义 token 减少 85% 以上。
延迟加载解决的是定义成本,而不是输出成本:当 MCP 工具返回超过 10,000 个 token 时,Claude Code 会发出警告,并默认把输出上限设为 25,000(MAX_MCP_OUTPUT_TOKENS)。刚接触这个协议?可以先读什么是 MCP,以及它为什么对 API 很重要。
API 工作中何时用 MCP、何时用 CLI
对于 API 设计、测试和文档,可以按下面的方式划分:
- 用 CLI:任务本来就会在终端里执行,例如列出接口、导出 OpenAPI 文件、创建并运行测试用例、在 CI 中运行测试套件。Agent 只在需要时支付帮助文本的成本,你还可以通过
jq或--reporters过滤输出,让它保持简短。 - 用范围窄的 MCP Server:Agent 每一轮都需要结构化读取时,例如在编写客户端代码时读取 OpenAPI 规范。三个工具、291 个 token,是合理的价格。
- 避免在所有项目中全局启用五个或更多 Server。正是这种配置产生了那次 28,400 token 的“运行测试”。
无论选择哪条路线,Sylwia 的警告仍然成立:会写入数据的工具需要服务端权限校验、针对高风险操作的人工审批步骤,以及重复检测,避免重跑时创建同一条记录两次。
让编码 Agent 驱动 Apifox CLI
下面是 API 工作的 CLI 路线,由你的编码 Agent 来敲命令。安装 CLI、登录一次并添加 Agent skill:
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apifox.com   # pick your agent when prompted
你也可以告诉 Agent:“读取 https://www.apifox.com/apifox-cli-installation-guide.md 并配置 Apifox CLI”,它会按照这份对 Agent 友好的安装指南执行。
然后给它一个提示词:
In Apifox project 123, list the endpoints, export the spec as OpenAPI 3.1 to
./openapi.json, then create a test case for GET /users/{id} that asserts a 200
status and an id field, run it against environment 456 and summarize failures.
Read --help for each command before using it. Print only the lines you need.
Agent 会在执行过程中读取帮助,校验 JSON,然后运行用例:
apifox endpoint list --project 123 --page 1 --page-size 500
apifox export --project 123 --format openapi --oas-version 3.1 --output ./openapi.json
apifox cli-schema get test-case-create
apifox cli-schema validate test-case-create --file case.json
apifox test-case create --project 123 --file case.json
apifox run --test-case <caseId> --project 123 -e 456 -r cli,json
每条命令都会返回结构化 JSON,通常带有 agentHints.nextSteps,因此 Agent 知道下一步该运行什么,而不必为每一种可能的操作加载 schema。同样的 apifox run ... -r junit 命令可以直接放进 CI,具体做法见接口测试接进 CI/CD 后我们踩过的 5 个坑。
在开始之前想查看所有命令组,可以阅读 Apifox CLI 页面。
现在就能降低 MCP token 成本的五种方法
- 在 Claude Code(或你的客户端中的同等功能)里运行
/context,记下工具定义的总量。 - 把不需要的 Server 从全局配置移到项目配置。
- 开启延迟加载(Claude Code 中是
ENABLE_TOOL_SEARCH)。 - 对于终端形态的工作,用 CLI 加一段简短的 skill 替代宽泛的 Server。
- 对于自己构建的 Server,保持工具数量少、描述简短。
常见问题
如果 Agent 从不调用 MCP 工具,它们还会占用 token 吗? 在预先加载定义的客户端中,会。每个工具的名称、描述和 input schema 都会进入每次请求。像开启 tool search 的 Claude Code 这类支持延迟加载的客户端,只发送工具名称,直到真正需要某个工具。
一个 MCP Server 会占用多少 token? 取决于工具数量和 schema 深度。在我的测量中,@playwright/mcp 的 25 个工具用了 4,634 个 token,Apifox MCP Server 的 3 个工具用了 291 个,均使用 o200k_base 分词器统计。
对 AI Agent 来说,CLI 一定比 MCP 便宜吗? 前期成本几乎总是更低,因为 Agent 复用了已有的 shell 工具。但按单次调用看,如果 Agent 打印了很大的负载,CLI 同样会淹没上下文,所以无论哪种方式都要过滤输出。
提示词缓存能解决 MCP 的上下文膨胀吗? 它能降低重复定义的费用,但不会释放上下文窗口,模型在每一轮仍然要关注这些 token。
应该停止使用 MCP Server 吗? 不应该。对于每轮都需要结构化读取的场景,以及需要在多个客户端之间共享同一能力的情况,应使用范围窄的 Server。至于导出、运行测试这类终端形态的 API 工作,交给 CLI。