一句话概括:llama.cpp 在服务端加了 /v1/systemone 接口,让模型不做"生成",只对给定的选项打分并给出概率。官方已放出 6 个可用的决策模型,最小 144M,单题延迟 3 毫秒起。对 Agent 里那些"该走哪条路"的判定,这条路比反复调 prompt 更省也更稳。
如果你在用本地模型跑 Agent,多半遇到过这类尴尬:一个只判断"是或否"的步骤,也要让模型把整段话生成一遍,再写正则去解析它到底说了 yes 还是 no。生成是延迟的大头,解析是稳定性的隐患,而模型真正要回答的其实只是一个分类问题。ggml-org 在 2026 年 10 月 2 日发布的官方博客里,把这件事单独拎了出来:llama.cpp 的服务端新增 Decision Models 支持,模型可以通过打分回答,而不是生成文本。
发生了什么:把"生成"换成"打分"
按官方博客的说法,Decision Model 是"对你给出的选项打分、而不是生成文本"的模型。差别在推理方式上:聊天模型每生成一个 token 都要走一次前向,输出之后还得再解析;决策模型把输入读一遍,直接从你给的候选里返回一个答案,并附上概率。
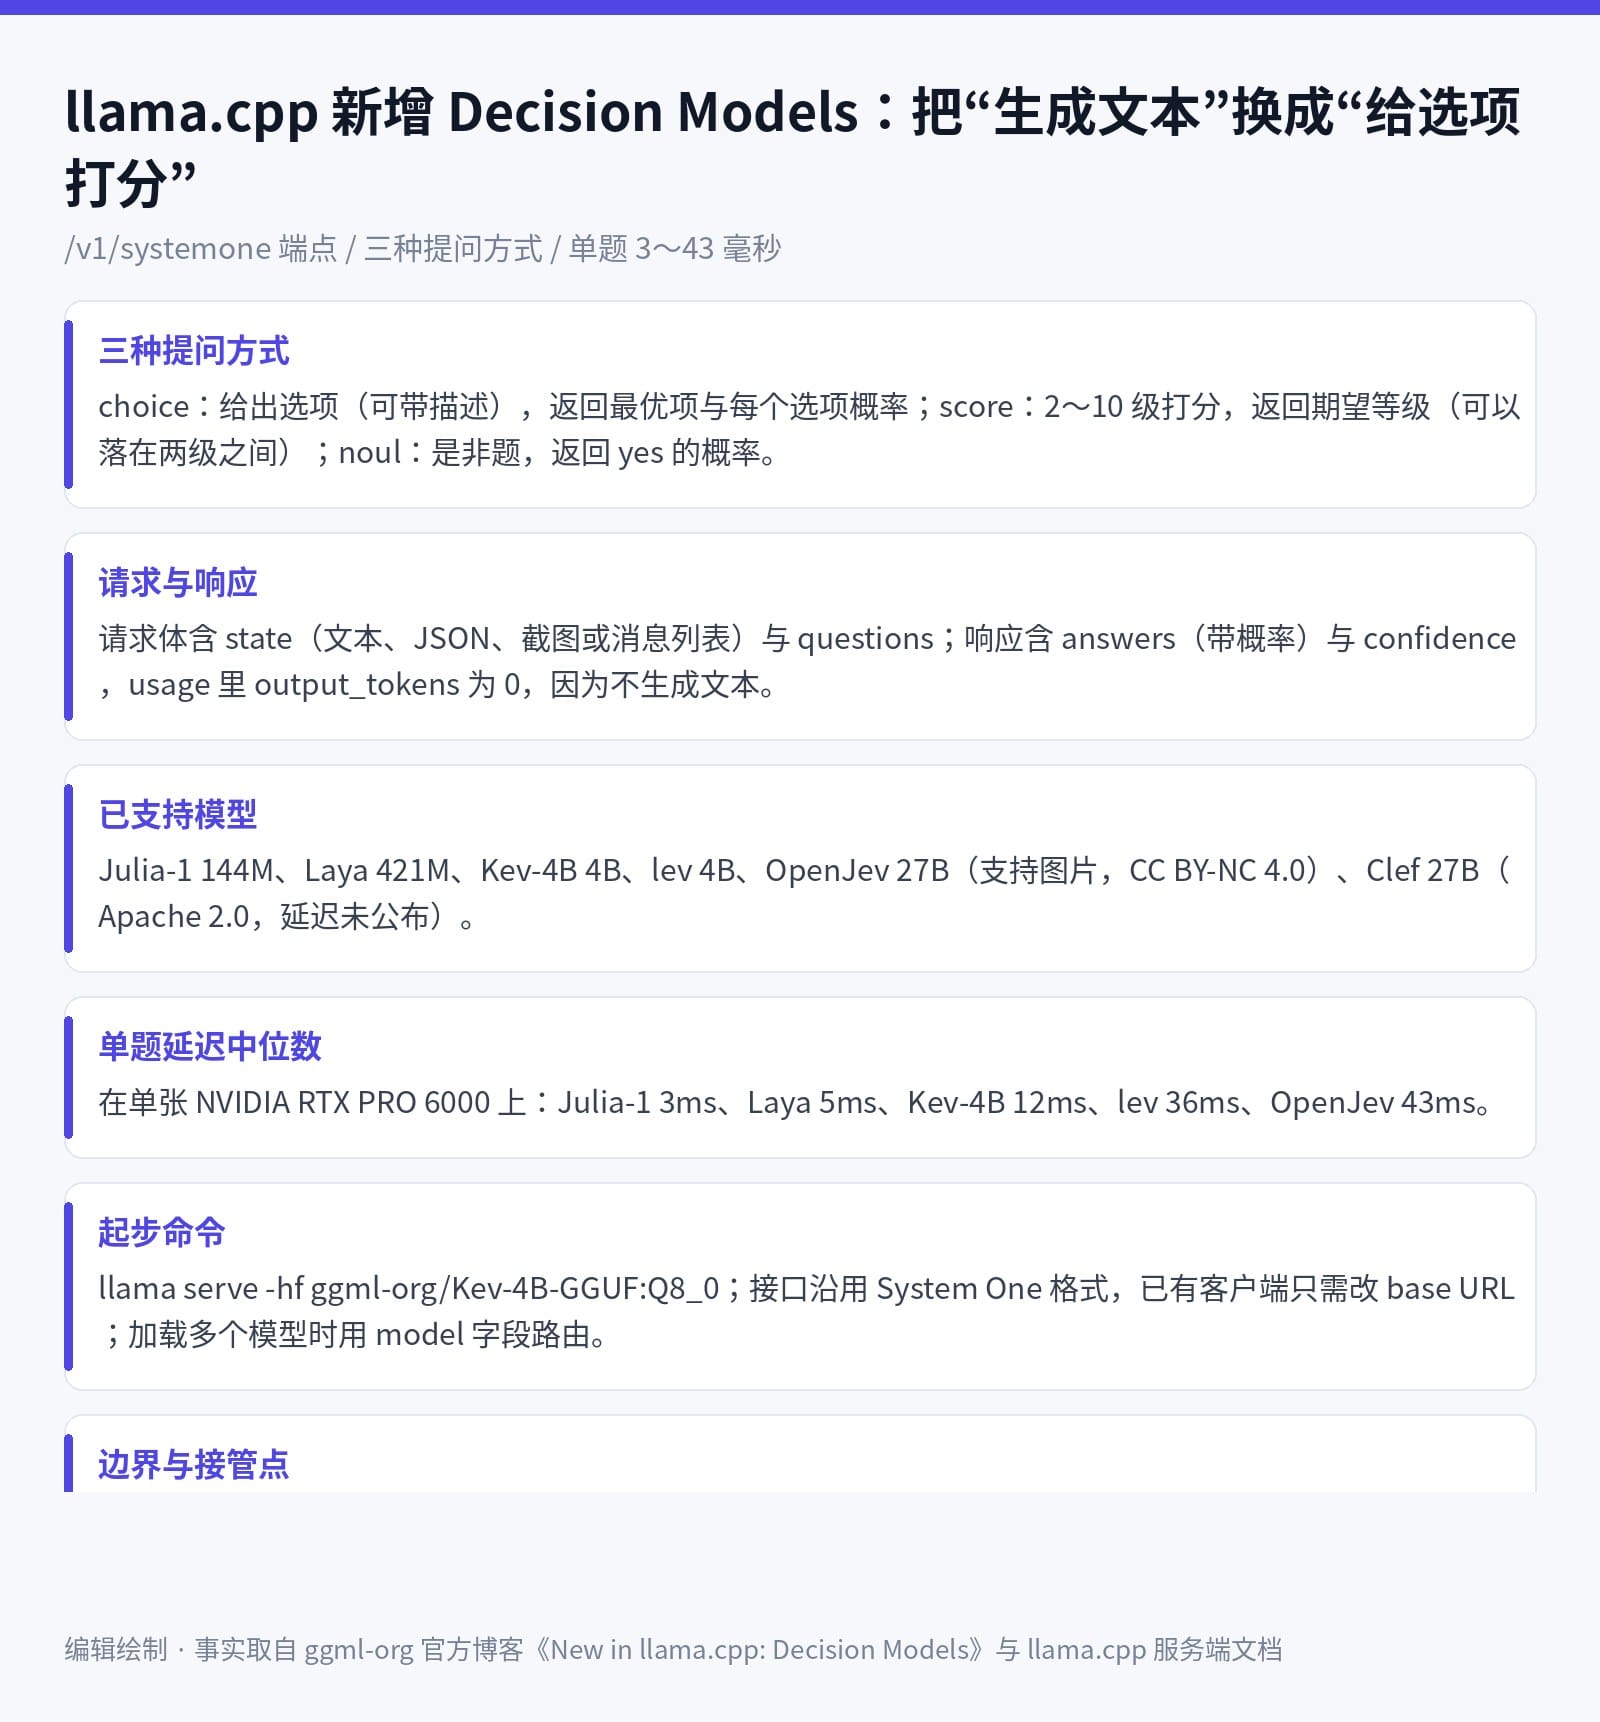
接口落在 /v1/systemone,格式沿用 TypeSafe 的 Jev 模型所用的 System One 规范,所以已有的客户端只需要改一个 base URL。实现来自 PR #29818,配套文档写在 llama.cpp 服务端的 README 里。请求体包含一个 state——可以是文本、JSON、截图,或者一组聊天消息——再加一组 questions;响应里是带概率的 answers、一个 confidence 值,以及 usage(官方示例里 input_tokens 为 130、output_tokens 为 0,因为它确实不生成文本)。
提问方式有三种。choice 是选择题:你把选项发过去,每个选项可以带描述,拿回来的是最优项加每个选项的概率。score 是 2 到 10 级的打分,最低级在前,返回一个期望等级,官方明确说这个值可以落在两级之间。noul 则是是非题,返回 yes 的概率。这三种基本覆盖了 Agent 里最常见的判定:选一条分支、给一个质量分、过一个二元闸门。
一个完整场景:把工单分流从"生成再解析"改成一次打分
假设你在做客服工单分流。原先的做法是给模型一段系统提示词,让它输出"billing"或"shipping",再写代码解析这个字符串,解析失败就重试。换成 Decision Model 之后,流程变成:把工单正文放进 state,把"账单 / 物流 / 其他"作为 choice 的选项发出去,直接拿到每个类别的概率和一个置信值。
起服务只要一条命令:llama serve -hf ggml-org/Kev-4B-GGUF:Q8_0,冒号后面是量化档位;要同时挂多个模型,就在请求里带 model 字段(例如 ggml-org/Julia-1-GGUF:Q8_0),/v1/models 会列出可用 id,只加载了一个模型时这个字段会被忽略。落地时值得注意的一点是:Kev-4B、lev、OpenJev 在一次请求里把 state 只处理一遍,多个问题各自独立作答——也就是说一个长工单配十个判定问题,状态编码只付一次代价。
官方博客给了一个很能说明问题的例子:一句含糊的工单"Hi, quick question about my account",用 Julia-1 打分只有 0.25,换成 Kev-4B 就有 0.80。同一个输入,不同模型给出的置信度根本不在一个量级上。另一个例子是选项描述的写法:只给裸标签时,Julia-1 把"我被重复扣款了"分到了物流标签;给每个选项补上一句描述之后,它把这条正确归到了账单,概率 0.99。这两个例子加起来说明:阈值和选项文本都不是可以照抄的参数。
为什么这会改变 Agent 的工作流
第一是延迟。官方给出的单题中位数(单张 NVIDIA RTX PRO 6000)是:Julia-1 3 毫秒、Laya 5 毫秒、Kev-4B 12 毫秒、lev 36 毫秒、OpenJev 43 毫秒。最小的一档是 144M 的 Julia-1,覆盖 50 多种语言。这类延迟意味着判定可以放进请求的关键路径里,而不是藏在异步任务里等。
第二是可控性。生成式输出天然是开放集合,你得防御它对格式的各种变体;打分是封闭集合,输出空间就是你自己定义的选项,概率还能直接拿来做降级策略——高置信度自动执行,低置信度转人工。
第三是它把"判定"从提示词工程里拆了出来。过去要判断"这个 Agent 的这一步做对了没有",常见的做法是再找一个模型来读一遍并写评语;现在这一步可以变成一个 noul 提问,返回一个概率数字,直接进你的监控面板。
还有一个容易被忽略的部署细节:因为这些模型同样由 llama.cpp 服务端托管,判定模型和生成模型可以挂在同一个服务上,用请求里的 model 字段分流。也就是说你不必为"打分"再单独维护一套推理栈,Agent 的分支判断和最终生成可以共用一层基础设施,运维面没有变大。
限制与人应该在哪儿接管
边界很具体。图片输入目前只有部分模型支持(写稿时是 OpenJev),视觉投影器会自动下载;OpenJev 走的是 CC BY-NC 4.0,不能商用,而 Julia-1、Laya、Kev-4B、lev、Clef 是 Apache 2.0。语言上,Laya、Kev-4B、lev、Clef 目前只有英文,Julia-1 覆盖 50 多种语言,OpenJev 覆盖英、德、法、印地、中、日。Clef 的延迟官方没有公布。
真正要人接管的地方是阈值。官方给的用法建议很直白:对置信度高的答案直接执行,剩下的路由给人工,而切割点因模型而异,必须拿你自己的样本测出来。这句话的潜台词是——Decision Model 不会替你做决策,它只是把"猜"变成一个可以调参的概率值,阈值定在哪里,是你的业务判断。低置信度那条路也必须有出口,否则概率再好看也只是把错误藏得更深。
如何试用
最快的方式是本地跑一条命令加载一个 GGUF 模型,然后按 System One 的格式对着 /v1/systemone 发请求;三种提问方式(choice、score、noul)可以在同一个服务上分别试。模型放在 Hugging Face 的 Decision models 合集里,官方说新的开源决策模型差不多每周都有,社区还做了一个叫 Decision Index 的对比工具,选型时可以先看那里。
信息来源
- ggml-org 官方博客《New in llama.cpp: Decision Models》(2026-10-02):huggingface.co/blog/ggml-org/decision-models-in-llamacpp
- llama.cpp 服务端接口文档(README,含
/v1/systemone完整参数与返回字段):github.com/ggml-org/llama.cpp/tools/server/README.md - 实现 PR #29818:github.com/ggml-org/llama.cpp/pull/29818
HiFox:将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 HiFox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,
欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
