Muse Wonder API 是 Meta 的 Model API,它提供 muse-wonder-1.0,托管于 https://api.meta.ai/v1,支持三种请求格式:Responses API、Chat Completions,以及一个兼容 Anthropic 的 Messages 接口。你使用来自 dev.meta.ai 的 bearer key 进行鉴权,每百万 input token 收费 $4,每百万 output token 收费 $20,并获得 1M token 的上下文窗口,推理强度可从 minimal 到 max。只要改一下 base URL,任何 OpenAI SDK 都能直接使用。
本指南带你从拿到 key 一路走到可运行的 Agent 循环:第一次请求、选择接口、控制推理、多轮状态、工具、流式、后台运行,以及那些能告诉你一次调用花了多少钱的 usage 字段。每个请求也都已在 Apifox 中配置好,这样团队无需互相传递 key 就能测试该模型。至于模型是什么、表现如何,请先看 Muse Wonder 详解。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Muse Wonder API 一览
| 值 | |
|---|---|
| 前置 URL | https://api.meta.ai/v1 |
| 模型 ID | muse-wonder-1.0 |
| Auth | Authorization: Bearer $MODEL_API_KEY |
| 接口 | POST /v1/responses, POST /v1/chat/completions, POST /v1/messages |
| 每 1M token 价格 | $4 input,$20 output,$0.20 缓存 input |
| 上下文窗口 | 1,048,576 token,无长上下文附加费 |
| 推理强度 | minimal, low, medium, high, xhigh, max |
| 速率限制 | 每分钟、每团队、每模型 3,000 次请求和 4M token |
| Web 搜索工具 | 在 token 费用之外,每 1,000 次查询 $2.50 |
更大的模型 Muse Wonder Full 不在 API 中提供,仅在 Muse Code 的 Power 和 Maximum 套餐内可用。把 Wonder 的 effort 设为 max 并不会把它变成 Full。
第 1 步:获取 key 并发出第一次调用
在 Model API 仪表盘的 API keys 下创建一个 key,并将其保存为 MODEL_API_KEY。然后:
curl https://api.meta.ai/v1/responses \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "muse-wonder-1.0",
    "input": "List three risks in a lease clause that lets the landlord enter without notice.",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 2048
  }'
使用 OpenAI SDK 时,只需改两行:
from openai import OpenAI
import os

client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])

resp = client.responses.create(
    model="muse-wonder-1.0",
    input="List three risks in a lease clause that lets the landlord enter without notice.",
    reasoning={"effort": "medium"},
    max_output_tokens=2048,
)
print(resp.output_text)
print(resp.usage)
响应除了文本之外还带有一个 usage 块。每次调用都要检查它:output_tokens_details.reasoning_tokens 告诉你输出预算中有多少用在了思考上,input_tokens_details.cached_tokens 告诉你有多少 input 是按缓存价计费的。
第 2 步:选择接口
Meta 的快速入门使用 Responses API,对于任何多步骤场景,这都是合适的默认选择。它能跨轮次保留推理,并为你管理对话历史。Chat Completions 则是为你已有的、基于 OpenAI SDK 的代码而存在。位于 https://api.meta.ai/v1/messages 的 Messages 接口接受 Anthropic 格式的请求,Claude Code 正是以此在 Muse Wonder 上运行。
| 需求 | 使用 |
|---|---|
| 新建 Agent、工具循环、长会话 | Responses |
| 已有的 OpenAI 风格代码、单轮对话 | Chat Completions |
| Claude Code 或其他 Anthropic 格式的 harness | Messages |
| 推理摘要 | 仅 Responses |
这三种格式的 parameter 名称各不相同。推理强度在 Responses 上是 reasoning.effort,在 Chat Completions 上则是顶层的 reasoning_effort。输出上限分别是 max_output_tokens 和 max_tokens。Responses 上的结构化输出使用 text.format,而不是 response_format。
第 3 步:设置推理强度
Muse Wonder 总是会进行推理。none 会返回 HTTP 400。可接受的等级为 minimal、low、medium、high、xhigh 和 max;如果省略该 parameter,模型会自行选择等级。Meta 的建议也很常规:使用能给出可接受结果的最低等级,因为推理 token 按 $20 的 output 价格计费,并计入你的输出上限。
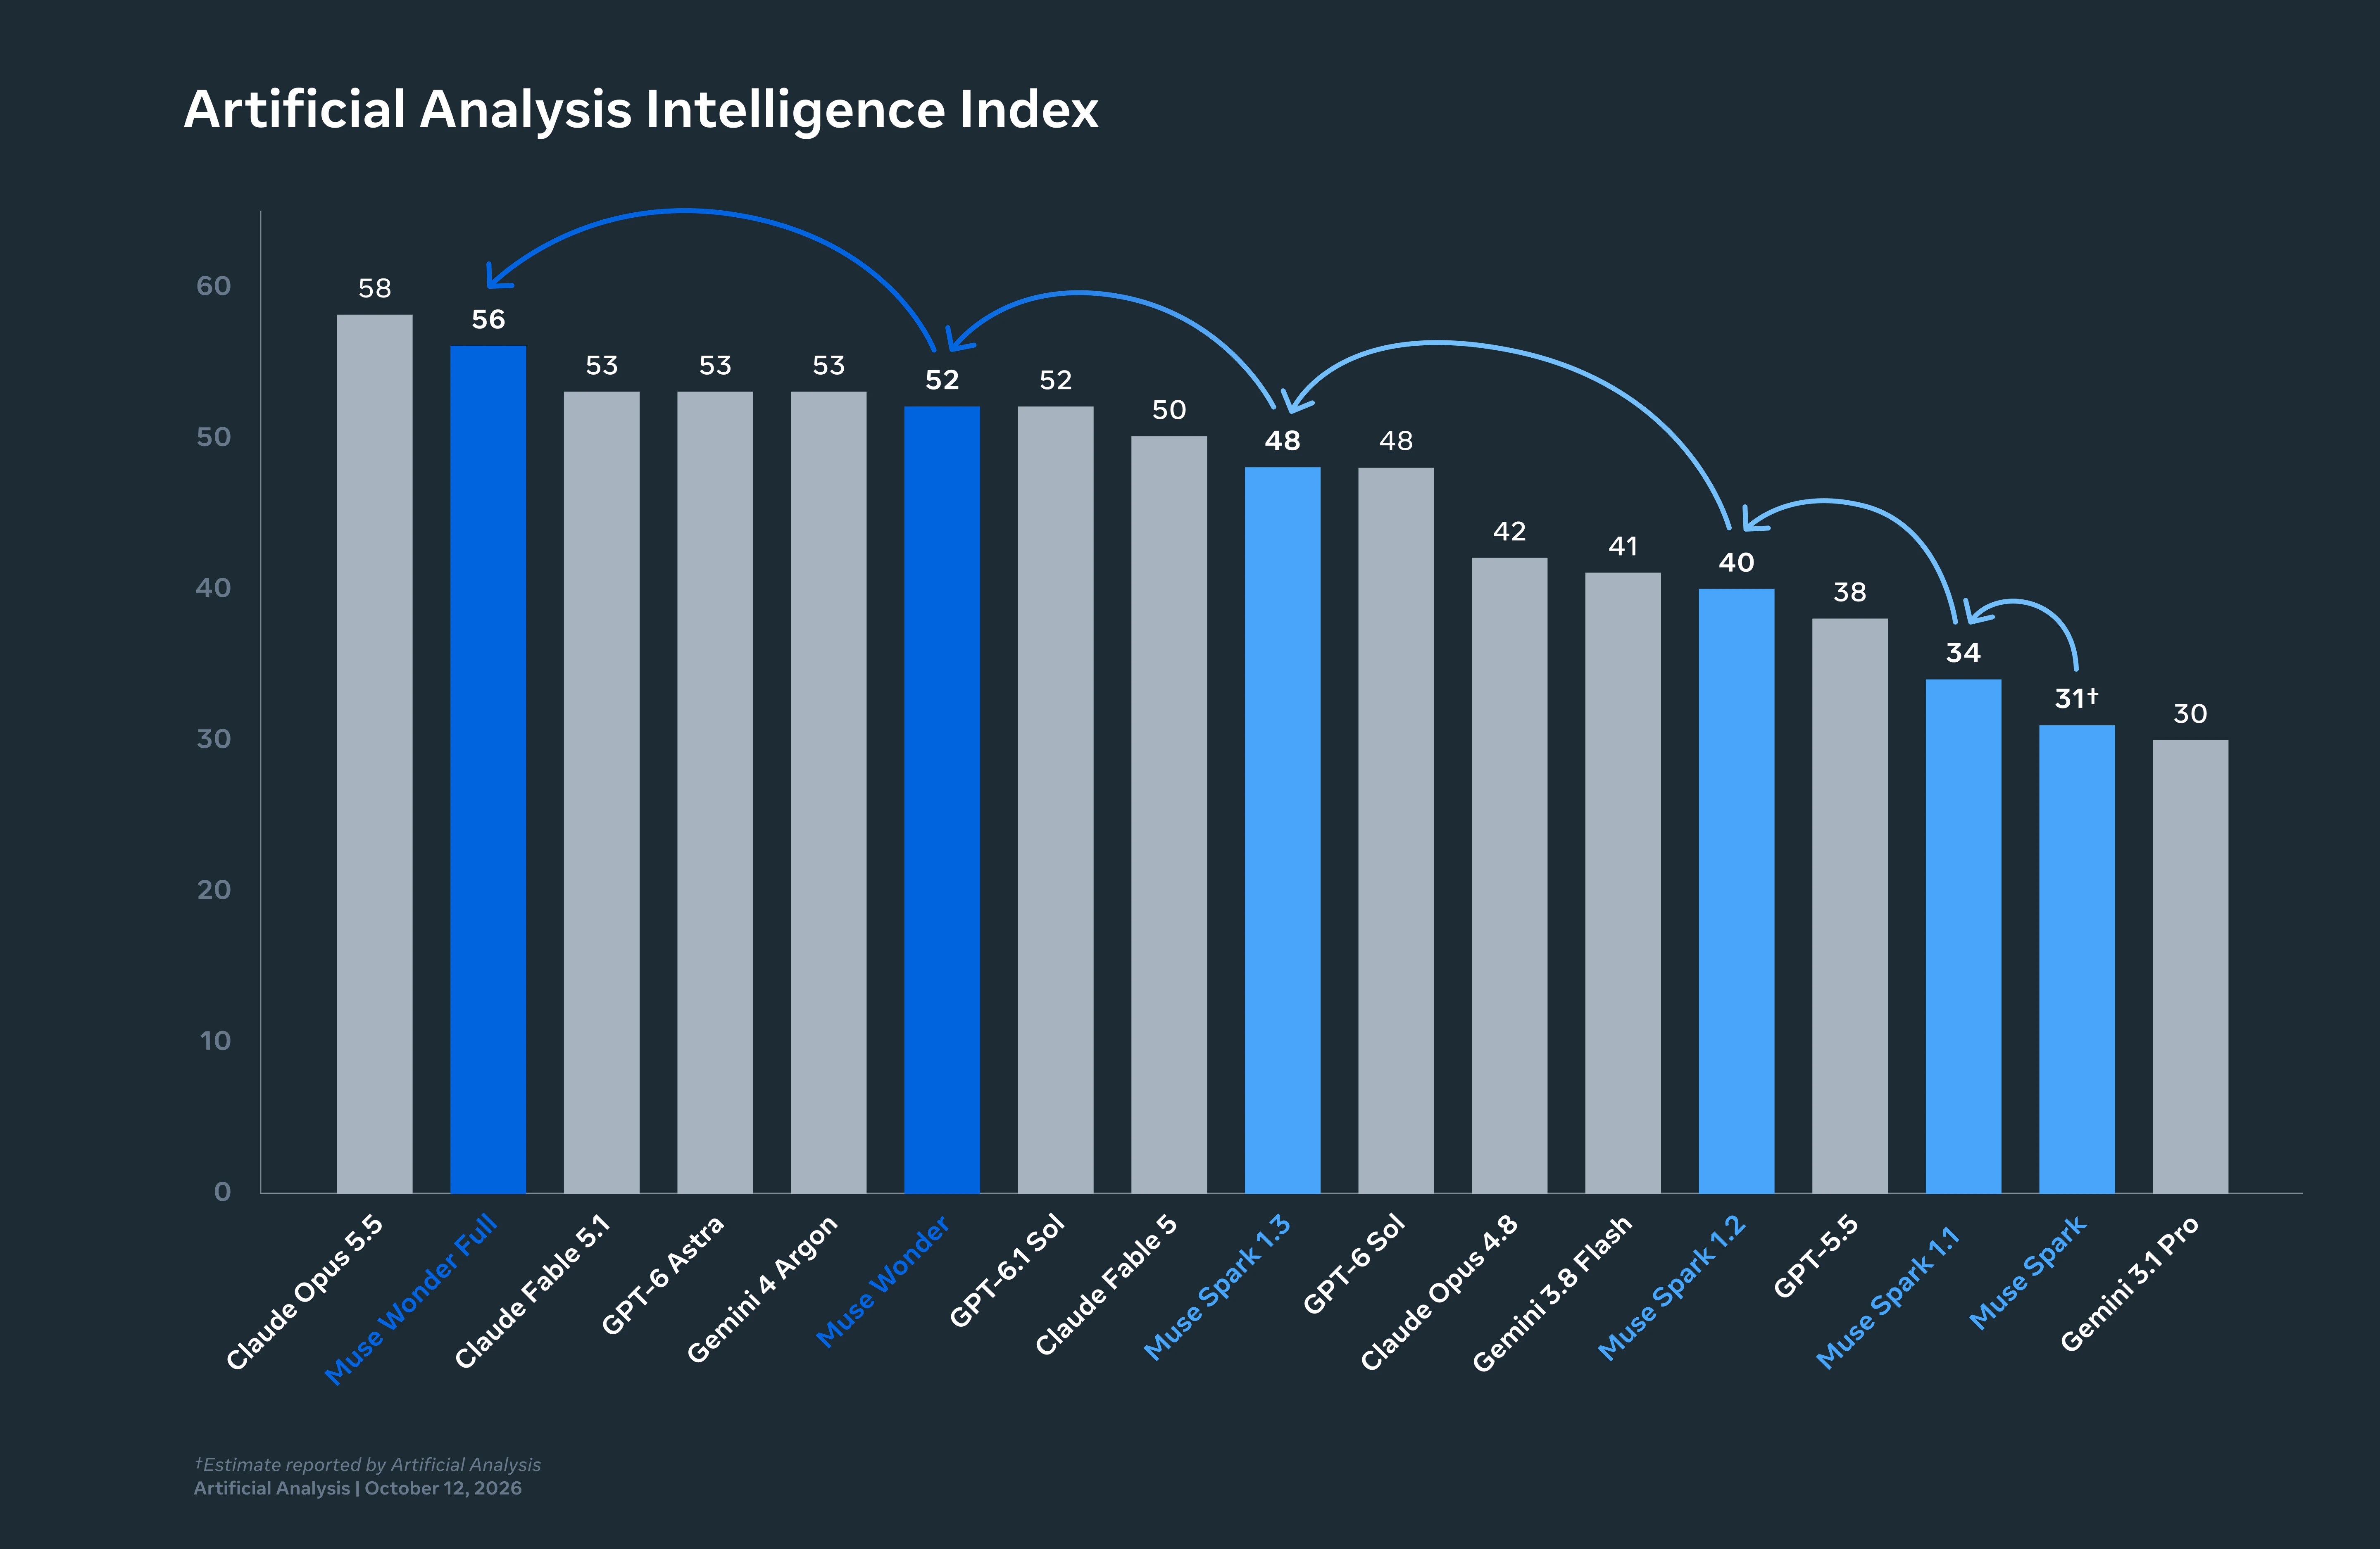
由此可以得出两条实用规则。第一,在高强度下把 max_output_tokens 设置得宽松一些;在 max 时,推理占输出的很大一部分,上限太紧会截断答案。第二,按请求类型记录 reasoning_tokens,这样你看到的就是每个强度等级在你自己的流量上(而非某个基准测试上)的花费。给该模型打出 52 分的 Artificial Analysis 测试使用了 max 强度,每个任务约 54,000 个 output token。
在 Responses API 上,把 reasoning.summary 设为 auto、concise 或 detailed,即可请求推理摘要。摘要是无法保证的,数组可能返回为空。原始推理内容永远不会返回。
第 4 步:跨轮次携带状态
Responses API 提供两种模式,且二者不能同时使用。
无状态加密重放 是 Meta 推荐的做法。发送 store: false 和 include: ["reasoning.encrypted_content"],保留响应返回的 reasoning 项,并在下一轮中把它们连同各自的 encrypted_content 以及一个 summary 字段(空数组即可)一起传回。模型的推理得以跨轮次保留,而 Meta 不会存储任何内容。
服务端管理历史 更简单:传入 previous_response_id,只发送新的 input。注意 instructions 不会保留,因此每次请求都要重新发送你的 system 指令。
first = client.responses.create(model="muse-wonder-1.0", input="Summarize this API's auth flow: ...", instructions="You are an API reviewer.")
second = client.responses.create(model="muse-wonder-1.0", previous_response_id=first.id, instructions="You are an API reviewer.", input="Now list the endpoints that need an OAuth scope.")
第 5 步:工具、结构化输出和 Web 搜索
函数工具在 Responses 和 Chat Completions 上遵循 OpenAI 的形式。Muse Wonder 会并行调用工具,并经过训练能从失败的工具调用中恢复,这正是 Meta 发布文章中所谓 Active Focus 的含义之一。用 JSON schema 定义工具,执行模型返回的 function_call 项,再把 function_call_output 项发送回去。
若要得到代码可解析的答案,在 Responses 上把 text.format 设置为一个 JSON schema。若要获取最新信息,通过 tools=[{"type": "web_search"}] 添加 Meta 托管的搜索;它在 token 之外按每 1,000 次查询 $2.50 计费。如果你已经在为其他模型测试工具调用,Apifox 中的 Agent 工具调用 harness 在这里无需改动即可使用:请求形式与 OpenAI 相同。
第 6 步:流式输出,或后台运行
设置 stream: true 并消费事件流:response.created、response.output_item.added、response.output_text.delta、response.function_call_arguments.delta 和 response.completed。失败以 response.failed 结束。请求推理摘要时,它们会以 response.reasoning_summary_text.delta 的形式到达。
对于长时间任务,发送 background: true。API 会以 "status": "queued" 确认,你可以从 GET /v1/responses/{id}?stream=true 轮询或流式获取生命周期事件。后台运行不能与 POST 上的 stream: true 同时使用,请求 body 上限为 1 MiB,且每分钟每团队另有 600 次新后台提交的上限。使用 POST /v1/responses/{id}/cancel 取消。
第 7 步:缓存重复的内容
缓存 input 为每百万 $0.20,比 $4 的价格便宜 95%,Meta 会在 usage.input_tokens_details.cached_tokens 中报告它。能获得缓存收益的模式与其他供应商相同:把稳定内容(system 指令、工具定义、参考文档)放在前面,把每次请求独有的内容放在最后。prompt 缓存指南涵盖了前缀设计。也要注意缓存写入这一侧:在 Artificial Analysis 的测试中,Wonder 每个任务 $4.52 的成本里有 $1.92 是缓存写入,高于 $1.44 的缓存命中。
在 Apifox 中测试 Muse Wonder API
一个共享的 Apifox 项目能让 key 不出现在聊天记录里,并让每个人都拿到相同的请求。
- 创建一个环境,命名为 Meta Model API,将
base_url设为https://api.meta.ai/v1,并把MODEL_API_KEY设为秘密变量。秘密值在界面中会被遮蔽,且永远不会被导出。 - 添加三个请求,每个接口一个,各自带上
Authorization: Bearer {{MODEL_API_KEY}}。复制 Responses 请求,分别设为low、medium和max强度,以便并排比较成本。 - 对 usage 做断言。 在
$.usage.output_tokens_details.reasoning_tokens和$.usage.input_tokens_details.cached_tokens上添加 JSONPath 断言。一个你预期会命中缓存的请求,如果缓存 token 值为零,那就是前缀有问题,能在进入生产环境之前被捕获。 - mock 掉 429。 Meta 的文档建议从约 500 ms 起做带抖动的指数退避,并遵循
Retry-After。把你的客户端指向一个返回 429 且带上该 header 的 Apifox mock,在与团队其他成员共享每分钟 3,000 次请求的上限之前,先验证重试逻辑。 - 在 CI 中运行,使用 Apifox CLI,这样模型或定价的变化会让流水线失败,而不是让客户受影响。
下载 Apifox 并从上方的请求示例中导入这三个接口。
常见问题
Muse Wonder API 有免费额度吗? 没有。计费按 token 计算且没有最低消费,所以少量测试调用只花几分钱,但没有免费额度。免费访问指南介绍了最省钱的途径。
我的 API 数据会被用于训练吗? 在 API 的 Standard 模式下不会。Muse Code 订阅默认使用 Contributor 模式,该模式会使用你的数据;这个设置位于 Muse Code,而非 API。
我可以通过 API 使用 Muse Wonder Full 吗? 不能。它没有可供调用的模型 ID,也没有按 token 计价的价格。只有 Muse Code Power 和 Maximum 的订阅用户可以选用它。
速率限制是多少,能提高吗? 每分钟每模型 3,000 次请求和 400 万 token,按团队中所有 key 合并计算。Meta 的定价页面没有列出任何档位,也没有提升额度的流程。速率限制那篇文章介绍了如何保持在限制之内。
下一步
针对你产品中的一个真实任务,用 low、medium 和 max 三种强度发出上面那三次调用,并在选定默认值之前比较 reasoning_tokens。真正决定你账单的是这个数字,而不是那个 $4 的标题数字。
HiFox :将 Agent 变成真正的队友
另外,我们也在思考,AI 如何从个人提效走进团队协作。
HiFox 是一个让人和 AI Agent 在同一个工作现场协作的平台:你可以像给同事分派任务一样指派 Agent,在任务看板中跟踪进度、查看结果,让 Agent 成为团队里的队友。
👉 立即体验 Hifox:https://hifox.com
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。