大多数人第一次接触新模型,都是打开一个聊天框开始打字。Jev 惩罚的正是这种反射。它是 TypeSafe AI 的 System One 模型,完全不产出文字:你交给它程序状态和一组带类型的问题,它返回的是附带概率的决策。这个角色转换就是全部技巧所在。你的语言模型继续负责写作;Jev 决定接下来发生什么,而你的代码决定如何处置这个决策。
本指南讲的是调用周边的架构,不是调用本身。如果你需要先看入门,从Jev 是什么开始,再读 TypeSafe 自己的发布博文了解官方视角。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Jev 擅长什么
三个原语覆盖 Jev 的全部能力。noul返回“关于状态的单条陈述是否为真”的概率。choice从一个 criteria map 中选出一个选项(最多 255 个),返回所选结果、完整的概率分布和一个 confidence 值。score把状态放到一张 2 到 10 级的有序评分表上,返回等级、图例、概率和 confidence。公司与模型家族的背景,见我们写过的TypeSafe AI。
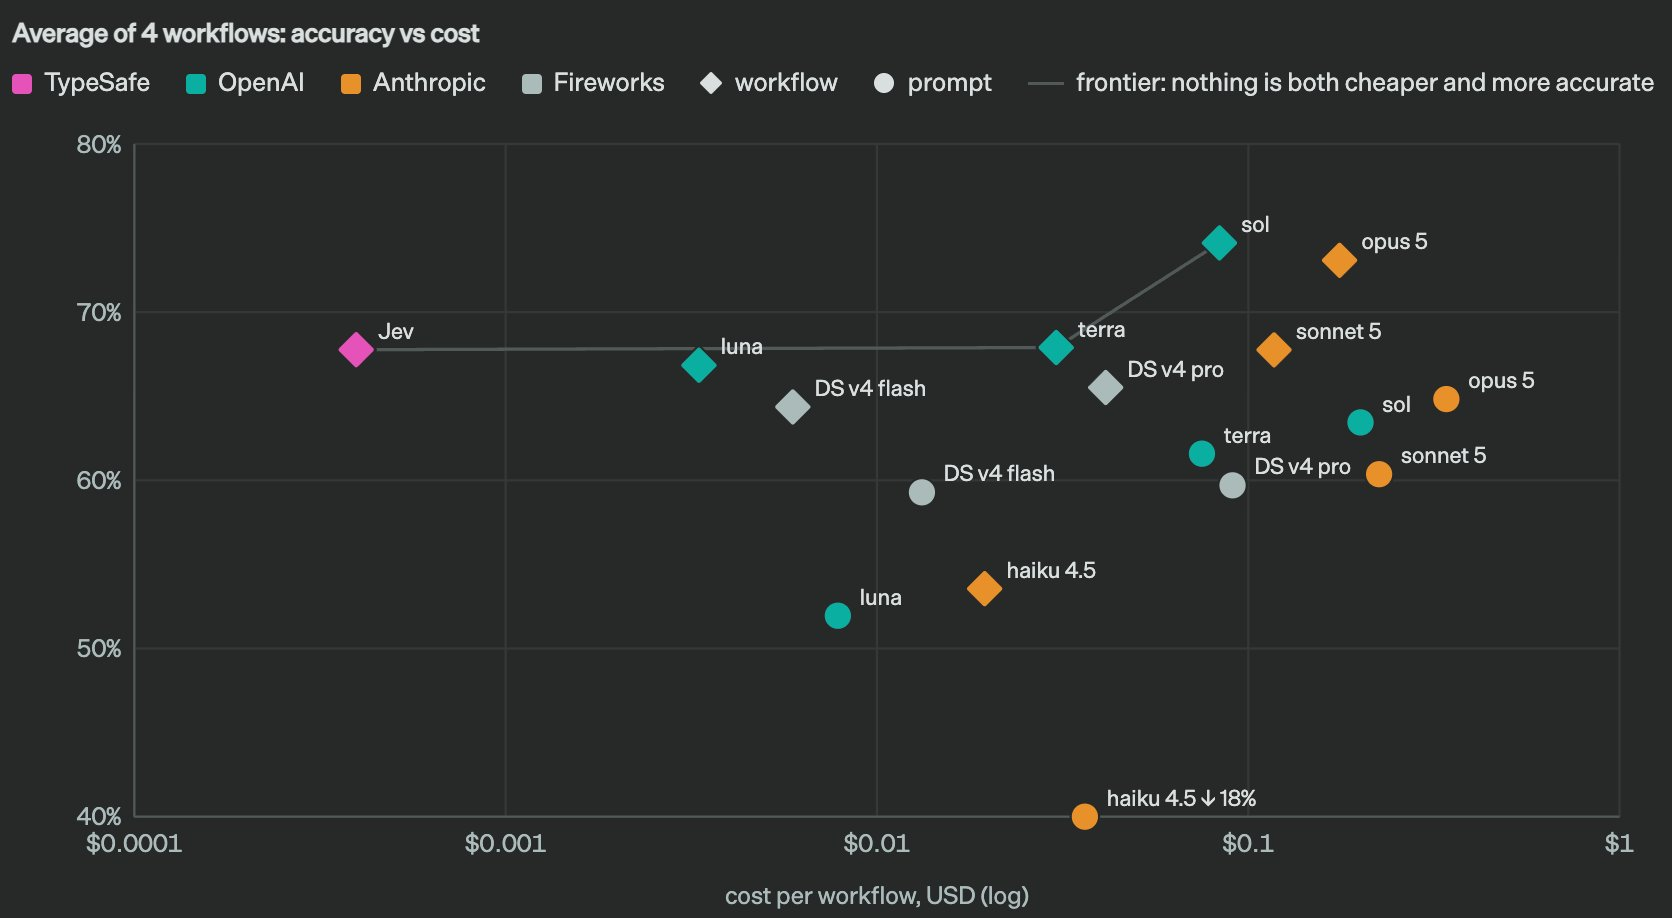
对架构来说有四个性质很关键。每个答案都以你的程序已经理解的类型到达。每个答案都自带不确定性,所以“不确定”会变成一个分支,而不是一场意外。针对同一状态的多个问题在一次请求里全部解决。而且每百万输入 token $0.042、输出 token 不收费的价格,让你在每个事件上都问一次也负担得起,而不是抽样。
把 Jev 当法官,而不是当写手
四个角色,职责清晰分开:
- LLM 负责生成。代码、邮件草稿、摘要、计划。
- Jev 负责决策。它给请求分类、给风险打分、选择路线,并按你提前写好的标准检查输出。
- 你的代码负责控制。阈值和规则决定执行、重试、升级还是停止。
- 人来兜住边界。低 confidence 加上高风险,交给人工。
这个分工之所以成立,原因如下。语言模型灵活,因为它什么都能输出;而正是这种自由让它很难嵌进你依赖的工作流。TypeSafe 的说法是,Jev “放弃了字符串生成”,换来一份狭窄的契约:可能的答案集合在请求离开你的服务器之前就已固定,每个结果都符合声明的形状,不确定性则是一个可以和阈值比较的数字。
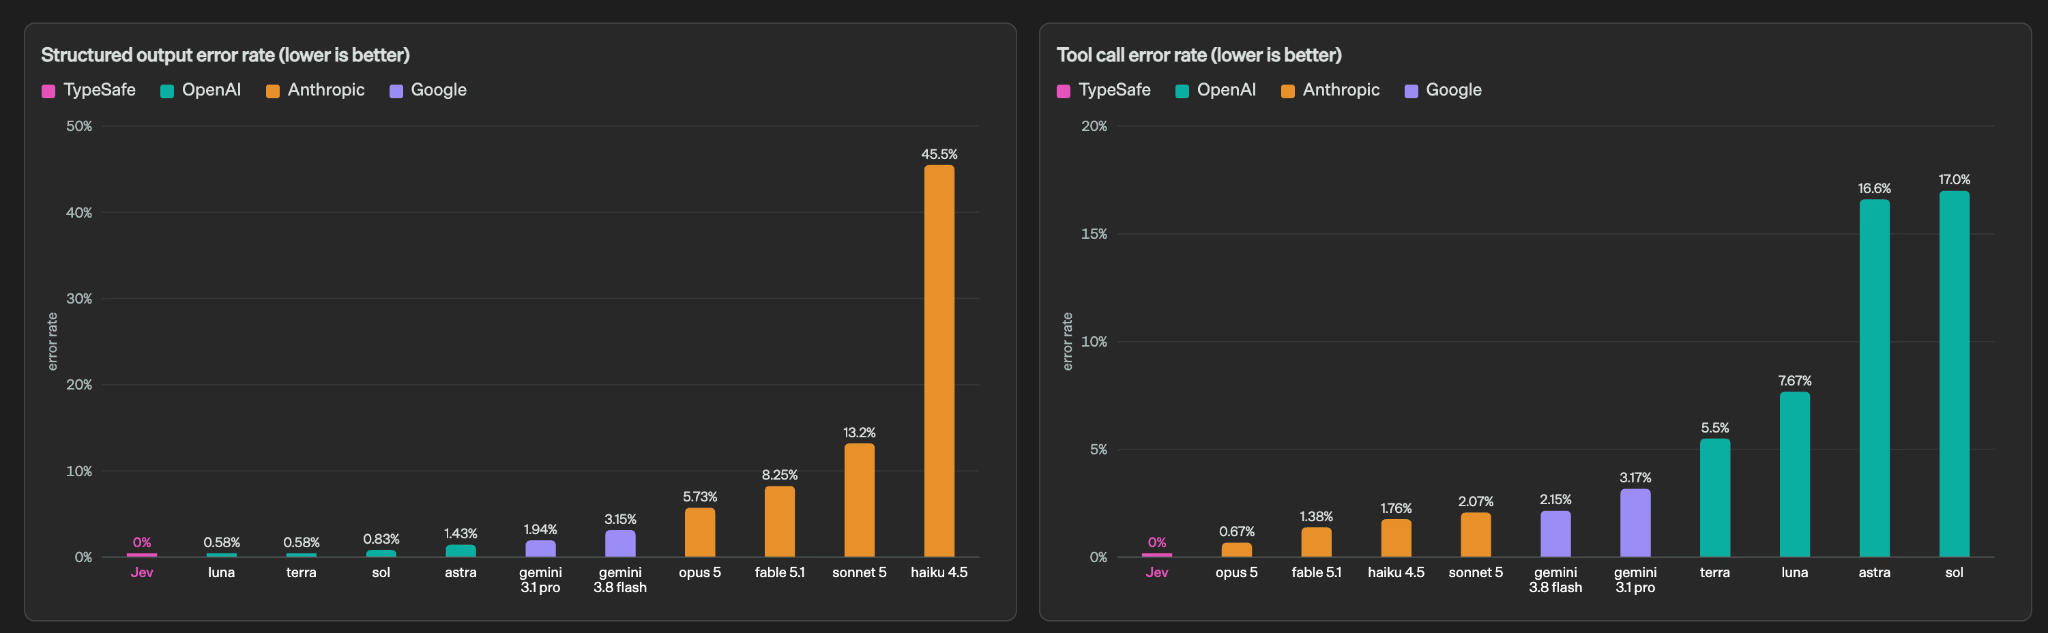
成本方面的账也来自同一笔交换。TypeSafe 报告端到端响应时间为 70ms 到 500ms,并声称在其测试过的工作流上快 193.6 倍、便宜 444.6 倍。把这些当作厂商数字,而不是独立基准。但结构上的结论无论如何都成立:昂贵的模型只在真正需要写东西的时候运行,围绕它的重复判断交给便宜的那一层。
设计 Jev 真正能回答的问题
每个请求携带一个共享的state和一组相互独立的问题。Jev 把状态读一遍,把所有问题都答掉。一个客服分流调用长这样:
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
三个习惯决定了问题是可以稳定工作,还是会摇晃。
别再写提示词了。人设、示例和冗长的开场白是在引导一个文本生成器。Jev 不生成文本。它需要状态、一个原子问题,以及每个答案含义的精确描述。描述性标准胜过光秃秃的标签:“支付、扣款、发票、订阅变更”比单独一个 “billing” 分流得更准。也别让它解释自己,因为响应里只有决策、概率和 confidence,没有别的东西。
一个问题,一个判断。“这个线索有价值吗、紧急吗、大概率会买吗?”是穿着风衣的三个问题。拆开它们,在代码里合并结果——那里看得见权重,也改得动权重。
把算术挡在模型外面。Jev 判断含义。你的程序做数学、套折扣表、核对合同条款。正是这种分工让整件事可审计。
TypeSafe 还发布了一个开箱即用的 skill,教编程 agent 这些约定,在 Claude Code 里用claude plugin marketplace add typesafe-ai/skills安装,在其他工具里用npx skills add typesafe-ai/skills。agent skill 页面有详细说明。
保持状态干净
相关的状态胜过最大的状态。三段内容通常就够:被判断的对象、理解该对象所需的上下文,以及一旦变化就会改变决策的事实。其余都是你要花钱发送的噪音。
去掉重复的日志行、早于当前问题的历史,以及任何一句替你说出你希望模型得出的结论的话。硬上限是每请求 64k token,其中 32k 留给状态加最长的问题,但远没到上限之前准确率就可能开始下滑。当路由变得含糊,缩小状态通常比重写标准更快见效。
并行问题与 confidence 门槛
因为 Jev 只把状态读一遍,第十三个问题的成本远低于再来一轮请求。把每个可能改变动作的独立判断都发过去:意图、风险、紧急度、情绪、相关性、下一步动作。然后砍掉那些答案永远不会改变代码行为的——用不上的信号就是没有回报的维护成本。
让原语匹配判断的形状。严重程度、质量、契合度这类梯度属于score,不要硬掰成是/否。单条事实陈述属于noul。固定的目的地集合属于choice。
门槛才是架构真正落地的地方。带类型的答案仍然可能是错的答案,所以 confidence 决定下一步。一个可用的起步模式:0.85 以上自动执行,0.55 到 0.85 交给更强的模型或再做一轮,0.55 以下排队等人工。这些具体数字只是示意。TypeSafe 的confidence routing模式会根据出错的代价为每个动作设独立阈值,它的confidence 页面告诉你要“用自己的数据测试,并根据观察到的结果调整”。阈值调好之后,把模型钉住:jev-latest跟随最新的稳定发布,而jev-1.13.0则冻结你实测过的行为。
在 Apifox 里测试决策层
决策层只有在你证明得了它的行为时才值得信任。这意味着保存下来的请求和断言,而不是终端里一次性 curl 的历史。Apifox两者都能给你,而且这里的断言和普通 API 测试不同:你在检查数字和枚举值,而不是字符串。
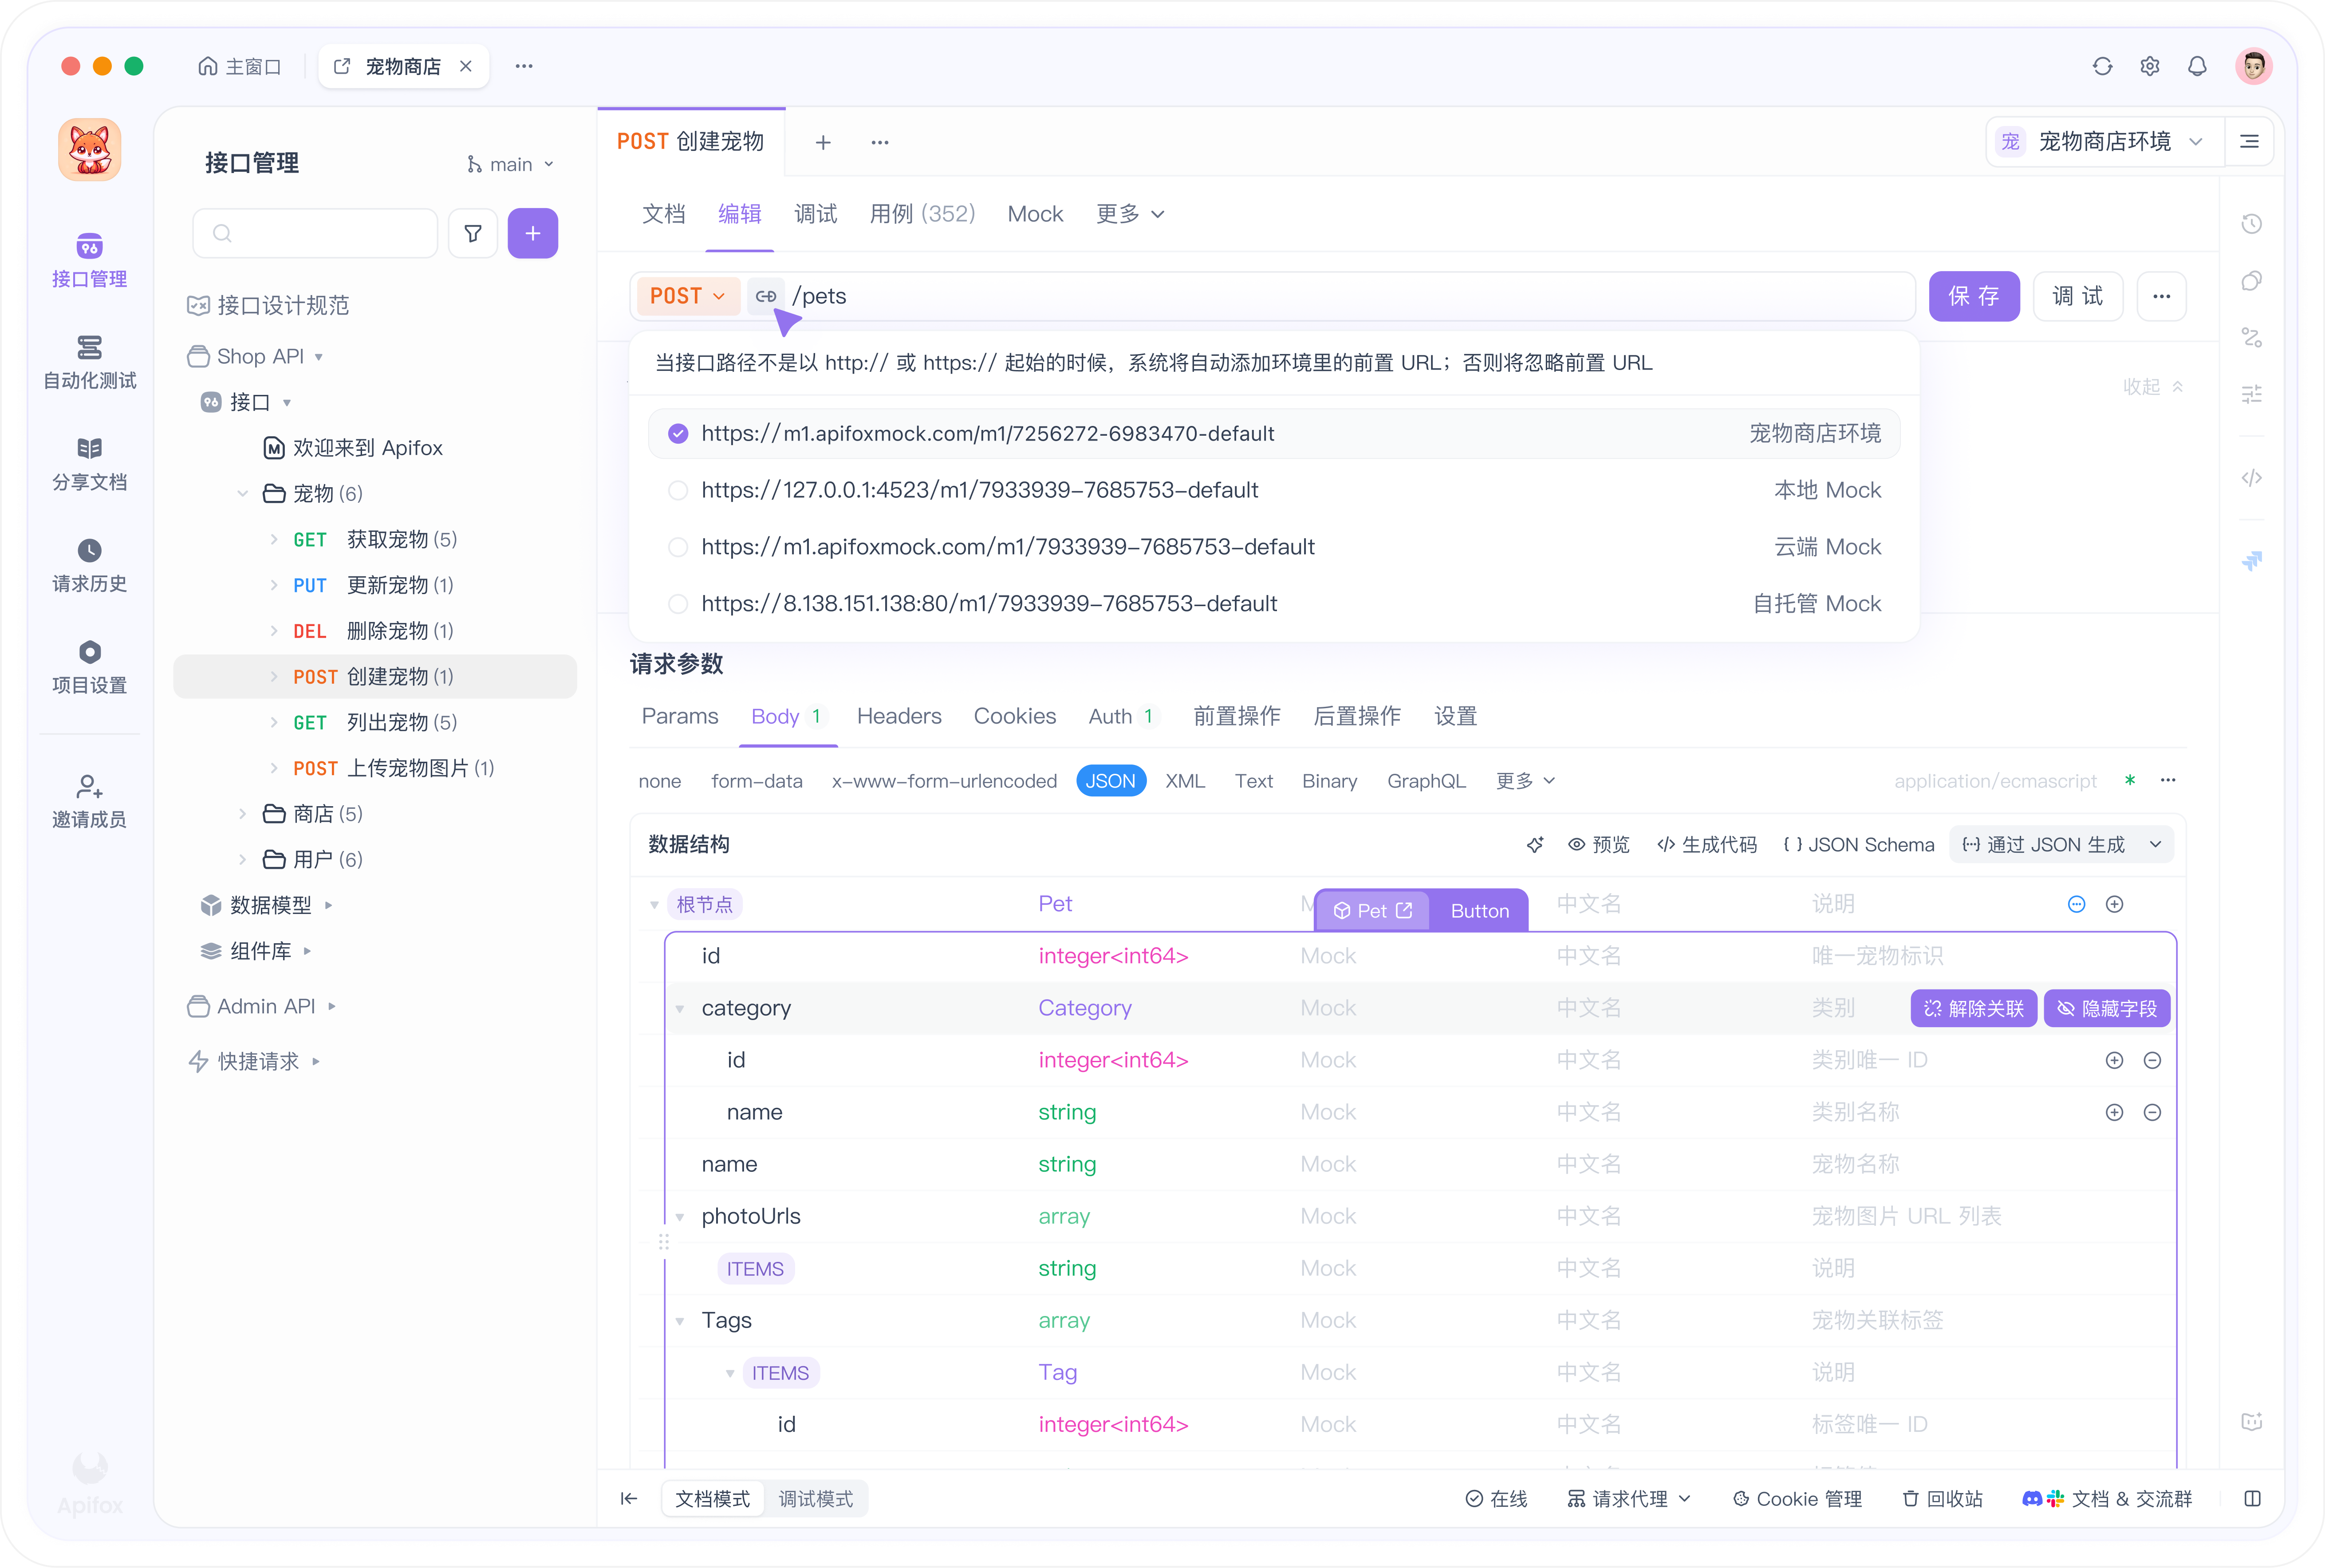
把 key 存成环境变量。新建一个名为TypeSafe的环境,把TYPESAFE_API_KEY添加为 local 值,让它只留在你的机器上,并在 Bearer token 里以{{TYPESAFE_API_KEY}}引用。我们的环境与私密变量指南讲了作用域规则。
发送真实请求。 POST https://api.typesafe.ai/v1/systemone,请求体用上面的状态加问题。
对决策加断言。添加后置操作断言,比如answers.department.choice等于billing、answers.urgent.noul大于0.9,以及answers.frustration.score大于1.5。从此行为变更会让测试失败,而不是悄悄分错工单。
然后把真正重要的场景固化下来。把一小组带标签的状态保存为测试场景:一个平静的提问、一个愤怒的取消威胁,以及一条优秀的路由应该犹豫的故意含糊消息。对前两条断言高 confidence,对第三条断言 confidence下降到门槛以下。这一个场景把阈值调优变成证据而不是猜测,还能抓住手工最难点检出的失败:有人改写了某条标准的描述,每个响应依然校验通过,路由却悄悄偏移。把它放进 CI,这种改写就会让构建失败。
mock 响应形状,让前端开发不烧 token。因为answers对象在请求发出之前就已声明,mock 与线上响应不可能漂移。
决策层物有所值的五个工作流
- 通用校验器。包住每一次昂贵的 LLM 调用。检查输入提示词有没有注入、选中的工具是否明显不匹配、输出是否漏了要求、最终答案有没有源材料撑不住的断言。在昂贵的大脑周围放便宜的检查。
- 客服控制塔。一次调用里完成工单分类,检测紧急度、挫败感、退款意图和取消风险,然后路由。收益是进错队列的工单更少,被晾着的高价值账户更少。
- 线索分级。把公司契合度、技术成熟度、陈述的痛点、购买意图和紧急度作为独立信号打分,再用你自己拥有、能在流水线评审里说得清的权重合并。
- 模型路由器。对每个请求决定由确定性代码、小模型、前沿模型还是人来处理。成本上的节省通常最先在这里显形。
- 大数据集作业。在客服日志、评论、商品列表、转写文本或 agent 轨迹上跑同样的语义判断,提取结构化特征,把值得人工看的记录排到前面。只有当每次决策都快到几乎免费时,这类分析才变得可行。
FAQ
我还是需要一个语言模型吗?需要。Jev 写不了回复、摘要或代码。它决定由哪个系统来写,还能在写完后按明确标准给草稿打分,比如是否符合政策,或者答案里有没有你不会做出的承诺。
这和 JSON mode 或结构化输出有什么不同?结构化输出约束的是文本模型的格式;模型仍在生成 token,仍可能用合法的形状断言错误的内容。Jev 返回的是你定义好的一组答案上的概率分布,不确定性是一等公民字段。我们在OpenAI 结构化输出的解读文章里覆盖了这个对比的另一面。
我要怎么拿到访问权限?Jev 处于带候补名单的 early access 阶段,还不能自助开通。TypeSafe 分批把开发者带出名单,到手后在console.typesafe.ai登录。它也可以通过 Vercel AI Gateway 使用:模型 id 为typesafe-ai/jev,通过experimental_evaluate在 AI SDK 7 中调用;这条路仅限SDK-only,OpenAI 兼容端点上没有暴露。我们的获取 Jev API key攻略里有请求和 SDK 细节。
我能在本地跑类似的东西吗?有几个项目在开放权重上用受限解码复刻了部分思路。我们在OpenJev 与开源 Jev 替代品里做过对比,包括各自对校准 confidence 的还原程度。
这对你意味着什么
Jev 不是要取代你其他模型的那一个。它是决定那些模型何时、何地、是否运行的那一层。按这个思路去建:一份干净的状态、带明确标准的原子问题、并行评估,以及挡在每个动作前面的 confidence 门槛。然后用Apifox里保存的场景证明门槛有效,再让它去分流第一张真实工单。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
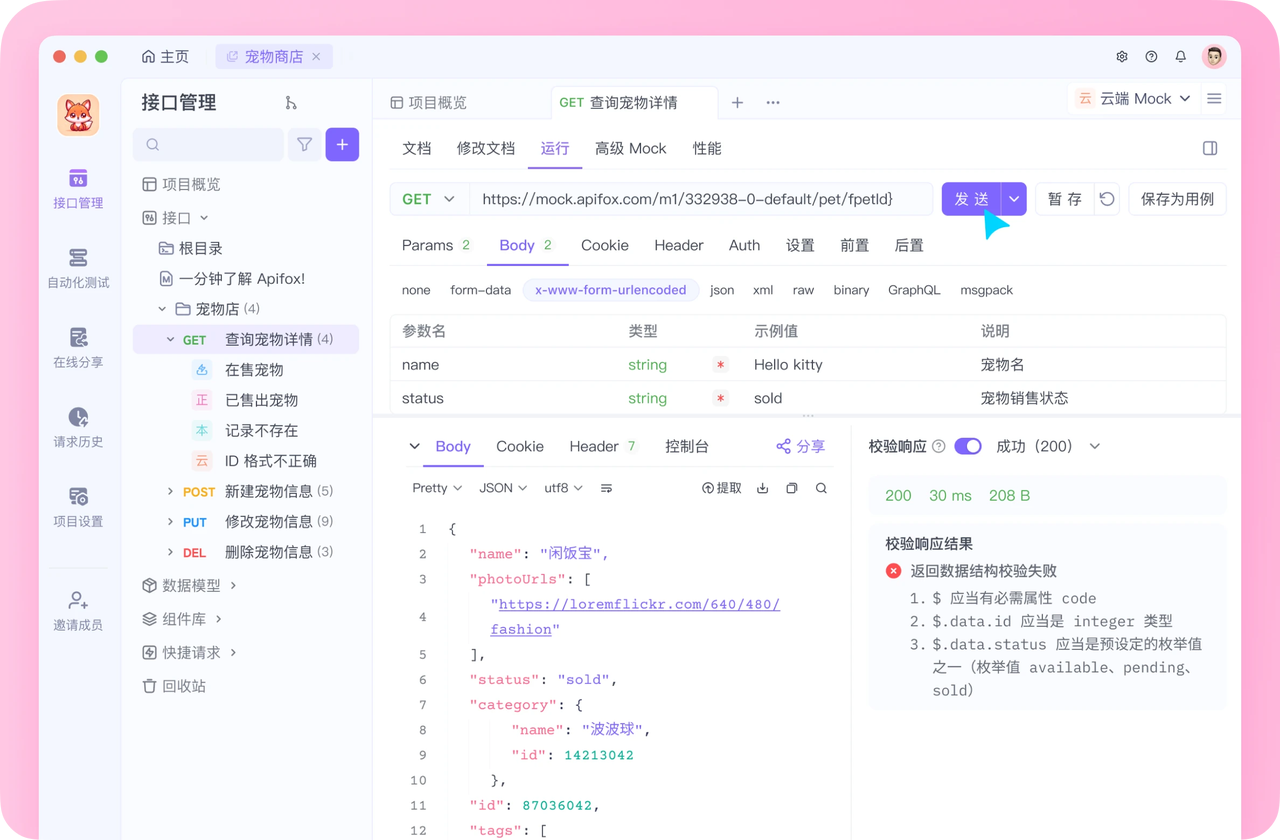
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会