DeepSeek-V4.1-Flash 于 2026 年 9 月 10 日在 API 上 GA,同时带来两个事实,让“免费”变成真问题,而不是营销钩子。权重以 MIT 许可放在 Hugging Face 上,模型本身不收费。官方 API 非高峰 cache-hit 输入按 $0.003 / 1M tokens 计费,已经接近零,对大多数副业项目来说,免费和几乎免费之间的界线不再重要。
DeepSeek API 仍然没有永久免费档。谁告诉你有,描述的要么是路由器促销,要么是消费级聊天应用。本指南按诚实程度给每条不花钱用 V4.1-Flash 的路排个序,再把付费路径的账算清楚,让你判断“几乎免费”够不够。如果想先看架构,去读 DeepSeek-V4.1-Flash 是什么,再回来。
先说一句。好几条免费路径会经过第三方接口,既限流,有时还会悄悄换模型。用 Apifox 录响应、对 model 字段做断言,能把免费额度留给真正的调用,而不是自己的调试。工作流在文末。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
TL;DR
从“没有任何附加条件的免费”排到“几乎免费但要绑卡”:
- DeepSeek 聊天应用,地址 chat.deepseek.com。免费,不绑卡。最适合亲手判断输出质量。
- 开源权重,在 Hugging Face 上。MIT 免费,但 552B 参数意味着成本在硬件。
- 第三方路由器,例如 OpenRouter。部分模型有时会有免费档,伴随限流和数据政策取舍。
- 编程工具里捆绑的试用额度。 只有工具本身已经把 DeepSeek 当后端时才有用。
- 官方 API。 不免费,但一个兴趣项目非高峰大约每月 $1.35。
选项 1:DeepSeek 聊天应用
消费级应用在 chat.deepseek.com,摩擦最低。用邮箱或手机号注册,不绑卡,直接开始提问。
两个注意点。第一,今天发布之后应用实际提供哪个模型,需要 [VERIFY]。发布说明覆盖的是 API,应用以往会落后于 API,或跑单独调过的构建。第二,应用是聊天界面,不是 API。你没法脚本化、批量 prompt,或接到产品里。
所以应用只回答一个问题:V4.1-Flash 在你的领域里,是否好到值得做集成?把用户会发的输入贴进去,图像也可以,因为模型是原生多模态。答案站得住,再走到下面的路径。
选项 2:开源权重
DeepSeek 以 MIT 许可发布了 V4.1-Flash 权重和技术报告。你可以下载、运行、微调,并基于它们出产品,不用向 DeepSeek 付费,也不用申请许可。
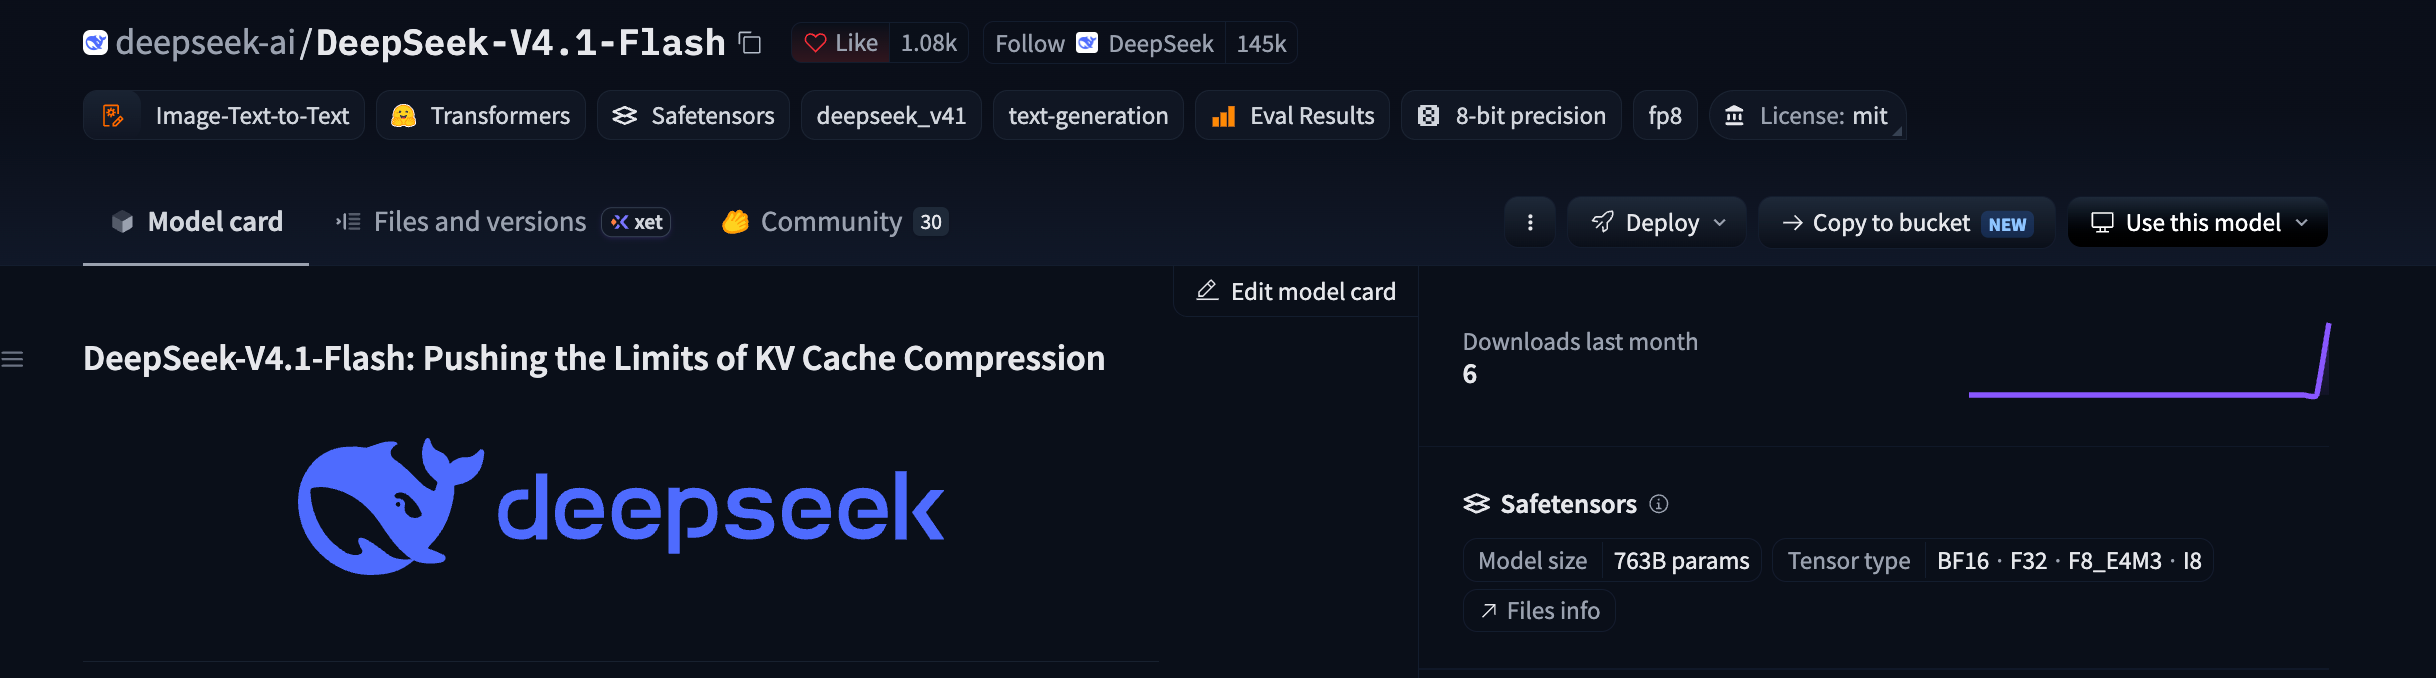
麻烦在体积。V4.1-Flash 是 552B 参数的 mixture-of-experts 骨干(加上视觉编码器是 763B)。prefill 时只有 8B 参数激活,decode 时 16B,但整套参数还是得住在某个地方。8-bit 大约只要骨干就 552 GB;4-bit 大约 280 GB。单张消费级 GPU 够不着。KV cache 是好消息:FP4 缓存下每 token 890 字节,满 1M-token 上下文大约只要 0.9 GB。
这里的“免费”是许可免费,不是运行免费。先读如何在本地运行 DeepSeek-V4.1-Flash,看硬件档位和该核对哪些推理引擎,再去下载 280 GB。如果你已经有硬件,这是本页最耐用的免费选项:无限流、无数据政策、不会悄悄换模型。
选项 3:官方 API 不免费,但已经很接近
DeepSeek 平台按量付费。你充值、创建 key,按 token 计费。没有永久免费档。
它能出现在“免费使用”这页上,靠的是价格。下面是 官方定价页的完整美元表,自 2026 年 9 月 10 日 04:00 UTC 生效,按每 1M tokens:
| Token type | deepseek-flash off-peak | deepseek-flash peak |
|---|---|---|
| Input, cache hit | $0.003 | $0.006 |
| Input, cache miss | $0.15 | $0.30 |
| Output | $0.60 | $1.20 |
高峰是周一到周五 01:00 到 04:00 以及 06:00 到 10:00 UTC(北京时间 09:00 到 12:00 以及 14:00 到 18:00)。其余时间含周末都是非高峰,半价。上下文缓存是自动的,重复的 system prompt 命中缓存不需要额外代码。
现在算账。假设一个副业项目一个月发出 5M tokens 的新(cache-miss)输入,生成 1M tokens 输出,全部在非高峰:
- 5M cache-miss 输入,按 $0.15 / 1M = $0.75
- 1M 输出,按 $0.60 / 1M = $0.60
- 合计:每月 $1.35
如果输入里有一部分是重复的 system prompt,还会更低。非高峰 1M cache-hit tokens 只要 $0.003,所以一条 2,000-token 的 system prompt 在 10,000 次请求里复用(20M 缓存 tokens)只多六美分。账单四舍五入就是零花钱,而且你拿到的就是你点名的那个模型,并发上限 2,500 个请求。V4.1-Flash 定价说明会讲 prompt 结构如何改写这笔账。
一个最小调用,把 usage 打出来,方便看缓存拆分:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You classify support tickets as billing, bug, or feature request."},
        {"role": "user", "content": "Customer says their August invoice shows two charges for one seat."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
选项 4 和 5:路由器、免费档和捆绑额度
OpenRouter 通常是给新开源权重模型找免费接口的地方。路由器把多家宿主聚到一个 OpenAI 兼容 API 后面,宿主有时会给某个模型开免费档来拉流量。今天 V4.1-Flash 有没有上架、有没有宿主给它开免费档,需要 [VERIFY];模型才发布几小时,列表变得很快。
每条路由器免费档都适用三条警告:
- 限流很紧。 按分钟和按天的上限,意味着测试循环可能一小时就把一天额度打光。
- 数据政策因宿主而异。 免费流量往往是宿主被允许记录或拿去训练的那部分。发任何私密内容前先读政策。
- 免费档每周都在变。 周一免费,周五可能收费,或转到另一家宿主。不要把生产依赖建在这上面。
要盯的失败模式是静默换模型:你请求 V4.1-Flash,免费宿主挂了,就用更老的模型来答。响应里的 model 字段是第一道防线,下面的工作流会对它做断言。
一些编程工具,包括 Cursor 和 Codex 风格的 Agent,会捆绑试用额度,花在工具支持的后端上。如果你已经在用的工具把 DeepSeek 列为可选模型,这些额度在试用期内是合法的免费路径。不要为了用 DeepSeek 专门去注册一个工具;额度数量和可用模型变得太勤,不值得写死。
哪种选项适合你
| Option | Cost | Model guaranteed? | Rate limits | Best for |
|---|---|---|---|---|
| DeepSeek chat app | Free | Depends on the app build | App usage caps | Hand evaluation, quick checks |
| Open weights (MIT) | Free license, your hardware | Yes, you run it | None | Privacy, fine-tuning, owned GPUs |
| Official API | About $1.35/month at hobby scale | Yes | 2,500 concurrent requests | Anything you ship |
| Router free tier | Free while it lasts | No, hosts swap | Per-minute and per-day caps | Prototypes, comparisons |
| Bundled tool credits | Free during the trial | Depends on the tool | Tool-defined | Coding inside that tool |
如果你打算上线,把那一美元花在官方 API 上。如果还在评估,从聊天应用开始。如果你有 GPU,权重胜过其他每一行。
在 Apifox 里测免费接口,不烧掉额度
免费路径有两种失败模式:调试自己代码时撞上限,以及路由器不吭声换了一个模型。两者用 Apifox 都很好防,它测的是你选定接口前面的 API 层。
- 接口只加一次。 创建
POST {{BASE_URL}}/chat/completions,Authorization header 用Bearer {{API_KEY}}。除聊天应用外,每条路径都是同一套 OpenAI 兼容形态,一个已保存请求就能覆盖全部。 - 每个提供方一个环境。
official环境把BASE_URL设为https://api.deepseek.com并配上你的 DeepSeek key;router环境指向免费宿主。切换是下拉。 - 先录真实响应,再 mock。 把几条有代表性的 prompt 打过免费接口,保存响应,再从 Apifox 的 mock 服务端提供它们。你在搭解析、重试和 UI 时,应用打 mock,免费额度不动。
- 对 model 字段做断言。 把请求存成测试用例,断言响应里的
model包含宿主给 V4.1-Flash 返回的字符串。每次开工先跑,换模型会在你花一小时追查 prompt“回归”之前就把测试打红。 - 对 usage 块做断言。 检查
usage.prompt_tokens和usage.completion_tokens大于零,并从同一块读取官方 API 的 cache-hit 计数。一周之后你就知道免费档帮你省了多少,以及 prompt 缓存是否如你所想。
FAQ
DeepSeek-V4.1-Flash 免费吗? 模型按 MIT 许可免费,DeepSeek 聊天应用里也可以免费用。官方 API 按量付费,没有永久免费档。Is DeepSeek free 追溯了这条分界在整条模型线上如何一直成立。
DeepSeek API 有免费试用吗? 没有常设试用。最低成本路径是官方 API 非高峰:5M cache-miss 输入 tokens 加 1M 输出 tokens 花费 $1.35。
通过 API 调用 V4.1-Flash 最便宜的方式是什么? 避开高峰,并把 prompt 结构成共享前缀能命中缓存,因为命中比未命中便宜 50 倍。What is prompt caching 解释了如何为这个目标排 prompt。
我能在笔记本上跑 V4.1-Flash 吗? 不能跑完整模型。552B 参数仅骨干在 4-bit 下大约 280 GB。上面链接的本地指南覆盖了各硬件档位上什么才现实。
免费路由器版本和官方 API 是同一个模型吗? 只有宿主这么说、并且你的测试确认时才是。对 model 字段做断言,并在固定 prompt 集上对比官方接口的输出。DeepSeek V4 for free 和 V4 API for free 的指南,对上一代做过同样的检查。
你现在可以怎么做
V4.1-Flash 在最重要的两种意义上免费:权重是 MIT,聊天应用不花钱。两极之间的一切,要么是会挪走的免费档,要么是已经便宜到不值得再为“免费”优化的官方 API。每月 $1.35,最便宜的路线通常是付钱。
无论你选哪个接口,都把 Apifox 放在前面:搭建时 mock 响应,对 model 字段做断言,记录 usage。免费额度是资源。把它花在模型上,而不是花在你自己的 bug 上。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
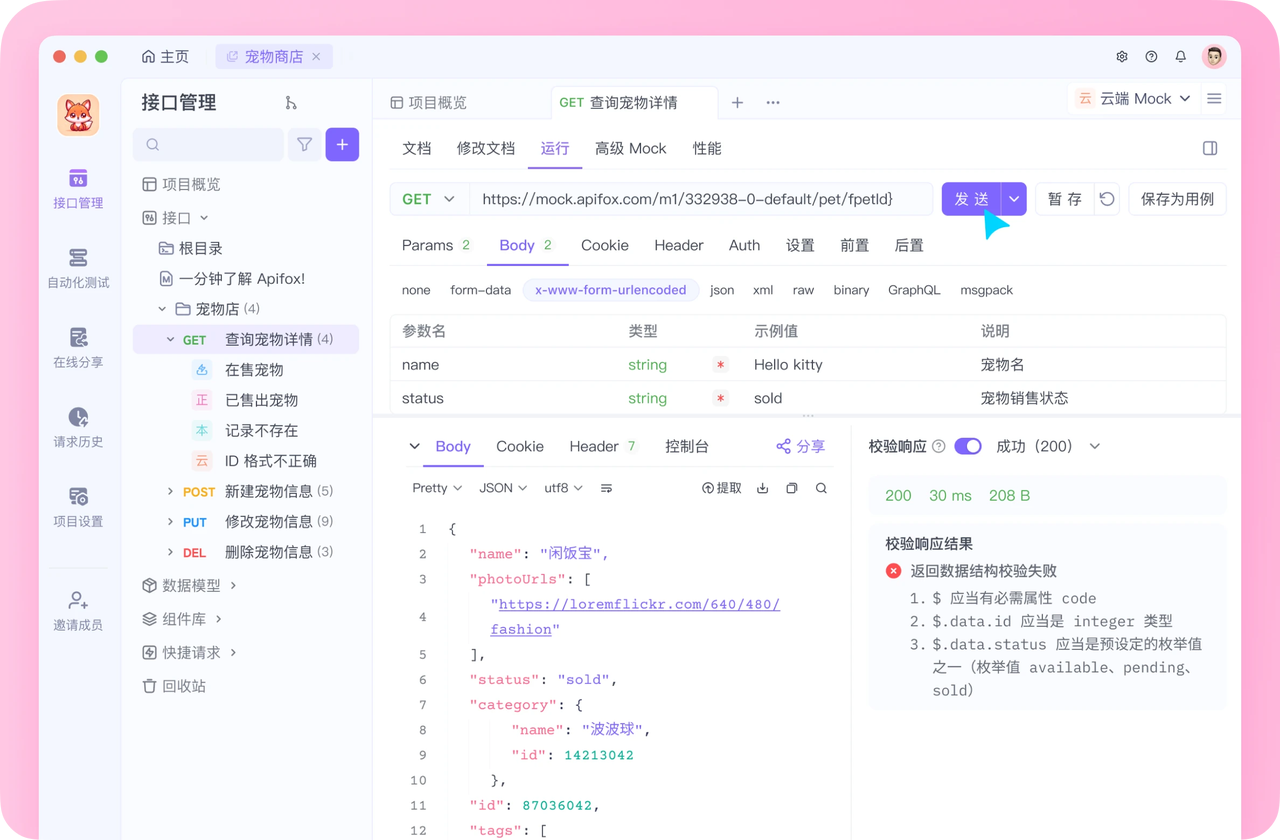
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会