DeepSeek-V4.1-Flash 今天正式在 API 上线,时间是 2026 年 9 月 10 日。发布说明很短,但对所有调用 DeepSeek API 的人来说,它改变了三件事:从现在起只有一个 model id 可用,即 deepseek-flash;每 token 单价再次下调;四天后的 9 月 14 日,所有发往 deepseek-v4-pro 的请求都会被重新路由到这个模型,并按 Flash 的价格计费。
最后一点才是本文存在的理由。如果你的生产代码跑在 V4-Pro 上,迁移日期由不得你选。如果你用的是 V4-Flash,其实早就在旧名字下被新模型服务了。无论哪种情况,你今天发送的 parameter 都值得检查一下。
本文讲实用部分:model id、base URL、三种语言下的第一次调用、reasoning effort、图片输入、流式响应和定价。关于架构与基准测试的故事,请先读 What is DeepSeek-V4.1-Flash。
在把任何东西接进代码之前,你需要一种快速发请求、快速对比响应的方式。Apifox 可以承担这件事:把它指向 https://api.deepseek.com,把 key 存成变量,把每一次可用的调用保存成可重复运行的测试。具体工作流在文章靠后的位置。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

TL;DR
- Model id:
deepseek-flash。旧名字deepseek-v4-flash和deepseek-v4-flash-vision-exp仍然可用,但会解析到 V4.1-Flash。 - Base URL 未变:
https://api.deepseek.com(OpenAI 兼容)和https://api.deepseek.com/anthropic(Anthropic 兼容)。 deepseek-v4-pro将于 2026 年 9 月 14 日 04:00 UTC 重路由到 V4.1-Flash。- 上下文 1M tokens,最大输出 384K,并发上限 2,500。
- 非高峰定价(每 1M tokens):缓存命中 $0.003,缓存未命中 $0.15,输出 $0.60。高峰时段翻倍。
- 视觉能力是原生支持的。图片以
image_urlpart 的形式放进content数组。
API 调用方这边变了什么
以下是差异,取自发布说明和 changelog。
只有一个 model id。规范名称现在是 deepseek-flash,不带版本号。请把你的 prompt 和测试锚定在行为上,而不是版本字符串上,因为下一个 Flash 版本还会用同一个名字发布。
旧名字仍然可路由。deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 目前仍被接受,但它们背后的模型 V4-Flash 和 V4-Flash-Vision-Exp 已经退役。发往这些名字的请求由 V4.1-Flash 提供服务。不会坏,但你跑的并不是你以为的那个模型。能改就改。
beta 名字已消失。9 月 8 日那两天的 beta 以 deepseek-v4.1-flash-expires-on-0910 的名字运行,已按承诺过期。请切换到 deepseek-flash。
Base URL 和格式未变。OpenAI 兼容调用走 https://api.deepseek.com,Anthropic 兼容调用走 https://api.deepseek.com/anthropic,Flash 系列此前已支持的 Responses API 格式也沿用下来。你的 SDK 配置不用动。
V4-Pro 只剩四天。从 2026 年 9 月 14 日 04:00 UTC(北京时间 12:00)起,每个 deepseek-v4-pro 请求都会被路由到 V4.1-Flash,并按 V4.1-Flash 的价格计费。DeepSeek 给出的理由是 V4.1-Flash“在性能、成本、速度和总耗时上全面超越 V4 Pro”,并引用了多方的测试结果。这是厂商的说法。V4-Pro 退役迁移指南会告诉你,在切换真正落到你头上之前,怎么用自己的 prompt 去验证这一点。
第 1 步:获取 key
登录 DeepSeek 平台,打开 API Keys,创建一个。key 以 sk- 开头。请用环境变量的方式导出,而不是直接粘进源码:
export DEEPSEEK_API_KEY="sk-your-key-here"
不需要 DeepSeek 专用的 SDK。只要改一下 base URL,OpenAI 和 Anthropic 的客户端库都能用。
第 2 步:发出你的第一次调用
先用 curl,因为它排除了除 API 本身之外的所有变量:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {"role": "system", "content": "You are a support engineer for a payments API."},
      {"role": "user", "content": "A customer gets HTTP 402 on /v1/charges. List the three most likely causes."}
    ],
    "stream": false
  }'
同一个调用换成 OpenAI Python SDK:
# pip install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You are a support engineer for a payments API."},
        {"role": "user", "content": "A customer gets HTTP 402 on /v1/charges. List the three most likely causes."},
    ],
)

print(response.choices[0].message.content)
再换成 Node:
// npm install openai
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.deepseek.com",
  apiKey: process.env.DEEPSEEK_API_KEY,
});

const completion = await client.chat.completions.create({
  model: "deepseek-flash",
  messages: [
    { role: "user", content: "Write a Postgres migration that adds a nullable refunded_at timestamp to invoices." },
  ],
});

console.log(completion.choices[0].message.content);
如果你是照着 V4-Flash API 指南接的上一个版本,那唯一的差异就是 model 字符串。
第 3 步:reasoning effort 与 thinking 模式
模型卡把 reasoning effort 描述为 1 到 100 区间上的“连续可控”。这与大多数 API 暴露的 low/medium/high 预设不同,意味着你可以按接口而不是按档位来调成本和延迟。
承载这个 1 到 100 取值的 parameter 形态,尚未在 API 文档中得到确认 [VERIFY]。在确认之前,先沿用 V4-Flash 的写法:reasoning_effort 加上一个通过 extra_body 传入的 thinking object:
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Our Redis cluster drops 2% of SETs under load. Plan the investigation."}],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)
模型卡推荐的采样设置:temperature 1.0,top_p 取 0.95 或 1.0,长 reasoning 链路请把 max_tokens 设为 256K 或更高。最大输出为 384K tokens。
一个实用的划分:自动补全、分类,以及任何用户在等的场景,关闭 thinking;agent 循环、多文件重构和调试,开启 thinking 并调到高 effort。然后去测量。你在输出里看不到的 effort,同样是要付钱的。
第 4 步:发送一张图片
V4.1-Flash 是原生多模态,在 45T token 的多模态语料上训练,并配有一个从零训练的 DeepSeek-ViT 编码器。请求格式沿用 V4-Flash-Vision-Exp:图片是用户消息 content 数组中的 part。
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Extract every line item and the total from this receipt as JSON."},
            {"type": "image_url", "image_url": {"url": "https://cdn.example-shop.com/receipts/48213.png"}},
        ],
    }],
)
如果是本地文件,把它编码成 base64 data URL:
import base64

with open("receipt.png", "rb") as f:
    data_url = "data:image/png;base64," + base64.b64encode(f.read()).decode()

# then pass {"url": data_url} in the image_url part
限制:base64 data URL 最大 32 MiB,外部 URL 最长 8,192 个字符,或者使用 file ID。还接受一个可选的 detail 字段。DeepSeek 报告 DocVQA 95.6,对应的正是上面这种文档读取场景。视觉 API 指南覆盖了多图 prompt、detail 级别,以及图片在每次请求中的计费方式。
第 5 步:流式返回响应
设置 stream=True,接口就会返回 server-sent events。reasoning 内容和答案内容会作为不同的 delta 到达,当你要在 UI 里渲染一个“thinking”状态时,这一点很关键。
stream = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Explain idempotency keys in one paragraph."}],
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
如果你还不熟悉 SSE,用 server-sent events 流式传输 LLM 响应 一文讲解了线上的数据格式以及重连的边界情况。
定价一览
以下取自官方定价页,自 2026 年 9 月 10 日 04:00 UTC 起生效,单位为美元/每 1M tokens:
| deepseek-flash 非高峰时段 | deepseek-flash 高峰时段 | |
|---|---|---|
| 输入,缓存命中 | $0.003 | $0.006 |
| 输入,缓存未命中 | $0.15 | $0.30 |
| 输出 | $0.60 | $1.20 |
有三点需要知道:
- 高峰时段为周一至周五 01:00–04:00 和 06:00–10:00 UTC(北京时间 9:00–12:00 和 14:00–18:00)。非高峰是半价。能等的批处理任务就等一等。
- 缓存命中是自动的。一次命中的成本比未命中低 50 倍,所以把稳定的 system prompt 放在每个请求的最前面,就是最便宜的优化。什么是 prompt caching 一文解释了前缀匹配是如何工作的。
- 与 V4-Flash 相比,缓存命中输入降了约 57%,缓存未命中输入降了 32%,输出降了 9%。9 月 14 日被重路由的 V4-Pro 负载,高峰时段每 1M 缓存未命中输入付 $0.30 而不是 $1.32,输出付 $1.20 而不是 $3.96。
在 Apifox 中测试该 API
第一次调用跑通之后,问题就变成了它能否一直跑通。deepseek-flash 不带版本号,所以下一次升级会是悄无声息的。下面这套 Apifox 工作流可以把它抓出来:
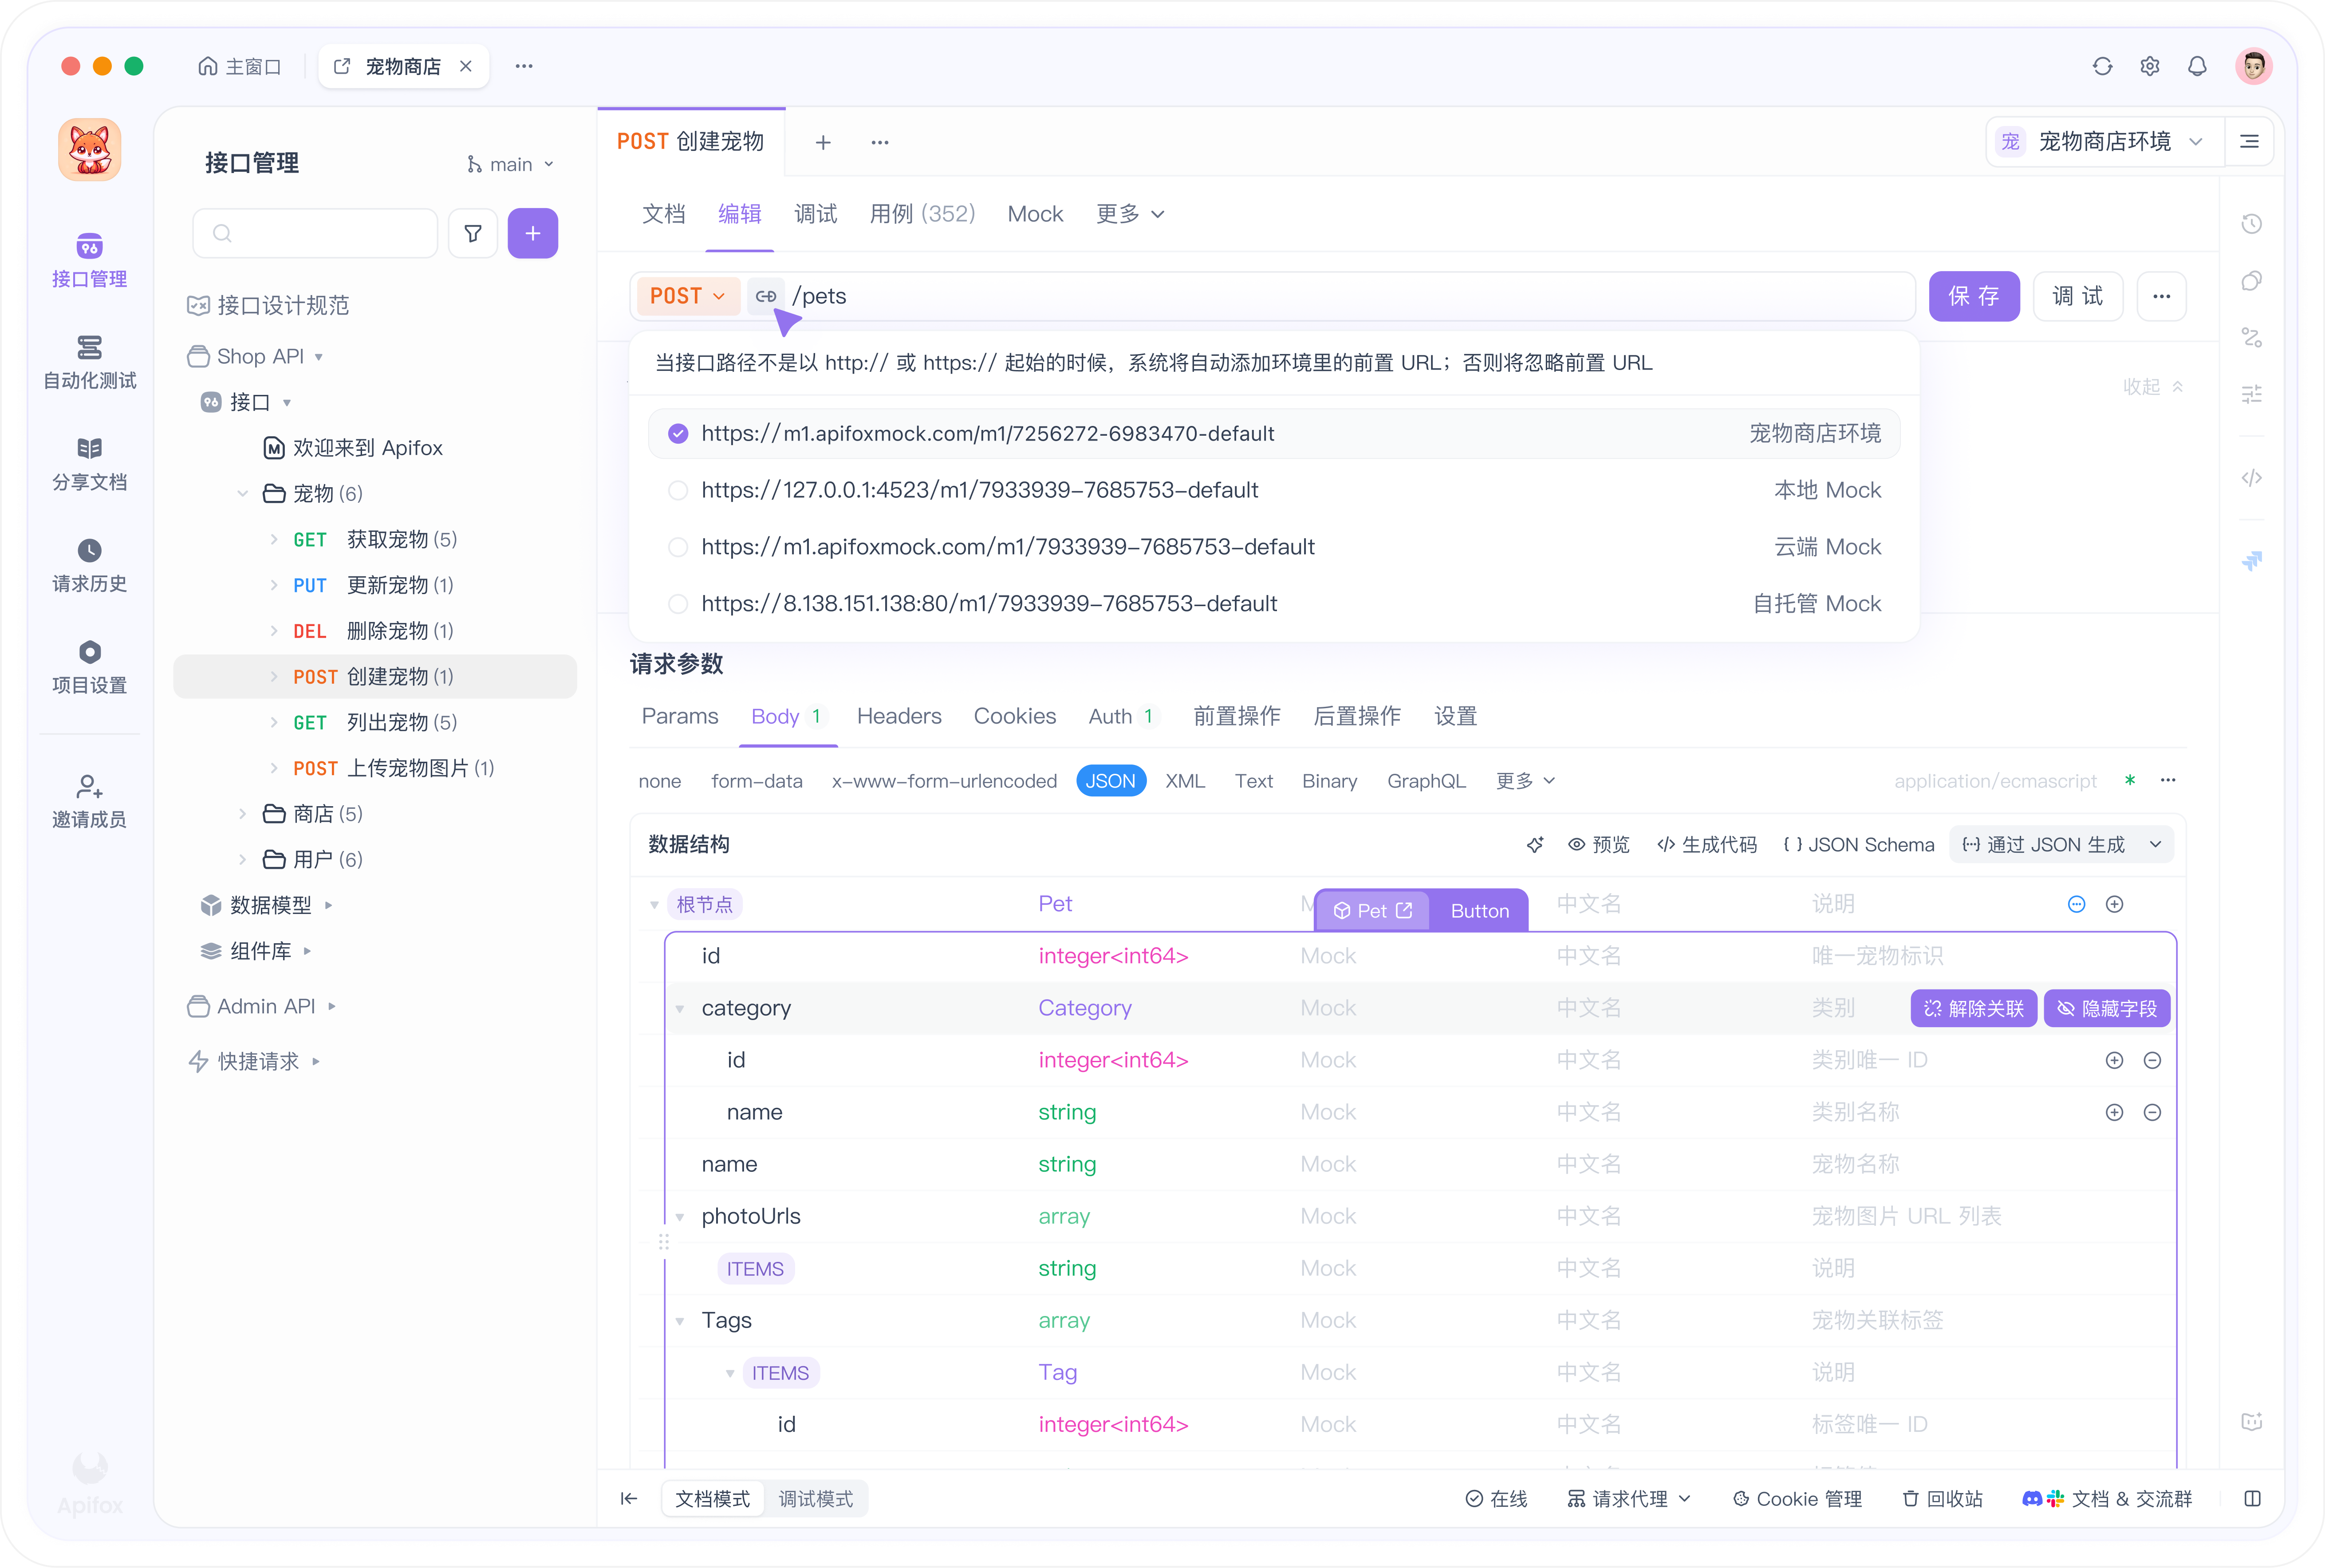
- 添加接口。创建
POST https://api.deepseek.com/chat/completions,或者导入一份 OpenAI 兼容的 OpenAPI 规范,一次性把所有路由都导进来。 - 把 key 存为环境变量。将
DEEPSEEK_API_KEY放进 Apifox 环境,并把 header 设为Bearer {{DEEPSEEK_API_KEY}}。这样在个人 key 和生产 key 之间切换就变成了一个下拉选择。 - 每个 effort 级别保存一个请求。把基础请求复制成多个变体:关闭 thinking、开启 thinking 且低 effort、开启 thinking 且高 effort。同一个 prompt,不同的 parameter。三个都发出去,并排对比 token 用量和延迟。
- 观察流式输出。对于
stream: true,Apifox 会在 SSE 事件到达时实时渲染,所以 reasoning delta 和 content delta 会分别显示成不同的行,而不是一屏的data:前缀。 - 把这些变体变成一个测试场景。对状态码加断言,对第二次运行时
usage中的缓存命中数大于零加断言,对响应包含你的应用所解析的字段加断言。每次模型更新后都重跑这个场景,9 月 14 日 V4-Pro 重路由生效时也要跑。 - 在 CI 中运行。
apidog-cli可以从流水线里执行同一个场景,这样一次悄无声息的模型变更会先让一次构建失败,而不是先让客户发现问题。
FAQ
我必须把 deepseek-v4-flash 改名成 deepseek-flash 吗?今天不必。旧名字仍然路由到 V4.1-Flash。但 V4-Flash 本身已经退役,而 DeepSeek 没有说这个别名什么时候下线。在你下一次部署时改掉它。
9 月 14 日我的 V4-Pro 代码会怎样?不会坏。从 04:00 UTC 起,发往 deepseek-v4-pro 的请求由 V4.1-Flash 应答并按 Flash 的价格计费。不过输出可能会变,请在此之前跑一遍你的评测集。迁移指南里有一份检查清单。
Anthropic 兼容的接口支持新模型吗?支持。https://api.deepseek.com/anthropic 未变;在那里同样使用 deepseek-flash 作为模型名。
有免费额度吗?该 API 按量付费,没有永久免费层。如果你想自托管,权重在 Hugging Face 上以 MIT 许可发布。当前的可行选项汇总在 如何免费使用 DeepSeek V4 API 一文里。
它有多快?DeepSeek 尚未公布 tokens-per-second 数据。一位 X 用户在视频测试中报告“接近 400 t/s”,这只是个例,不是规格。请在高峰时段用自己的 prompt 实测。
在重路由发生之前
API 表面几乎没动:同样的 base URL,同样的请求格式,多了一个新的 model id。真正变动的是价格,以及 9 月 14 日对每一个 V4-Pro 调用的路由。把 deepseek-v4-flash 改名为 deepseek-flash,为每个接口选好 effort 级别,并在 DeepSeek 替你跑之前,先用自己的 prompt 跑一遍新模型。
顺便把这些 prompt 保存成测试。Apifox 一键即可重跑,下一次悄无声息的 Flash 升级会表现为一条失败的断言,而不是一张支持工单。
开发必备:API 全流程管理神器 Apifox
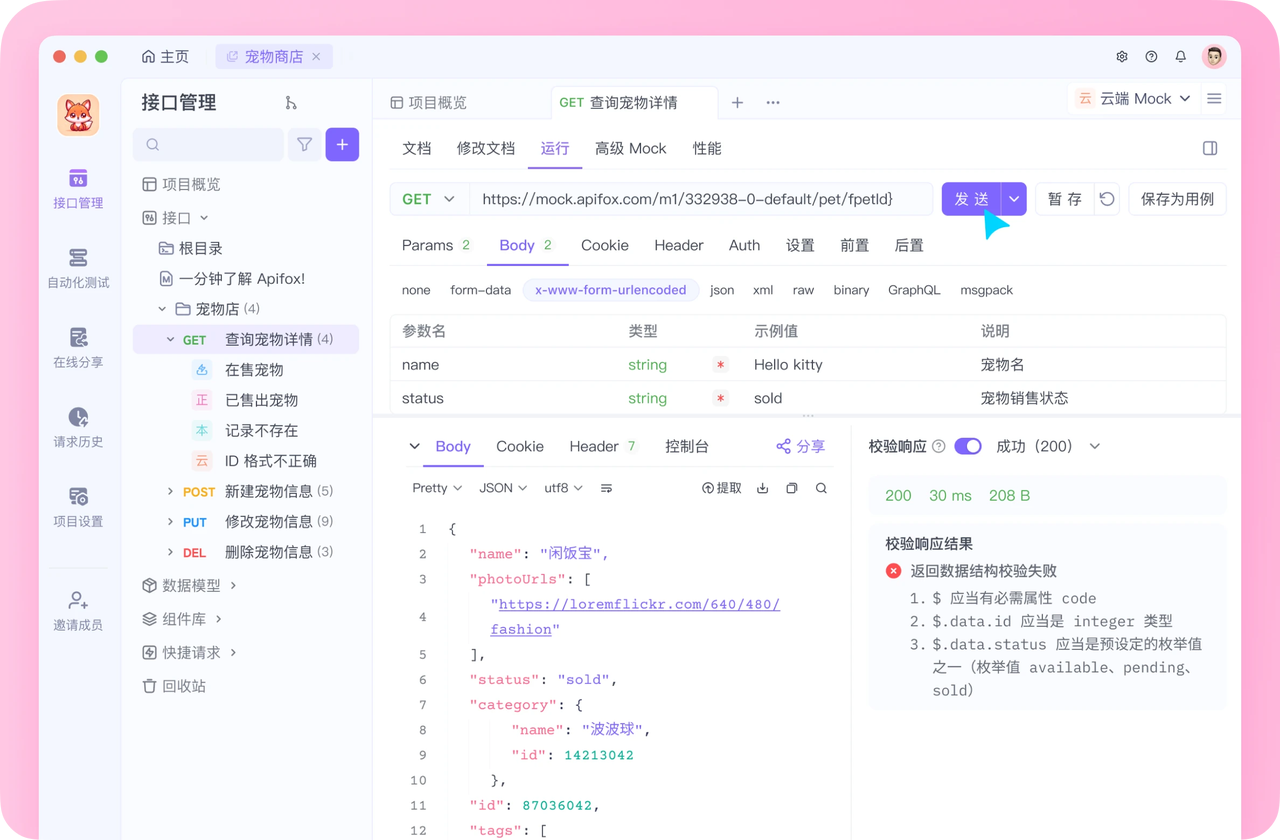
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会