要使用 Claude Haiku 5.5 API,请向 https://api.anthropic.com/v1/messages 发送 POST 请求,带上 "model": "claude-haiku-5-5"、放在 x-api-key 请求头中的密钥,以及 anthropic-version: 2023-06-01。对于不超过 100K token 的提示词,每百万输入/输出 token 的价格为 $0.10/$0.50(超过则为 $0.50/$2.50);它能读取最多 1M token 的上下文,最多写入 128K,并默认使用 medium 档位、开启自适应思考。
Anthropic 于 2026 年 10 月 7 日发布了 Haiku 5.5,这是首个带 effort 档位的 Haiku(《什么是 Claude Haiku 5.5》涵盖规格与定位)。本指南涵盖用 curl、Python 和 TypeScript 完成第一次调用,随后是 effort、thinking、缓存、批处理、拒绝处理和 Agent 工具集。你可以在 Apifox 中保存并断言下面的每一个请求。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

Claude Haiku 5.5 API 一览
| 参数 | Haiku 5.5 行为 |
|---|---|
| 模型 ID | claude-haiku-5-5(Bedrock:anthropic.claude-haiku-5-5);没有单独的别名 |
| 每 MTok 价格,提示词不超过 100K token | $0.10 输入,$0.50 输出,$0.01 缓存读取 |
| 每 MTok 价格,提示词超过 100K token | $0.50 输入,$2.50 输出,$0.05 缓存读取 |
| 上下文 / 最大输出 | 1M / 128K;在 Batch 上使用 output-300k-2026-03-24 beta 请求头时为 300K |
output_config.effort |
low、medium(默认)、high、xhigh、max |
thinking |
默认 adaptive;disabled 仅在 high 档位或以下可用 |
thinking.display |
默认返回空的 thinking 字段;summarized 返回可读文本 |
temperature、top_p、top_k |
非默认值会返回 400 |
| Assistant 预填充 | 返回 400,即使关闭 thinking 也是如此 |
| 最小可缓存提示词 | 512 token(Haiku 4.5 上为 4,096) |
来源:Haiku 5.5 模型页面 和 Claude API 定价文档。
你的第一次 Claude Haiku 5.5 API 调用
在 Claude Console 中创建一个密钥(Anthropic API key 指南中有完整步骤),并将其导出为 ANTHROPIC_API_KEY。切勿把密钥粘贴到代码中。然后发送以下请求:
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 4096,
    "output_config": {"effort": "medium"},
    "thinking": {"type": "adaptive", "display": "summarized"},
    "messages": [{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: The export button times out on large projects."}]
  }'
Python SDK 会从环境中读取 ANTHROPIC_API_KEY:
import anthropic

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    thinking={"type": "adaptive", "display": "summarized"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: The export button times out on large projects."}],
)

for block in response.content:
    if block.type == "thinking":
        print("[thinking]", block.thinking)
    elif block.type == "text":
        print(block.text)
print(response.stop_reason, response.usage)
TypeScript 的形式相同:
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 4096,
  output_config: { effort: "medium" },
  thinking: { type: "adaptive", display: "summarized" },
  messages: [
    { role: "user", content: "Classify this ticket as billing, bug, or feature request: The export button times out on large projects." },
  ],
});

for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
console.log(response.stop_reason, response.usage);
三个习惯能让这段代码持续可用。按 type 选择内容块,因为响应可能以 thinking 块开头,此时 content[0].text 会出错。在 max_tokens 中留出余量,因为 thinking token 也计入其中。并保持请求体干净:不要出现 temperature、top_p、top_k、budget_tokens 或 assistant 预填充。在这个模型上,每一项都会导致 400。如果你在迁移旧代码,Haiku 5.5 vs Haiku 4.5 指南列出了每一处破坏性变更及前后对比的 JSON。
选择 effort 档位
通过 output_config.effort 设置的 effort,是调节质量、延迟和成本的主要旋钮。提示词指南 给出了以下起点:
low:最便宜、最快的档位,适用于对话、简短的工具任务以及简单的高频请求。medium:默认档位。大多数工作都从这里开始,包括 agentic 编码。high:知识型工作、较长的 Agent 任务以及严格的指令遵循。xhigh和max:仅在你的评测显示有收益时才使用。Anthropic 建议在 Claude Sonnet 5.5 上运行相同的评测并做对比。
成本曲线很陡。以下是 Anthropic 自己发布的 OSWorld 2.1(离线子集)运行数据,来自发布时的图表,包含部分得分和每次尝试的成本:
| 档位 | 得分 | 每次尝试成本 |
|---|---|---|
low |
42.0% | $0.0695 |
medium |
53.3% | $0.1257 |
high |
61.3% | $0.1827 |
xhigh |
67.6% | $0.2792 |
max |
72.4% | $0.6111 |
从 xhigh 到 max,成本翻了一倍多,得分提升却不到五分。Haiku 5.5 基准测试拆解 中有其他按档位划分的图表。
一个怪癖:在多轮对话中,xhigh 档位下模型有时会把整个答案写进 thinking,并在没有任何可见文本的情况下结束该轮。在展示给用户之前,先检查回复是否为空。
控制 thinking
自适应思考默认开启,相比 Haiku 4.5 有两点变化。第一,默认显示会隐藏文本。每个 thinking 块返回时 thinking 字段为空,只有一个 signature。当你想在日志或 UI 中获得可读摘要时,设置 "display": "summarized"(如第一次调用那样)。想减少思考,就降低 effort;在 Anthropic 的测试中,提示模型直接作答并不能让它停止思考。
第二,你可以关闭 thinking,但只能在 high 档位或以下:
{
  "model": "claude-haiku-5-5",
  "max_tokens": 1024,
  "thinking": {"type": "disabled"},
  "output_config": {"effort": "low"},
  "messages": [{"role": "user", "content": "Extract the invoice number from: INV-2291, due Nov 3."}]
}
同样的请求体在 xhigh 或 max 下会返回 400。强制 tool_choice(any 或指定工具)会被接受,但响应会以工具调用开头,且不包含 thinking 块。
对于多轮对话和 Agent 循环,把每个 thinking 块原样回传,并保持历史记录只追加。在返回的 thinking 块之前修改 system、tools 或更早的 messages 会返回 400,而且 thinking 块只在生成它们的账户(或与之关联的账户)中有效。
缓存提示词与批处理任务
缓存是 Haiku 5.5 变便宜的地方。对于不超过 100K token 的提示词,缓存读取每百万 token 花费 $0.01,而全新输入为 $0.10;5 分钟缓存写入花费 $0.125,1 小时写入为 $0.20。最小可缓存提示词为 512 token,低于 Haiku 4.5 的 4,096,因此简短的系统提示词和工具列表现在也符合条件。用 cache_control 标记稳定的前缀:
{
  "model": "claude-haiku-5-5",
  "max_tokens": 1024,
  "system": [{
    "type": "text",
    "text": "You are a support triage assistant. <long, stable policy text here>",
    "cache_control": {"type": "ephemeral"}
  }],
  "messages": [{"role": "user", "content": "Ticket: refund not received after 10 days."}]
}
在请求之间修改顶层 effort 会使缓存失效;按消息设置 effort(beta 请求头 mid-conversation-output-config-2026-07-01,Claude API 和 Google Cloud)则会保留缓存。提示词缓存文档 介绍了 TTL,我们的提示词缓存解读文章介绍了其概念。
对于可以等待的工作,Message Batches API 可将输入和输出费用降低 50%:不超过 100K token 的提示词为 $0.05/$0.25,超过则为 $0.25/$1.25。Batch 也是获得 300K 输出 token 的唯一途径,需要 output-300k-2026-03-24 beta 请求头。
注意 100K 这条线:用 Anthropic 的话说,“超过 100,000 token 的提示词需支付更高的价格”。Haiku 5.5 定价指南 通过两侧的示例做了讲解。
处理 stop_reason “refusal”
Haiku 5.5 会运行安全分类器,可能拒绝请求,而且它没有服务端兜底。被拒绝的请求会返回 stop_reason: "refusal",类别包括 cyber、frontier_llm、bio 和 general_harms。如果你是从 Haiku 4.5 迁移过来的,这些拒绝是新增的。重复发送同一个请求通常会再次得到拒绝,所以不要盲目重试:
def run(client, messages):
    response = client.messages.create(
        model="claude-haiku-5-5",
        max_tokens=4096,
        messages=messages,
    )
    if response.stop_reason == "refusal":
        details = getattr(response, "stop_details", None)
        category = getattr(details, "category", "unknown")
        log_refusal(category, messages)  # your logging
        return {"status": "refused", "category": category}
    text = "".join(b.text for b in response.content if b.type == "text")
    return {"status": "ok", "text": text}
先根据 stop_reason 分支,再读取 content,并在你自己的代码中把拒绝路由给人工或另一个模型。从事正当安全或生命科学工作、却被 cyber 或 bio 分类器拦截的团队,可以申请 Anthropic 的 Cyber Verification Program 或 Life Sciences Verification Program。
Computer use 与 browser use
在 Claude API 和 Google Cloud 上,Haiku 5.5 仅通过 computer_toolset_20260801 工具集支持 computer use,且无需 beta 请求头;声明 computer_20250124 会返回 400。Browser use 通过 browser_toolset_20260801 实现,而 Haiku 4.5 不支持它。Python 和 TypeScript SDK 在发布当天就为两者添加了 beta 类。成员工具请参阅 computer use 工具文档。
速率限制
Haiku 5.5 与 Haiku 4.5 具有相同的 速率限制:在 Start 层级上,每分钟 1,000 个请求、2M 输入 token 和 400K 输出 token;在 Scale 层级上最多 10,000 个请求、10M 输入和 2M 输出。不支持 Priority Tier。有关 429 的处理,请参阅 rate limit exceeded 指南。
在 Apifox 中测试 Claude Haiku 5.5 API
保存的请求让 effort 对比和拒绝调试可以重复进行。以下是在 Apifox 中的设置:
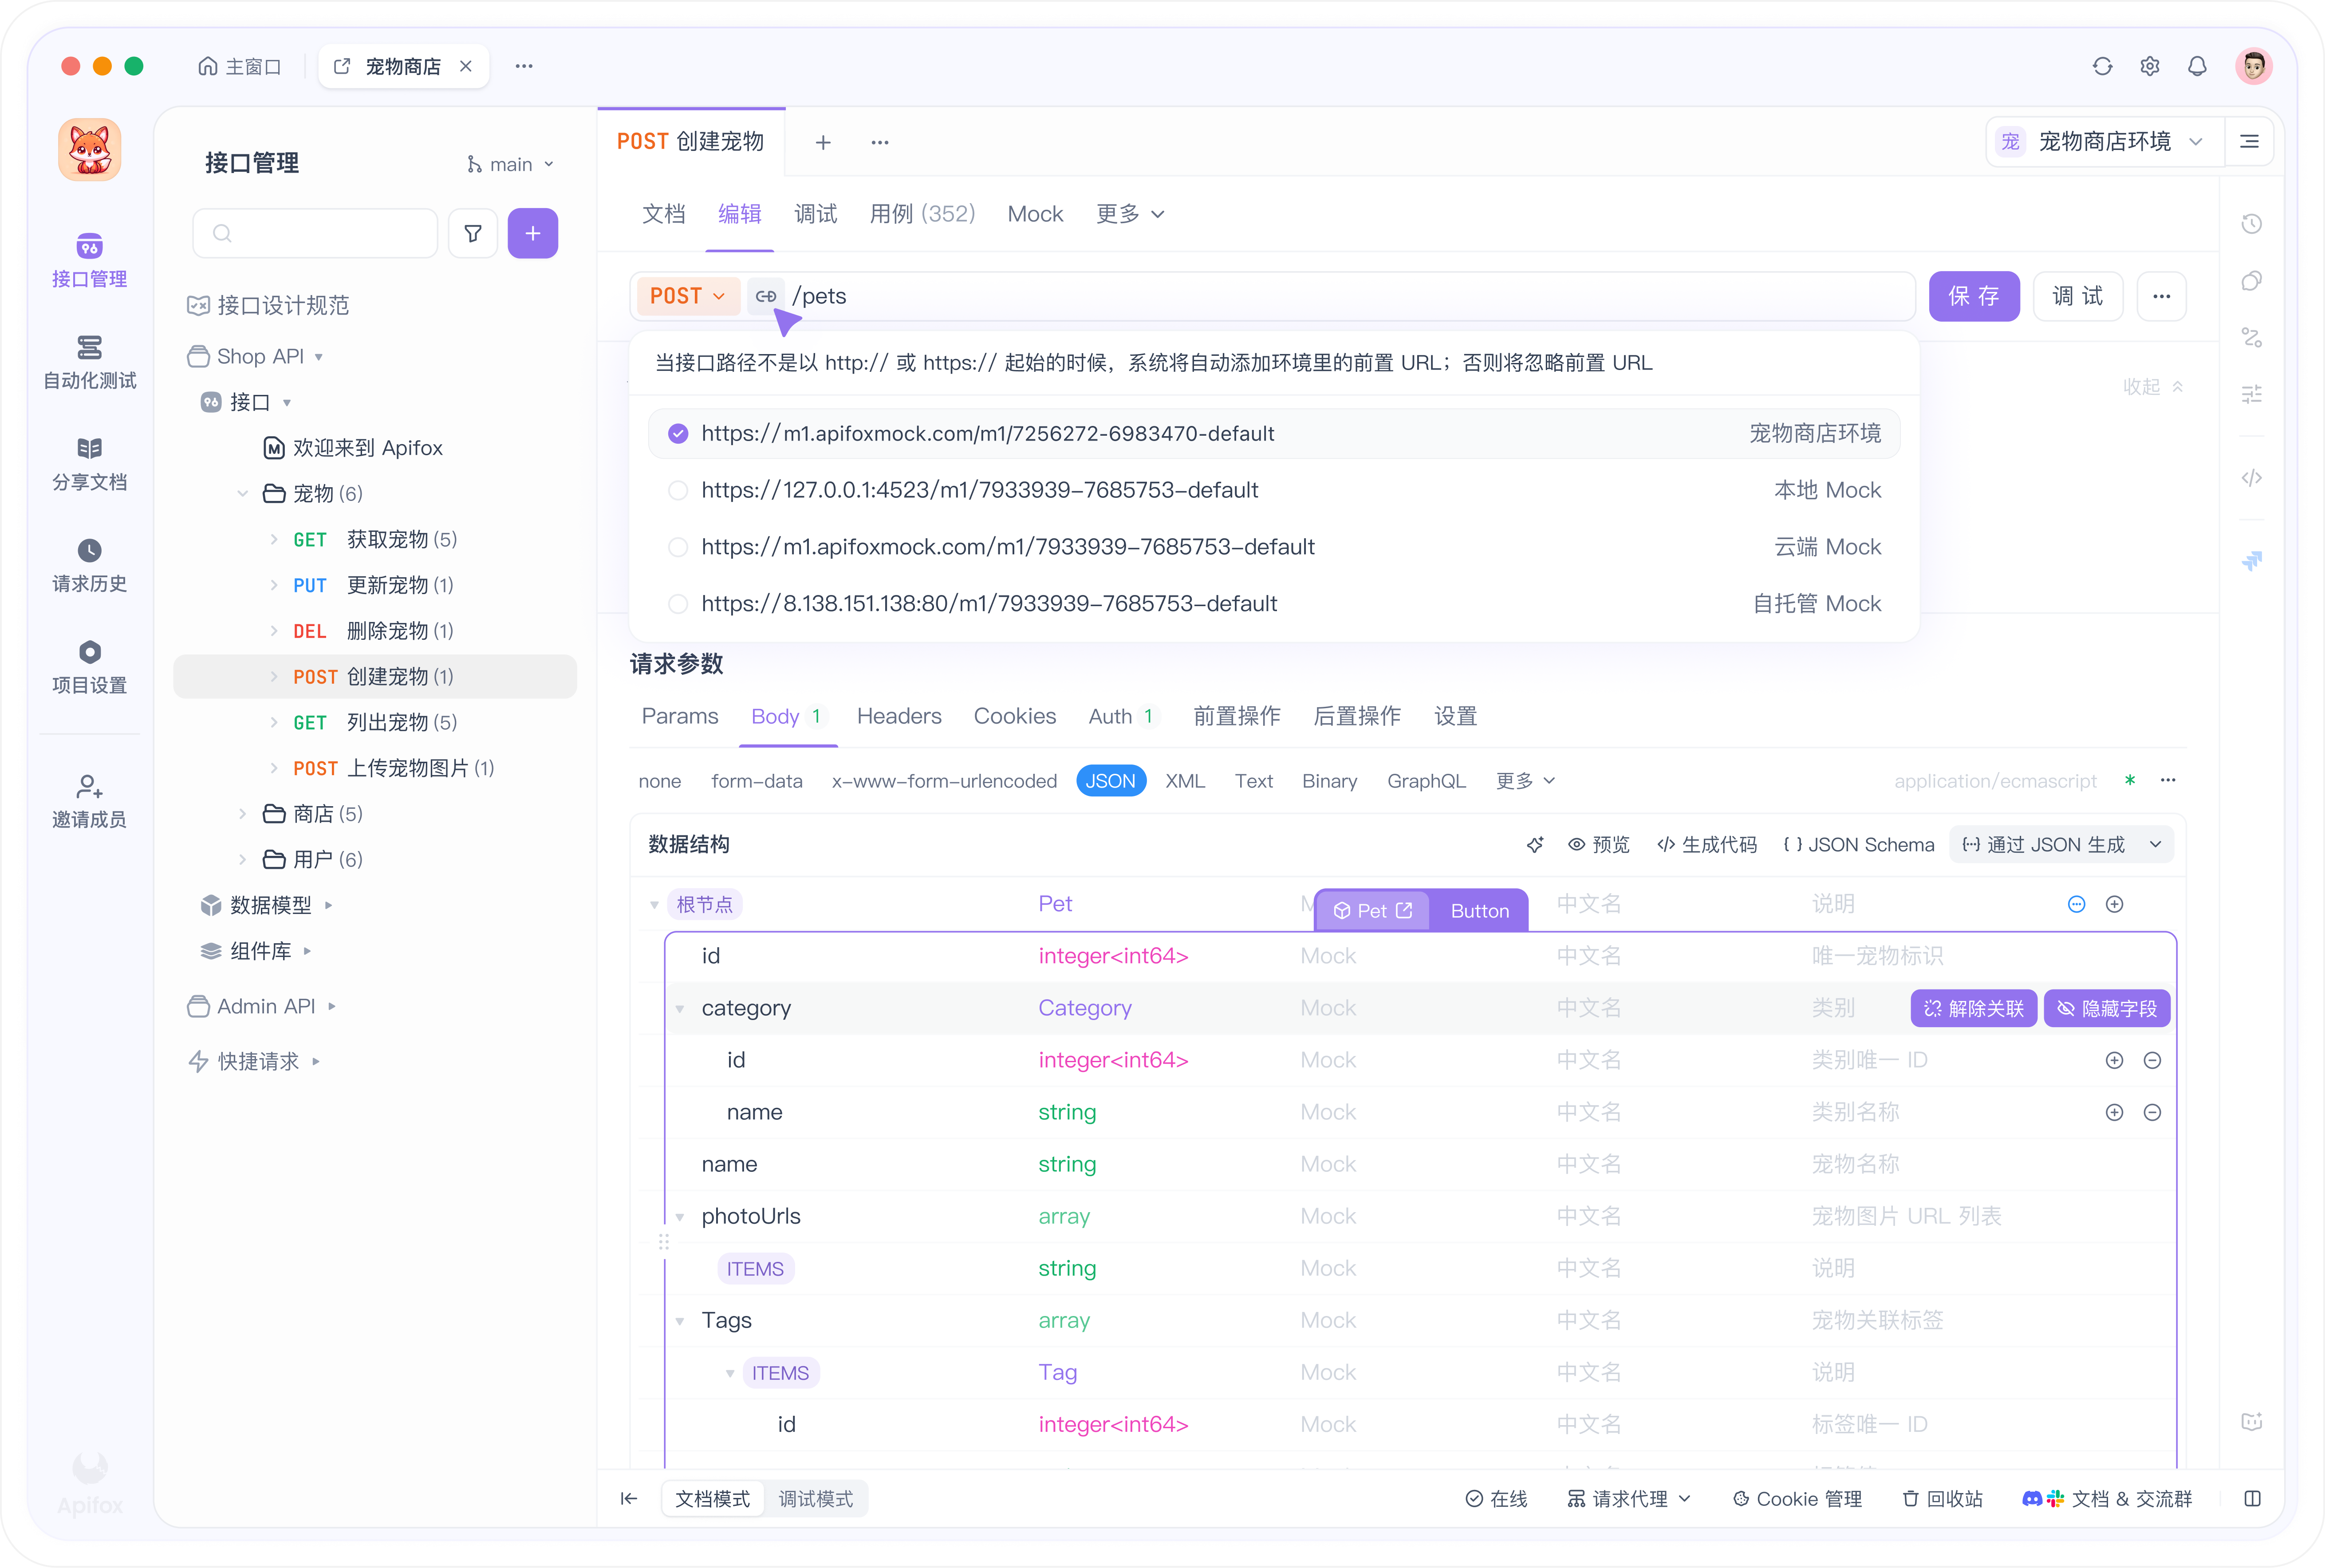
- 创建一个环境,并将
ANTHROPIC_API_KEY添加为密钥变量。以{{ANTHROPIC_API_KEY}}的形式在x-api-key请求头中引用它,紧挨着anthropic-version: 2023-06-01和content-type: application/json。 - 创建一个指向
https://api.anthropic.com/v1/messages的 POST 请求,粘贴第一次调用的请求体并保存。 - 添加断言:状态码为 200,
$.stop_reason等于end_turn,$.usage.output_tokens大于 0,且$.content[*].type包含text。这样,拒绝或空的xhigh回复现在会让测试失败,而不是被放过。 - 用
low、high、xhigh和max把该请求复制四份,然后运行该目录。你就能针对自己的提示词获得每个档位的usage。 - 添加带缓存系统提示词的变体,并断言第二次运行时
$.usage.cache_read_input_tokens大于 0。
更多通用模式,请参阅 testing LLM applications。
常见问题
Claude Haiku 5.5 的模型 ID 是什么? claude-haiku-5-5,没有日期后缀,也没有单独的别名,适用于 Claude API、Google Cloud、Microsoft Foundry 和 Claude Platform on AWS。在 Amazon Bedrock 上是 anthropic.claude-haiku-5-5。
有免费的 Claude Haiku 5.5 API 吗? 没有长期的免费额度,但新的 API 用户可以获取少量免费额度来测试 API。免费版 Claude.ai 用户可以在对话中选择 Haiku 5.5,但那并不是 API 密钥。Max 和 Team 套餐现在包含每月 API 额度。free access 指南 说明了哪些算数、哪些不算。
为什么我的 Haiku 4.5 请求返回 400? 检查是否有 budget_tokens、非默认的 temperature 或 top_p、任何 top_k、assistant 预填充,或旧的 computer_20250124 工具。这些是常见原因。
我可以在 Claude Code 中使用 Haiku 5.5 吗? 可以,从 v2.1.293 起。在 Anthropic API 上,haiku 别名会解析为 Haiku 5.5。参见 Claude Haiku 5.5 in Claude Code。
agentic 编码应该用 Haiku 5.5 还是 Sonnet 5.5? Anthropic 表示,Sonnet 5.5 和 Opus 5.5 “仍是复杂 agentic 编码任务的更好选择”。把 Haiku 5.5 用于范围明确的工作:分类、摘要、压缩、子 Agent 和 browser use。
下一步
用 medium 发送第一次调用的请求,然后用你自己工作负载中的提示词在 low 和 high 下重跑,比较 usage.output_tokens 和答案质量。下载 Apifox 来保存全部三次带断言的运行,这样下一次模型发布就只需改动一个字段。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会