2026 年 9 月 10 日,DeepSeek 以 MIT 许可把 DeepSeek-V4.1-Flash 的权重放上了 Hugging Face,同一天该模型在 API 上正式 GA。这个时间点并不常见。大多数实验室会先把托管 endpoint 上线,几周之后再放权重,甚至干脆不放。
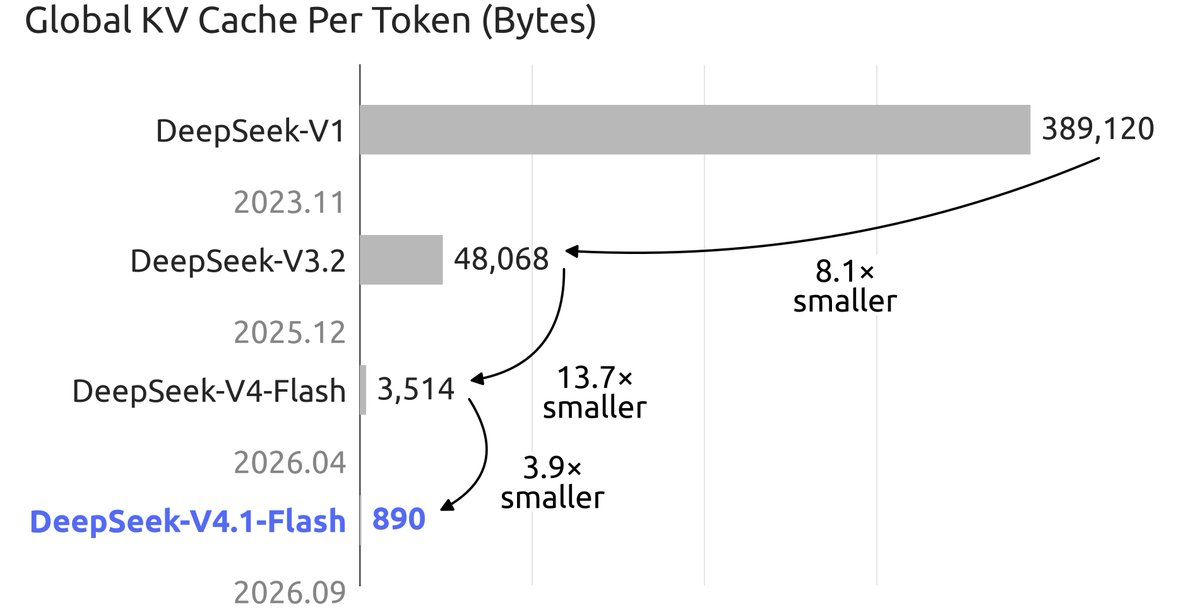
标题里的数字会吓退大多数读者:backbone 5520 亿参数,加上视觉编码器是 7630 亿。但这套底层设计对自托管的友好程度,远超这个体量给人的印象。prefill 阶段只有 8B 参数处于激活状态,decode 阶段是 16B;新的 FP4 KV cache 每 token 只占 890 字节,大约是 V4-Flash 的四分之一。算力便宜,显存才是那堵墙。
但人们还是会去试。本指南给出显存账本、各硬件档位下真正可行的路径、通用部署命令,以及一种在 Apifox 中把本地 OpenAI 兼容 endpoint 与托管 API 做对照测试的方法。如果你想先看模型概览,可以先读《什么是 DeepSeek-V4.1-Flash?》再回来。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。

TL;DR
- 权重:552B MoE backbone,MIT 许可。8-bit 约 552 GB,4-bit 约 280 GB,仅 backbone。
- KV cache:每 token 890 字节。完整的 1M token 上下文约需 0.9 GB。这一块已经解决了。
- 真正可用的 4-bit 部署需要 4 到 8 张 80 GB 级别的 GPU。低于这个配置就只能靠 CPU 或 SSD offload,而且很慢。
- 托管 API 在非高峰时段每 100 万 cache-miss 输入 token 收费 $0.15。对多数团队来说,光这一项就比电费便宜。
你要下载的是什么
model card 描述的是一个 552B 参数的 Mixture-of-Experts backbone,采用新的 Causal Encoder-Decoder 结构:40 层,拆成 20 层 encoder 和 20 层 decoder。每层在 384 个 expert 加 1 个共享 expert 之间做路由。DeepSeek-ViT 视觉编码器把完整 checkpoint 推到 763B 参数,而且即使你只需要文本能力,也得把整个 checkpoint 下载下来。
本地推理有三个细节值得注意:
- 激活参数很小。prefill 阶段激活 8B,decode 阶段激活 16B。单 token 的 FLOPs 看起来就像中等规模的 dense 模型。问题在于,552B 参数里的每一个都必须待在 forward pass 能访问到的地方。
- KV cache 是 FP4 的。release note 说这套 cache 的 HBM 占用是上一代的 1/4,SSD 存储占用是 1/8。按每 token 890 字节算,长上下文不再是过去那种显存难题。
- attention 本身就是稀疏设计的。带三种 static 模式的 Compressed Sparse Attention 2 在 64K 上下文下训练,并在 45T token 训练的后期扩展到 1M。这就是 1M 上下文下 KV 占用依然很小的原因。
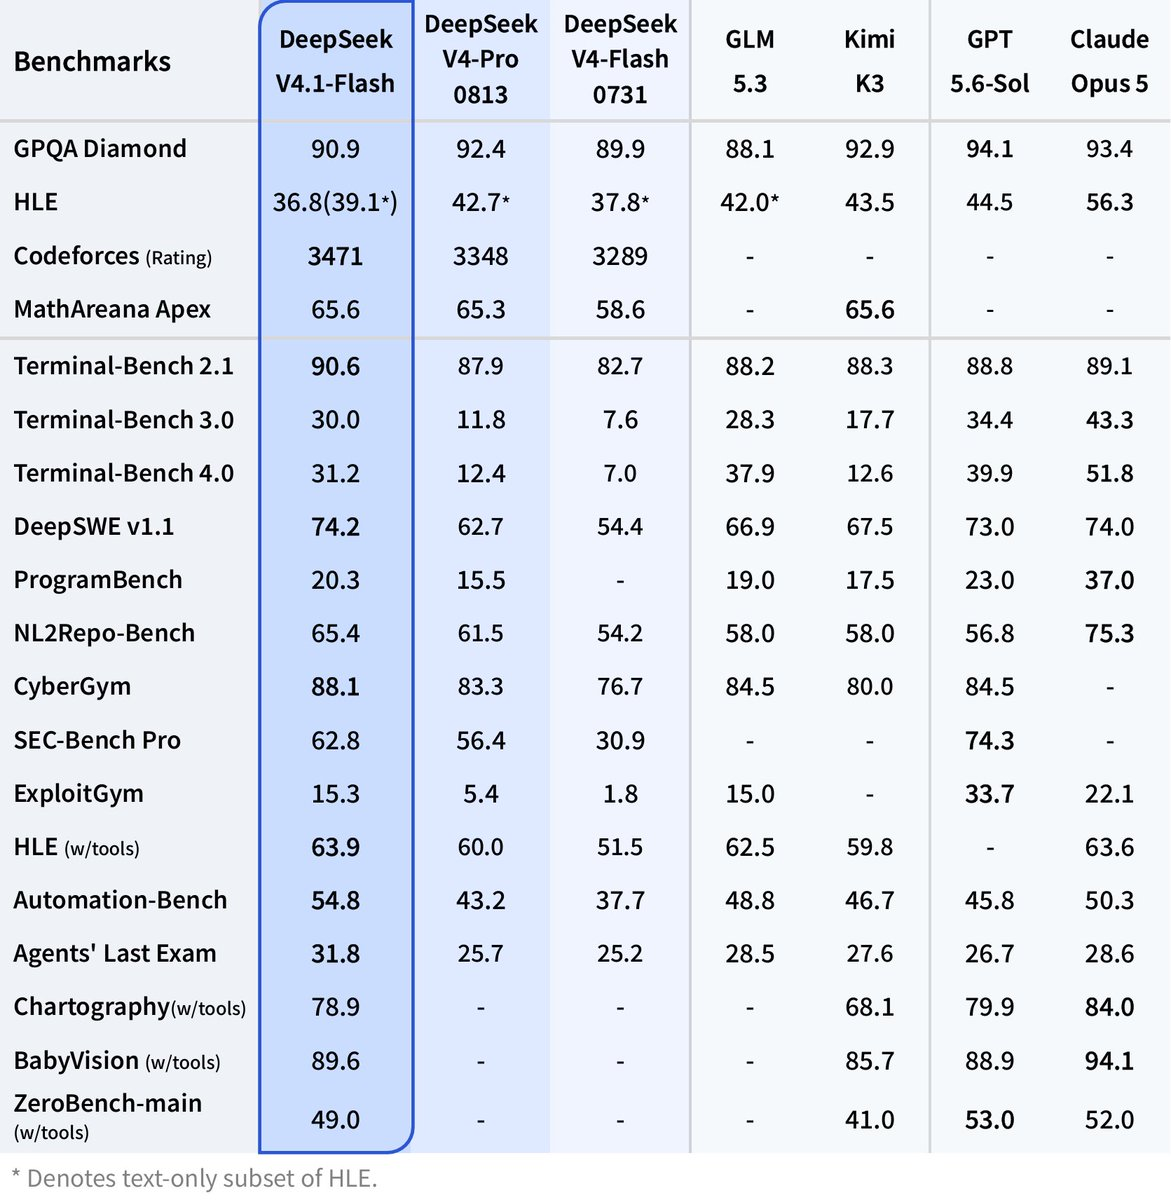
tech report 完整介绍了这套架构。model card 上的每个 benchmark 数字都由 DeepSeek 自己报告,请把它们当作一方说法来看待。
显存账本
下面的数字是直接相乘算出来的,不是实测值,并且不含引擎开销、activation 和视觉编码器。
| 组成项 | 大小 | 计算方式 |
|---|---|---|
| backbone 权重,8-bit | ~552 GB | 552B 参数 × 1 字节 |
| backbone 权重,4-bit | ~280 GB | 552B 参数 × 0.5 字节 |
| KV cache,每 token | 890 字节 | 来自 model card |
| 128K 上下文下的 KV cache | ~0.11 GB | 890 x 128,000 |
| 1M 上下文下的 KV cache | ~0.89 GB | 890 x 1,000,000 |
有两点很突出。第一,KV cache 小到可以忽略。一个 1M token 的会话占不到 1 GB,所以你可以在不碰权重预算的前提下常驻几十个长会话。第二,权重才是全部问题所在。没有任何量化技巧能让 552B 参数塞进一块消费级 GPU,而 8B 激活的设计也帮不上忙,因为 MoE 路由仍然需要每个 expert 都被加载且可寻址。
这也解释了为什么 offload 方案体感很不均衡。prefill 会把整个 prompt 批量处理,始终是算力受限。decode 则要为每一个 token 从 RAM 或 SSD 换入 16B 激活参数。决定你每秒能出多少 token 的是带宽,不是 FLOPs。
现实中可行的硬件档位
这里不给吞吐数字。DeepSeek 之外没人拿到权重的时间长到足以发布可信的 benchmark。
第一档:多 GPU 服务器,4 到 8 张 80 GB 级别的卡。四张 80 GB 卡给出 320 GB,够放 4-bit 权重,留给 KV cache 和引擎开销的余量很薄。八张卡给出 640 GB,够放 8-bit checkpoint,或者舒服地跑大 batch 的 4-bit 部署。只有这一档,“本地运行”才意味着带 tensor parallelism 的生产级服务;代价是五位数到六位数美元的采购支出,或者每小时数美元的云端租用费。
第二档:单台大内存工作站加 CPU offload。一台系统 RAM 在 512 GB 以上、配一两块 GPU 的机器,可以把 4-bit 权重放在 RAM 里,按需把 expert 层流式送进 GPU。能用,但很慢,因为 decode 阶段吃的是 DDR5 总线带宽而不是 HBM。适合批处理任务和整夜跑的 eval,不适合交互式对话。
第三档:Apple Silicon 加 SSD 流式读取。爱好者路线。512 GB 的 Mac Studio 可以把 4-bit 权重放进统一内存,如果你手上正好有一台,这是真可行的选项。再往下的配置就进入 Kimi K3 HN thread 的领域了:权重拆到多块外置 SSD 上,靠 mmap 干重活,速度大约每秒 1 个 token。这只能证明模型能跑起来,不能证明它在那台机器上有用。我们关于在本地运行 Kimi K3 的指南讨论了在更大模型上同样的取舍,在本地运行 DeepSeek V4 的指南则覆盖了上一代。
部署路径
硬件到位之后,流程是:下载、以 OpenAI 兼容 endpoint 提供服务、测试。
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
在 1 Gbps 的线路下,满速时每 100 GB 大约要 15 分钟。预留一小时以上比较稳妥。
需要注意的是服务端这一环。vLLM、SGLang、llama.cpp 和 Ollama 对 CED 架构与 CSA2 attention 的 day-0 支持情况是 [VERIFY];新的层类型通常需要先给引擎打补丁才能加载权重,而 release note 并没有点名具体支持哪些引擎。在决定下载之前,先去各项目的 changelog 里搜 “DeepSeek-V4.1”。等支持落地之后,用 vLLM 跨 8 张 GPU 提供服务大致是这样:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
只要存在 GGUF 转换版本,llama.cpp 的 llama-server 或 Ollama 模型会暴露同样风格的 http://localhost:8000/v1 endpoint,所以任何 OpenAI SDK 客户端只需改一行就能用:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
temperature=1.0 和 top_p=0.95 这两个值与 model card 的推荐设置一致。Ollama 方面,我们的 Ollama 指南介绍了 Modelfile 流程,vLLM 指南则深入讲了多 GPU 相关的 flag。
更务实的替代方案:托管 API
在非高峰时段,pricing page 上 deepseek-flash 的价格是每 100 万 cache-miss 输入 token $0.15、每 100 万 cache-hit 输入 token $0.003、每 100 万输出 token $0.60。高峰时段翻倍。也就是说,每月 10 亿输入 token 加 2 亿输出 token,非高峰约 $270,高峰约 $540,而这还没算上 cache hit 把输入侧进一步压低的部分。一台 80 GB 级别的 8 卡服务器,在持续负载下光是电费和散热每月就超过这个数,更别说还要摊硬件成本或请人盯着。除非你有数据驻留的合规要求,或者手头正好有闲置硬件,否则 API 在成本上胜出。切换只需要改一个 base_url;我们的 DeepSeek-V4.1-Flash API 指南完整走了一遍。
当约束不是钱的时候,本地部署才赢:物理隔离的环境、不能外发的 prompt 数据,或者需要改动权重的研究。
在 Apifox 中把本地 endpoint 与托管 API 做对照测试
无论选哪条路,在把流量切过去之前,先证明本地服务器的行为与参考实现一致。量化的漂移、错误的 chat template、缺失的 stop token,最终都会表现为细微的输出差异。在 Apifox 里的做法是:
- 建两个环境。一个叫
local,base_url设为http://localhost:8000/v1;一个叫hosted,base_url设为https://api.deepseek.com并填入你的真实 key。所有请求都用{{base_url}}/chat/completions和Bearer {{api_key}}。 - 把一小组 prompt 存成请求。五到十条能代表你实际负载的 prompt:一次 JSON 抽取、一次代码修复、一次长上下文摘要。把它们的
model都设为deepseek-flash,这个值在两端服务器上都可用。 - 加上断言。对 JSON 任务,断言响应能解析成功且存在某个必需字段。对所有请求,断言
finish_reason等于stop,这样可以抓到因上下文设置不当导致的截断。 - 在两个环境上各跑一遍。把环境下拉框从
hosted切到local,重跑同一个测试场景。只在local上出现的失败,就是你的量化或 template 问题,一键完成隔离。 - 观察流式输出。设置
stream: true,用 SSE 视图看事件逐个到达。如果本地服务器会把整个响应缓冲完再发,非流式调用下看不出问题,在这里就会露馅。 - 接进 CI。每次升级引擎都用
apidog-cli跑一遍这个场景,让被改坏的 chat template 在流水线里失败,而不是在用户那里失败。
常见问题
笔记本能跑 DeepSeek-V4.1-Flash 吗?跑不出有用的效果。4-bit 的 backbone 约 280 GB。笔记本可以像 Kimi K3 那个实验一样从 SSD 流式读取,速度大约每秒 1 个 token,这只能算演示,不是工作流。用 API,或者用《如何免费使用 DeepSeek-V4.1-Flash》里列出的其他方案。
8B 激活参数是不是意味着我只需要 8 GB 显存?不是。激活参数决定的是每个 token 的算力开销,不是显存占用。MoE 路由对任意 token 都可能从每层的 384 个 expert 里挑任何一个,所以 552B 参数必须全部加载且可寻址。
1M 上下文需要多少显存?按每 token 890 字节算,约 0.89 GB 的 KV cache。这是这个模型里便宜的部分。权重才是贵的部分。
这个许可可以安全商用吗?可以。据 Hugging Face 的 model card,权重是 MIT 许可。
结论
DeepSeek-V4.1-Flash 在法律和技术这两个真正重要的层面是开放的:MIT 权重、公开的 tech report,以及一套让 1M token 会话在显存上几乎不花代价的 KV cache 设计。但它并没有开放到能让你在桌子底下那台机器上跑起来。对大多数团队来说,正确的做法是用托管 API——非高峰时段每 100 万输入 token $0.15——而本地部署只留给不能出这栋楼的数据。
无论走哪条路,先测试再信任。用 Apifox 同时指向两个 endpoint,跑同一批已保存的请求,让断言告诉你本地构建是否与参考实现一致。
开发必备:API 全流程管理神器 Apifox
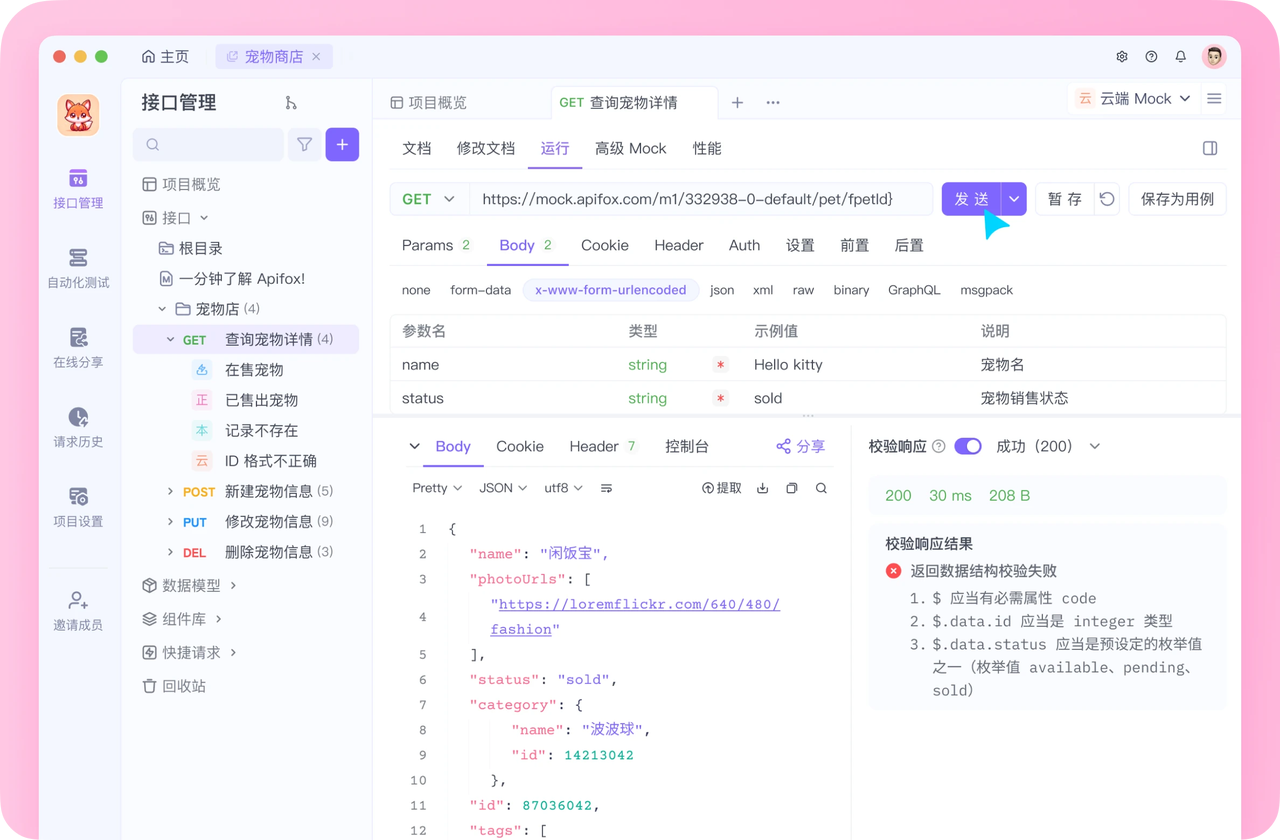
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。
获取专属报价与部署方案
 详细的私有化部署系统架构与安全白皮书
 针对您公司规模的专属报价单
 免费的 1v1 专属产品演示 (Demo) 机会