简要回答: 要使用 Gemini Omni 1.2 Flash 延展视频,只需将现有视频片段和简短的续写提示词发送到 Interactions API。每轮延展可追加 3 至 10 秒并返回拼接后的完整视频。Gemini API 总时长上限为 30 秒;Google Cloud 的 Agent Platform 最高可达 40 秒,但前提是合理规划每一步的时长,否则开头画面会被截断。
关于提示词编写技巧,可参考我们的 Omni 1.1 场景延展指南。本文将聚焦 1.2 版本的新变化:请求构造方式、多轮拼接算术以及生成一段 40 秒视频的真实成本。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
Gemini Omni 1.2 Flash 视频延展的工作原理
视频延展(video extension)会在现有视频片段的末尾生成一段续接画面。模型会读取输入视频最后最多 10 秒的内容作为上下文,生成 3 至 10 秒的新画面,并将其拼接到原视频末尾。延展仅支持向后追加:你无法在视频开头插入画面,也无法从中间展开。
根据调用平台的不同,Google 文档规定的限制也有所差异:
| Gemini API | Agent Platform(Google Cloud) | |
|---|---|---|
| 认证方式 | API Key | Google Cloud 项目与访问令牌 |
| 总时长上限 | 30 秒 | 40 秒 |
| 输入视频长度 | 未单独声明上限 | 任意时长 |
| 参考图数量 | Omni 最多支持 6 张 | 每次延展最多 2 张 |
| 延展模式声明 | 优先靠提示词触发,task 作为备选 |
所有示例均显式传入 task: "extend" |
| 随机种子与标签 | Omni 文档未列出 | 支持 generation_config.seed 与 labels |
| 结果存储保留期 | 付费层级保留 55 天 | 最长保留 7 天 |
数据来源:Gemini API Omni 文档与 Agent Platform 视频延展文档。
在 Agent Platform 上,模型会读取输入视频的最后最多 10 秒,然后将新生成的片段拼接到输入视频的最后最多 30 秒之后。在 Google 给出的示例中,将一段 60 秒的输入视频延展 10 秒,最终返回的是 40 秒视频——这意味着开头的 30 秒被直接裁掉了。
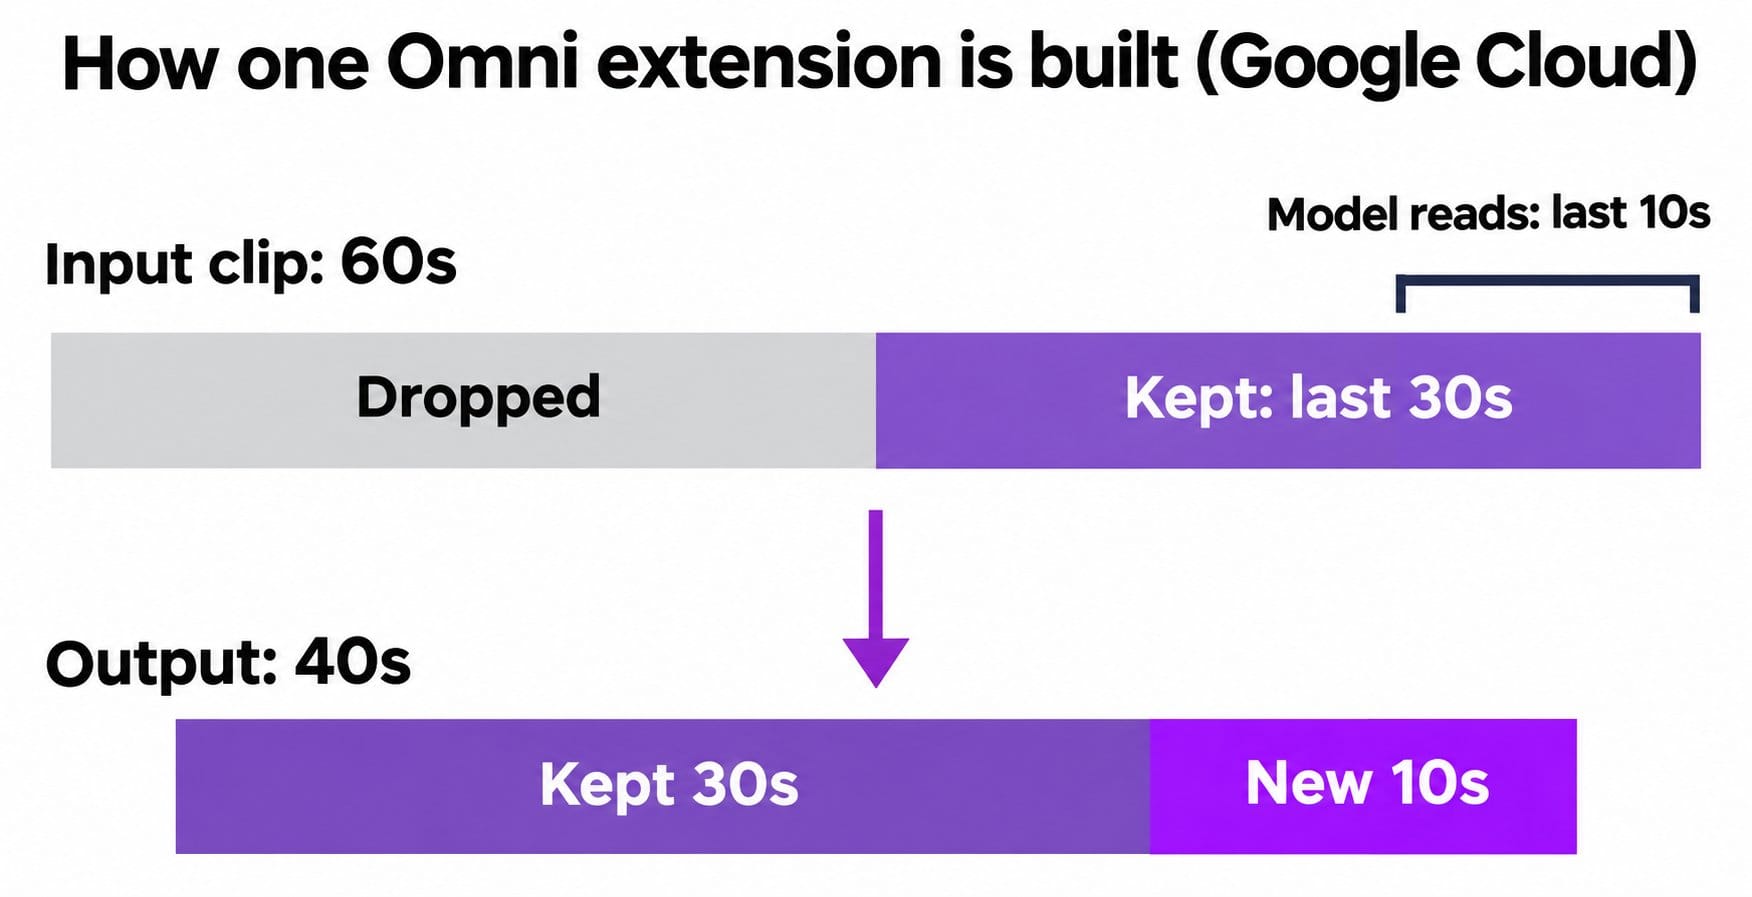
由于返回结果已经包含了前面的画面,你不需要自己做视频拼接。此外 Google 会对输入视频末尾的若干帧进行微调,使接缝过渡更加自然。
1.2 版本在视频延展上的新变化
- 初始片段最长支持 15 秒。 1.1 版本单次生成上限为 10 秒。不过每轮延展追加的时长上限仍为 10 秒。
- 支持参考图、随机种子(seed)和计费标签(labels)(在 Agent Platform 延展请求中提供)。
- 全新的提示词语法。 Google 弃用了旧版指南中使用的
<IMAGE_REF_0>等控制标签,现在需用自然语言直接描述每张参考图。 - 输入类型更新。 当前官方示例统一发送
"type": "video",而不再使用 1.1 示例中的document类型。
在 Gemini API 中分步延展视频
- 先生成一段视频,或通过 Files API 上传已有视频(上传的文件会在 48 小时后自动删除)。
- 在提示词中只描述接下来发生的动作。
- 将
duration设置为"3s"至"10s"(默认值为 10 秒)。 - 保存返回的 interaction ID,供下一轮延展使用。
from google import genai

client = genai.Client()

first = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input="A courier in a yellow jacket cycles through a rainy night market.",
    response_format={"type": "video", "duration": "15s"},
)

second = client.interactions.create(
    model="gemini-omni-1.2-flash",
    previous_interaction_id=first.id,
    input="The courier brakes at a red door. Keep the same yellow jacket.",
    response_format={"type": "video", "duration": "10s", "delivery": "uri"},
)
如果要延展自己拍摄的视频素材,只需将 previous_interaction_id 替换为包含 {"type": "video", "uri": video_file.uri} 和文本项的 input 数组。
- 起初不要加
task字段。 Google 表示该字段会施加严格的约束条件,因此仅在普通延展效果不理想时,才在video_config中设置"task": "extend"作为备选。 - 文件超过 4MB 时使用
delivery: "uri"。 请直接从创建响应中保存 URI;即使创建时请求了 URI,后续对该 interaction 发起GET请求仍会返回内联的 base64 数据。 - 保持
store开启。 如果设置store: false,后续将无法基于该 interaction ID 继续延展。
上传自有视频还有两项额外限制:不支持在有人物说话的上传视频中添加对白;且欧洲经济区(EEA)、瑞士和英国地区不支持对上传视频进行延展。对模型生成的视频进行多轮延展则不受这两项限制影响。
Agent Platform 请求详解
如果需要生成 40 秒视频或接入异步任务队列,请使用这一入口。由于视频生成耗时可能超过 1 分钟,建议开启 background,向 https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/global/interactions 发送如下 POST 请求体:
{
  "model": "gemini-omni-1.2-flash",
  "background": true,
  "input": [
    { "type": "text", "text": "The courier opens the red door and steps inside." },
    { "type": "video", "uri": "gs://my-bucket/hop-1.mp4", "mime_type": "video/mp4" }
  ],
  "response_format": [
    {
      "type": "video",
      "delivery": "uri",
      "gcs_uri": "gs://my-bucket/out/",
      "aspect_ratio": "16:9",
      "duration": "5s"
    }
  ],
  "generation_config": {
    "seed": 4242,
    "video_config": { "task": "extend" }
  },
  "labels": { "campaign": "courier", "hop": "2" }
}
该调用会立即返回一个状态为 in_progress 的 interaction ID。随后通过 GET .../locations/global/interactions/INTERACTION_ID 轮询状态;当任务完成后,从 steps 的 model_output 步骤中读取 gs:// URI,并将该 URI 作为下一轮延展的输入。
该接口同样支持无状态(store: false)、有状态(store: true)和流式(streaming)模式。存储结果与异步任务结果最长保留 7 天,需要长期保存的视频请及时转存。
【待核实】原文注记:因未配置可用的 Google Cloud 项目,该请求体尚未实测运行;Google 官方示例请求体中未同时展示seed与labels的嵌套位置,接入前请核实字段层级。
如何分步拼接到 40 秒而不丢失片头
只有当单次延展的输入视频不超过 30 秒时,系统才会完整保留之前的全部画面。因此,要想生成完整的 40 秒视频且不丢失片头,必须在倒数第二步恰好停在 30 秒。
| 轮次(Hop) | 规划方案 duration |
规划方案输出时长 | 粗放方案 duration |
粗放方案输出时长 |
|---|---|---|---|---|
| 初始生成 | 15s | 15s | 15s | 15s |
| 第 1 轮延展 | 10s | 25s | 10s | 25s |
| 第 2 轮延展 | 5s | 30s | 10s | 35s |
| 第 3 轮延展 | 10s | 40s | 10s | 40s(片头前 5 秒被丢弃) |
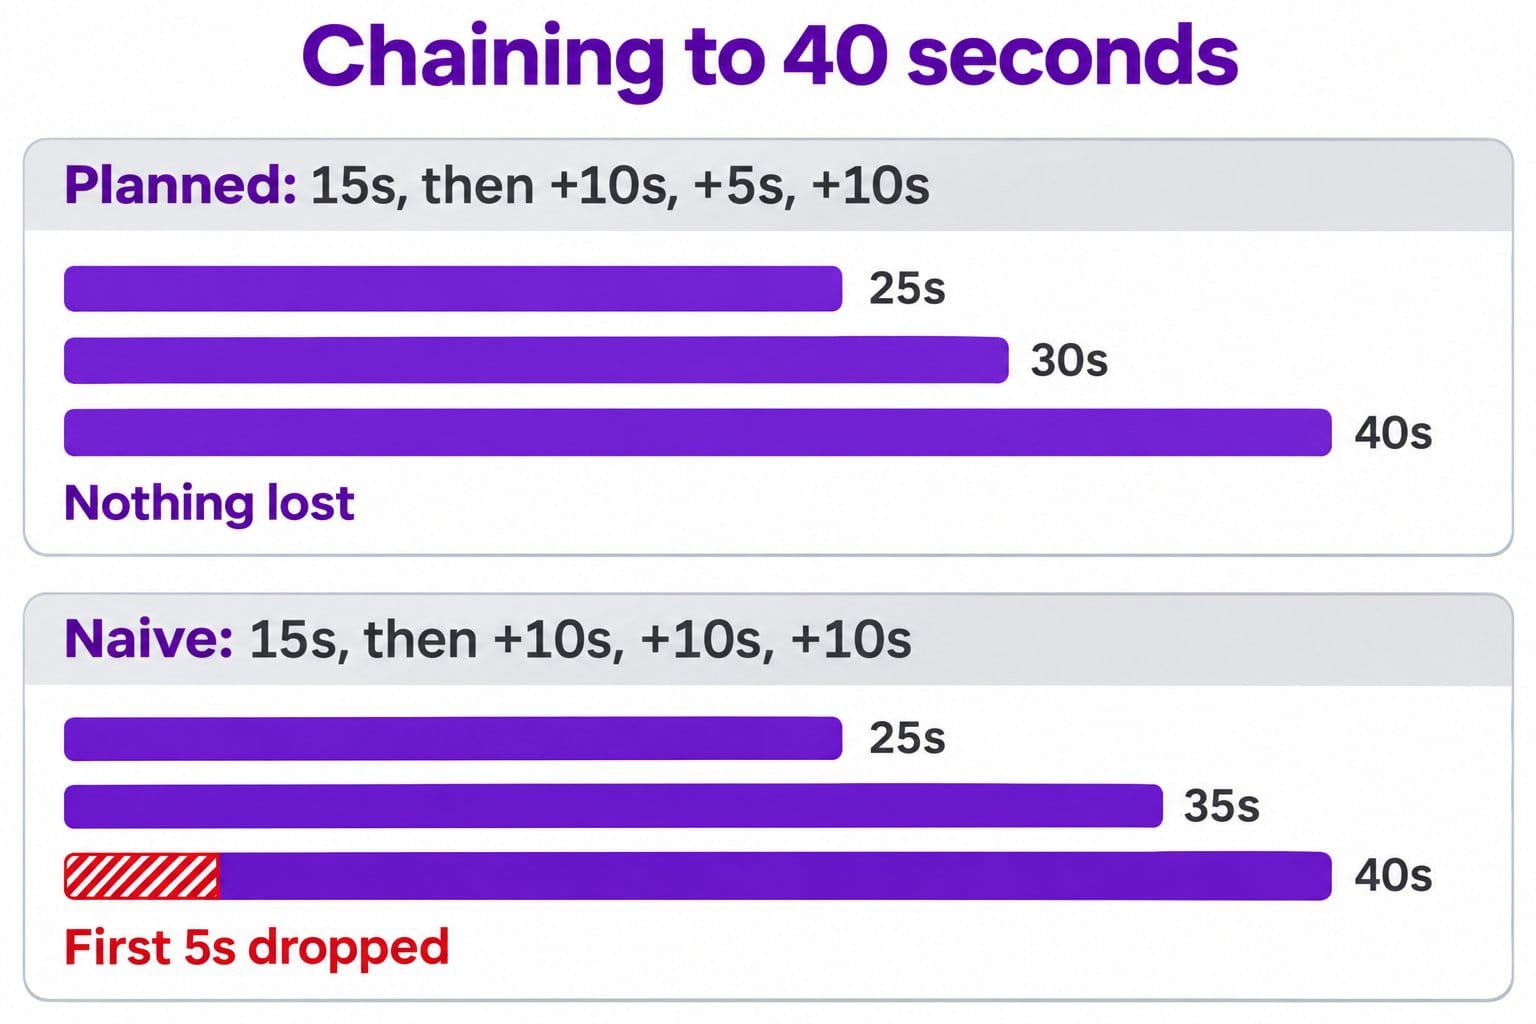
粗放方案在第 2 轮多生成了 5 秒,结果却导致最后一轮把片头裁掉了。仅看返回视频的总时长并不会发现异常,因为两种方案最终返回的都是 40 秒。
在冲击 40 秒上限时,15 秒的初始片段并不能减少调用次数(从 10 秒起步同样需要三次延展);但在其他目标时长下它能少跑一轮:生成 25 秒只需延展一次(而非两次),生成 35 秒只需延展两次(而非三次)。
如果使用 Gemini API,请在第 2 轮延展(30 秒)后停止。Google 文档未说明超过 30 秒的请求会如何处理。
使用参考图与随机种子保持角色一致
如果某个角色在输入视频的最后 10 秒之前就已经离开画面,那么即使这些早期帧仍保留在视频文件里,模型在延展时也“看不见”这个角色。Google 给出的解决方法是:在提示词中重新描述该角色,或者在同一个 input 数组中传入角色参考图:
{ "type": "image", "uri": "gs://my-bucket/courier.png", "mime_type": "image/png" },
{ "type": "text", "text": "The courier from the reference image walks back into frame." }
- 在需要该角色的每一轮延展中复用同一张参考图。
- 在 Agent Platform 上精挑细选参考图。 每次延展最多支持 2 张参考图,请留给最容易走形的主体。
- 不要传入参考视频。 Google 仅在全新生成视频时支持参考视频,视频延展不支持。
- 时间戳从新片段起点算起。 提示词中的
0s指的是本次延展新片段的第 0 秒,而非整段视频的开头。
设置 generation_config.seed 可以获得可复现的生成结果。这在调试提示词时非常实用:固定相同的 seed 重跑某一轮延展,就能判断画面变化是否来自提示词修改。不过 Google 并不保证同一个 seed 能在不同提示词之间锁死角色外观,角色一致性仍需依赖参考图。此外可以使用 labels 按轮次统计账单成本。
生成一段 40 秒视频需要多少钱
Google 的定价页面将 Omni 1.2 的视频输出定价为每百万 token $12.00。但官方文档并未明确说明:视频延展究竟是只按新生成的秒数计费,还是按每次返回的完整视频总秒数计费。按照上文的规划方案,最终成片虽然是 40 秒,但四步依次返回了 15 秒、25 秒、30 秒和 40 秒,累计返回时长达 110 秒。
| 分辨率 | 每秒单价 | 若仅按新增秒数计费(40 秒) | 若按每次返回总秒数计费(110 秒) |
|---|---|---|---|
| 360p | $0.023 | $0.93 | $2.55 |
| 720p | 约 $0.07 | $2.78 | $7.65 |
| 1080p(上采样) | $0.104 | $4.17 | $11.47 |
| 4K(上采样) | $0.209 | $8.34 | $22.94 |
以上为根据 Google 每秒 token 数折算的 Gemini API 费率,输入 token(每百万 $1.50)和思考 token(thinking tokens,每百万 $9.00)另行计费。
在实测核对账单明细之前,建议先按右侧列(按每次返回总秒数计费)预留预算。以下方法有助于控制成本:
- 先在 360p 下跑通草稿,验证完整拼接链路后再花钱渲染 720p。
- 在开始多轮拼接前选定分辨率。 Agent Platform 模型页面规定超分上采样(upscaling)的输入视频最长不超过 15 秒,因此拼接完成的 40 秒成片无法一次性直接上采样。
- 为高难度镜头预留重抽预算。 Google 发布公告指出,高速体育运动、剧烈切换的剧本动作和复杂物理规律仍在持续优化中。
此外,发往 gemini-omni-1.1-flash 的请求将自 2026 年 12 月 3 日起自动路由至 1.2 并按 1.2 费率计费。
使用 Apifox CLI 让编程智能体测试异步延展流程
异步多轮链路很容易出现静默故障:轮询永不结束、任务最终状态变为 failed,或者返回结构发生变动。你可以让编程智能体通过 Apifox CLI 构建并自动执行这套异步测试。
npm install -g apifox-cli@latest
apifox auth login --with-token <YOUR_TOKEN>
apifox skill install
随后向 Claude Code、Codex 或 Cursor 提供一条提示词:
In Apifox project <id>, create endpoints for POST and GET on the Omni
interactions URL. Build a test scenario named omni-extend-async: start a
3-second 360p extension with background set to true, save the interaction
ID, then loop with a 10-second delay on GET until status leaves in_progress.
Assert status is completed and a model_output step holds a video/mp4 item
with a uri or data. Run it and summarize any failures.
智能体会先校验请求载荷,再创建并运行该测试场景:
apifox cli-schema get test-scenario-update
apifox test-scenario create --project <id> --name "omni-extend-async" --folder-id <folderId> --priority 1
apifox test-scenario import-steps <scenarioId> --project <id> --source endpoint --ids <postId>,<getId>
apifox cli-schema validate test-scenario-update --file scenario.json
apifox test-scenario update <scenarioId> --project <id> --file scenario.json
apifox run -t <scenarioId> --project <id> -e <envId> --timeout-request 300000 -r cli,junit --out-dir ./reports
由于每次运行都会产生真实的视频计费,建议将其配置为每晚定时构建,而非每次代码提交都触发。如果仅按新增秒数计费,单次 3 秒 360p 延展成本约为 $0.07。同一条运行命令可直接接入 CI 流水线,详见我们的 Apifox CLI CI/CD 指南;智能体侧的配置步骤可参考在 Claude Code 中使用 Apifox CLI。
常见问题
Gemini Omni 1.2 Flash 生成的视频最长可以达到多少秒? 单次生成支持 3 至 15 秒。通过视频延展,Gemini API 文档支持总长最多 30 秒,Agent Platform 文档支持最高 40 秒。
为什么延展后的视频开头部分消失了? 在 Agent Platform 上,系统每次仅保留输入视频的最后 30 秒。任何超过 30 秒的输入都会丢失片头画面。请合理规划每一轮延展的步长,确保最后一轮延展恰好从 30 秒的输入开始。
可以延展自己拍摄的视频吗? 在欧洲经济区(EEA)、瑞士和英国以外的地区可以。你可以通过 Files API 上传视频,或在 Agent Platform 上指向 Cloud Storage 存储桶。注意不能向包含人物说话画面的上传视频中添加新对白。
可以免费使用视频延展功能吗? 通过 API 调用不能免费。Google 将 Omni 1.2 和 1.1 的免费层级均列为“不提供(Not available)”,因此哪怕跑一次测试也会计费。3 秒 360p 的延展是单次成本最低的测试方式。