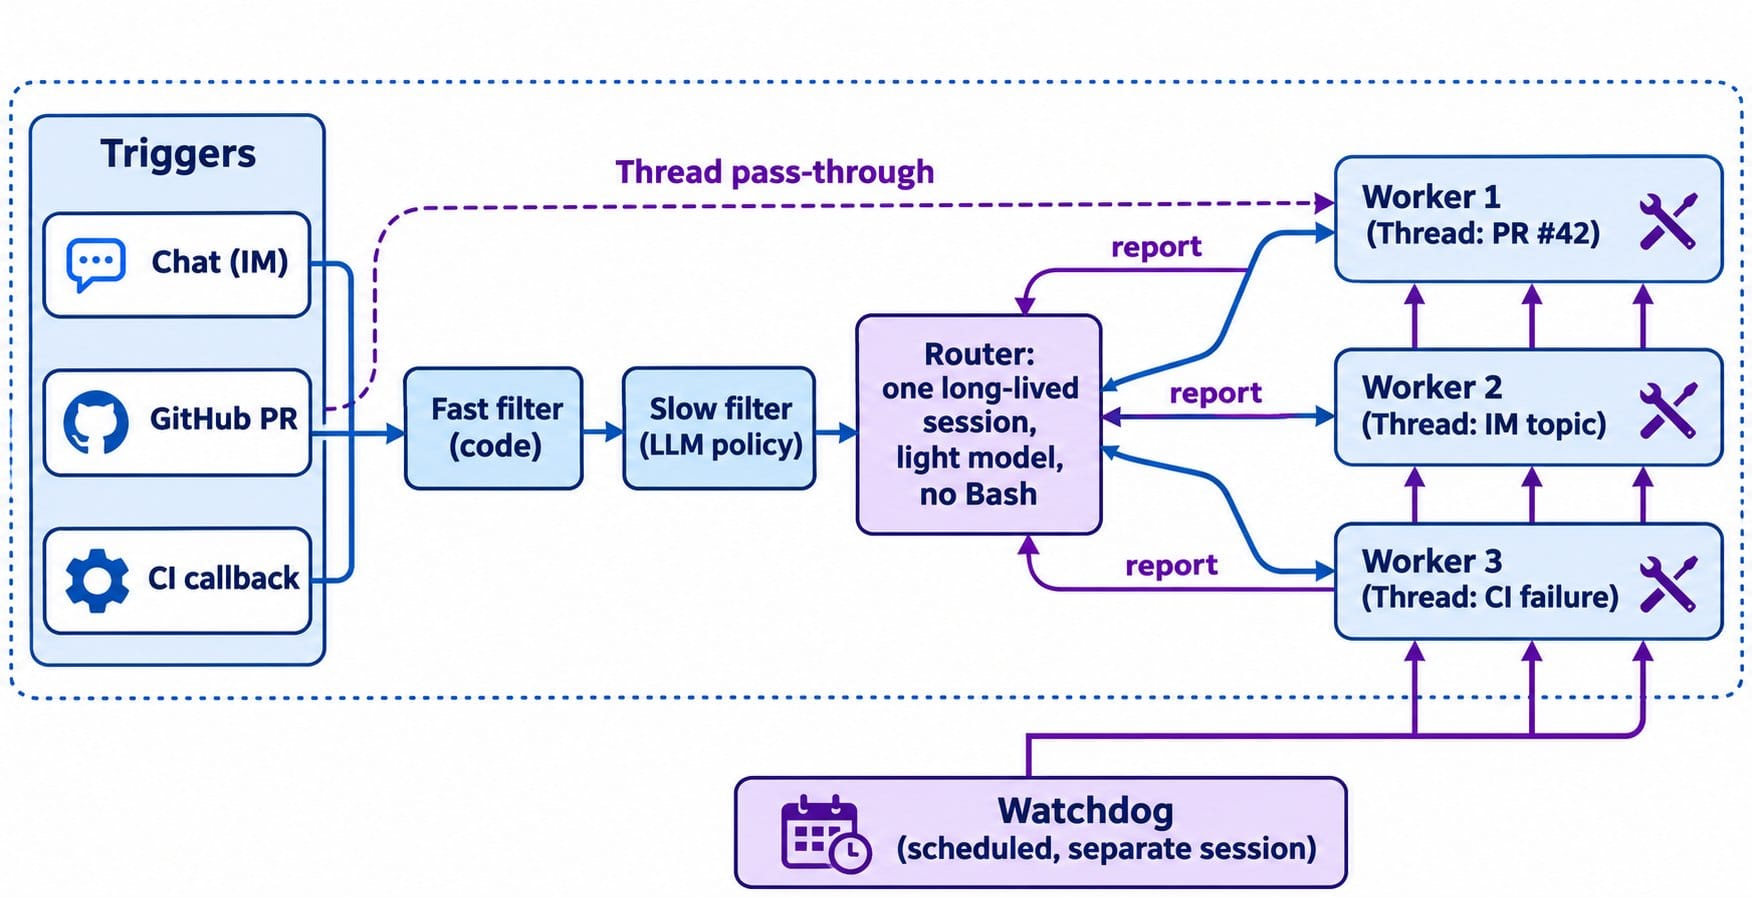
要构建 DeepSeek Harness 所描述的超级智能体,可将系统分成两层:一个长期运行、负责与人交流和分派工作的 Router 会话,以及多个相互隔离、各自配备完整工具并执行一项任务的 Worker 会话。两层都接收聊天、GitHub、CI 等事件产生的 Trigger;后续事件按 Thread 路由,并由独立的 Watchdog 监控整体运行。
本文把 DeepSeek Harness 的设计文章 “Exploring Super-agent Design” 整理成构建步骤。需要注意:原文介绍的是架构,并非已经发布的功能。其中部分设计存在于 dsh-superagent-prototype 原型插件中,作者称它“并非 DeepSeek 官方产品”。下文所有代码片段仅用于说明,并非 DeepSeek 源码。
AI Coding 交流群
如果你也在用 AI 写代码,或者正在研究 Cursor、Claude Code 这些工具,欢迎加入以下交流群。群里平时会聊一些 AI 编程的实际用法、开发工作流,还有各种新工具和新玩法。
什么是超级智能体?
超级智能体是一个始终在线、身份统一的 AI 队友:它接收聊天、拉取请求和 CI 等多个渠道的事件,在隔离会话中并行处理多项任务,再以同一个身份回复用户。
问题在于,智能体会话彼此隔离,而“一个人通常只能同时跟进 3 到 5 个活跃会话”。单项任务受模型能力限制;多任务处理则受人的注意力限制。超级智能体针对的是后者。
它有四个特点:
- 连续性: 同一个智能体贯穿 IM 和 GitHub。你在聊天中讨论方案 A,转到 PR 评论讨论方案 B,它仍能跟上。
- 生产力: 并行执行任务,上一条指令尚未完成时就能接收下一条。
- 主动性: 关注事件,只有需要介入时才出声。
- 持久性: 始终在线,并能自行恢复。
DeepSeek Harness 是这套设计的背景;理解其与 Claude Code 等编程智能体的区别,有助于看清下文的会话分工。
超级智能体架构:五个模块
原文提出五个模块,下表列出各自的作用及对应构建步骤:
| 模块 | 作用 | 构建步骤 |
|---|---|---|
| 双层架构 | Router 分派,Worker 执行 | 1 |
| 事件驱动的 Trigger | 把聊天、GitHub 和 CI 事件转为智能体输入 | 2 |
| 全双工、多渠道 | 异步工具与按渠道调整的回复 | 4 |
| 计算、状态、环境分离 | 无状态循环、数据库保存状态、机器留在原处 | 5 |
| Watchdog | 独立会话检查进度和错误 | 6 |
第 1 步:分离 Router 与 Worker
Router 是一个长期运行的会话,负责所有人与系统的交互及任务分派,本身不执行任务。它可以不配备 Bash 工具,使用较轻量、成本较低的模型即可。若一个 Router 回合中陆续收到多个 Trigger,它们会合并到下一次调用中:输入较长、输出较短,并在 prefill 阶段合并。
每个 Worker 都是对应一项任务的隔离会话,拥有完整工具,并使用预算允许的最强模型。它不直接与人交谈,而是向 Router 汇报。Worker 自身还可以调用子智能体,甚至是完整的智能体团队。
这与智能体团队不同。团队负责人拆解的是一项相互关联的任务;Router 分派的是彼此独立的任务。两者可以组合使用。
# Illustrative sketch, not DeepSeek's code
class Router:
    def on_events(self, batch):              # triggers arriving mid-turn are batched
        plan = self.llm_light.decide(batch)  # dispatch, reply, or ignore
        for task in plan.new_tasks:
            Worker.spawn(task, model="strongest", tools="all", report_to=self)
        for msg in plan.replies:
            self.channels.send(msg)          # only the Router speaks to humans
第 2 步:把事件转为 Trigger
超级智能体的每项输入都是 Trigger,例如聊天消息、GitHub webhook 事件、Slack Events API 载荷或 CI 回调。大多数事件根本不该送入模型,因此原文采用两级过滤。
- 快速路径:代码过滤。 按来源、群组以及用户或机器人的允许名单过滤。各来源分别设置“仅响应明确请求”“候选”或“忽略”模式。
- 慢速路径:LLM 判断。 候选事件交给模型,按提示词形式编写的策略判断,例如“有人在此频道报告缺陷时回复”。
接收端点应快速确认,再异步处理。GitHub 的 webhook 最佳实践 要求在 10 秒内返回 2XX,而模型调用无法保证这一点。可返回 202 Accepted,将 Trigger 入队,再由 Router 处理。这一层还需要处理重试与幂等性。
第 3 步:按 Thread 路由后续事件
Thread 是同一个 PR、IM 话题或邮件会话中连续发生的一组事件。为首个事件创建的 Worker 会订阅这个 Thread;后续事件直接送给该 Worker,不再调用 Router。
这种映射可以是多对多的。如果两个 Worker 都涉及同一个 PR,它们都会收到相关事件,也可以通过 PR 本身解决冲突,无需直接互发消息。
省略这一步会增加开销:原文实验中,去掉直通机制后,Router 的决策次数增加约 30%,token 用量增加约 37%。
第 4 步:把上下文视作缓存,并让工具异步运行
Router 无法容纳所有信息,因此原文把上下文当成缓存:
- 内联 可能需要的内容:ID、简短摘要及相邻消息。
- 外置 其余内容:截断正文,留下可供智能体追溯的指针。
Trigger、Thread 和 Worker 的稳定 ID 组成引用关系图,作者称之为“Chain of Recall”。智能体可以从 Trigger 追到 Thread,再找到处理它的 Worker,无需把所有内容塞进巨大的提示词,也能实现多跳回溯。
接下来实现全双工:用异步的 start() 和 stop() 替代阻塞式 run() 工具。start() 立即返回“Started”,执行结果随后作为新事件到达。这样,上一项工作仍在运行时,智能体就能接收下一条指令。原文称 DeepSeek Harness 已实现这一机制,但默认未启用。
最后,让回复适应渠道。测试中使用的规则将 IM 回复限制在 100 个词以内,而 GitHub、邮件和文档可以使用结构化、信息密集的长文。
这还支持推测性执行:其用户群采用“静默复现并修复”策略,只有确认简单修复有效时才向用户报告,否则保持安静。
第 5 步:分离计算、状态与环境
智能体循环运行在无状态的云端容器中,会话状态保存在数据库里。执行环境留在原处:每台机器运行一个轻量守护进程,原文称之为 BYOM(Bring Your Own Machine)。循环崩溃后可在别处重启并恢复状态,而代码仓库仍留在原机器上。
原文认为 Anthropic 的“Scaling Managed Agents: Decoupling the brain from the hands” 采用了类似思路,但针对的是托管沙箱,而非用户自己的机器。
第 6 步:加入 Watchdog
Watchdog 是定时运行的独立会话,位于主系统之外。它处理 API 错误,并请模型判断各 Worker 是否持续推进、是否偏离目标。维护者也可以直接询问它故障原因。应让它独立于 Router 进程运行,以免 Router 卡住时监控也随之失效。
实验结果
作者运行了约 300 条聊天和 CI 消息,其中包含约 20 项工作请求;编码过程以计时器模拟,每种配置运行 5 次。作者强调,结果“仅供参考”。
| 配置 | p50(分钟) | p95(分钟) | 每次运行的缓存读取 token 数 |
|---|---|---|---|
| 超级智能体 | 12.4 | 15.7 | 23.2M |
| 不采用 Thread 直通 | 12.6 | 15.5 | 31.8M |
| 单会话 + 子智能体工具,中性提示词 | 20.4 | 29.5 | 6.1M |
| 单会话,优先委派提示词 | 13.8 | 29.0 | 10.8M |
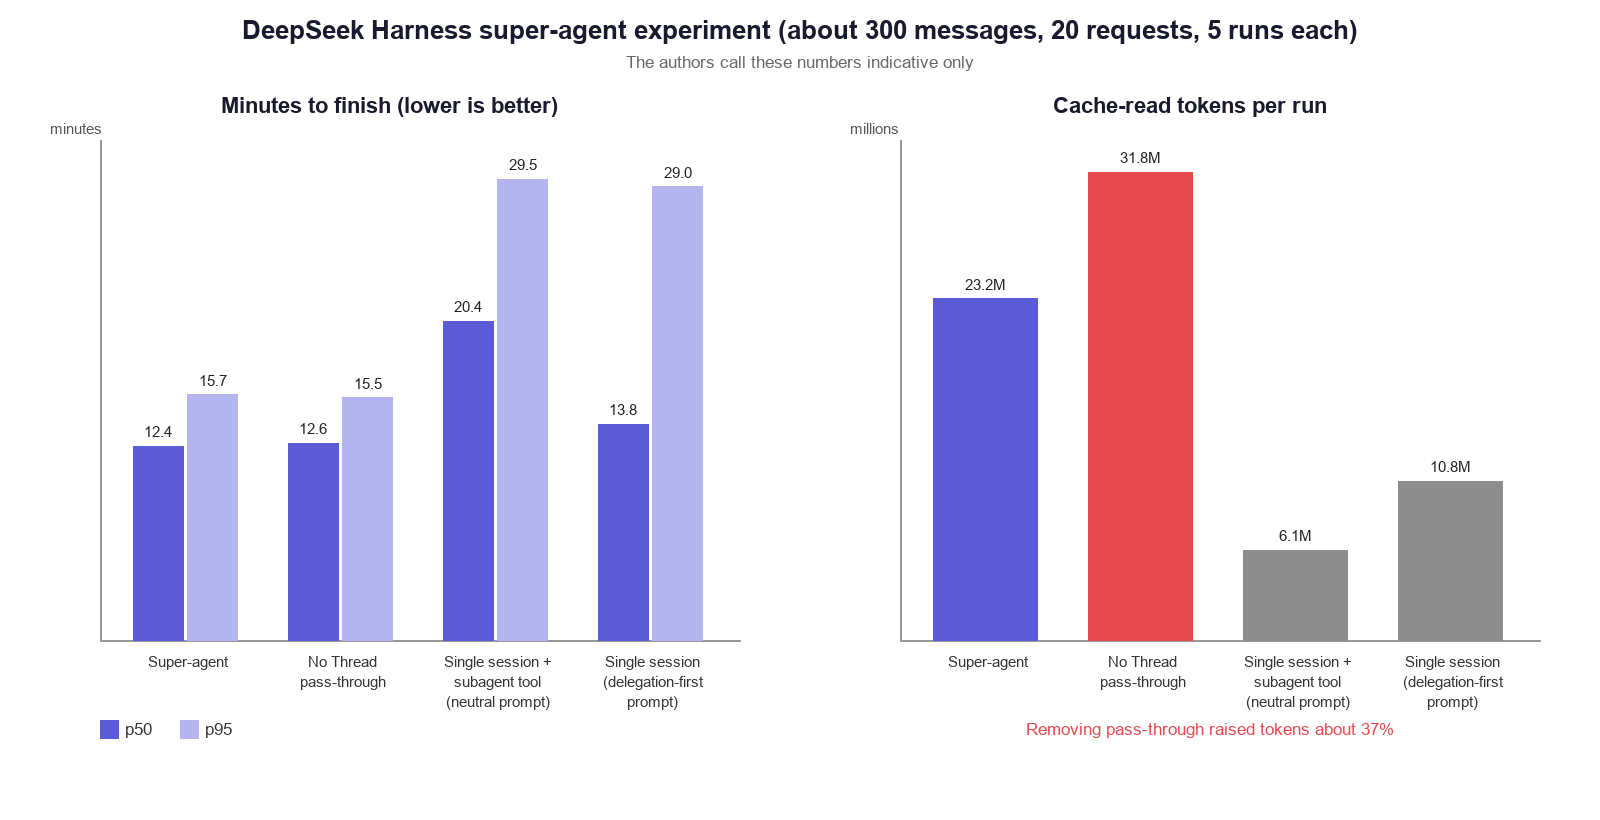
有两个发现值得关注。使用中性提示词时,单会话在 5 次运行中一次也没有委派任务,因此 p95 几乎是超级智能体的两倍。优先委派的提示词改善了中位数,却没有解决尾部延迟。超级智能体消耗的 token 多于单会话,相当于用更多 token 换取更低延迟和更少的人工跟进负担。
第二组测试单独对 Router 施加负载。当 Trigger 速率从每分钟 1 个增至 40 个时,批量大小从 1.0 增至 2.8,每次请求耗时从 2.5 秒增至 3.9 秒,但每项决策耗时从 6.4 秒降至 1.6 秒。批处理让单个 Router 在早期不易成为瓶颈。
测试 Trigger 接收端点
每个 Trigger 最初都是发送到接收端点的 HTTP 请求,因此应优先测试这个端点。如果它漏掉 PR 评论,或给每个事件都分配新的 thread_id,Thread 路由就会失效,后续事件也会重新经过 Router。可以先在 Apifox 中建立测试场景,发送同一 PR 的两条 pull_request_review_comment 事件,并分别断言状态码为 202、响应包含 trigger_id,且两次响应的 thread_id 相同。再把测试场景导出为 Apifox CLI 格式,在预发环境运行。
npm install -g apifox-cli
apifox run ./trigger-intake.apifox-cli.json -r cli,json
测试场景可按以下需求设计。这里描述的是待验证的端点行为,不涉及智能体自动创建接口或用例:
Endpoint: POST /triggers/github
Event: GitHub pull_request_review_comment
Input: two comments on the same PR
Assertions: HTTP 202; response includes trigger_id;
            both responses have the same thread_id.
Environment: staging
如果使用在线测试场景,可按 Apifox CLI 公开文档提供的 --test-scenario 和 --access-token 参数运行:
apifox run -t <testScenarioId> --access-token <accessToken> -e <stagingEnvId> -r cli,json
在流水线中可把报告格式改为 -r cli,junit。以上命令仅用于运行已创建的测试场景;接口、用例及智能体集成流程仍需按实际环境配置。
待解决的问题
原文列出以下尚未解决的问题:
- 随负载增长,如何扩展 Router 并选择 Worker 拓扑。
- 超越 Chain of Recall 的长期记忆。
- 无会话界面下的用户体验:没有统一聊天窗口时,如何引导智能体。
- 上下文边界和智能体间协议,其中 A2A 是候选方案之一。
- 安全性:进入云端循环的提示词注入可能影响每台已连接机器,上下文中的凭据也可能泄漏。作者希望智能体能够使用凭据,却永远看不到凭据本身。
常见问题
超级智能体是可以直接启用的 DeepSeek Harness 功能吗? 不是。原文介绍的是架构。部分功能存在于 dsh-superagent-prototype 插件中,作者称其并非 DeepSeek 官方产品。全双工工具虽已实现,但默认关闭。
为什么 Router 使用较轻量的模型? 它只分派任务并与人交谈,不执行任务,也不需要 Bash。复杂推理由使用更强模型的 Worker 完成。
超级智能体与智能体团队有何区别? 团队负责人拆分一项相互关联的任务;Router 分派相互独立的任务。超级智能体中的 Worker 可以运行自己的智能体团队。
什么是 Thread 直通? 同一 PR、IM 话题或邮件会话的后续事件直接送到负责该 Thread 的 Worker,跳过 Router。原文测试中,去掉该机制后 token 用量增加约 37%。
超级智能体能节省 token 吗? 相比单会话,不能。它每次运行读取 23.2M 个缓存 token,而单会话为 6.1M 至 10.8M;换来的是 15.7 分钟的 p95,而不是约 29 分钟。
原文作者:Ashley Innocent。